
まずい、MiniMaxが本当にマルチモーダルを極めつつある😭。
オープンソースのフラッグシップ動画モデル「H3」が大好評を博したのに続き、最新の画像生成モデル——H3-Imageが再びネット中を席巻している。
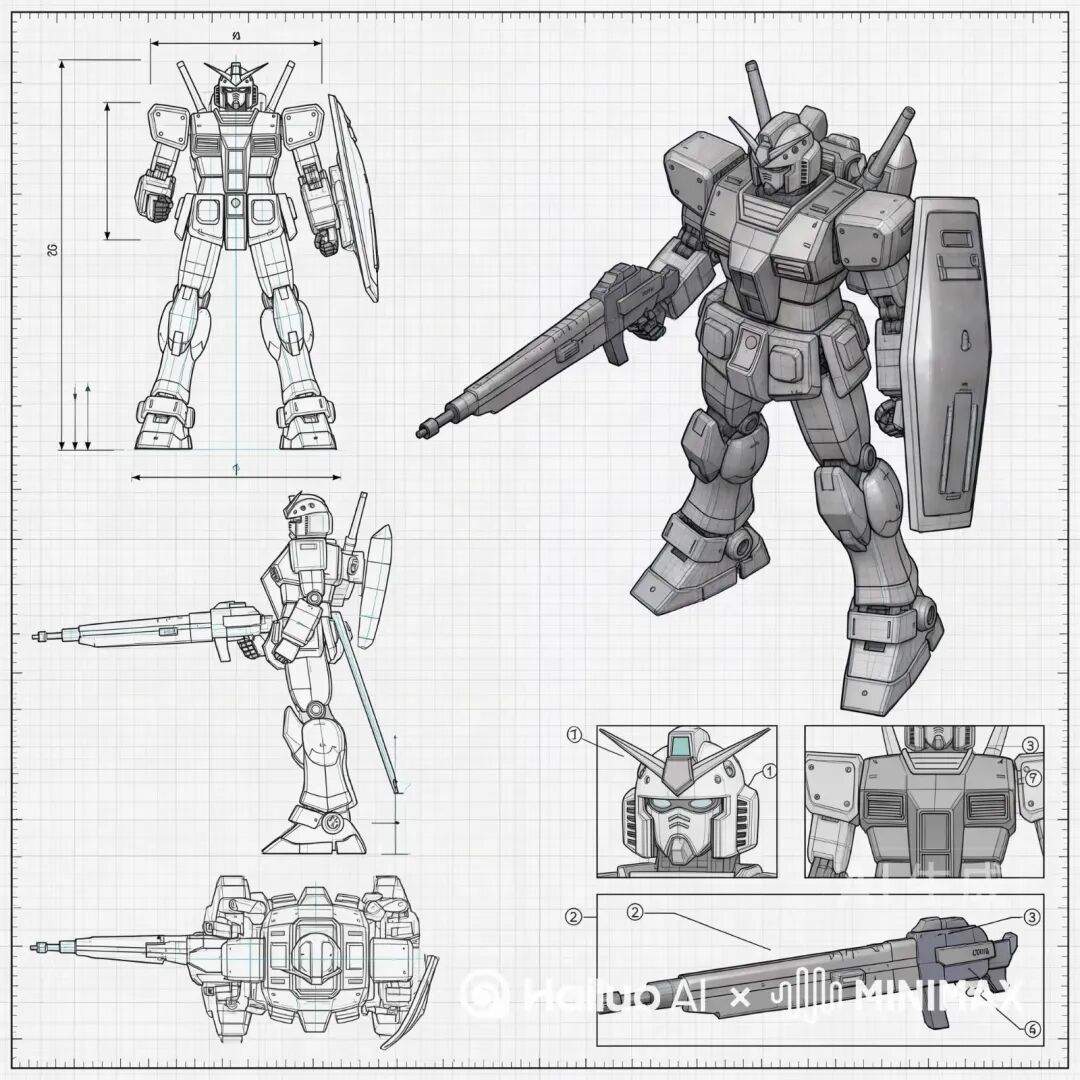
最も話題になっているのが「CAD分解図」だ。参照画像を1枚放り込むだけで、H3-Imageがお気に入りのフィギュアをそのまま「構造分解」してくれるのだ……。
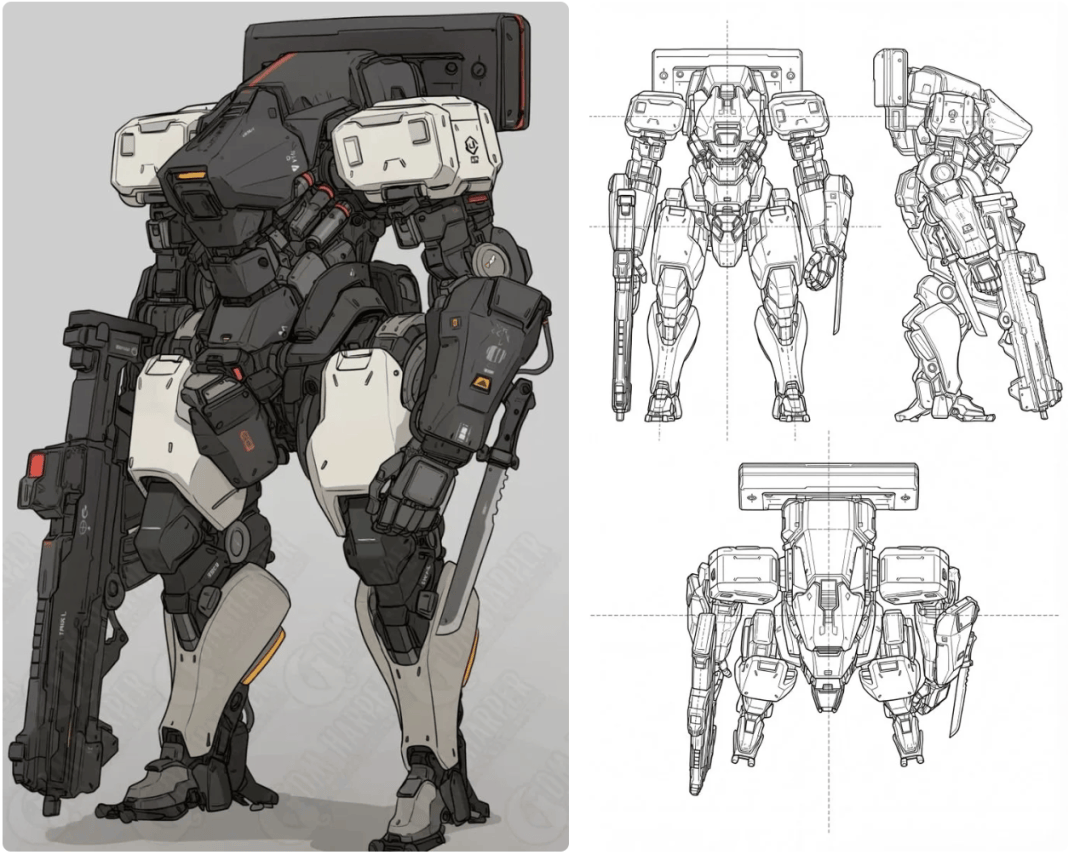
さらにはUnitreeのロボット犬をCAD分解したものまである。
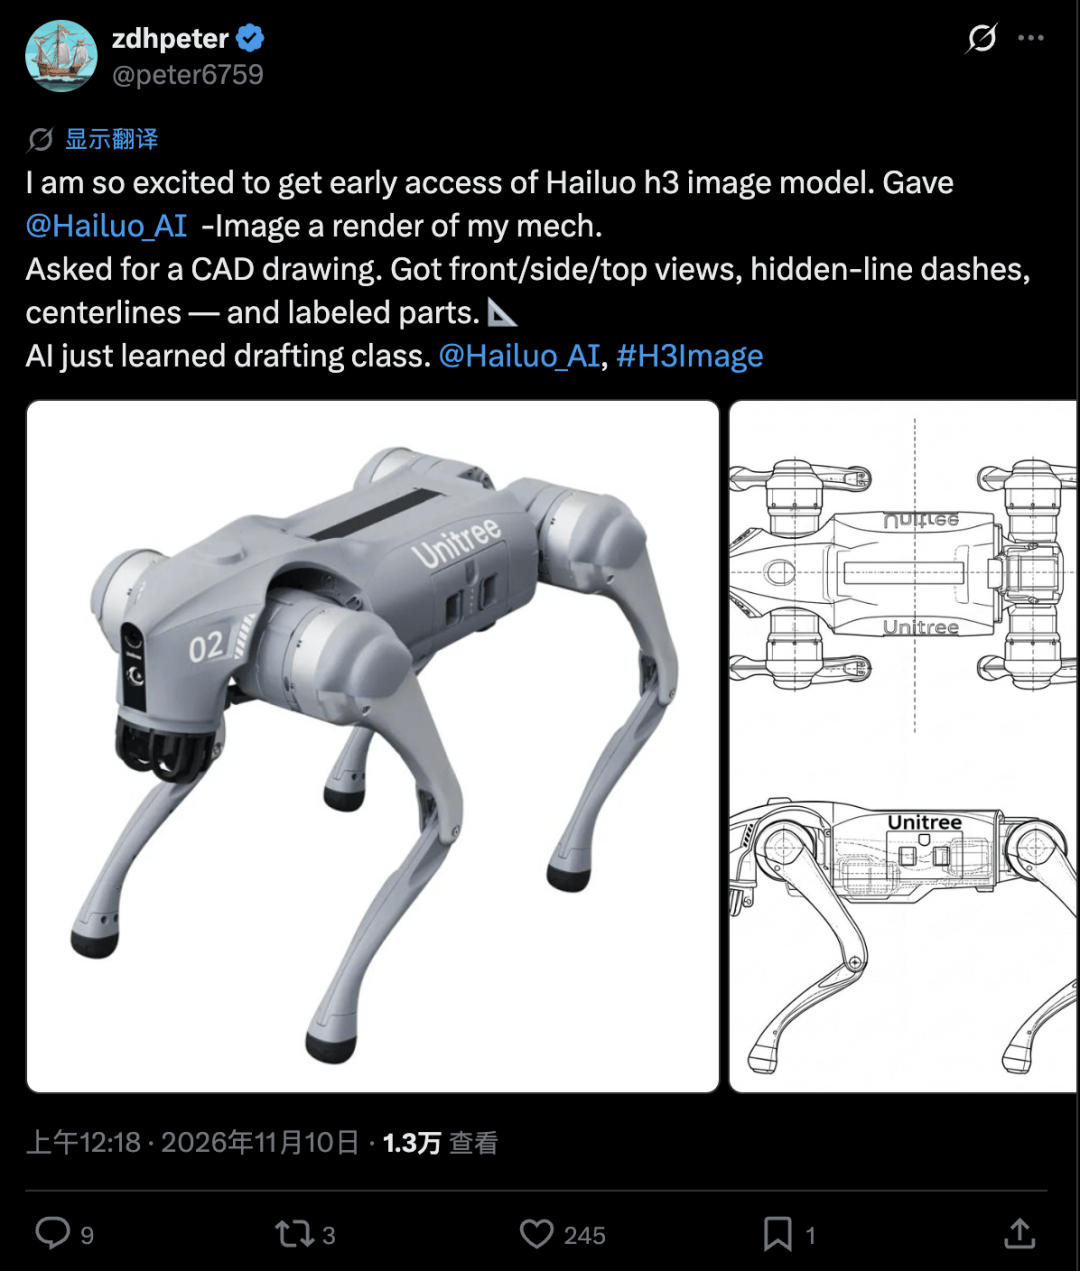
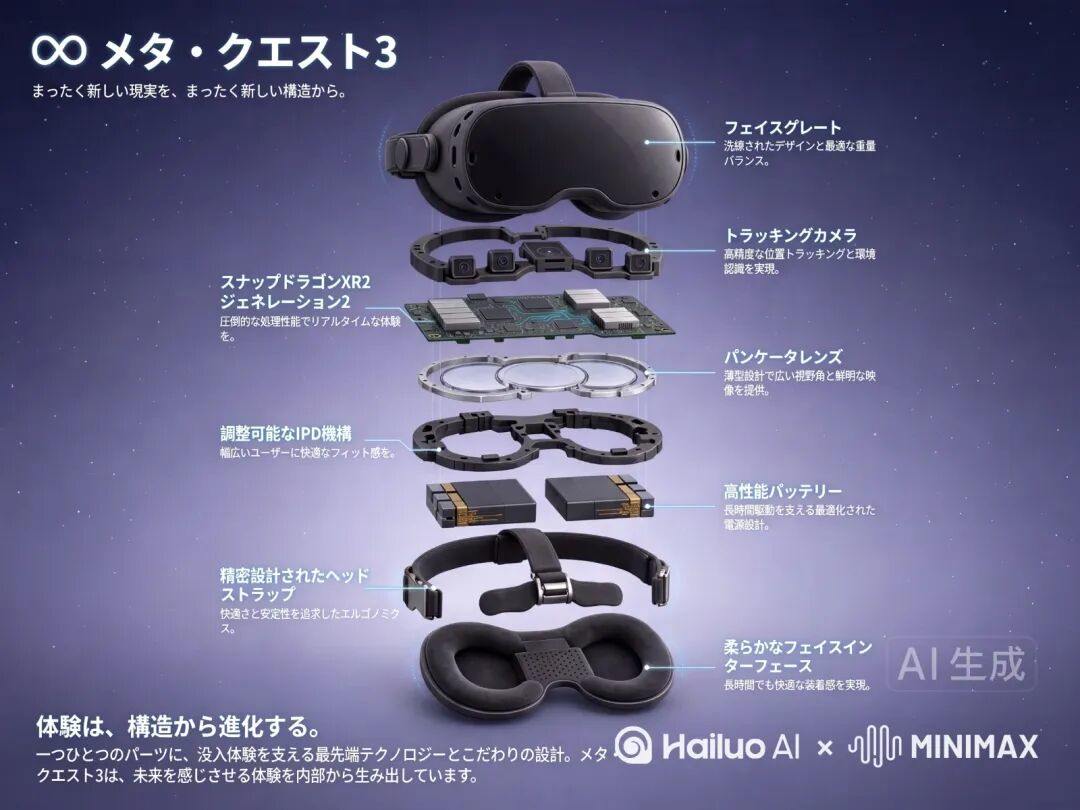
要するに森羅万象あらゆるものを分解でき、パーツごとにきっちりとラベルまで付けてくれるのだ。
私自身も実際に試してみたが、いやはや、これは本当にすごい……。
それだけでなく、海外ユーザーの検証結果を見る限り、他の複雑な画像生成タスクも軽々とこなせるようだ。例えば——ゲーム。
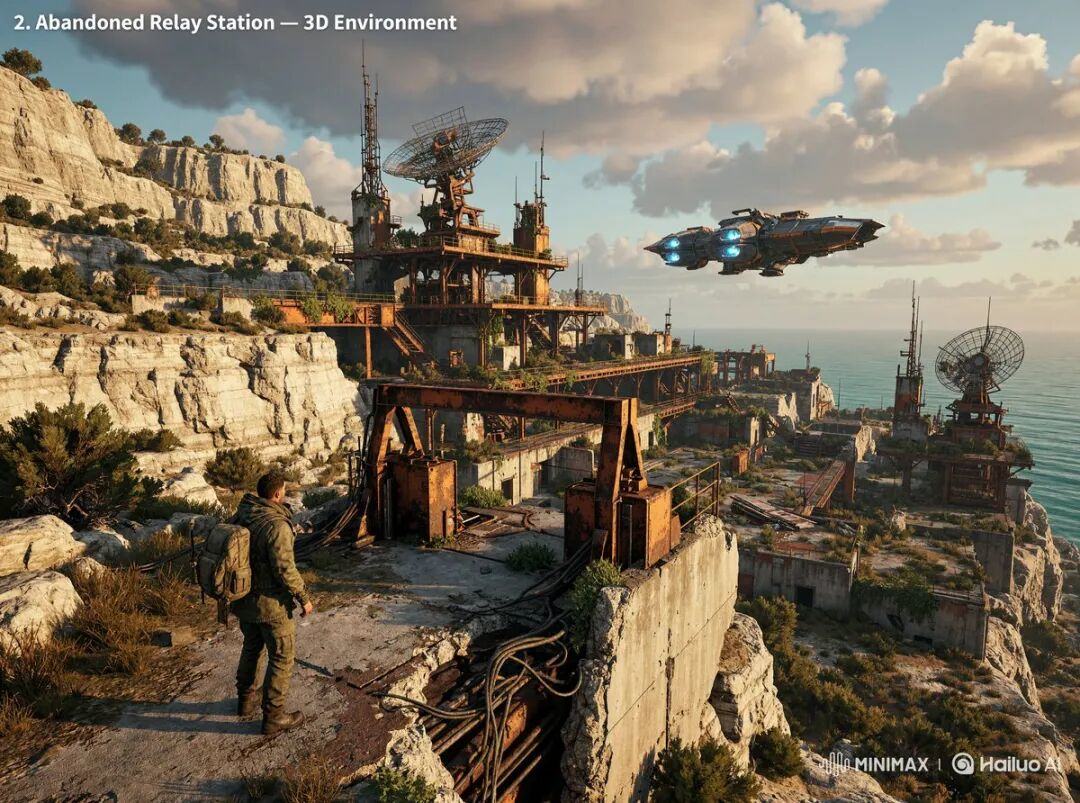
こ、これは……言われなければ、GPTでコーディングして作ったゲーム画面かと思ってしまう😭。
ECサイト向けのシンプルなアセットを作る程度なら、なおさら朝飯前だ。
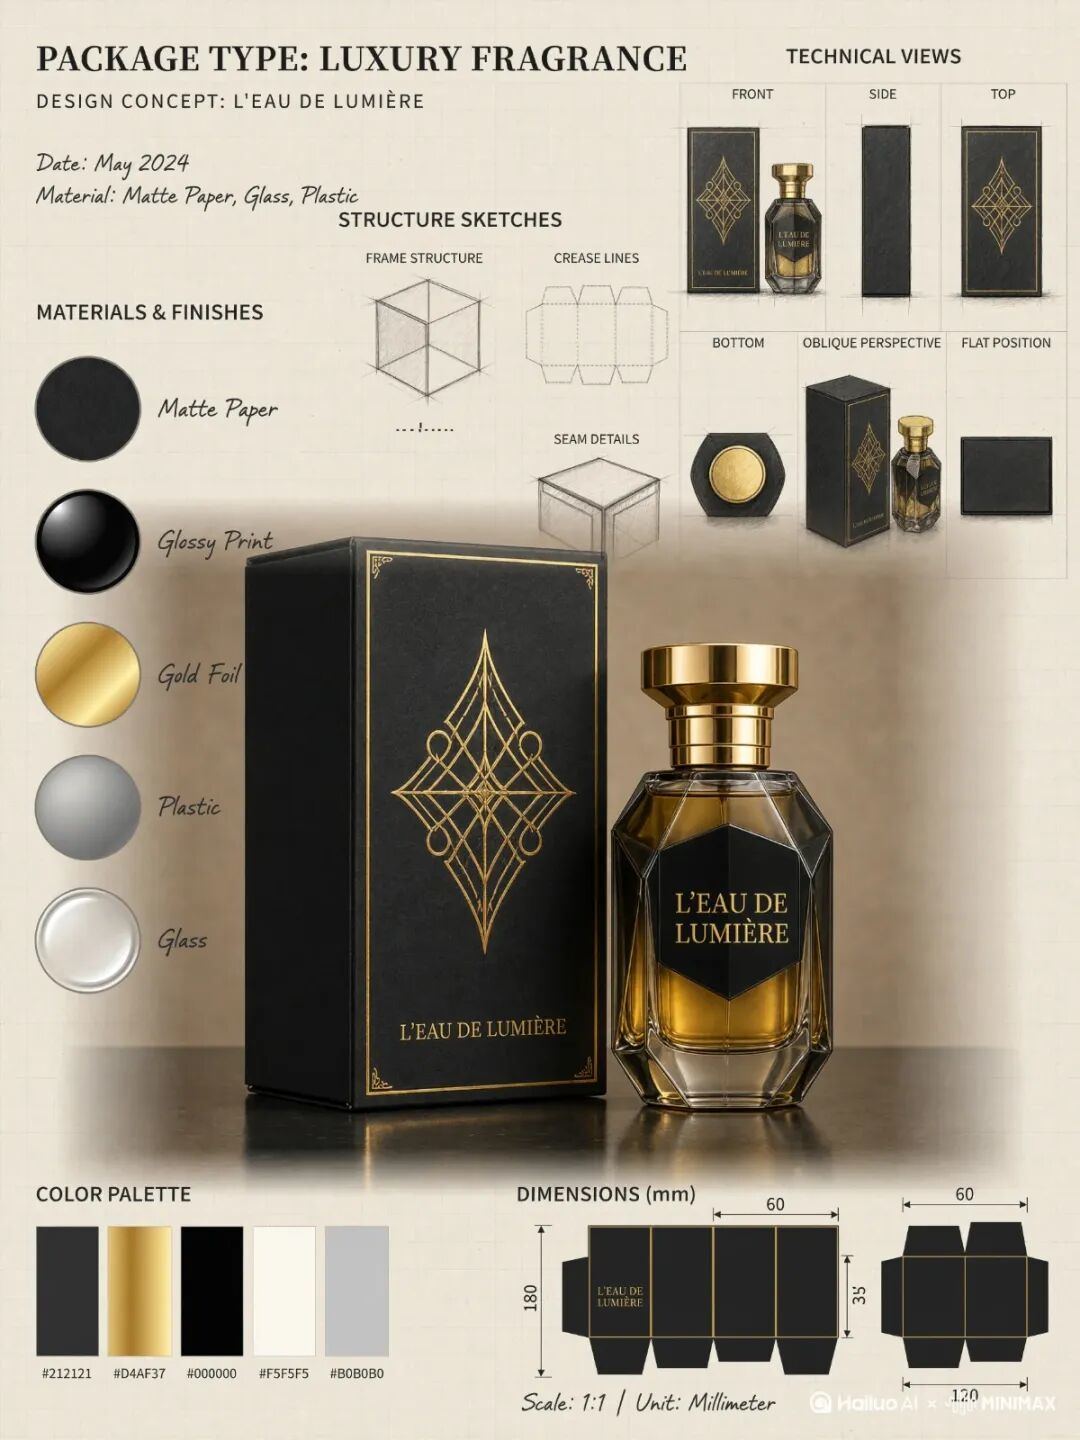
だが予想外だったのは、こいつがまさかの「文理両道」だったことだ。
高い知能を保ちつつ、H3-Imageは美的センスもかなり優れている。
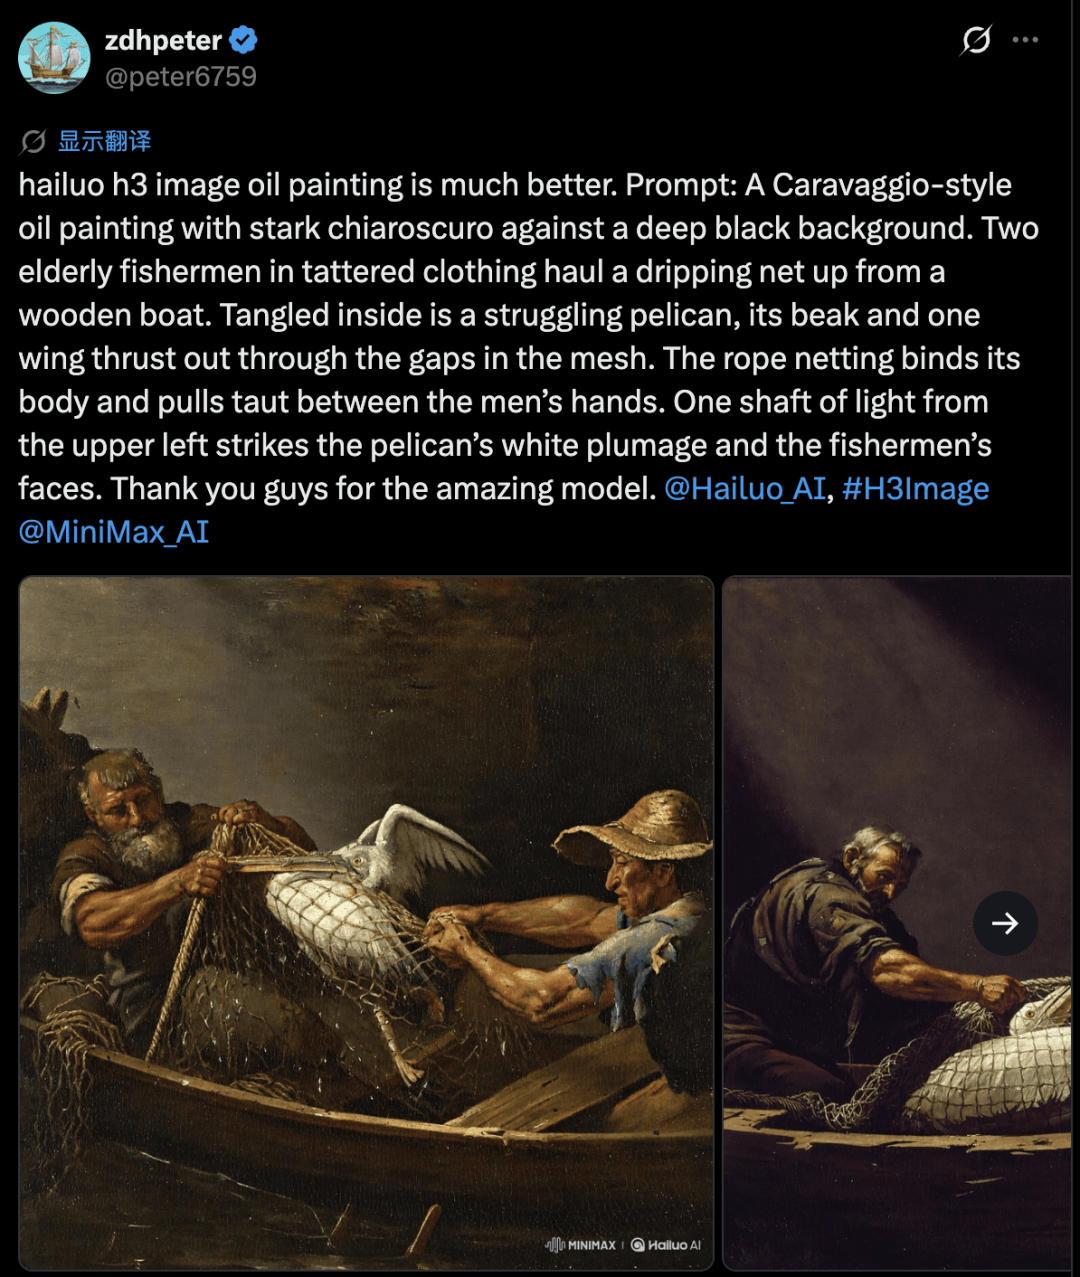
そうそう、もう一つ大事なことがある。
これほど高品質な画像生成モデルが、なんとオープンソースだというのだ???
もう何も言うことはない。
ここに宣言しよう。MiniMaxこそがマルチモーダル界の「オープンソースの神」だ(なんてね)。
プラスチックのような「AIっぽさ」との決別
これまで私たちが「AI画像生成」と聞いて真っ先に思い浮かべるのは、顔がテカテカで、肌はゆで卵のようにツルツル、目はうつろで、人間味がまるでない不気味さだった。
要するに、強烈な「AIっぽさ(AI臭)」である。
GPT Image 2はこの点で非常に大きな進歩を遂げたが、使い続けていると、やはり不気味の谷現象が頭をもたげてくる。
しかし今回のH3-Imageは、この問題をほぼ解決したように感じる。
生成された画像を見て私は呆然とした。「いや待て、これがAIだって誰が見抜けるんだ??」
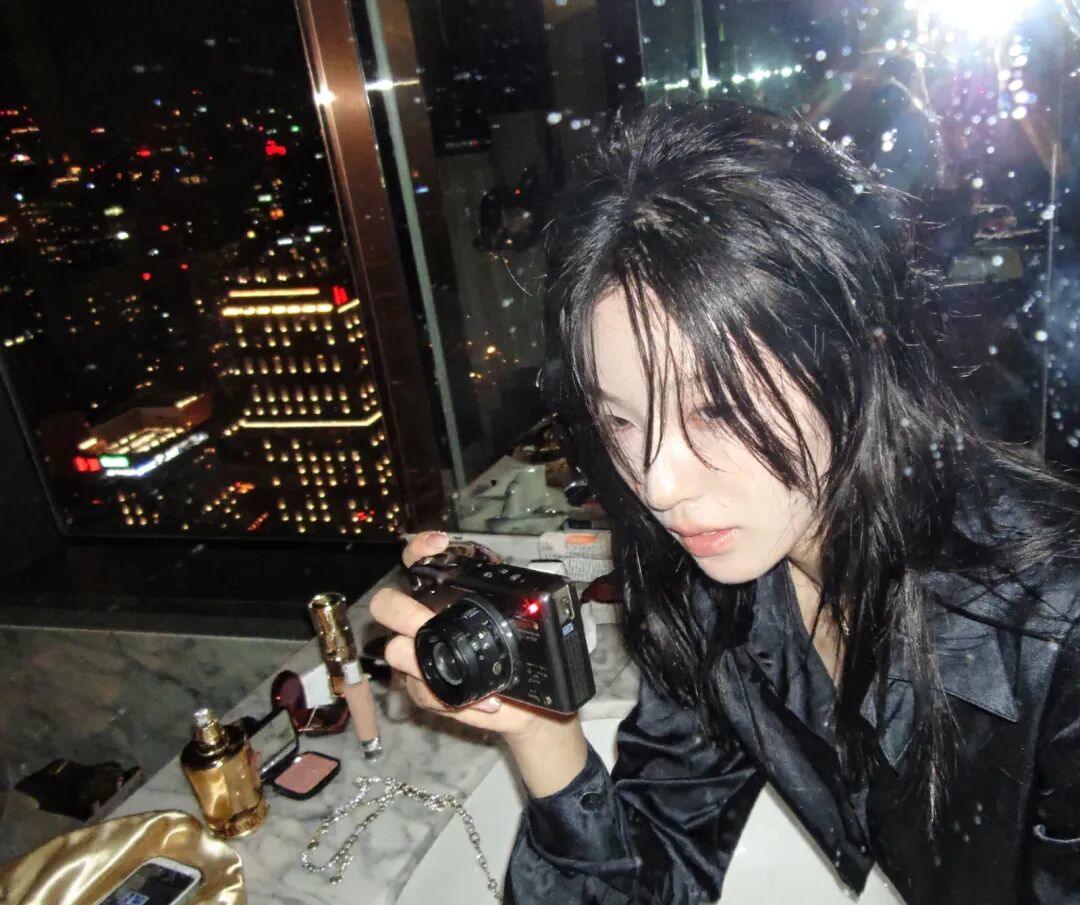
最も重要なのは人間の顔だ。毛穴やそばかす、さらには顔の産毛までしっかり描き込まれている。
さらに、鏡についた水滴やホコリ、フラッシュがレンズに反射してできるハレーションなど、こうしたディテールの処理も極めてリアルで、本当にSNS(小紅書など)のタイムラインに流れてくる写真そのものなのだ。
下からのアングル(あおり)で見ても、顔の細かなディテールがしっかりと表現されている。例えば、下のデスクトップがそのままインスタ写真になったようなファッション誌の表紙を見てほしい。人物の目線や微妙な表情筋の動きをじっくり観察すると、現実世界のコミュニケーションにおける自然な表情のロジックに完全に合致している。
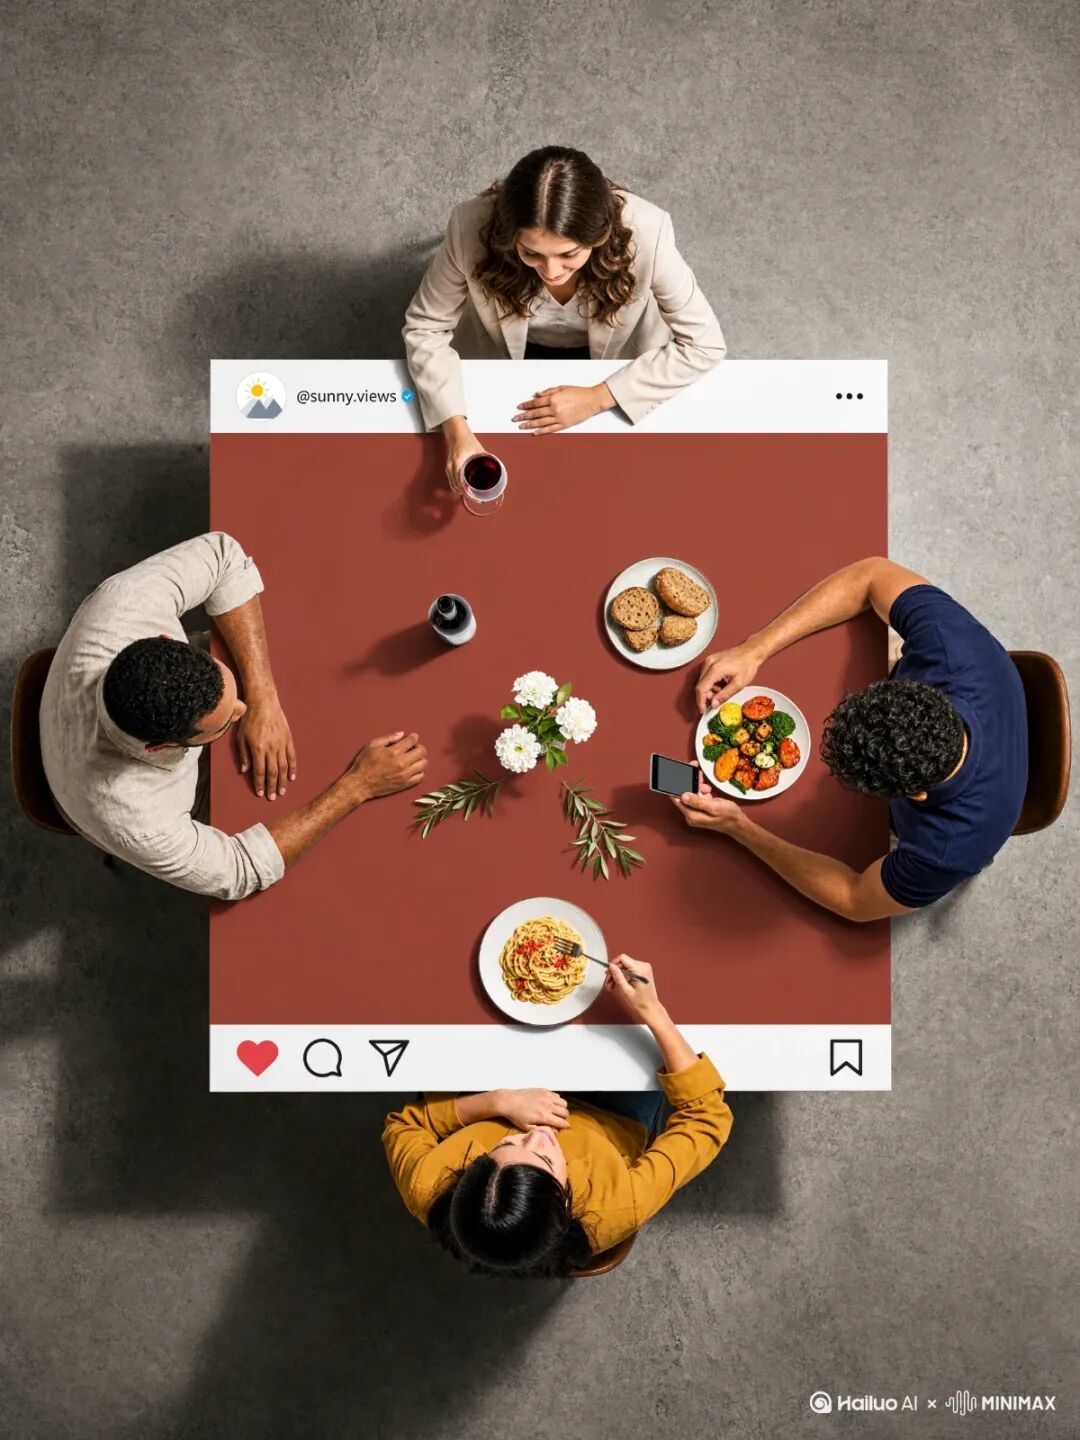
これもH3-Imageを実際にテストしてみて最も強く感じた点なのだが、以前古いモデルで試した多くのプロンプトに対して、H3-Imageは全く新しい解釈を提示してくれるのだ。
このモデルが持つ「世界知識」は間違いなく非常に豊富だ。
顔以外の被写体に至っては、それこそお手の物である。
例えば、リオデジャネイロのランドマークを立体的なペーパークラフト風のトラベルノートにしてみる。
このミニチュア感と光と影の奥行きには、どこかFable 5のトレーラー映像のような雰囲気が漂っている。
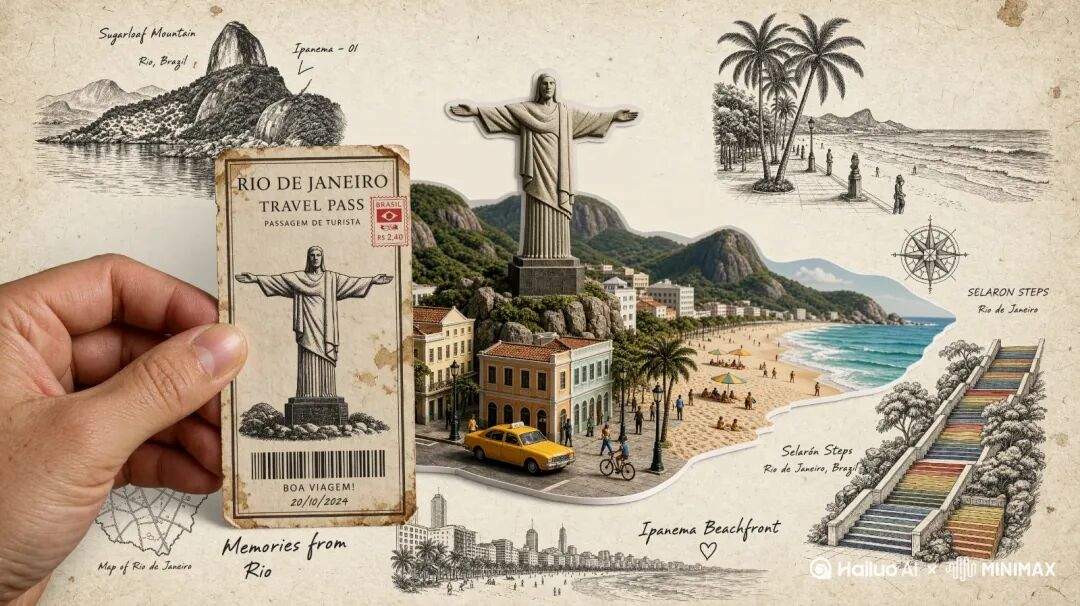
しかもディテールの処理が驚異的だ!
左下のこの手を見てほしい。お気づきだろうか、なんと親指の関節付近にホクロがいくつか足されているのだ!!
拡大して見ても全く粗が出ない。指の皮膚のキメ、関節のシワ、さらには爪の端の自然なツヤと質感まで、くっきりと再現されている。
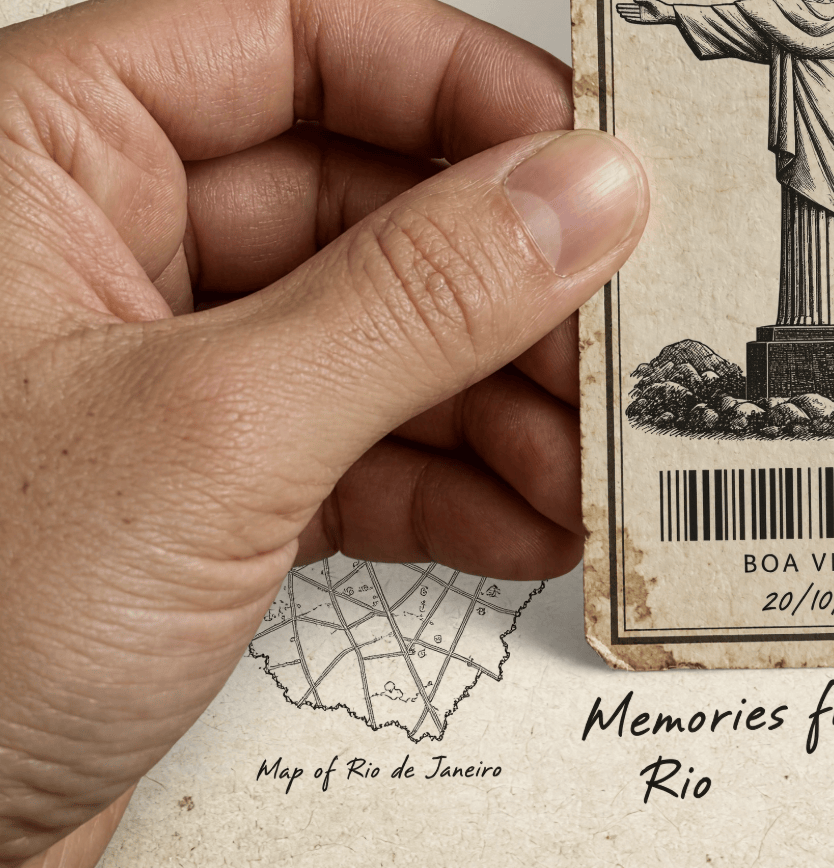
実に興味深い。
H3-Imageからこれほど「AIっぽさ」が消えた理由は、こうした**意図的に作られた「不完全さ(ノイズ)」**に大きく起因しているのだと思う。
人間が主観的に生み出す作品には、必然的にランダム性が満ちている。完璧さを追求しすぎると、かえって人間の脳が情報を受け取る際の自然な感覚からズレてしまうのだ。
だが、これには少しゾッとさせられる部分もある。
私はこれまで、美的センスというものは機械には学習できないと頑なに信じていた。
しかし今や、その裏にあるトリックさえ掴んでしまえば、人間が誇りにしてきた多くの特質も、実はそれほど神秘的なものではないのかもしれない……。
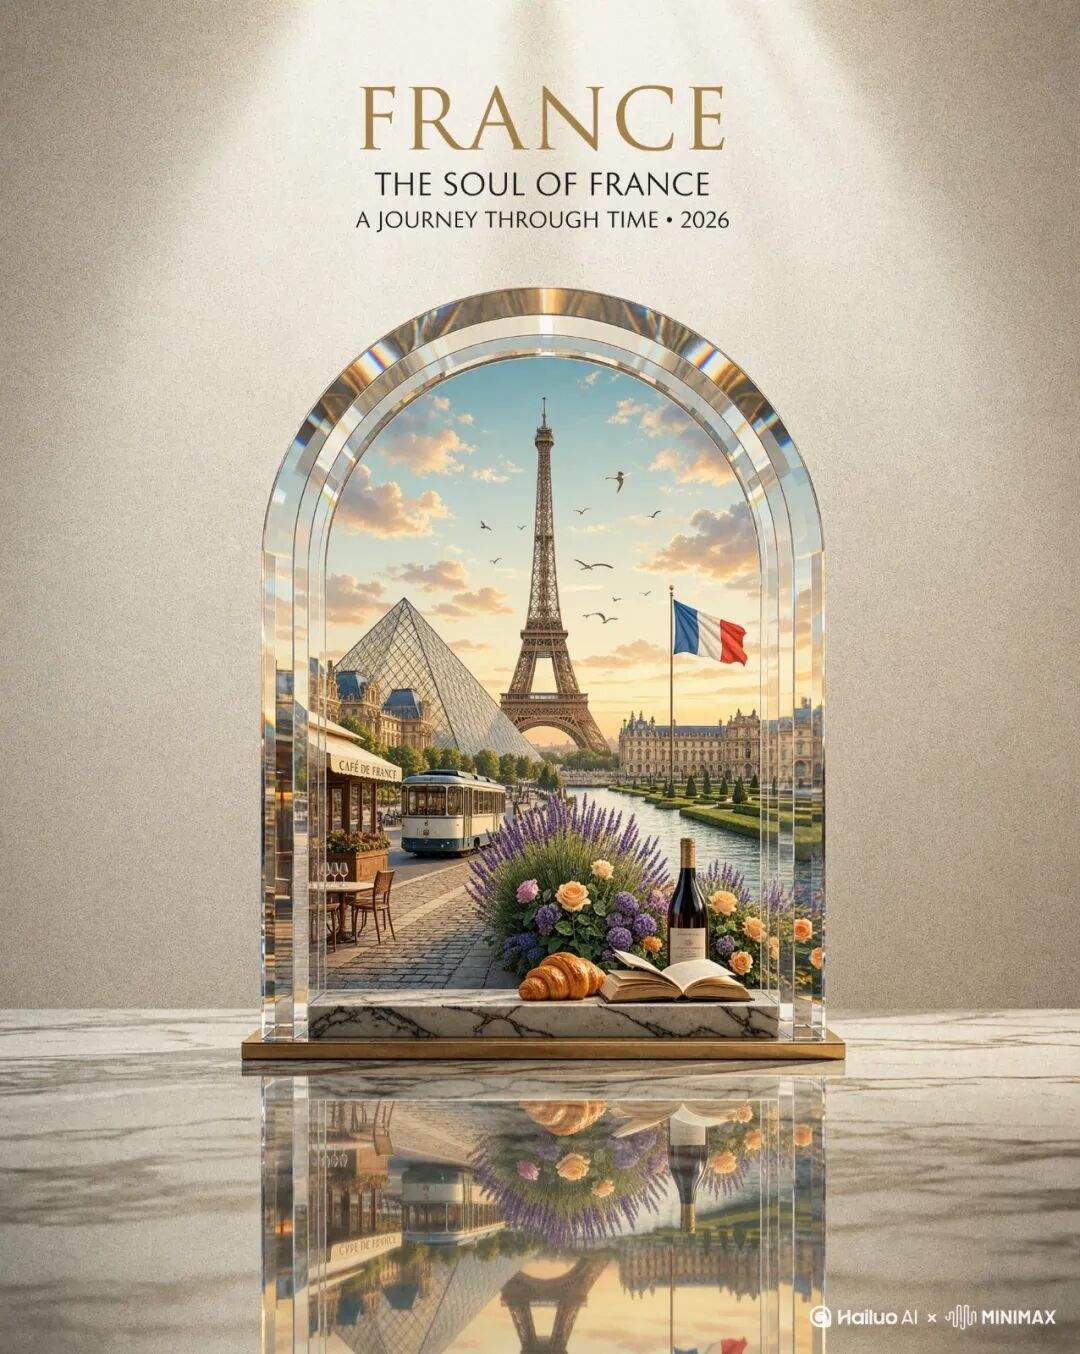
もう一つデモをお見せしよう。H3-Imageでフランスの旅行ポスターを作ってみた。
なんというか、お恥ずかしくてとても評価なんてできない。私の乏しい芸術的素養では、もはやどこがどう凄いのかすら分析しきれないレベルだ。
はぁ。
SOTAレベルの知能
気を取り直して、自分にも理解できるタスクを試すことにしよう。
マルチモーダルモデルに関して、私は常に2つの評価基準を持っている——「美意識(センス)」と「知能(ロジック)」だ。
美意識については上でテストした通りで、かなり感覚的なものなので主観的な感想を語るしかない。
しかし、知能についてはしっかりと掘り下げて語ることができる。
例えば、H3-Imageには非常に特殊なスキルがある——「世界理解能力」だ。
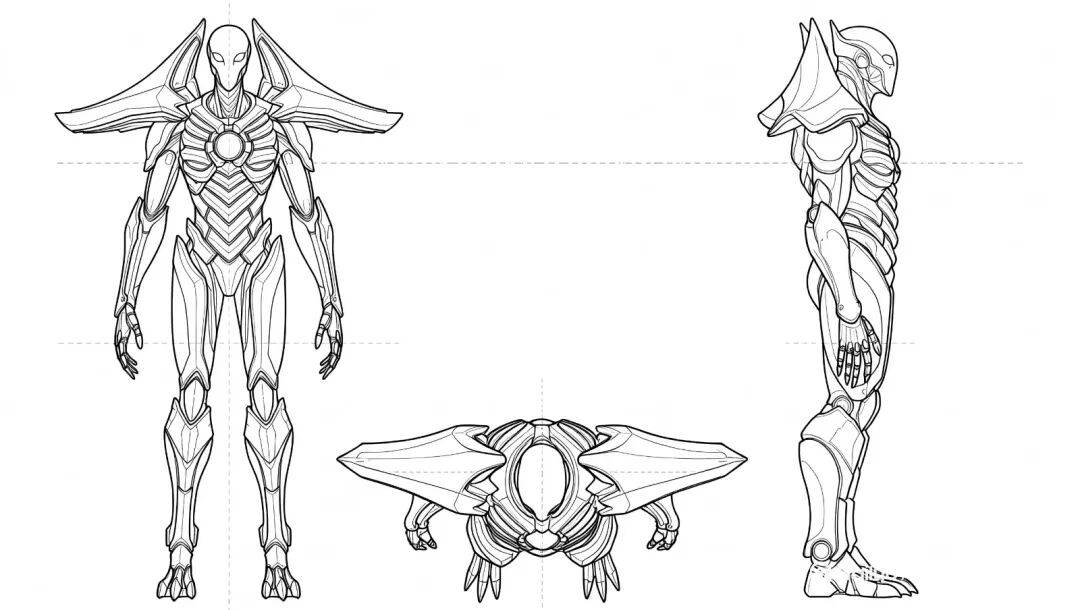
これを使えば、直接CAD図面を生成することができる。
そう、製品の外観画像を1枚与えるだけで、標準的な正投影の三面図を自動的に推論して描き出してくれるのだ——
正面図、側面図、平面図、どれ一つとして欠けていない。
皆さん、私は度肝を抜かれました😭😭。
これだけではない。
CAD図面だけでなく、このモデルに製品を「爆発(分解)」させることもできるのだ。
H3-Imageに機械の分解立体図(パーツ展開図)を描かせると、機械の組み立てロジックに正確に従い、パーツを階層ごとに明確に展開し、さらには引き出し線(リーダー線)まで引いてラベルを付けてくれる。
この裏には間違いなく、3次元幾何学と空間的関係性に対する深い理解が存在している。
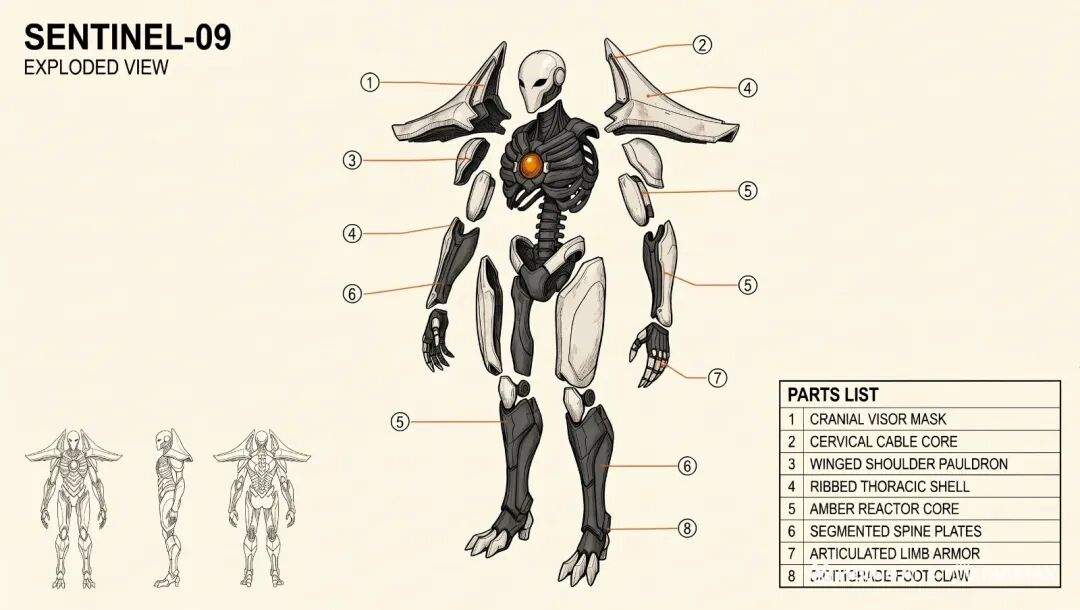
もちろん、こうした機能的な 성격が強い画像においては、指示追従能力(プロンプトの理解力)も非常に重要になる。単に「描く」こと自体の難易度はそれほど高くない。ここで試されているのは、主にモデルのプランニング能力と推論能力だ。
そうでなければ、ユーザーが投げた大量のプロンプトが一体何を意味しているのか、モデルには到底理解できないはずだからだ。
もちろん、本格的な実務やプロダクションの現場に導入するとなれば、求められる基準は当然かなり高くなる。商用利用では情報を正確に伝えることが絶対条件だからだ。
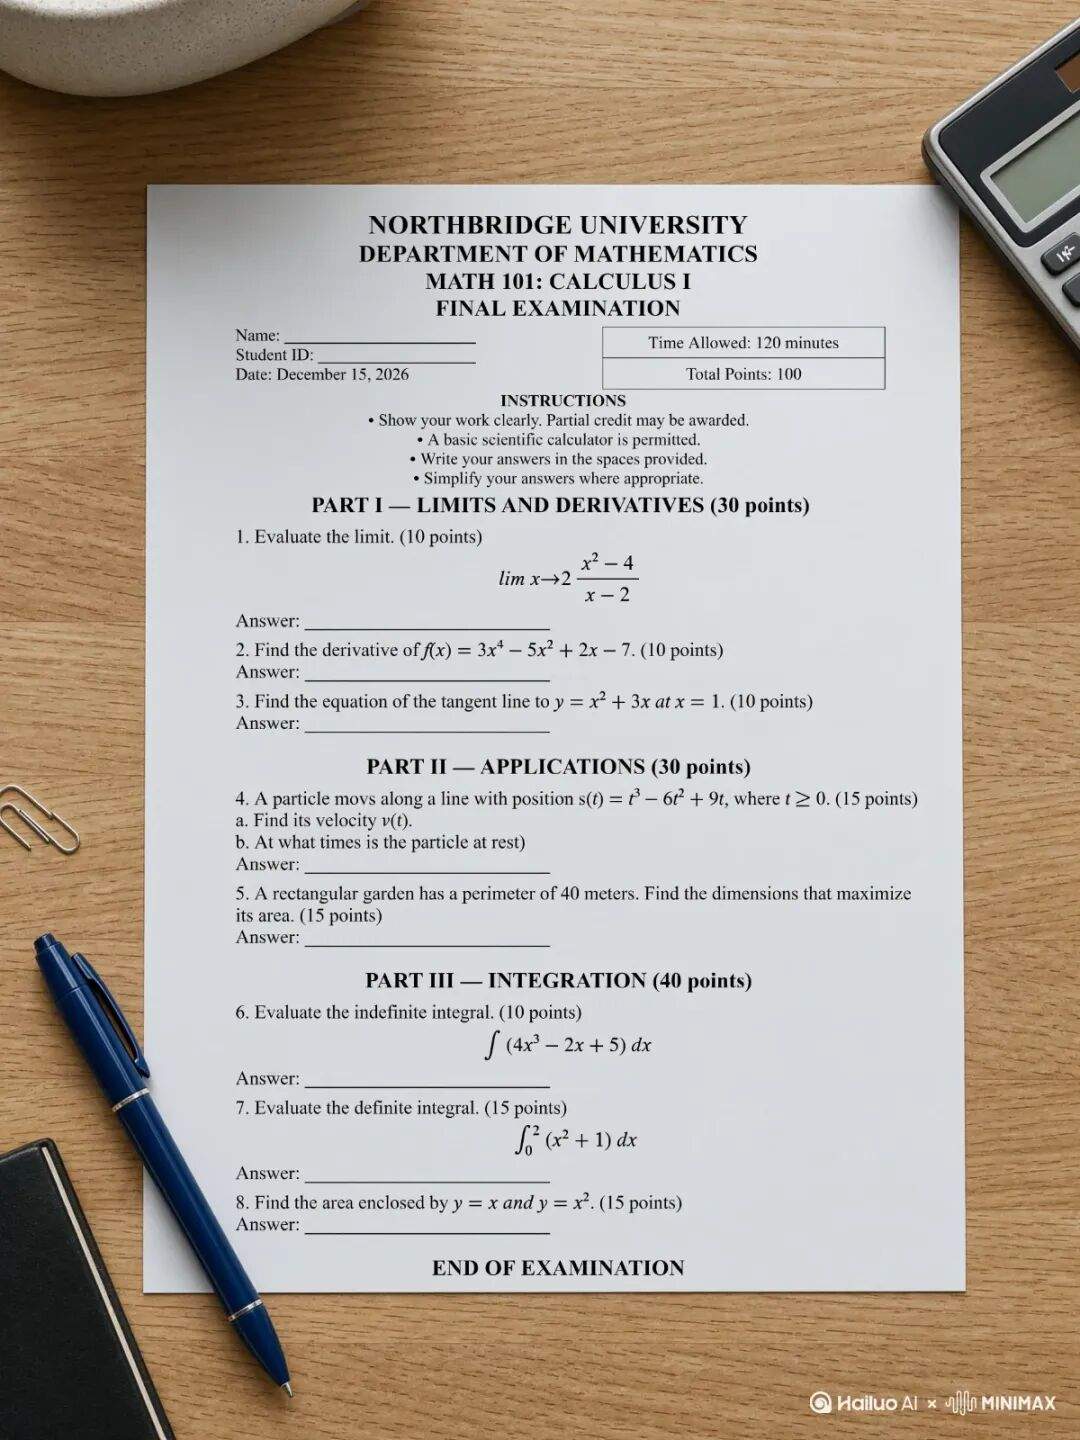
そのため、空間理解に加えて「テキストの組版(タイポグラフィ)」という軸も非常に重要になってくる。
そこで、私はこんなことを試してみた——
大学数学(高等数学)の期末試験問題を生成させてみたのだ。
10秒ほどで生成された。
極限の記号、複雑な積分式……このような高密度な学術系の組版でありながら、なんと文字化けが1文字たりともない。
これだけではまだ簡単すぎるだろうと思い、私はさらに天才的なプロンプトを思いついた。
この試験問題を解きなさい。
生成された画像を開いてみて、私は全身に衝撃を受けた——
画像生成モデルの微分積分のレベルが私より高いって、どういうこと???
単位をギリギリで落第せずに済んだ私の乏しい大学数学の知識を総動員してざっと確認してみたところ、なんと答えが合っているだけでなく、途中式(解法ステップ)まで書かれているではないか!??
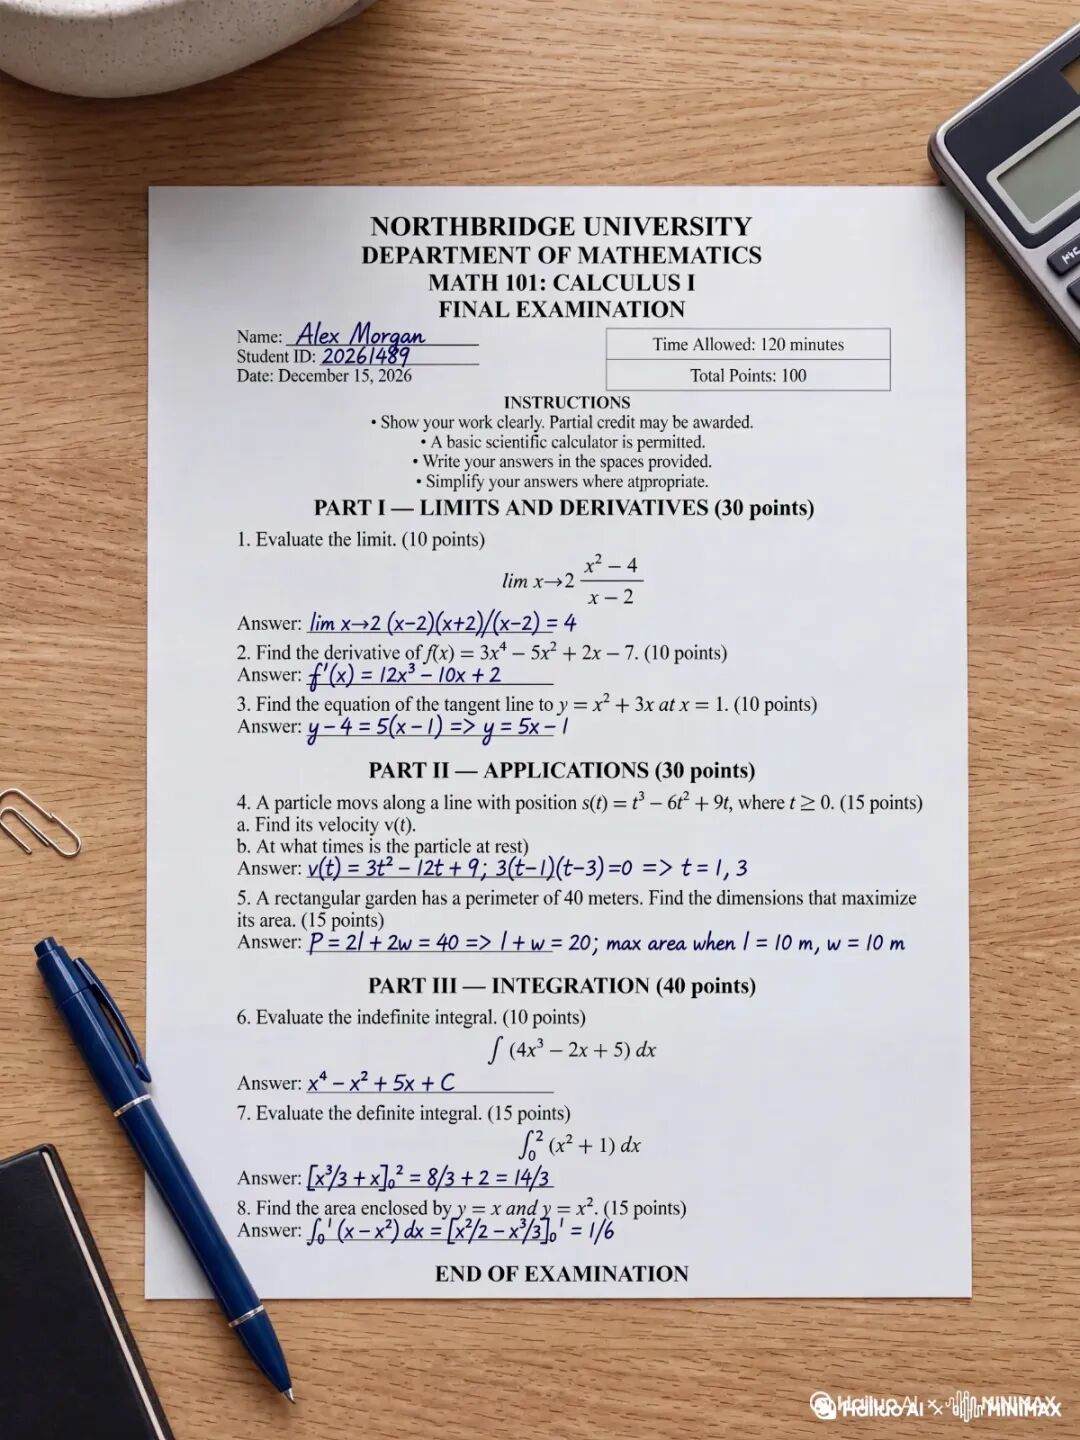
あまりのことに言葉を失ってしまった。
もちろん、画像生成の本業であるアセット生成も忘れてはならない。
最近は「コーディングがすべてを飲み込む(Coding eats everything)」なんて言葉が流行っているではないか? Astraが3Dを圧倒し、Opus 5.5が動画を圧倒する、といった具合に。
しかし私は常々、その多くは単なるポジショントークだと思っている。こうしたテキストとは縁もゆかりもないタスクを、なぜわざわざテキストモデルでやらなければならないのか?
要するに、純粋なテキスト領域の方がリソースが豊富で、発展のスピードが速かったというだけの話だ。
第一原理(ファーストプリンシプル)から考えれば、私はやはり特化型モデル(バーティカルモデル)の道の方を信じている。各領域でそれぞれのモデルを学習させる方が、性能の天井も高くなり、コストも現実的だからだ。
しかも、H3-Imageのような特化型モデルは、それ自体が選ばれし専門モデルであり、汎用モデルと全く矛盾しないどころか、システム基盤(ハーネス)に組み込んでエージェントから直接Tool Call(ツール呼び出し)させるのにうってつけなのだ。
これも最近見え始めているトレンドだ。必ずしも単一のモデルですべてを圧倒する必要はなく、汎用モデルを介して各特化型モデルを連携させる方が、全体としての実用性はむしろ高くなる。
単にプレゼンや展示用のアセット(例えば下のような恐竜のおもちゃ)を生成するだけなら、特化型の画像生成モデルを使う方が明らかに最適解であり、わざわざComputer Useを使って延々と試行錯誤する必要はない。
何しろ今の画像生成モデルにとって、光と影や幾何学といった基本的な物理の常識は、もはや何の問題にもならないのだから。
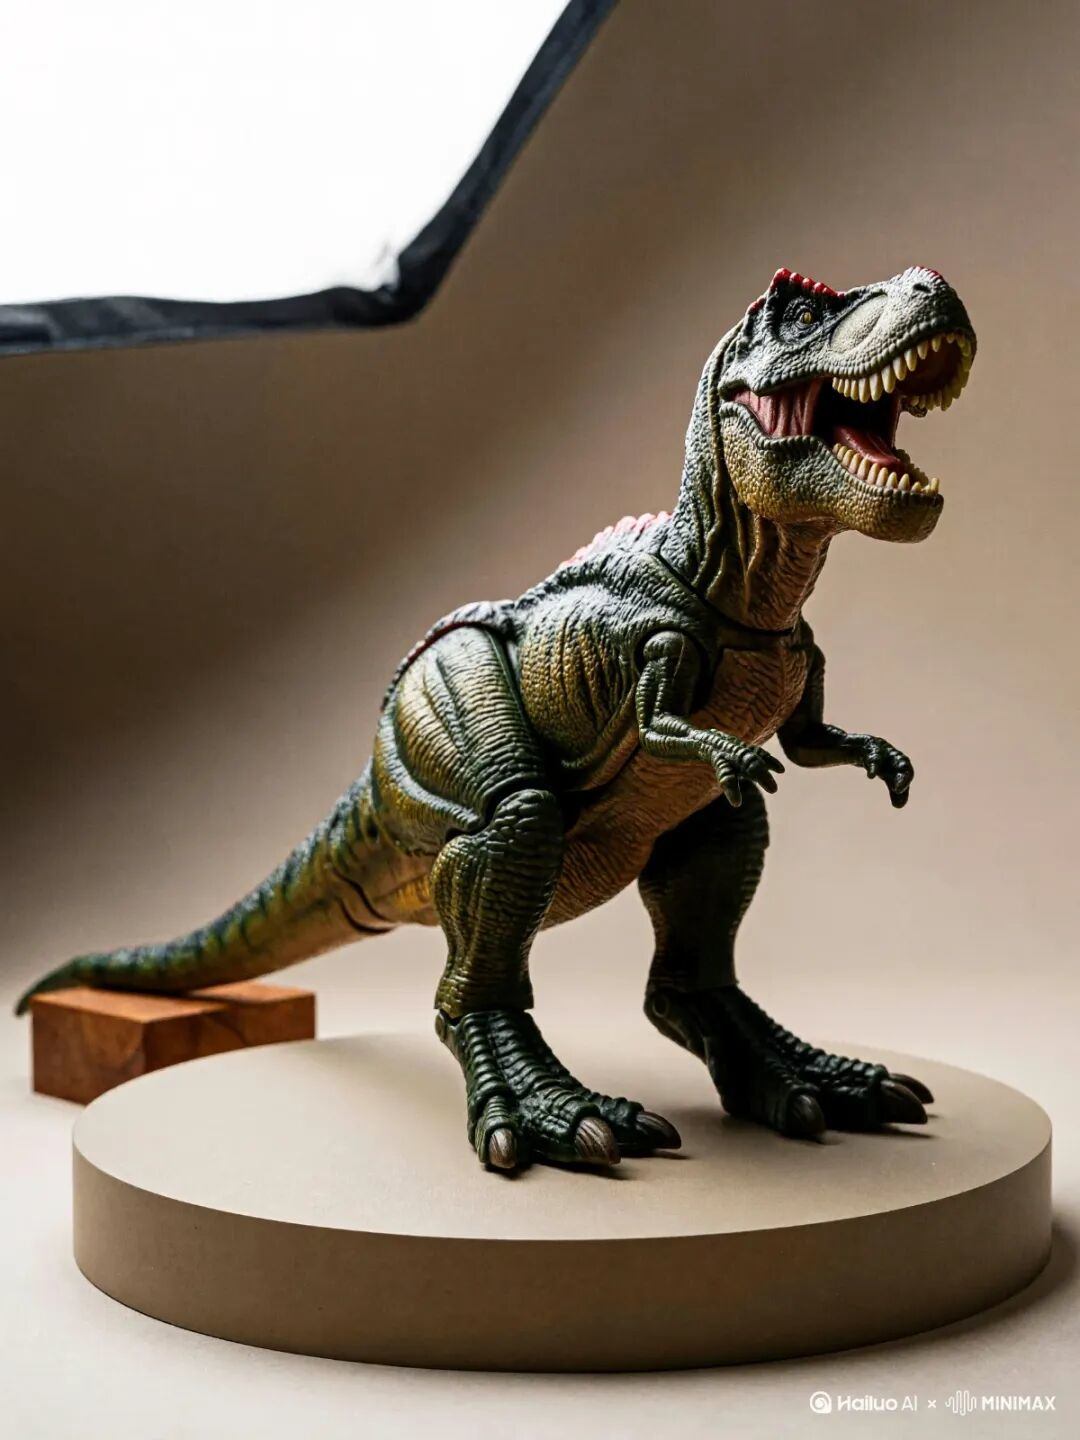
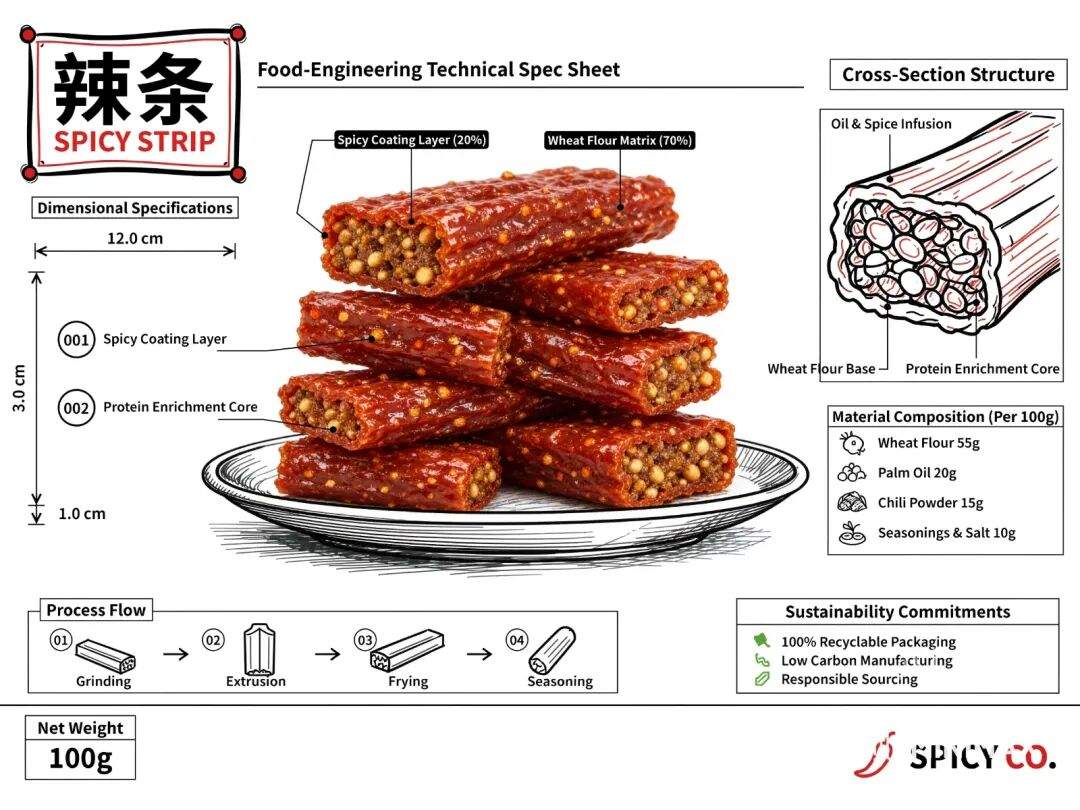
お菓子(スナック)のパッケージ生成なんかも全く問題ない。私がどうやって中国の「辣条(ラーティアオ)」を世界に進出させるか、とくとご覧あれ。
さらには3Dゲームの画面まで生成できてしまう。もはや常識がひっくり返っている😭。
長文の戦術指示テキスト——遮蔽物、火力制圧、側面からの包囲といった指示を投げると、リアルな奥行き感と合理的な遮蔽関係を持った3Dの戦闘シーンを即座に構築してくれる。
ゲーム用語を厳密に理解して反映してくれるため、生成された画像はそのままコンセプトデザインに使えるレベルだ。
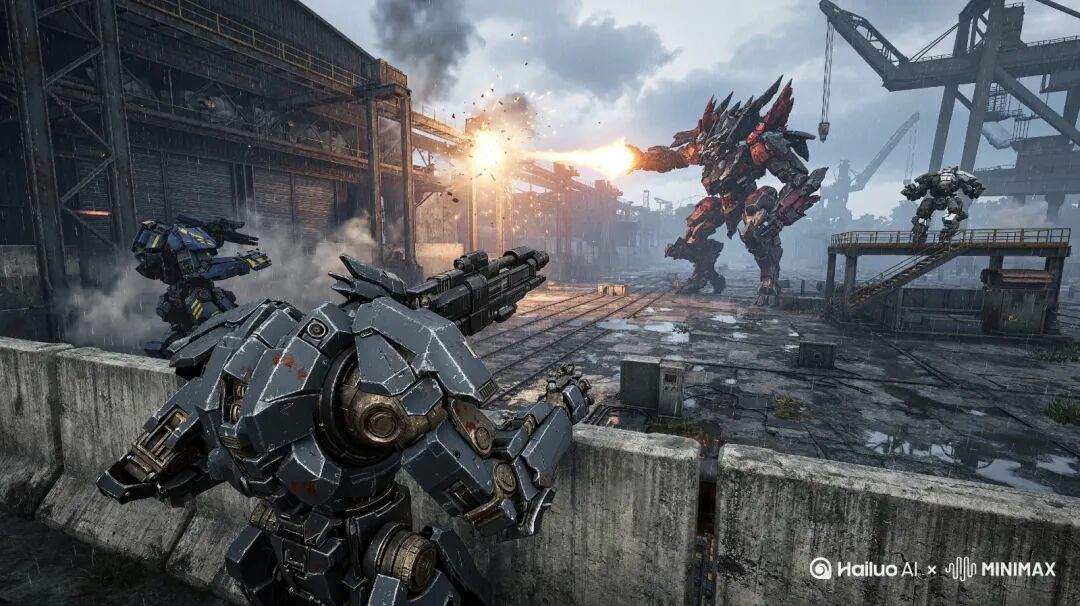
これじゃあ、もうAstra Ultraなんて待つ必要ないじゃないか。どうせデモを見るだけなら、直接画像を数枚生成してしまえばそれで終わりだ。
(なんてね)
マルチモーダル界の「オープンソースの神」
テスト内容はだいたいこんなところだ。これ以外にも、フラッグシップの画像生成モデルとして、H3-Imageはいくつか嬉しい特典を用意してくれている。
最も重要なのは、H3-Imageが解像度を一気に16MP(4096×4096ピクセル)、つまりネイティブ4Kまで引き上げたことだ。
泣けるじゃないか、皆さん。これでようやく、GPTで画像を生成した後にNano Bananaに放り込んで延々とアップスケールや最適化をかける手間から解放されるのだ🥹。
しかも4K画像の生成速度も爆速で、これほど巨大な画像でも、Web版での体感でわずか10〜20秒ほどしかかからない。
まあ、そうは言っても、GPTがのろのろと画像を生成している待ち時間に、楽しくスネークゲームで暇つぶしをするのが嫌いな人なんていないだろうけど(なんてね)。
話が逸れた。
これらに加えて、H3-Imageにはもう一つかなり特別なパラメータがある——
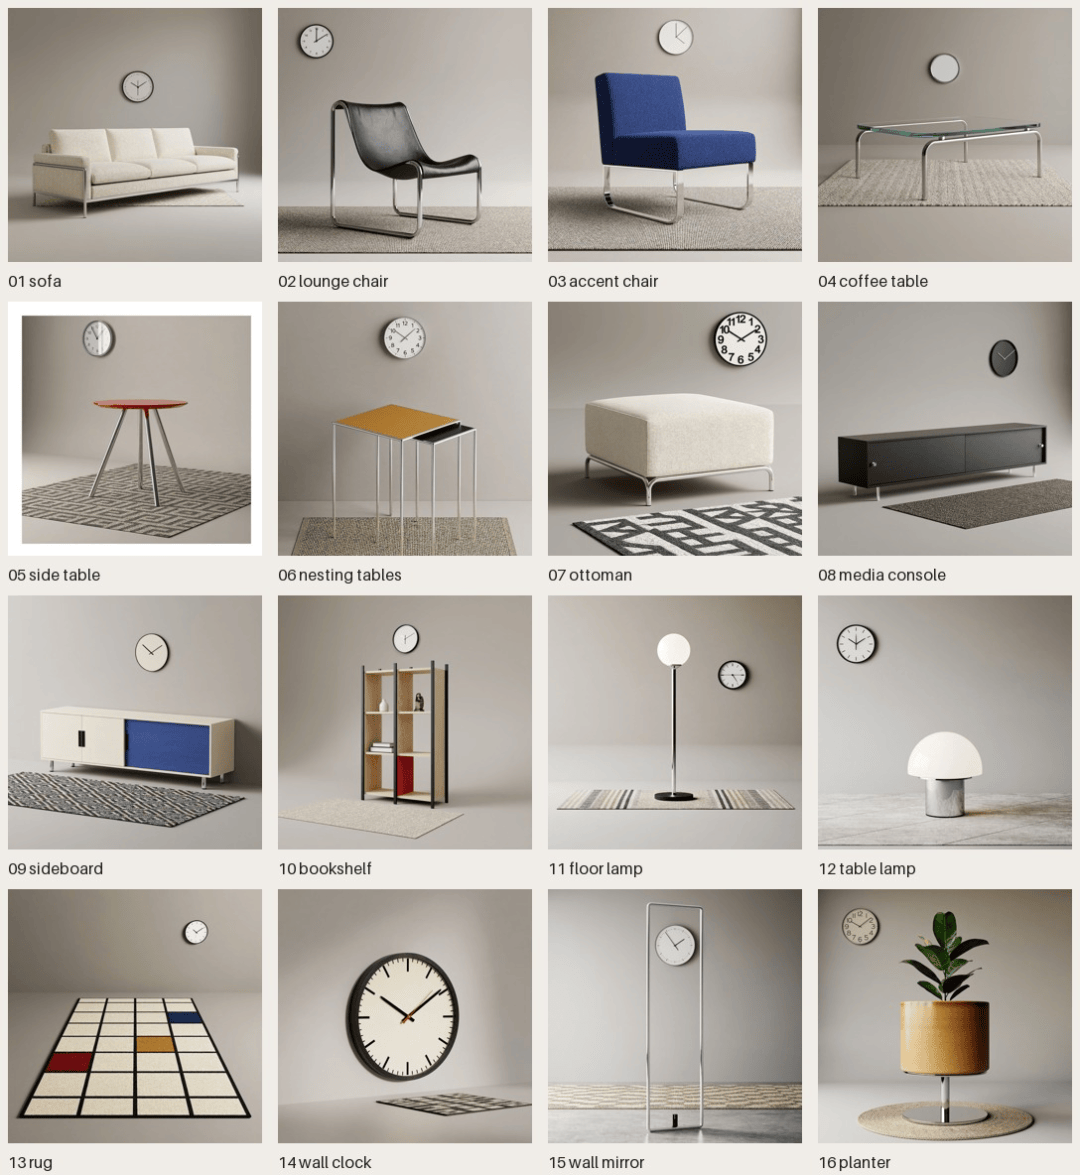
最大16枚の参照画像の入力に対応しているのだ。
まさに容量マックスで、完璧主義者にとっては福音と言えるだろう。キャラクターの一貫性や複雑な絵コンテの連続性において、クリエイターにかつてないほどの自由度をもたらしてくれる。
4Kでの日常的なクリエイティブ制作が、本当の意味で普及する時代が来たのだ。
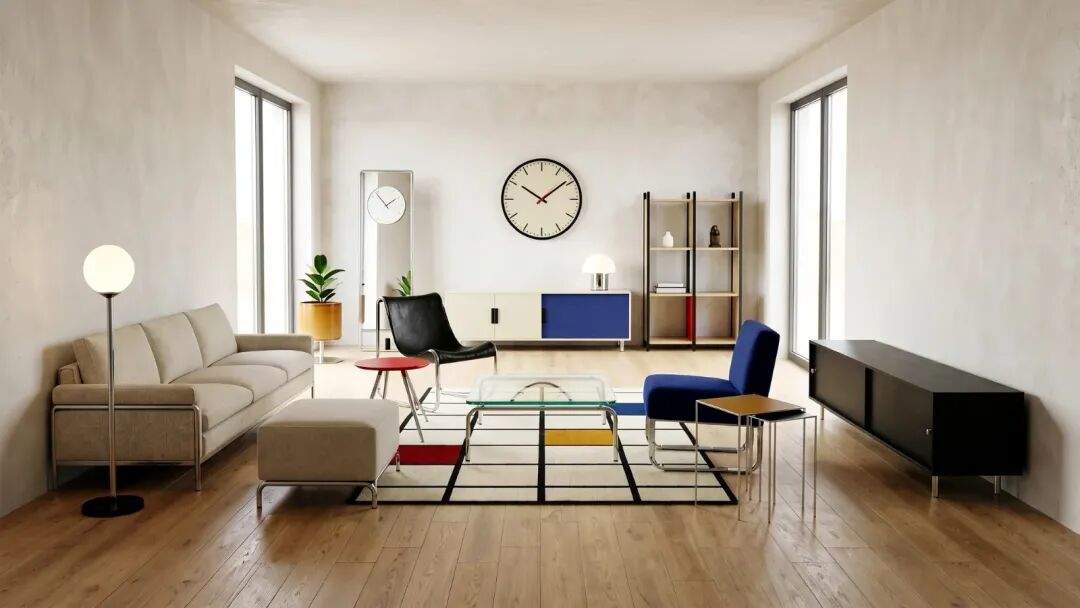
その結果どうなるかというと、参照画像を適当に数枚放り込んで、水を一口飲んでいる間に……
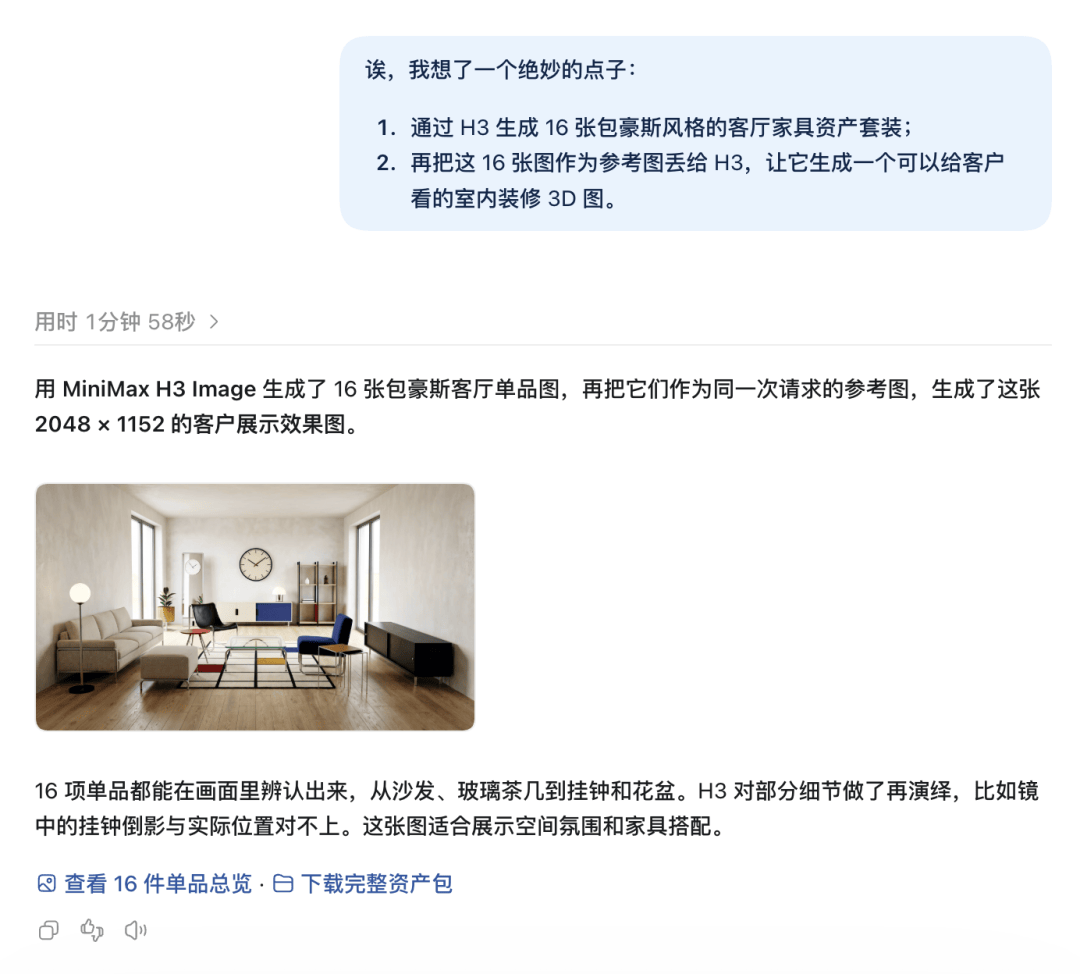
このクオリティのインテリア完成予想図(パース)が手に入るのである。
これじゃあ、もうBlenderなんていらないじゃないか😭。
だが、私が何より思いもよらなかったのは——
このH3-Imageが、なんとオープンソースだということだ???
以前SOTAレベルの動画モデル「H3」をオープンソース化したのに続き、MiniMaxが再び動き出し、世界中の開発者に自由にカスタマイズ可能なSOTAの基盤モデルをプレゼントしてくれたのだ。
マルチモーダル界のオープンソースの神、もはや言葉はいらない。
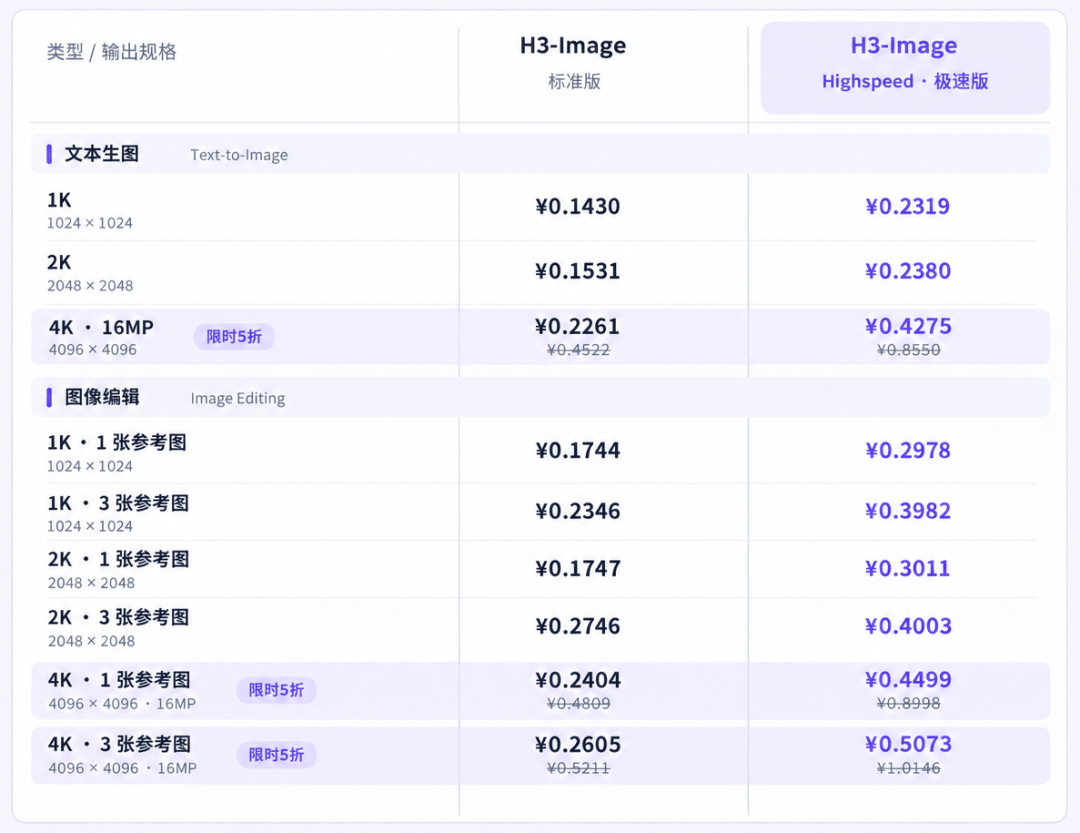
もちろん、ローカル環境の構築に手間をかけたくない人にとっても、そのAPI利用料は捨て値同然の安さだ。
価格は主流の競合製品の50%〜70%に抑えられており、リリース初週は16MPのリクエストがさらに半額になる(みんな、今すぐ突撃だ!!)。
ここまでテストしてみて、ふとこんな予感がした——
マルチモーダル生成は今、まさに自分たちの「コーディングの瞬間(Coding Moment)」を迎えようとしているのかもしれない。
これまでAI画像生成がビジネス現場でしばしば「おもちゃ扱い」されてきたのは、主にディテールが精査に耐えられず、プラスチックのような不自然さが強すぎて、どのクライアント(発注者)に見せても難色を示されたからだ。
しかし今、H3-Imageは3つのことを成し遂げた——
脱・AIっぽさ、汎用性の高い美的センス、そして緻密なロジックだ。
これらの条件が満たされた時、マルチモーダルのアプリケーション市場は間違いなくコーディング領域に引けを取らない規模になる。
高精度の工業パッケージデザインや商業イラストから、多言語展開する越境ECのマーケティング素材に至るまで、新世代の画像生成モデルの登場は、従来のワークフローのサイクルを大幅に短縮してくれるはずだ。
そこに先ほど挙げたバフ(強み)が重なる。爆速 + オープンソース + 低価格……。
これが一体どんな未来をもたらすのか、もはや想像すらつかない。
最後に、やはり現在のAI業界全体に目を向けてみよう。
世界中のAI企業の視線がほぼすべて純粋なテキスト領域に集中している中、MiniMaxは依然としてそのリソースの大部分をマルチモーダルの世界に注ぎ込んでいる。
これもまた、同社が一貫して持ち続けている特徴だ。最初からマルチモーダルに賭け続け、今ついにその能力の創発(エマージェンス)を迎えたのである。
世間では「AGIにとってマルチモーダルは重要ではない、コーディングにこそビジネスモデルがある」なんて言われているが……
私は常々思っているのだ。もしAIの定義の中にテキストしか入り込む余地がないのだとすれば、そんな未来はあまりにも退屈すぎる、と。
動画生成の勢力図を塗り替えたH3から、今こうしてロジック、構造、そして美的センスにおいて全面的なブレークスルーを果たしたH3-Imageへ。
中国発のオープンソースという野火は、すでにマルチモーダル領域へと完全に——
燃え広がり始めている。