
2026年11月11日 科学
Adam Gayoso、Natasha Latysheva、Pushmeet Kohli、Žiga Avsec
私たちの次世代 DNA 配列モデルは、シングルセル生物学とヒト遺伝学の架け橋となり、遺伝子変異が数百種類のヒト細胞型にどのような影響を与えるかを予測します。
本日、次世代モデルである AlphaGenome 2 を正式に発表します。このモデルは、DNA 配列とその変異が特定のヒト細胞型にどのように影響するかを予測でき、科学者が疾患の細胞レベルの要因を解明するための強力な新しいツールを提供します。
細胞は生命の基本的な構成要素です。私たちの体内のすべての細胞は同じ DNA の設計図を持っていますが、それぞれの細胞型や状態(たとえば心筋細胞や、感染症と闘っている免疫細胞など)は、異なる遺伝子のオン・オフを切り替えることでその役割を果たしています。「ヒト細胞アトラス(Human Cell Atlas)」などの世界的なプロジェクトによって数百万個の細胞の遺伝子発現マップが作成されていますが、わずかな DNA の変異が細胞内のこうした発現にどう影響するかを予測することは依然として未解決の課題であり、これこそがヒトの形質や疾患を決定づける重要な要因となっています。
昨年、私たちは幅広い組織における分子活動に DNA 変異がどう影響するかを予測する AlphaGenome を発表しました。その後、ヒトゲノム内の起こり得るすべての単一塩基変化(single-letter changes)90億通りの予測を網羅したプラットフォーム、AlphaGenome Atlas によってその応用範囲を拡大しました。これらのツールは、研究者が変異の影響に優先順位を付けて解釈するのに役立ち、希少疾患、複雑な形質、基礎生物学の分野における発見を後押ししました。
研究の視点を大まかな組織の平均レベルから個々の細胞型や細胞状態へと絞り込み、モデルアーキテクチャを再設計することで、AlphaGenome 2 は変異予測の性能において飛躍的な向上を遂げました。重要なのは、大まかな組織モデルでは見落とされてしまう疾患関連細胞における変異の影響を予測できるようになり、モデルにとって未知の細胞や疾患状態に対しても予測を行えるようになった点です。
これまでの最先端(SOTA)モデルと比較して、AlphaGenome 2 が特定した「細胞の遺伝子発現を変化させる変異」の数はほぼ倍増しました。このモデルは68種類の組織にわたる1億個以上のシングルセルプロファイルデータでトレーニングされており、静的な細胞アトラスをヒト遺伝学の予測エンジンへと変貌させます。AlphaGenome 2 は本日より、AlphaGenome API を通じて非商用研究向けに公開され、商用研究向けにはプライベートプレビュー(private preview)として提供されます。
特定の細胞型に向けた AlphaGenome の再設計
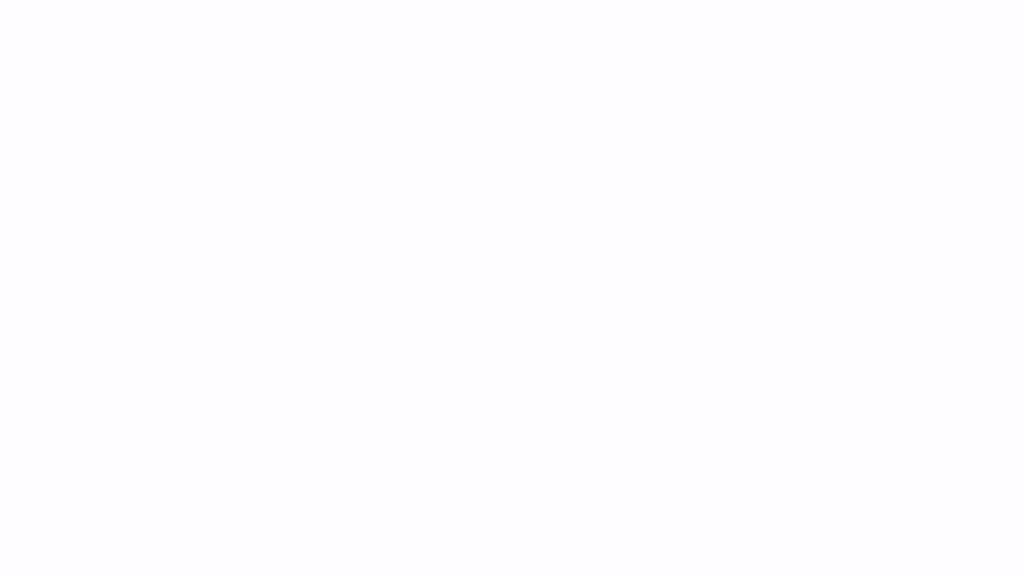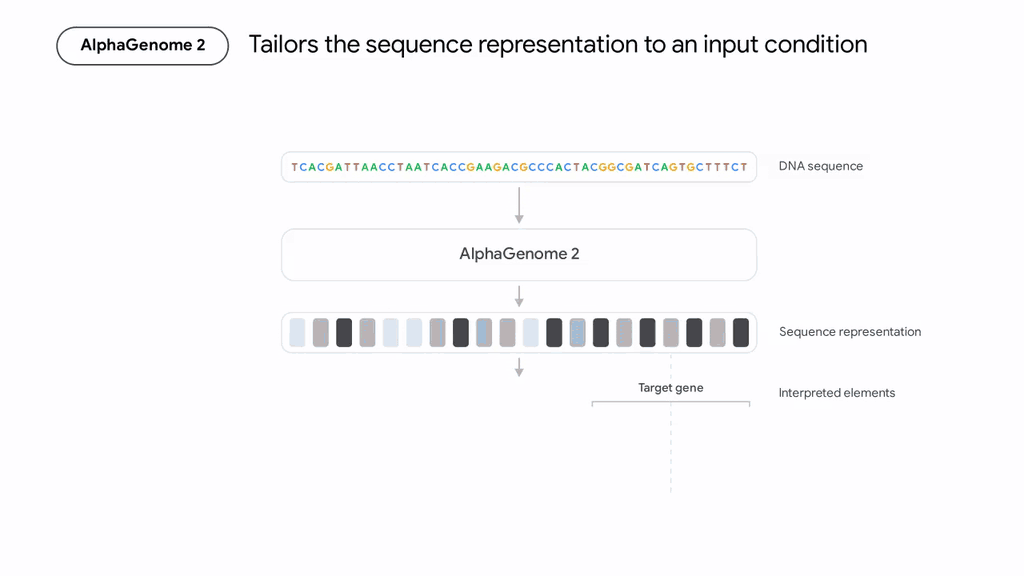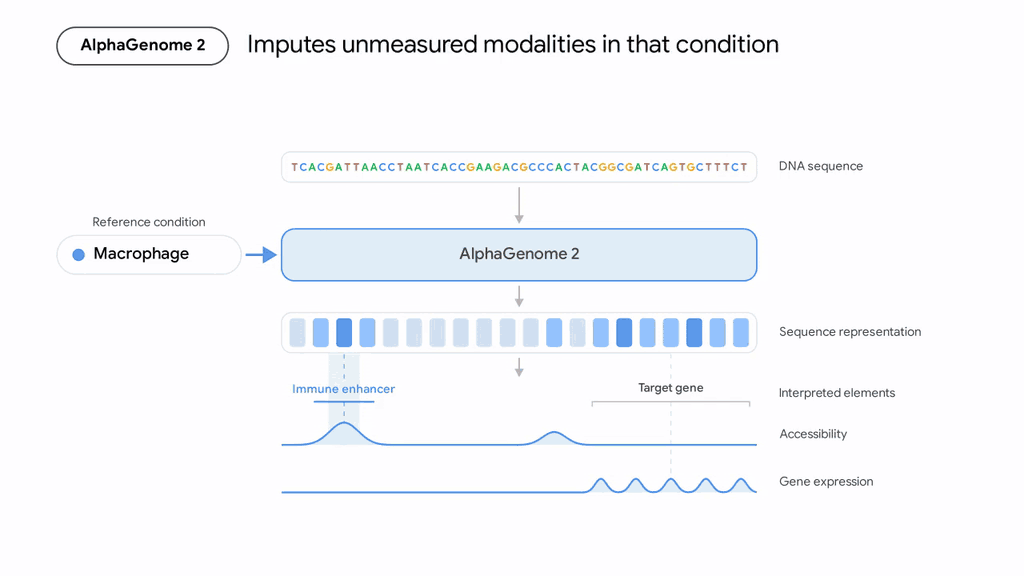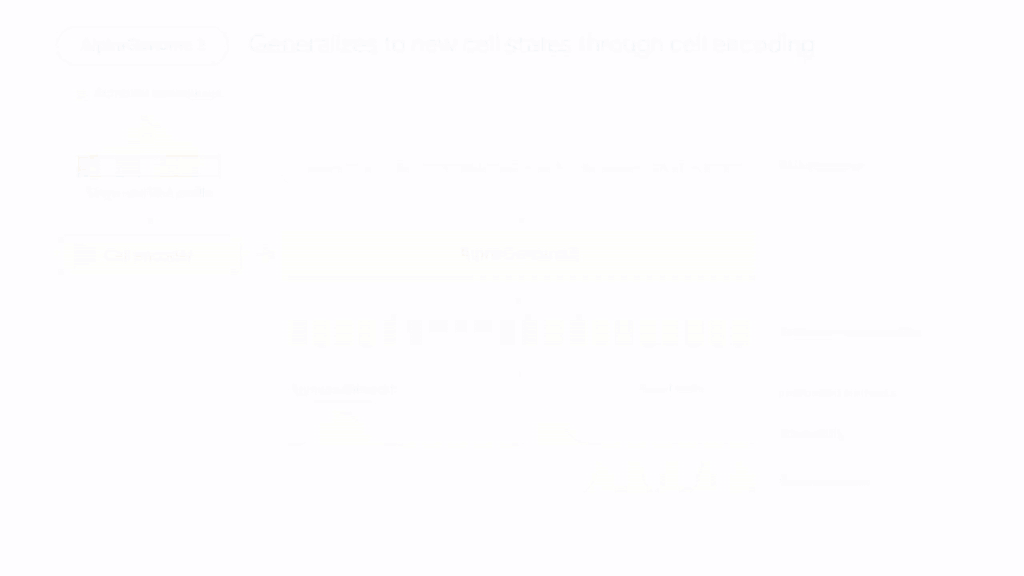
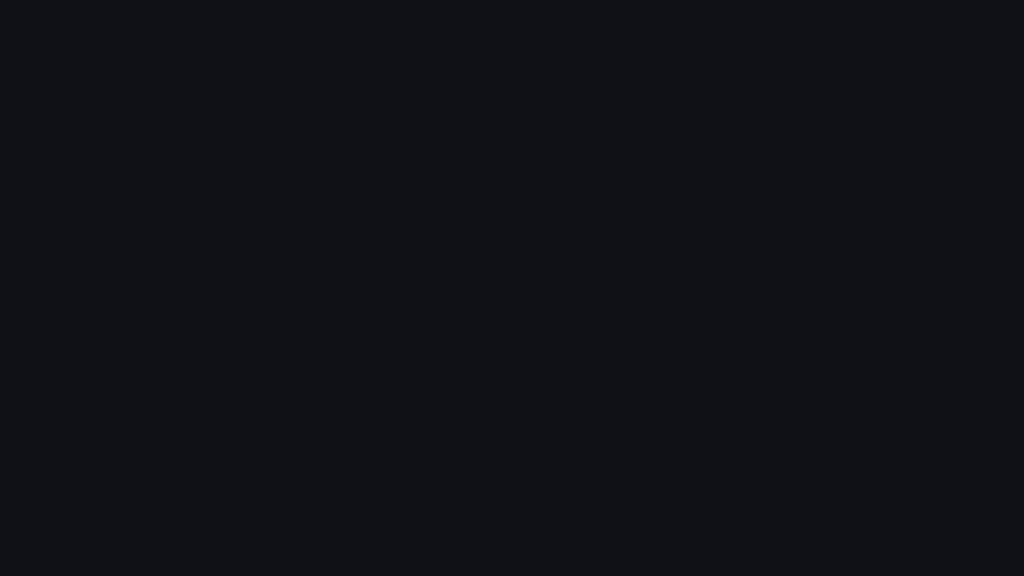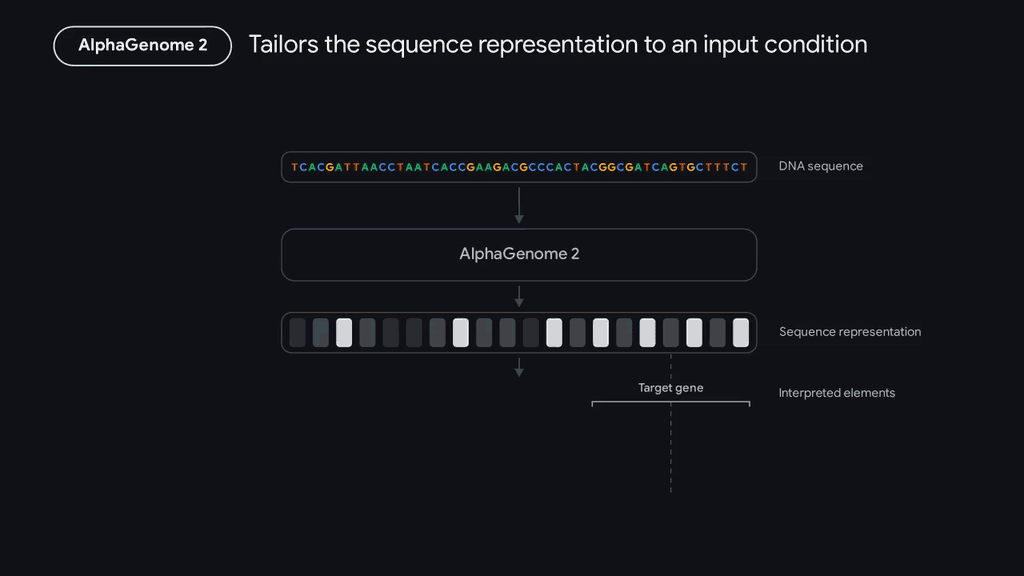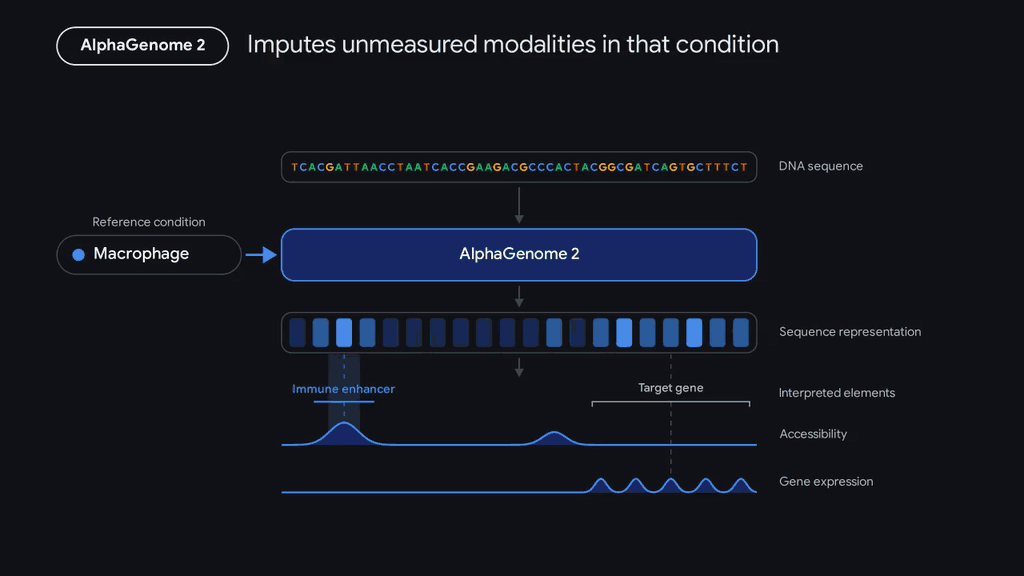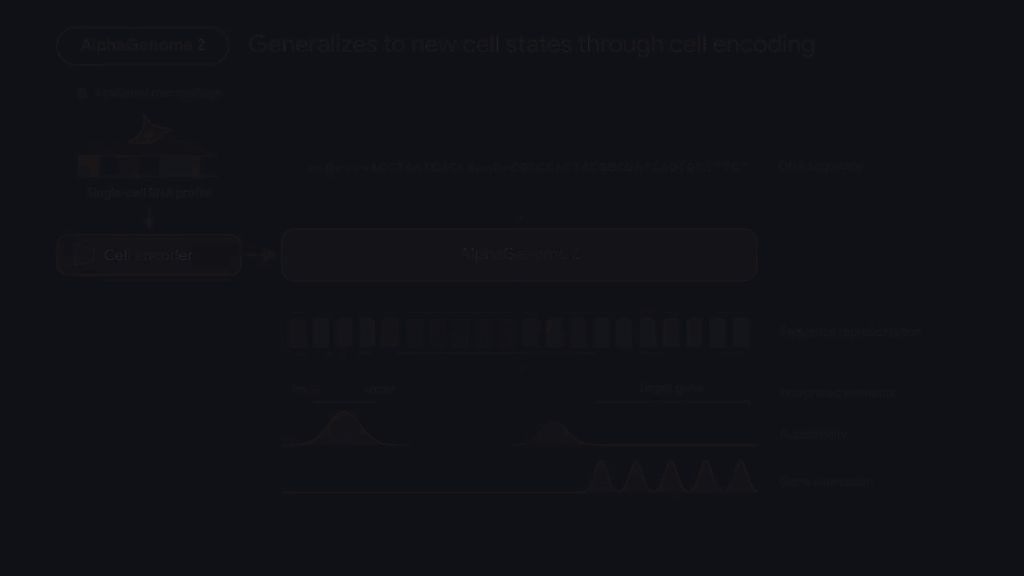
AlphaGenome 1 と 2 における細胞型の処理方法の比較。AlphaGenome は、100万塩基の DNA 配列から、固定数のバルク組織(bulk tissues)および細胞株の出力を並列に生成します。一方、AlphaGenome 2 は条件付きモデル(conditional model)であり、入力として DNA 配列を受け取ると同時に、特定の生物学的条件を受け取ります。この条件は、参照用の細胞型カタログから選択することも、科学者自身のシングルセル実験に基づいて当社のセルエンコーダー(cell encoder)を介してリアルタイムに生成することも可能です。
初代 AlphaGenome モデルは、100万塩基を含む DNA 配列を入力とし、複数の組織にわたる数千の実験の特性を一度に予測していました。この並列アプローチは効率的である一方、モデルのキャパシティが分散してしまい、近縁の細胞型間の微細な違いを捉えることが困難でした。
これを改善するため、私たちはモデルが細胞型を処理する方法を根本から再設計しました。AlphaGenome 2 は並列予測を行うのではなく、条件付きモデルとして機能し、一度に1つの条件(組織、細胞型、または状態として定義される)のみに絞って DNA の影響を予測します。100万塩基の DNA 配列に加え、アーキテクチャの各段階でターゲットとなる生物学的条件を入力として受け取ります。これにより、同じ DNA 配列が異なる細胞型でどのように異なって読み取られるかを学習できるようになりました。
また、条件付きモデルはクロスモダリティ補完(cross-modality imputation)もサポートしており、AlphaGenome 2 は欠損している実験データを予測することができます。このモデルは細胞の生物学的状態をその出力から切り離しているため、科学者が1つの測定データ(シングルセルの遺伝子活性など)を入力するだけで、AlphaGenome 2 は未測定の特性(クロマチンアクセシビリティなど)を予測できます。これは、研究者が次の実験の優先順位を決定する際に役立ちます。
私たちは、1億700万個以上のシングルセルプロファイルを含む、ヒトおよびマウスサンプルのバルク(bulk)データとシングルセルデータを使用して AlphaGenome 2 をトレーニングしました。初代モデルのバルク組織の平均値を超え、AlphaGenome 2 は特定の細胞(異なる心筋細胞や血中の免疫細胞など)内部の活動を解析できるため、特定の細胞型でのみ機能する重要な DNA 変異を発掘するのに役立ちます。
このモデルは、遺伝子発現、ヒストン修飾、クロマチンアクセシビリティなど、AlphaGenome と同じ主要な DNA 機能実験のリードアウト(readouts)を予測するだけでなく、要望の多かった DNA メチル化(DNA methylation)のリードアウト予測も新たに追加されています。
AlphaGenome 2 のエキサイティングな点は、新しい s に直接適応できることです。