
2026年11月11日公開
マルチベクトル埋め込み(Multi-vector embedding)モデルでは、各クエリトークン(Query token)がドキュメント内で独立して一致箇所を見つけることができます。これにより検索タスクにおいて非常に高い表現力を発揮しますが、それに伴いドキュメントのベクトル数も急速に膨れ上がります。数百万のドキュメントを含むコーパスでは、数億個ものベクトルに達することもあります!
トークンプーリング(Token pooling)は、類似したトークンベクトルを結合することで、これらの表現のサイズを縮小します。しかし、圧縮を積極的に行えば行うほど、有用な情報が失われやすくなります。プーリング考慮型トレーニング(Pooling-aware training)は、ベクトルを結合する際に重要な情報を保持するようエンコーダーに学習させることで、同じストレージ予算内でより優れた検索結果を得るのに役立ちます。
この記事では、プーリングの仕組みを解説し、Sentence Transformers を使用して圧縮検索用のモデルをトレーニングした上で、そこから生じる品質とストレージのトレードオフについて考察します。pool_factor=4(プーリング係数4)の設定において、通常の方法でトレーニングしたモデルでは、ドキュメントベクトルを 4分の1 に削減しつつ、プーリングなしの場合の NanoBEIR nDCG@10 の性能を 94.6% 維持しました。一方、同じストレージ予算でトークンプーリング考慮型トレーニングを行った場合、この維持率は 97.8% にまで向上しました!具体的にどのように実現するのか見ていきましょう。
本記事は、Stefan Josef の Learn to Pool および LightOn のプーリング正則化に関する研究で議論されているプーリング考慮型トレーニングをベースにしています(後者ではターゲットを絞ったトレーニングや適応型予算についても探求されています)。ここでは、この手法の理解を深め、Sentence Transformers を使った短く再現可能な例を通じて実践に落とし込むことに焦点を当てます。
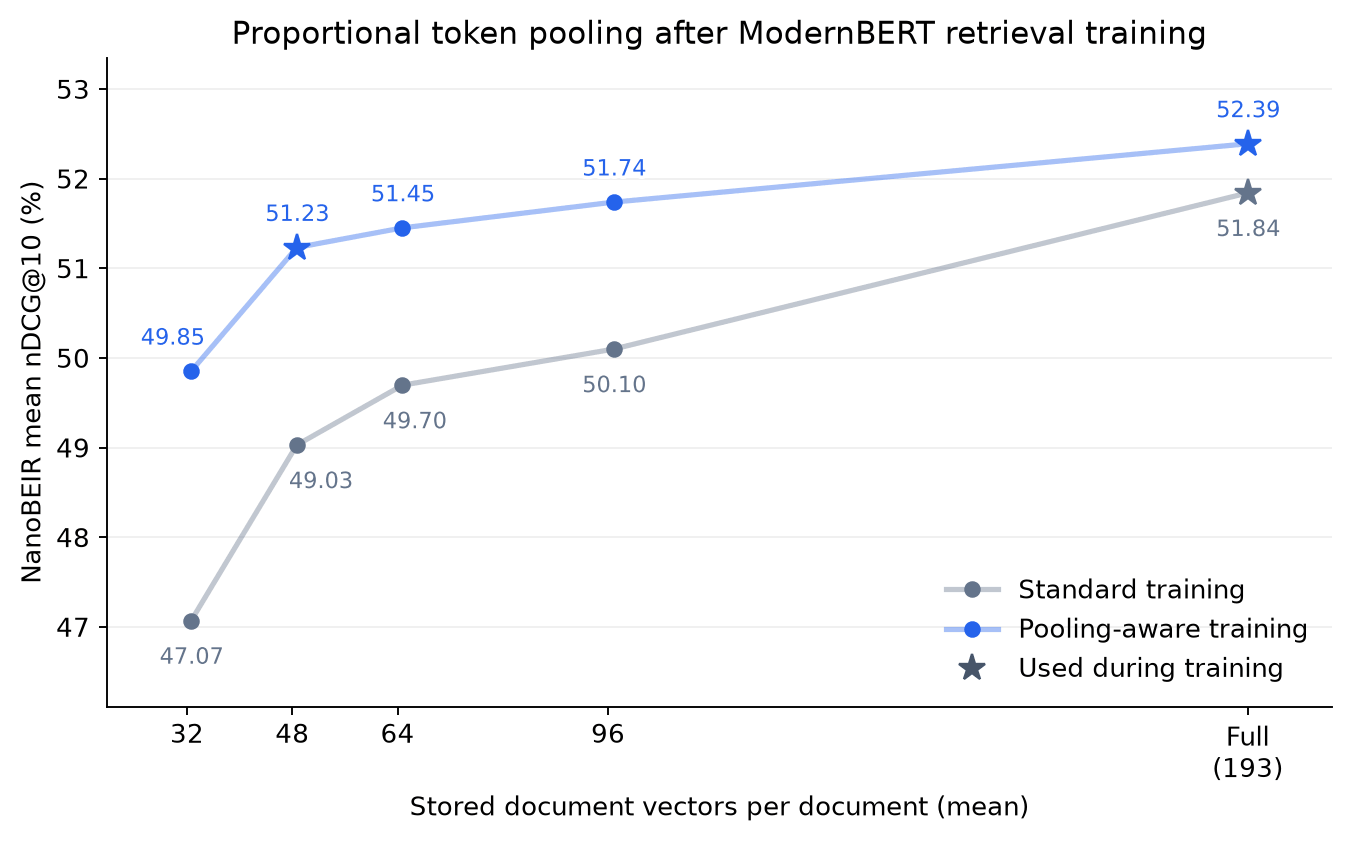
プーリング考慮型トレーニングにより、同じベクトル予算で検索品質が向上します。詳細は以下の通りです。
目次
なぜマルチベクトル検索にはこれほど多くのベクトルが必要なのか
シングルベクトル埋め込みモデルは、ドキュメント全体を1つのベクトルに圧縮します。一方、ColBERT のようなマルチベクトルモデルは、文脈化されたトークンベクトルのセットを保持するため、クエリの異なる部分をドキュメントの異なる部分と照合することができます。
たとえば、「バッテリーが長持ちするノートパソコン」に関するクエリであれば、ドキュメントのある部分でノートパソコンに関する根拠を見つけ、別の部分でバッテリーの持続時間に関する根拠を見つけることができます。MaxSim(最大類似度)スコアリングメカニズムを通じて、各クエリベクトルは最適な一致箇所を選択します。