
全員起立!1年半の時を経て、NVIDIAの次世代ロボット基盤モデルがついに登場しました!
先ほど、今年オースティンで開催されたCoRLカンファレンスにて、NVIDIAのGEAR責任者であるYuke Zhu氏とJim Fan氏が、新世代のワールド・アクション・モデル(世界行動モデル)を披露しました。それが——
GR00T 2です。
1分半の公式デモ動画では、GR00T 2がハサミでタグを切る、グラフィックボードを取り付ける、マッチを擦る、バナナを切って朝食を作る、こぼれたコーヒーを拭く、テーブルを片付ける、ポップコーンを売るといった動作を見事にこなしています。
一見してわかる通り、ほぼ何でもこなせる万能ぶりです。両手を使った精密な作業から全身の移動まで、このモデルがカバーするタスクの範囲は、ロボットに求められるあらゆる能力の方向性をほぼ網羅しています。
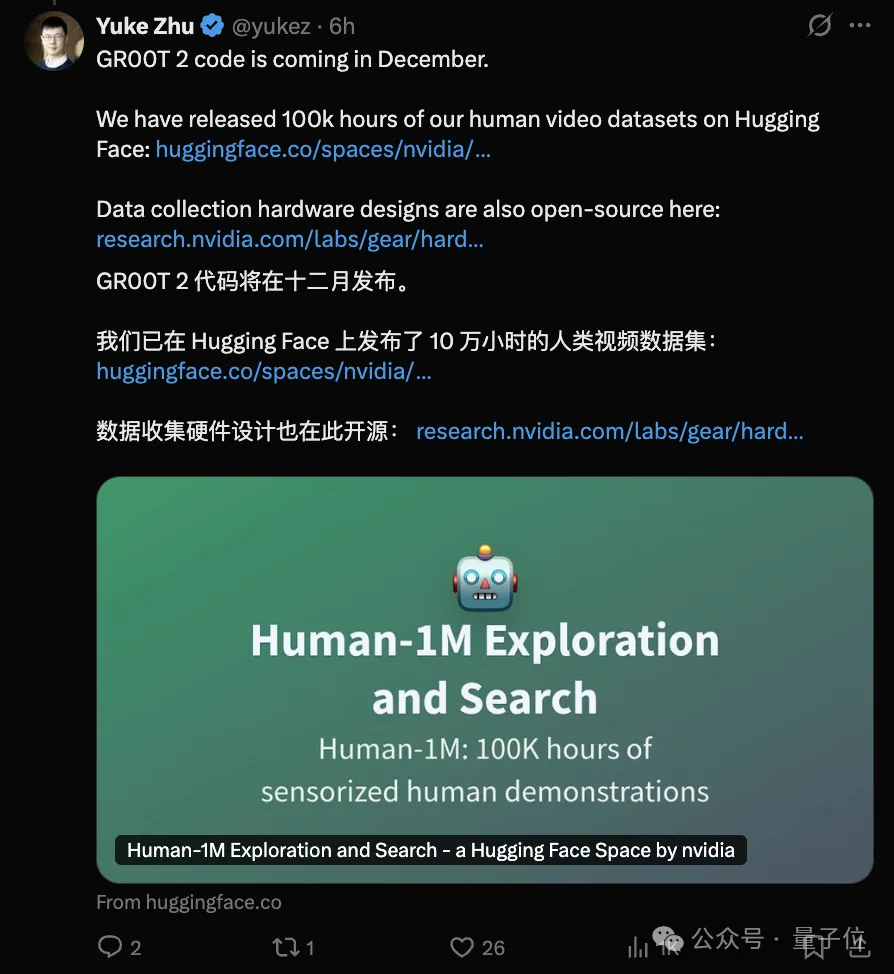
さらにYuke Zhu氏によると、GR00T 2のモデル、データ、シミュレーション環境、およびデータ収集ハードウェアも順次オープンソース化される予定です。
現在、まずは10万時間におよぶ人間のデータが先行公開されています。
ここでみんなで一言、「さすがNVIDIA、神がかってる!」と叫んでも大げさではないですよね?
GR00T 2:ロボット基盤モデルの汎化性能、器用さ、適応能力の拡張
ワールド・アクション・モデルとして、GR00T 2は未来の映像とロボットの動作を同時に予測できます。トレーニング時には、「世界がどのように変化するか」と「ロボットがどのように行動すべきか」をセットにして学習します。
発表会でJim Fan氏は、このモデルを「反応が十分に速く、ローカルで実行可能でありながら、デモンストレーションによって簡単に学習させることができ、推論モデルからの誘導も受けやすい『System 1(速い思考システム)』の物理スキルモデル」と位置づけました。
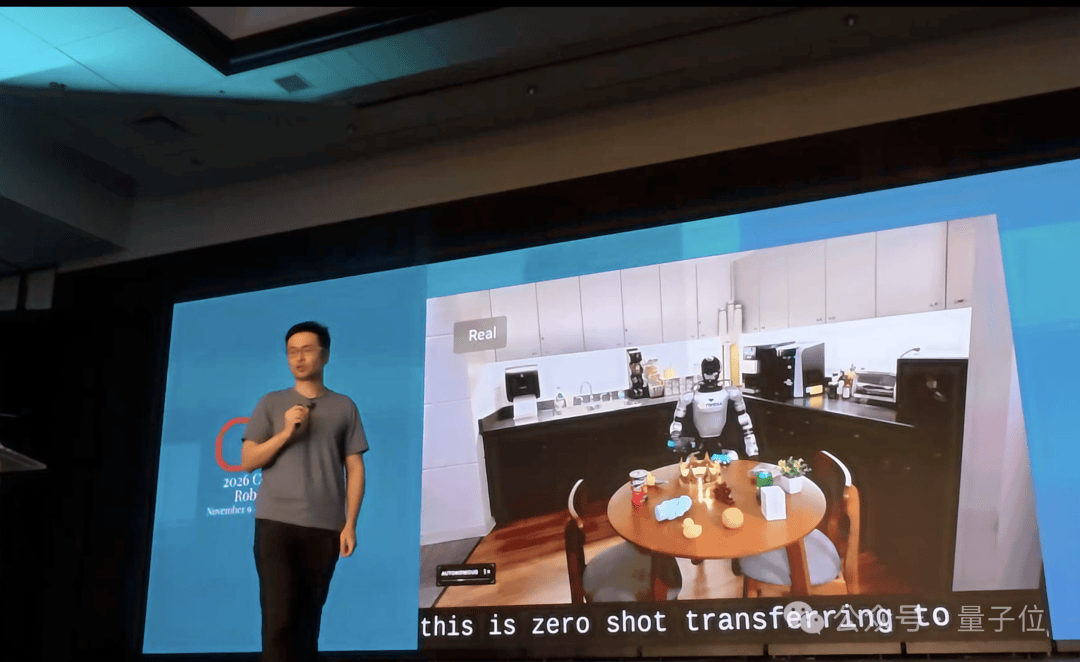
そしてGR00T 2の内部に目を向けると、これこそがYuke Zhu氏がX(旧Twitter)で言及していたクロスエンボディメント(異種機体間)適応技術、「X-Adapt」にあたります。
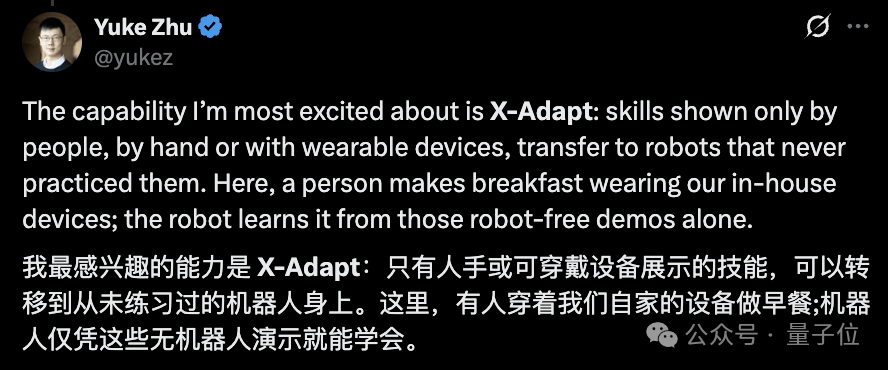
簡単に言うと、これまでロボットに新しいタスクを教えるには、そのロボットの身体構造や制御方式に合わせて、ロボットによるデモンストレーションデータを新たに収集し直す必要がありました。
X-Adaptはこの制約を打ち破ろうとしています。つまり、人間やハンドヘルドデバイスが実演したスキルを、そのタスクを一度も練習したことがないロボットへ直接転移できるのです。
具体的には、NVIDIAは以下の3つのアプローチを示しました。
1. 人間のデモンストレーションからロボットへの転移
研究者がモーションキャプチャデバイスを装着し、ろ紙を置いて湿らせる方法を実演します。するとその後、双腕の5本指ハンドロボット「Dexter」が同じタスクをこなせるようになります。
この全プロセスにおいて、当該タスクに関するロボットの遠隔操作デモデータは一切収集されていません。人間の実演データだけで、Dexterは20回の試行中65%の成功率を達成しました。
2. ハンドヘルドグリッパーからロボットアームへの転移
研究者がハンドヘルド型のUMIグリッパーを使って、おもちゃのダンプカーを組み立てる方法を実演します。モデルがこれを学習した後、そのスキルを「YAM」ロボットアームへと転移します。
UMIとYAMではグリッパーの形状が異なるにもかかわらず、YAMは最長約4分におよぶ組み立てタスクをエンドツーエンドで完遂し、60%の成功率を記録しました。
同じ転移アプローチは、ベルトコンベアでの仕分けや投げ入れ、操作パネルの解体といったタスクにも応用されています。
3. ウェアラブル外骨格からロボットの多指ハンドへの転移
研究者がハンド外骨格デバイス「DexUMI」を装着し、バナナヨーグルトを作ったりシリアルをすくったりする動作を実演します。
このデータを使ってモデルをファインチューニングすると、ロボットが引き継いで朝食作りのタスクを完了できるようになります。こちらも同様に、このタスクのためにロボットの遠隔操作デモを追加で収集する必要はありません。
まとめると、これら3つのアプローチはすべて同じパラダイムシフトを指し示しています。それは、**「同じスキルを、ロボットの種類ごとに毎回ゼロから実演し直す必要はもうない」**ということです。
もちろん、クロスエンボディメント転移だからといって、ロボットのデータが全く不要になるわけではありません。
人間のモーションキャプチャやUMIのアプローチにおいても、対象となるロボットは具体的なタスクとは無関係のデータを提供し、自身の身体構造や運動方式、制御空間をモデルに把握させる必要があります。その上で、新しいタスクのデモンストレーションについては、より収集しやすい人間の操作から取り入れることができるのです。
これこそが、GR00T 2の技術レポートで強調されている方向性——**「ロボット基盤モデルの汎化性能、器用さ、および適応能力の拡張」**です。
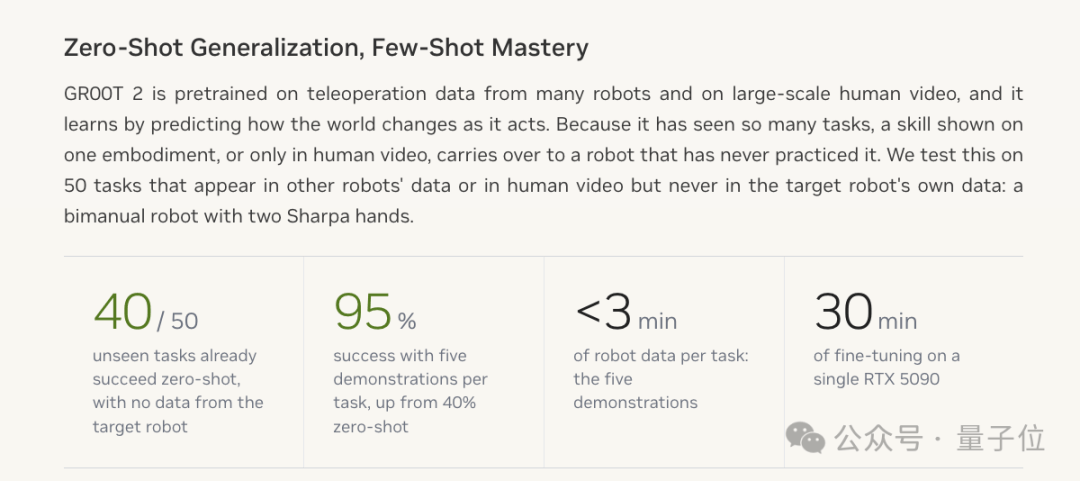
転移能力だけでなく、GR00T 2は少量のロボットデモンストレーションによって実行精度を高める能力も示しています。
別の「Dexter-50」ベンチマーク評価では、モデルのゼロショット平均成功率は40%でしたが、タスクごとに1回のデモンストレーションを与えると成功率は71%に向上し、5回のデモンストレーションを与えると95%に達しました。
さらに重要なのは、この5回のデモンストレーションの合計時間がわずか3分未満である点です。その後、単一のRTX 5090上で約30分間のLoRAファインチューニングを行うだけで、対象タスクに適応したモデルを得ることができます。
実際の呼び出しに関しても、NVIDIAはトレンドをしっかりと押さえ、「WAM API」を公開しました。
このAPIを通じて、推論モデルがタスクの分解や進捗状況のチェックを担当し、具体的な物理スキルをGR00T 2に引き渡して実行させることができます。
言い換えれば、GR00T 2は単体でスキルをこなせるだけでなく、上位のAIエージェントから呼び出される「物理実行モジュール」としても機能するのです。
さて、ここで疑問が湧いてきます。NVIDIAよ、なぜそこまで凄まじいのか?
40万時間の人間動画が、いかにしてロボットの「手作業スキル」に変わるのか?
一つずつ見ていきましょう。X-Adaptの背後には、まず巨大な「データピラミッド」が存在します。GR00T 2の事前学習には、以下の3種類のデータがミックスされています。
- 402,730時間の人間の主観視点(一人称視点)動画
- 2,897種類のタスクをカバーする、10,184時間のハンドヘルドUMIデモンストレーション
- 23,500時間のロボット遠隔操作データ
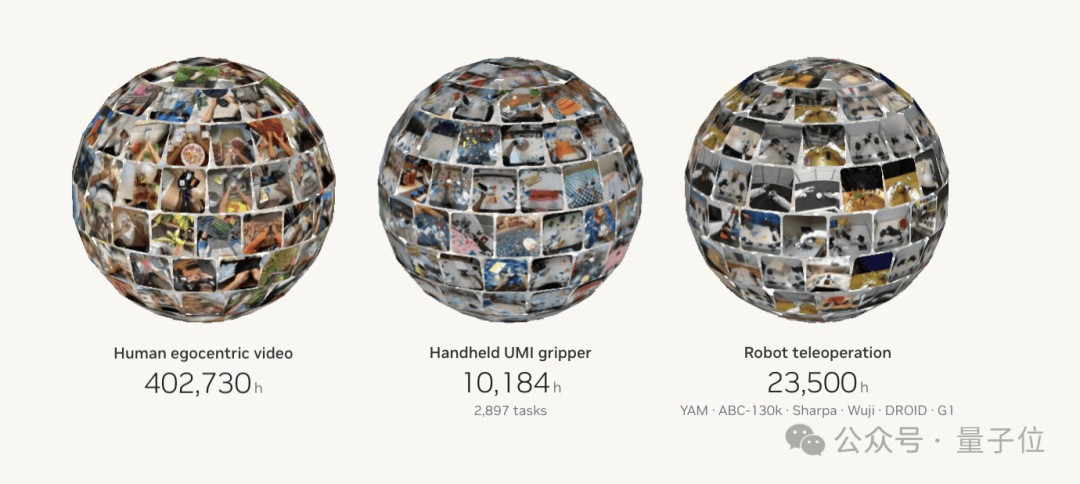
人間の動画の規模が、他の2つと比べて圧倒的に大きいことは一目瞭然です。これは、ロボットの学習教材がもはや人間による遠隔操作で収集された動作軌跡だけに限定されず、現実世界の膨大な人間の活動へと広がっていることを意味します。
人間がどのように道具を手に取り、物体を動かし、組み立てを完了するのか。そして1つの動作の後に、周囲のシーンがどのように変化するのか、といったことです。
UMIやウェアラブルデバイスはより直接的な操作の軌跡を補完し、ロボットの遠隔操作データは、異なる身体構造に対応する運動や制御方式をモデルが学習するのを助けます。
人間の動画が本当にロボットの作業に役立つのかどうかを検証するため、研究チームはスケーリング実験も特別に実施しました。
人間の動画を「全く含まない」「1%」「10%」「すべて含む」というデータセットでそれぞれモデルをトレーニングし、72項目のDexterタスクで評価を行ったのです。
その結果、人間の動画データが増えるにつれて、実機ロボットにおける平均タスク進捗率が50%から70%へと向上することが示されました。
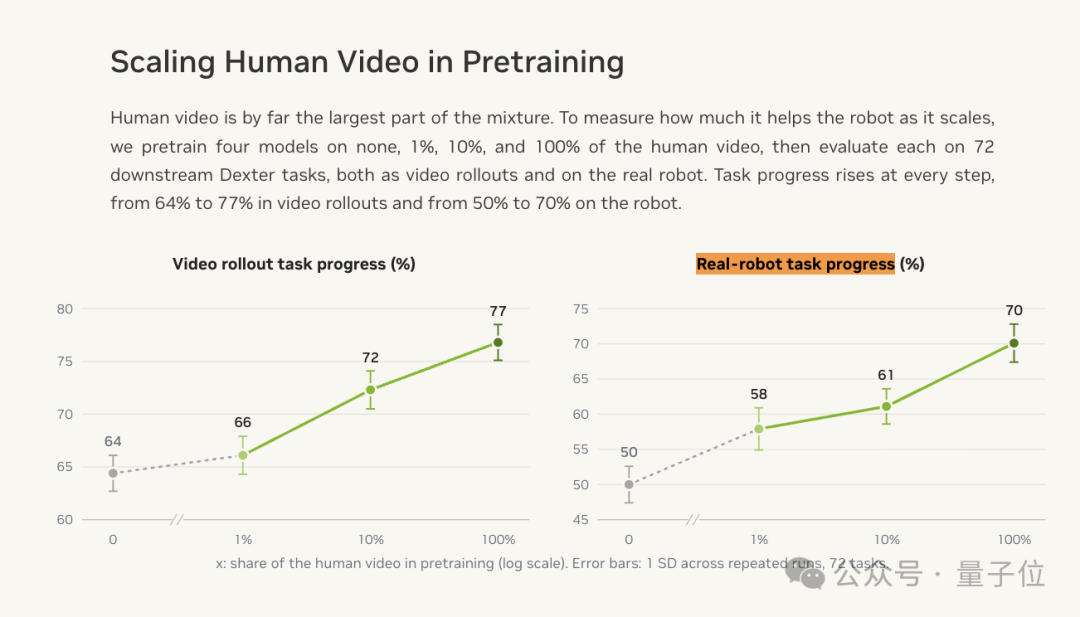
この実験は極めて明確な答えを出しています。大規模な人間の経験は、モデルの視覚的知識を豊かにするだけでなく、実際のタスクにおけるロボットの実行パフォーマンス向上にも直結するということです。
これらの膨大なデータを消化するため、モデルアーキテクチャの面では、GR00T 2は言語指示、マルチビューカメラ映像、およびロボットのステータスを受け取り、単一のDiffusion Transformer(拡散トランスフォーマー)を通じて未来の動画と動作シーケンスを同時に予測します。
最後に、NVIDIAはGR00T 2を中心として、データ収集、処理、トレーニング、シミュレーション検証、そして実機デプロイまでを一気通貫でつなぐ完全なツールチェーンを構築しています。
収集側には、UMIやDexUMIなどのデバイスがあります。これらにより、研究者は人間の操作、特に従来の遠隔操作では自然にこなすのが難しかった器用な動作を直接記録できます。
データ側には、Human-1MとFloraが含まれます。前者は人間の主観視点動画を提供し、最初の10万時間のサブセットがすでに公開されています。後者はデータの整理、記述的アノテーション、および自動評価をサポートします。
シミュレーション側には、SimFoundryがあります。現実のシーンからタスク環境を再構築し、ポリシーのテスト、データ生成、スキル開発に利用できます。
実行側は、異なるモデルとコンポーネントの役割分担によって成り立っています。
「ASPIRE」はロボットモデルとコードスキルを統合し、タスクの実行とエラー回復をサポートします。ヒューマノイドロボット向けには、「Turbo」がより軽量なネットワークとコンパクトな動画表現を用いることで、予測のオーバーヘッドを削減します。
G1ロボットに搭載されたJetson Thor上では、Turboの1回あたりの予測時間はわずか124ミリ秒です。一方、別のJetson Orin上で動作する「SONIC」は、50Hzで全身制御を行います。
前者が運動計画を生成し、後者がその計画を連続的な身体動作へと変換することで、ロボットが手を伸ばしたり、腰を曲げたり、物を運んだりする際の全身の協調性を維持します。
このようにして、開発者はGR00T 2を手に入れた後、モデル自体を呼び出せるだけでなく、付属のツールチェーンに沿って独自のデータを収集し、自身のタスクに適応させ、シミュレーションでスキルを検証し、最終的にそれを実機のロボットへとデプロイすることができます。
これこそが、NVIDIAの今回の発表で最も注目すべき点です。彼らが開放したのは単なる1つのロボットモデルにとどまらず、データ収集、モデル学習からスキルの呼び出し、実際の実行に至るまでの開発エコシステム全体なのです。
One more thing
CoRLの現地講演で、Jim Fan氏は次のように語りました。
「Astraは私たちの夢を打ち砕いたわけではありません。それが打ち破ったのは、私たちの周囲にあった『壁』なのです。」
「これは冬の時代ではありません。ロボットの『夏』が来たのです。」
確かに言葉としてはその通りなのですが、本日発表された「Claude Fable 5.2」のRoboDojoにおけるパフォーマンスは、ロボット工学界に強烈なレッスンを突きつけるような内容となっています。
Anthropicが公開した「RoboDojo Sim」の双腕シミュレーションテストにおいて、同一の実行フレームワークと各モデルの利用可能な最高推論強度を用いた結果、Fable 5.2のスコアは64.9%に達し、対するGPT-6 Astraは29.8%にとどまりました。
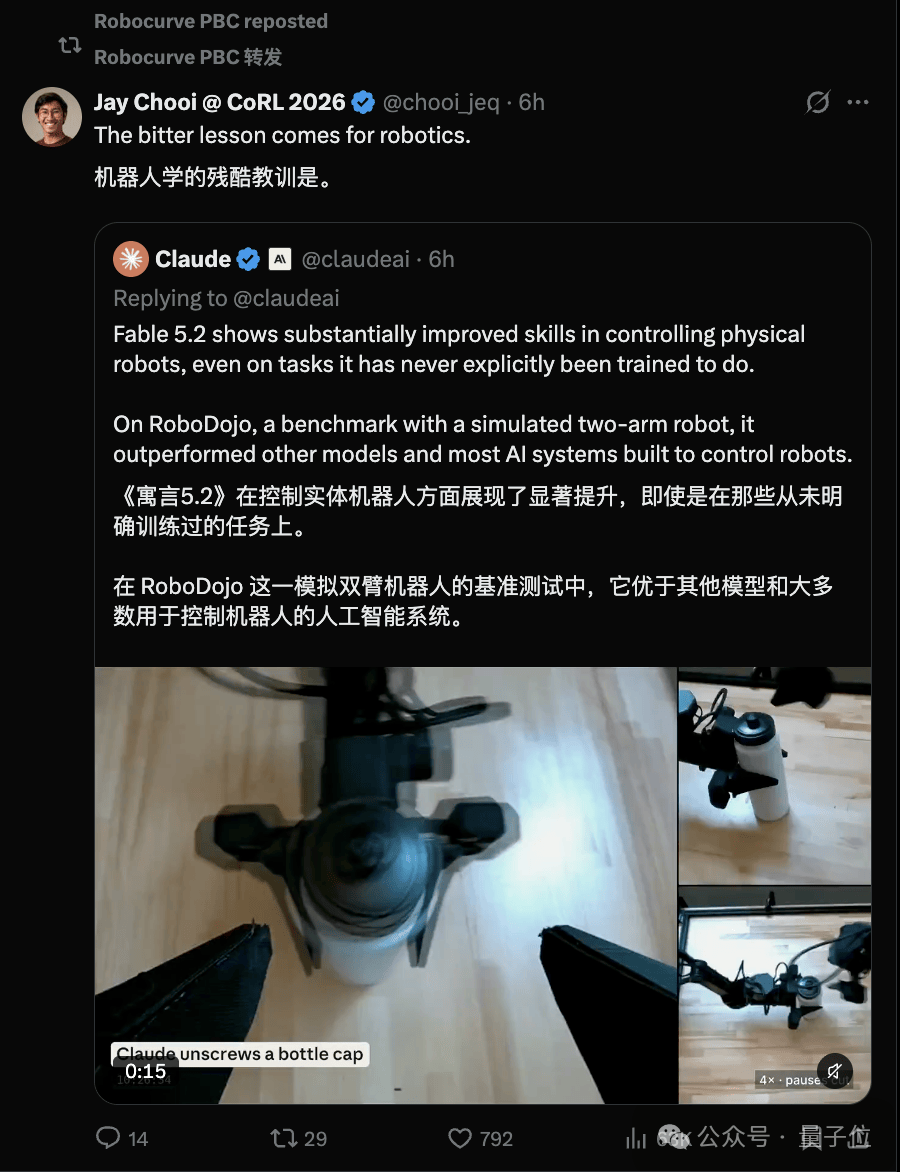
こうなったら次回の「後会友期(イベント)」には、大規模言語モデル(LLM)チームとエンボディドAI(具身智能)モデルチームの両方にエントリーしてもらうのもアリかもしれませんね?
参考リンク
[1]https://research.nvidia.com/labs/gear/gr00t-2/
[2]https://research.nvidia.com/labs/gear/gr00t-2/assets/gr00t2_whitepaper.pdf