
Ant Lingbo、LingBot-Touchをオープンソース化
このギャップはすごい。
ロボットに触覚を搭載したはずなのに、なぜかかえって賢くなくなってしまった……。
 △画像はAI生成
経緯はこうだ。
先日、あるチームが実験を行った。Sharpa Wave 多指ハンドの五本の指すべてに触覚センサーを取り付け、バッグのファスナーを閉めるというタスクに挑ませたのだ。
使用したアクションモデルはπ0.5。カメラのみの場合、成功率は**39%**だった。
次に、チームは指先センサーの読み取り値をそのままモデルに入力した。感覚がひとつ増えたのだから、ファスナー閉めはもっとうまくなるはず、と普通は考える。
ところが、結果はどうだったか。
あれれ……成功率は一気に15%まで急落した!
しかも、これは例外ではない。
同じSharpa Wave多指ハンドとπ0.5の組み合わせで、生の触覚データを入れて箱の受け渡しタスクを行ったところ、成功率は57%から48%に下がった。
ハンドをXHandに替えても、6タスクの平均成功率は49.71%から48%に低下した。
では、ロボットに感覚が増えたのに、かえって不器用になってしまうのはなぜなのか。
答えは、読み取り値にある。
触覚データは、他のデータとは性質がかなり異なる。ロボットの指はほとんどの時間、物体に触れていないため、読み取り値の大半は「0」だ。接触が始まっても、信号は疎でノイズを含んでいる。
さらに、センサーの種類ごとに仕組みが違う。視触覚センサーは指先のソフトゲルの変形を撮影し、磁気触覚センサーは磁場を測定し、圧抵抗式触覚センサーは電気抵抗を記録する。得られるデータはそれぞれ異なる。
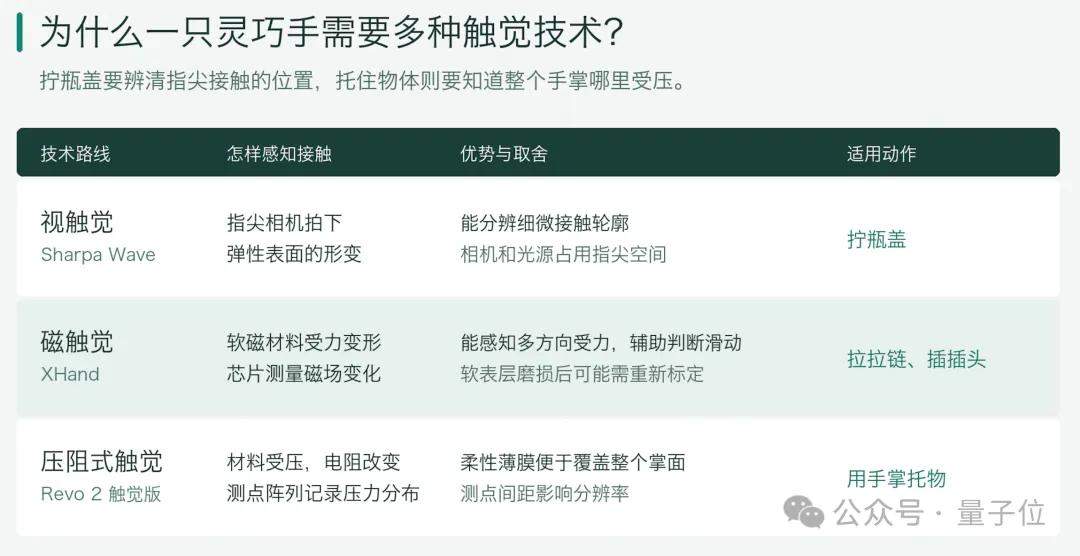 △3種類の触覚センサーが接触を感知する仕組みと、それぞれの長所・短所
たとえばボトルキャップをつまむタスクでは、3種類のセンサーがまったく異なる3種類の数値を出力する。アクションモデルはそれを理解できないうえに、無理に使わされるので、かえって足を引っ張ることになる。
では、この状況をどう打開すればよいのか。
Ant Lingboが出した答えは、センサーとアクションモデルの間に**「翻訳者」を挟む**ことだった。
(注:上記の実験はAnt Lingboによるもの。)
簡単に言えば、各種センサーが読み取ったデータを、アクションモデルが理解できる情報に変換してから渡すのである。たとえば、指がどこに触れているか、どれくらいの力がかかっているか、力がどの方向に偏っているか、滑っていないか、といった情報だ。
同じπ0.5、同じファスナー閉めタスクでこの方法を使うと、成功率は一気に**59%**まで跳ね上がった。触覚をまったく使わない場合よりも20ポイント高い。箱の受け渡しタスクでも、成功率は48%から63%に回復した。
この「翻訳者」こそ、Ant Lingboが今回新たにオープンソース化した触覚事前学習基盤モデルLingBot-Touchである。
これを導入すると、先ほどのボトルキャップを回す動作が非常にスムーズになる。
動画リンク:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
ボトルキャップを回す動作で最も失敗しやすいのは、指の腹とキャップが接しているごく小さな部分だ。つまむ力が少し弱いだけで、指の腹がキャップの表面で滑ってしまい、手首が半周回ってもキャップはびくともしない。そして、この場面こそカメラにははっきり見えないのである。
では、LingBot-Touchというこの「翻訳者」は、いったいどのようにそれを実現しているのだろうか。
多指ハンドには翻訳者が必要だ
まず、LingBot-Touchが何をするものなのかを整理しておこう。
簡単に言うと、磁気触覚・視触覚・圧抵抗式触覚という3種類のセンサー信号を受け取り、ひとつの触覚Tokenに統一してエンコードする。そこから、接触位置、力の大きさ、そして力の方向が時間とともにどう変化するかを読み取る。
位置づけは、ちょうど中間にある。下流側では、さまざまなセンサーや多指ハンドに接続でき、上流側では、そのTokenをさまざまなアクションモデルに渡せる。
こうすれば、各社のセンサー信号がどれだけ多様でも、アクションモデルの側では統一的に理解でき、いわば「異なる道から同じ目的地へ」たどり着ける。
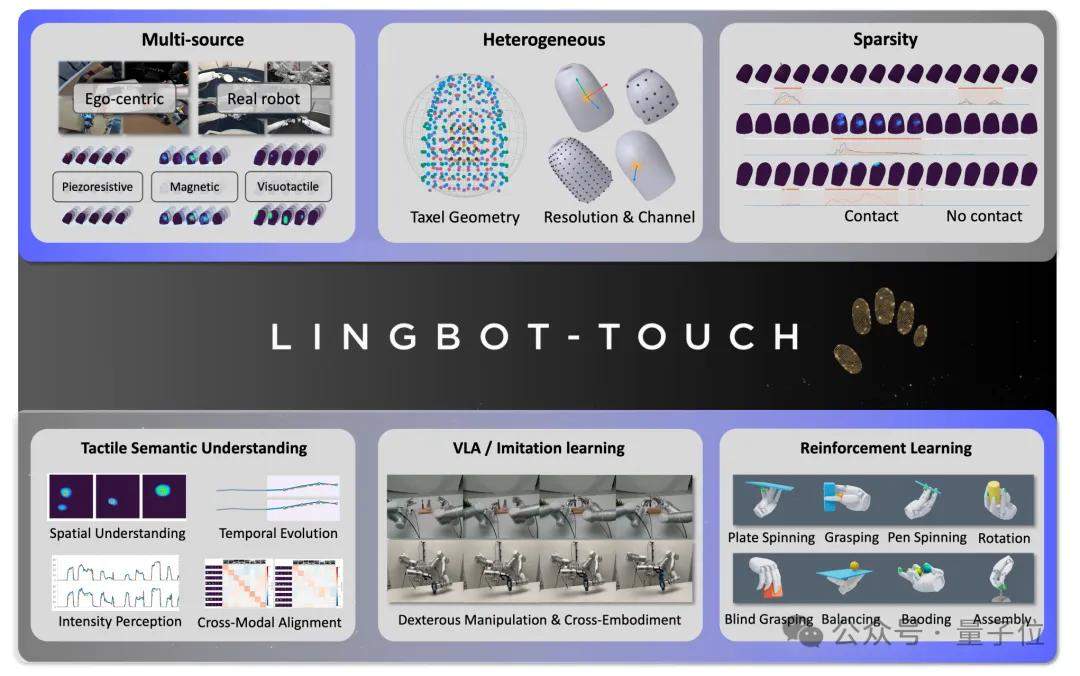 △LingBot-Touchは多様な触覚センサーと実機での巧緻な操作をつなぐ
また、LingBot-Touchの軽量版LingBot-Touch-Tinyは、パラメータ数が約532万しかない。現在、技術レポート、コード、モデルの重みはすべて公開されている。
では、LingBot-Touchはどのように作られたのか。
全体として、Ant Lingboのチームは大きく3つのステップを踏んだ。
ステップ1:座標の統一
チームが最初に直面した課題は、センサーごとに接触点の数も配置も大きく異なることだった。たとえば、親指だけで116個の接触点を備えた多指ハンドもあれば、布製グローブには3×3の小さなアレイしかないものもある。
番号でそのまま対応づけようとしても、当然うまくいかない。
そこでチームは、まずすべてのセンサーの接触点を、同一の標準化された指先空間にマッピングし、各Tokenに「アドレス」を割り当てた。このアドレスは、時間、指、3次元位置から構成される。
アドレスは回転位置埋め込み(RoPE)を通じてモデルに入力される。これにより、モデルは接触点の数が固定であることを前提としなくなり、配置が変わっても同じように読み取れる。
そのうえで、3種類のセンサーにはそれぞれ軽量な入口があり、生の読み取り値をTokenに変換する。入口を通った後は、共通の触覚Transformerバックボーンを使う。
つまり、センサー間の違いは各入口で吸収し、接触そのものの法則はバックボーンで一括して学習するのである。
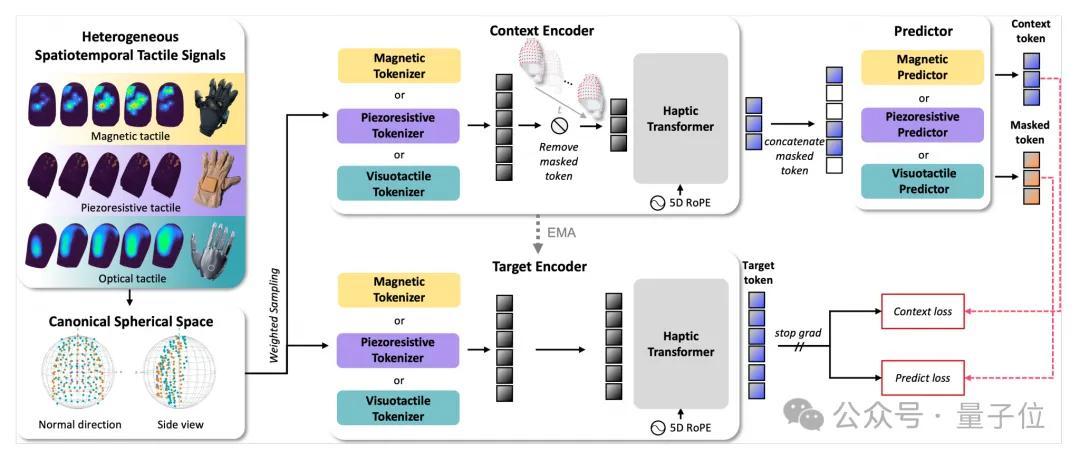 △LingBot-Touchの全体アーキテクチャ:3種類のセンサーがそれぞれ入口を持ち、ひとつのバックボーンを共有する
ステップ2:特徴空間で予測する
座標を統一した後、チームは2つ目の落とし穴にぶつかった。冒頭で触れた、あの一面の「0」である。
モデルに生の読み取り値を復元させようとすると、すぐに近道を見つけてしまう。「接触していない」背景さえうまく学習すれば、損失をかなり低く抑えられるのだ。そうなると、スコアは見栄えが良くなるが、本当に役立つ接触情報はほとんど学習されない。
そこでLingBot-TouchはJEPA方式を採用した。
具体的には、学習時に接触点の**90%**をランダムにマスクし、しかも時間方向の全区間にわたってマスクし続ける。そのうえで、モデルは残り10%の変化をもとに、マスクされた部分の表現を特徴空間で予測する。読み取り値を点ごとに復元する必要はない。
効果はてきめんだった。同じ1000時間のデータで学習した場合、接触中心の判定誤差は、LingBot-Touchが0.90ミリメートルであるのに対し、VAEとMAEはいずれも3ミリメートル以上だった。
また、ある区間の触覚から対応する映像を検索するタスクでは、LingBot-TouchのTop-5リコール率は32.07%だったのに対し、他の2手法はいずれも6%未満だった。
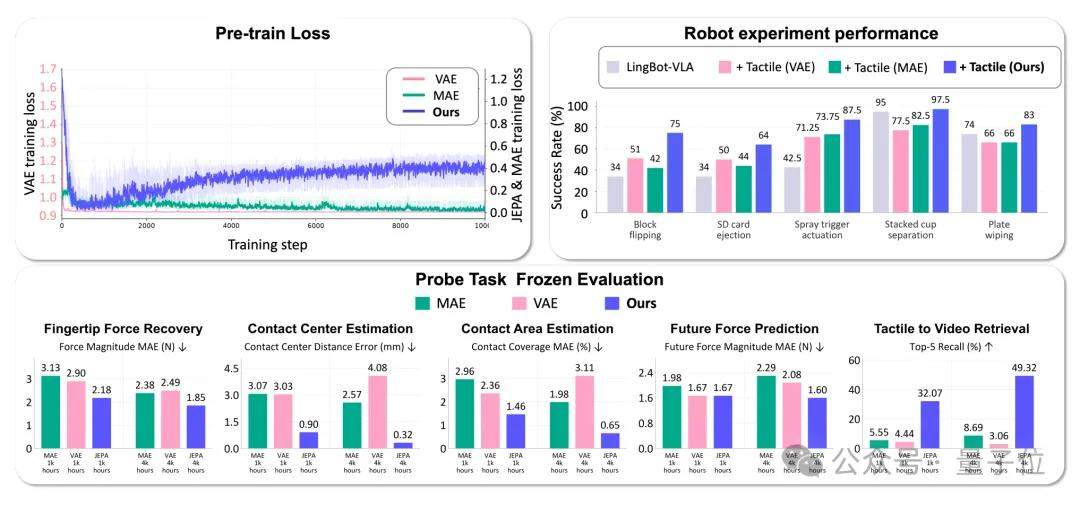 △同じデータで、特徴空間での予測と生の読み取り値の復元を比較した結果
ステップ3:データの拡充とモデルの丸暗記の防止
LingBot-Touchの事前学習データは、合計4983時間、約13.3億フレームに及ぶ。そのうち3分の2は、人が触覚グローブを着けて作業したデータで、残りの3分の1は、Sharpa Wave双腕ロボットを遠隔操作して得たものだ。
グローブを多用するのは、ロボットが不要で、ひとりで一日に数時間、通常の環境で記録できるからである。しかも、これらのデータには、開ける、閉める、組み立てる、注ぐといったタスク分類しか付与されておらず、力の大きさについては1フレームもアノテーションされていない。
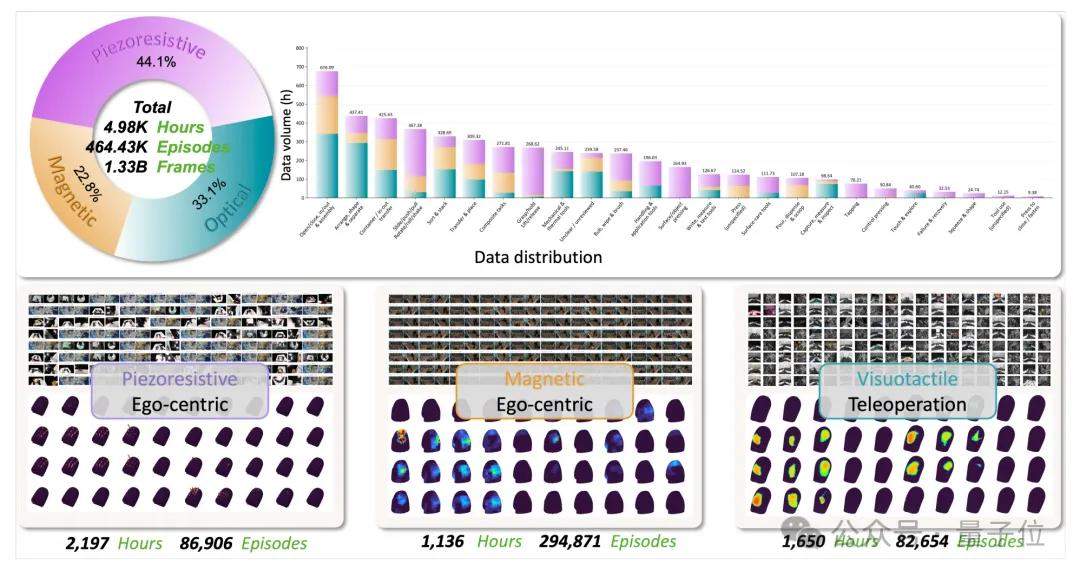 △事前学習データの構成。3種類のセンシング原理をカバーしている
とはいえ、データが十分に集まっても、モデルが「楽をする」ことを防がなければならない。
事前学習データにはセンサーの配置が3種類しかないため、モデルがこの3パターンの接触点位置をそのまま暗記してしまい、4種類目の配置に出会うと対応できなくなる恐れがある。
そこで学習時には、接触点のサンプリング密度をランダムに変え、さらに各接触点の位置を少しずつずらす。こうして、モデルに接触そのものの法則を学ばせるのである。
3つのステップを終えたら、いよいよ実機での検証だ。
テストでは2種類の多指ハンドを使用した。高自由度のSharpa Waveで20種類のタスク、低自由度のXHandで6種類、合計26種類である。
テストに参加したアクションモデルは、Diffusion Policy、π0.5、LingBot-VLA、T-Rexの4種類。各モデルについて、触覚なし、生信号の直接入力、LingBot-Touch導入の3つの設定でそれぞれテストした。
その結果、2種類のハンドのどちらでも、4種類のモデルすべてで、LingBot-Touchを導入したグループの平均成功率が最も高かった。
触覚なしと比べると、T-Rex、π0.5、LingBot-VLAの成功率はそれぞれ23.18、21.81、24.81ポイント向上した。その代償は、パラメータ数がわずか0.13%〜0.16%増えるだけだ。
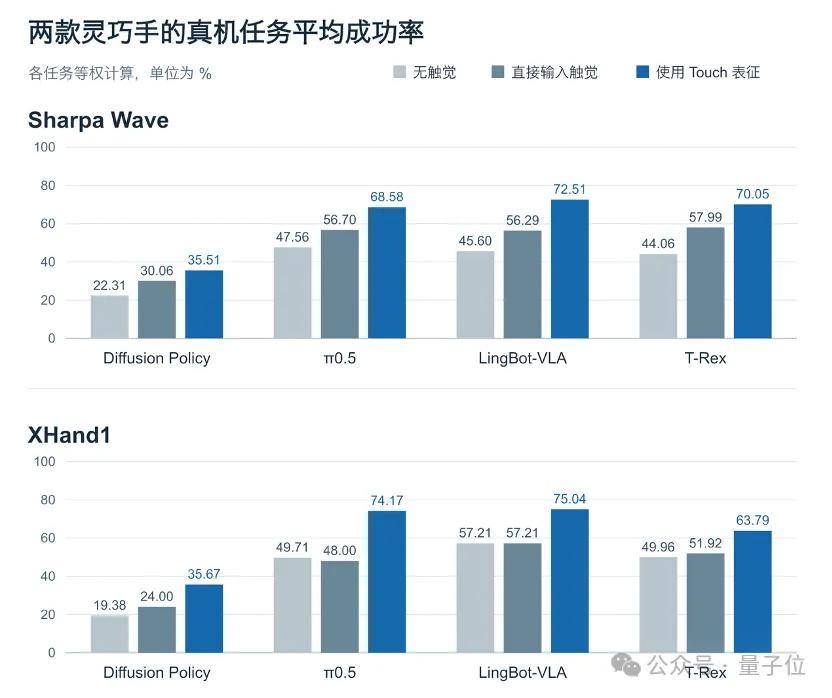 △2種類のハンドにおける、4種類のアクションモデルの3つの設定での平均成功率
片手でストローを差し込むタスクを例にとろう。このタスクの難所は、封止フィルムを突き破る瞬間にある。ストローを透明なフィルムに押し当てて下に押し込むと、抵抗がだんだん大きくなり、フィルムが破れた途端に手応えが突然抜ける。
カメラでは、フィルムがへこんでいるだけなのか、すでに突き破られたのかを見分けるのが難しい。しかし指先なら分かる。力を抜くのが一瞬でも遅れれば、ストローはそのままカップの底まで突っ込んでしまう。
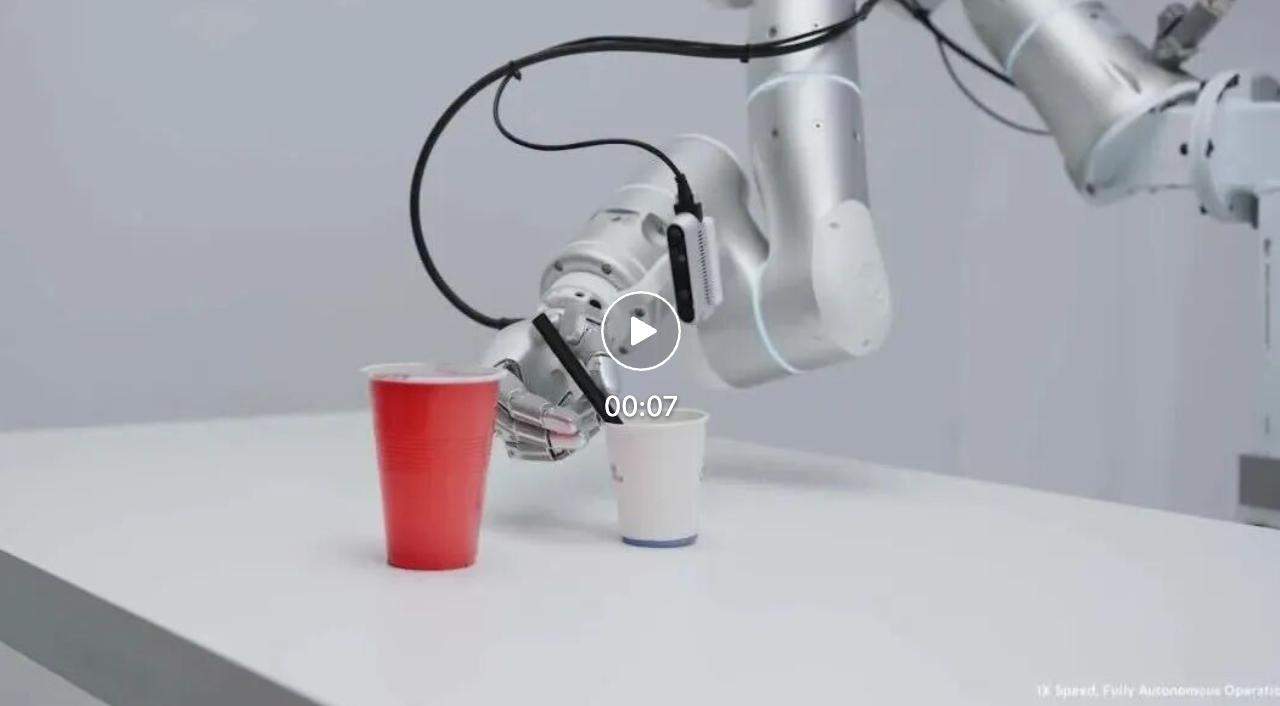
動画リンク:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
もちろん、最も説得力があるのは、やはりXHandの実験だ。
XHandが使う磁気触覚センサーの型番は、事前学習データに一度も登場していない。しかも、事前学習の磁気触覚データはすべて、人が着けたグローブから得たものである。XHandに接続する際、LingBot-Touchはパラメータを一切変更していない。
それでも、π0.5の6タスク平均成功率は、生信号を直接入力した場合の48.00%から74.17%へと上昇した。
なかでも、カップ重ねの分離タスクでは、成功率が32.5%から2倍以上の72.5%に跳ね上がった。
このタスクでは、多指ハンドは一番上のカップだけを取らなければならない。片手で積み重ねたカップ全体を支え、もう片方の手でカップの縁をつまんで引き抜く。抵抗が突然小さくなり、指の腹がカップの縁にしっかり接したままなら、カップが外れたということなので、すぐに力を抜く必要がある。指の腹自体が縁の上で滑っているなら、掴み直さなければならない。
この2つの状況では、手応えがまったく異なる。
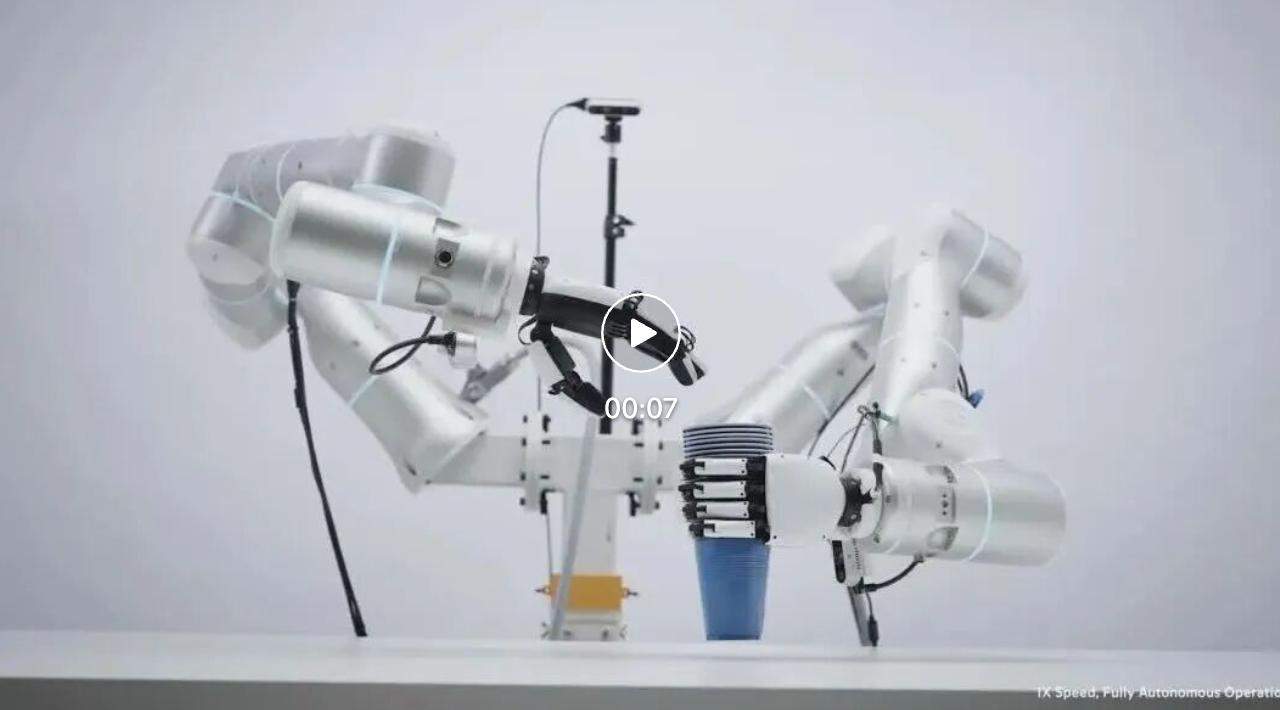
動画リンク:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
言い換えれば、人の手が蓄積した経験が、ロボットが一度も触れたことのない手を読み解く助けになったのである。
さらにチームは、LingBot-Touchを、従来の触覚基盤モデルFTP-1とも比較した。
Sharpa Waveでの接触中心の判定では、FTP-1の誤差が2.19ミリメートルだったのに対し、LingBot-Touchは0.12ミリメートル。XHandでも、誤差は5.89ミリメートルから0.16ミリメートルに下がった。
なお、FTP-1は2種類のハンドそれぞれに専用のアダプターを組み合わせているのに対し、LingBot-Touchは同じ凍結済みエンコーダーを使っている。
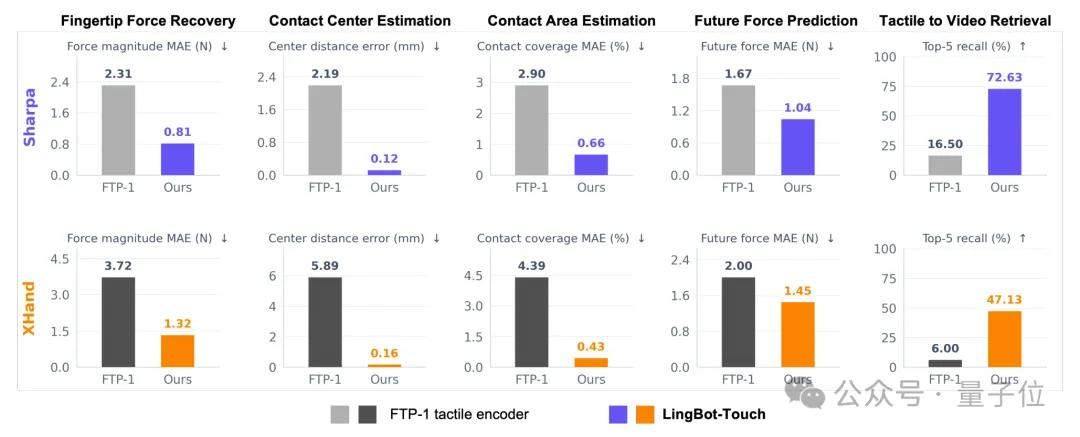 △2種類の多指ハンドでのFTP-1との比較
加えて、LingBot-Touchのスケーリング則も、初期の兆候が現れている。
Tiny版は4000時間前後で飽和し始めるが、容量の大きいSmall版に替えると、5000時間でも効果が伸び続けた。実機タスクの成功率も、事前学習データの増加に伴って着実に向上している。
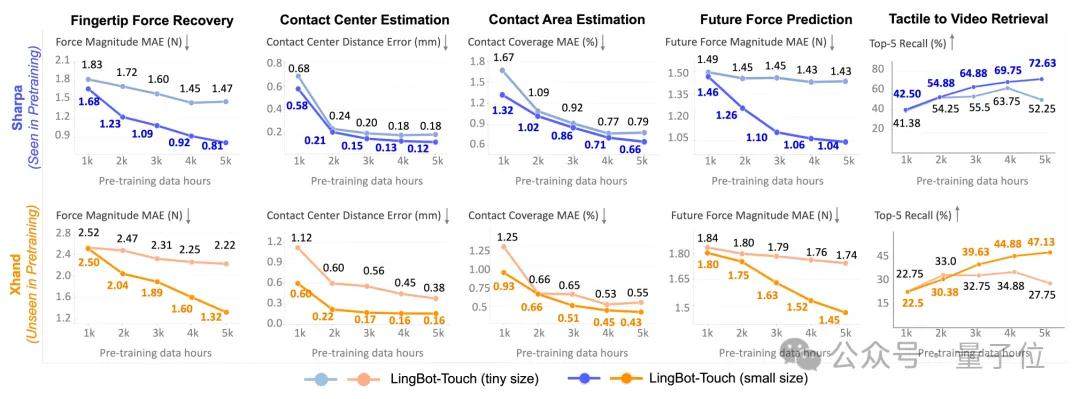 △事前学習データ量とモデル規模が効果に与える影響
触覚というピースが埋まった
技術的な詳細を見たところで、LingBot-TouchをAnt Lingboの技術ロードマップ全体に置き直してみると、その位置づけがよりはっきり見えてくる。
これまで、Lingboの汎用ブレインは3つの能力を展開してきた。空間認識にはLingBot-VisionとLingBot-Depth 2.0、環境とのインタラクションにはLingBot-VideoとLingBot-World 2.0、巧緻な操作にはLingBot-VLA 2.0とLingBot-VA 2.0がある。
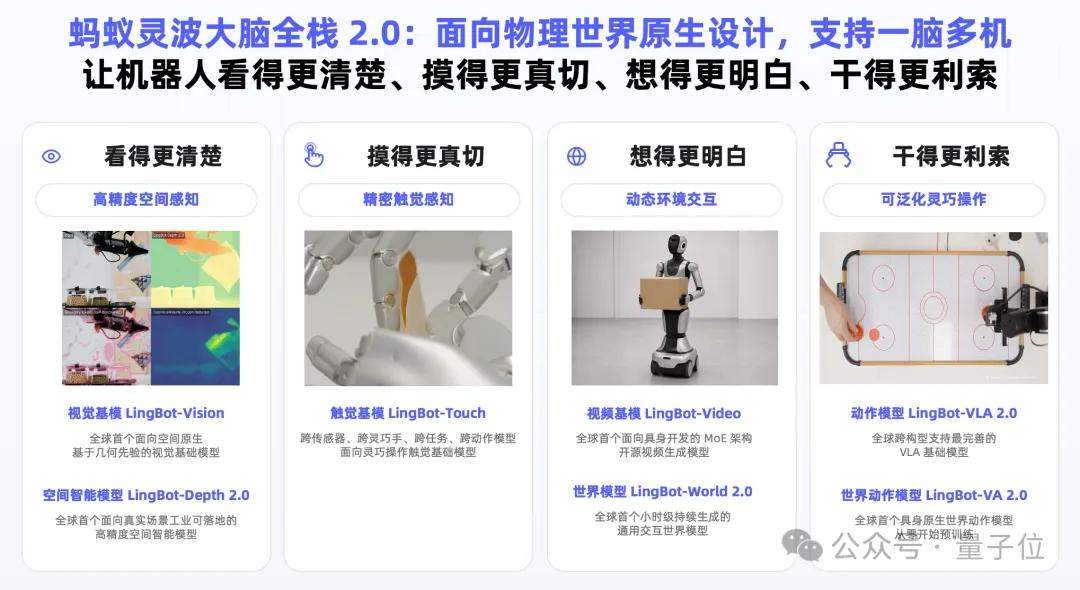
ご覧のとおり、これらの能力の多くは、接触する前の問題を解くものだ。物がどこにあるか、手をどこに伸ばすべきか、次に何をすべきか、といった問題である。
しかし、指が物体に触れた途端、視覚から得られる情報は少なくなる。指の腹がボトルキャップに触れている部分は手に隠れてしまうし、鍵が鍵穴に入った後は、何も見えなくなる。
LingBot-Touchが埋めるのは、まさにこの部分だ。ひとことで言えば、接触前は視覚、接触後は触覚である。
両手での解錠は典型的な例だ。
片手で南京錠を持ち、もう片方の手で鍵をつまんで鍵穴に合わせる。この段階は主に目に頼る。しかし鍵を奥へ押し込むと、錠が傾くことがあり、途中で引っかかれば、少し戻して角度を変え、やり直さなければならない。
鍵が鍵穴に入ってしまえば、カメラはほとんど役に立たない。多指ハンドは、鍵から指先に伝わる抵抗だけを頼りに判断するしかない。
動画リンク:
https://mp.weixin.qq.com/s/b7PNN5A3W8e1bZDVNTd5tg
ここまで読んで、こう思う読者もいるかもしれない。Lingboはなぜ、触覚を独立した基盤モデルとして作ったのか。
理由は、ハンドごとに制御方式は異なっても、どれも接触を理解しなければならないからだ。
「接触の理解」を切り出して、再利用可能な一層にすれば、あるハードウェアで蓄積した経験が、次のロボットの出発点になる。
この発想は、Lingboがこれまで手がけてきたLingBot-VLAと一脈通じている。
VLAが研究するのは、同じ頭脳でさまざまな構成のロボットを動かす、つまり「ひとつの頭脳で多くの機体を」である。Touchではその問いがさらに一歩進む。異なるハンド、異なるセンサーが蓄積した接触経験をまとめて学習し、新しいロボットに活用できるのか。
先ほどのXHandの結果は、この問いに対する初期的な答えになっている。
LingBot-Touchの設計上の選択も、この目標から逆算されたものだ。データ収集にグローブを使うのは、グローブがロボット本体に依存せず、データ規模を拡大できるからである。入口をセンシング原理に基づいて設計し、製品型番に基づかないのは、将来の新しいセンサーのための余地を残すためだ。
これこそ、Lingboが一貫して強調するエンボディド・ネイティブである。ロボットが物理世界でどう感じ、どう手を動かすかという出発点から、モデルの設計とトレーニングに用いるデータを決めていくのだ。
現在、LingBot-TouchはすでにLingBot-VLAおよびLingBot-Depthと統合されており、汎用ブレインの手と目の協調や精密操作の能力を高めるために使われている。
実用化の面でも、Lingboは、Leju(乐聚)やTaihu(钛虎)といった機体パートナー、そして国大薬局や隆盛などの現場パートナーとともに、小売の仕分け、物流の仕分け、産業分野で商用テストを進めている。
大規模モデルが強くなるほど、エンボディド・ネイティブは欠かせない
LingBot-Touch自体の話はここまでにして、視野を少し広げてみよう。
今年9月にGPT-6 Astraが発表された後、RoboDojoチームは、このモデルにゼロショット条件で42種類のシミュレーション操作タスクを実行させた。その結果、総合スコアは評価対象の43エントリーの中で1位だった。
正直なところ、これにはエンボディドAI界隈も一時、少し動揺した。
しかし、同じレポートには別の数字もある。GPT-6 Astraの精度の次元での成功率はわずか4%で、最も良かった公開ポリシーは20.42%だった。チューブの挿入やタワーの積み上げのような、精密な接触を要するタスクでは、ほぼ全滅だった。実機テストも、安全上の問題から中止された。
レポートはこの差を、物理的な常識の欠如、つまり接触・力・衝突への理解不足に帰している。
そして今日、AnthropicがClaude Fable 5.2を発表し、大規模モデルによるロボット制御はさらに一歩前進した。
Anthropic公式ブログが公表した内部テストの結果によると、Fable 5.2のRoboDojoシミュレーションテストでの平均成功率は**64.9%**に達した。同じテストフレームワークでのGPT-6 Astra(29.8%)の2倍以上で、ロボット制御専用に作られたAIシステムの大半も上回っている。
公式が公開したデモでは、Fable 5.2が制御するロボットは、ルービックキューブを解いたり、ボトルキャップを回したり、絵を描いたりすることもできる。ただし、RoboDojoが評価するのは、カメラ映像を見ながらシミュレーション上の双腕ロボットを制御する能力である。