
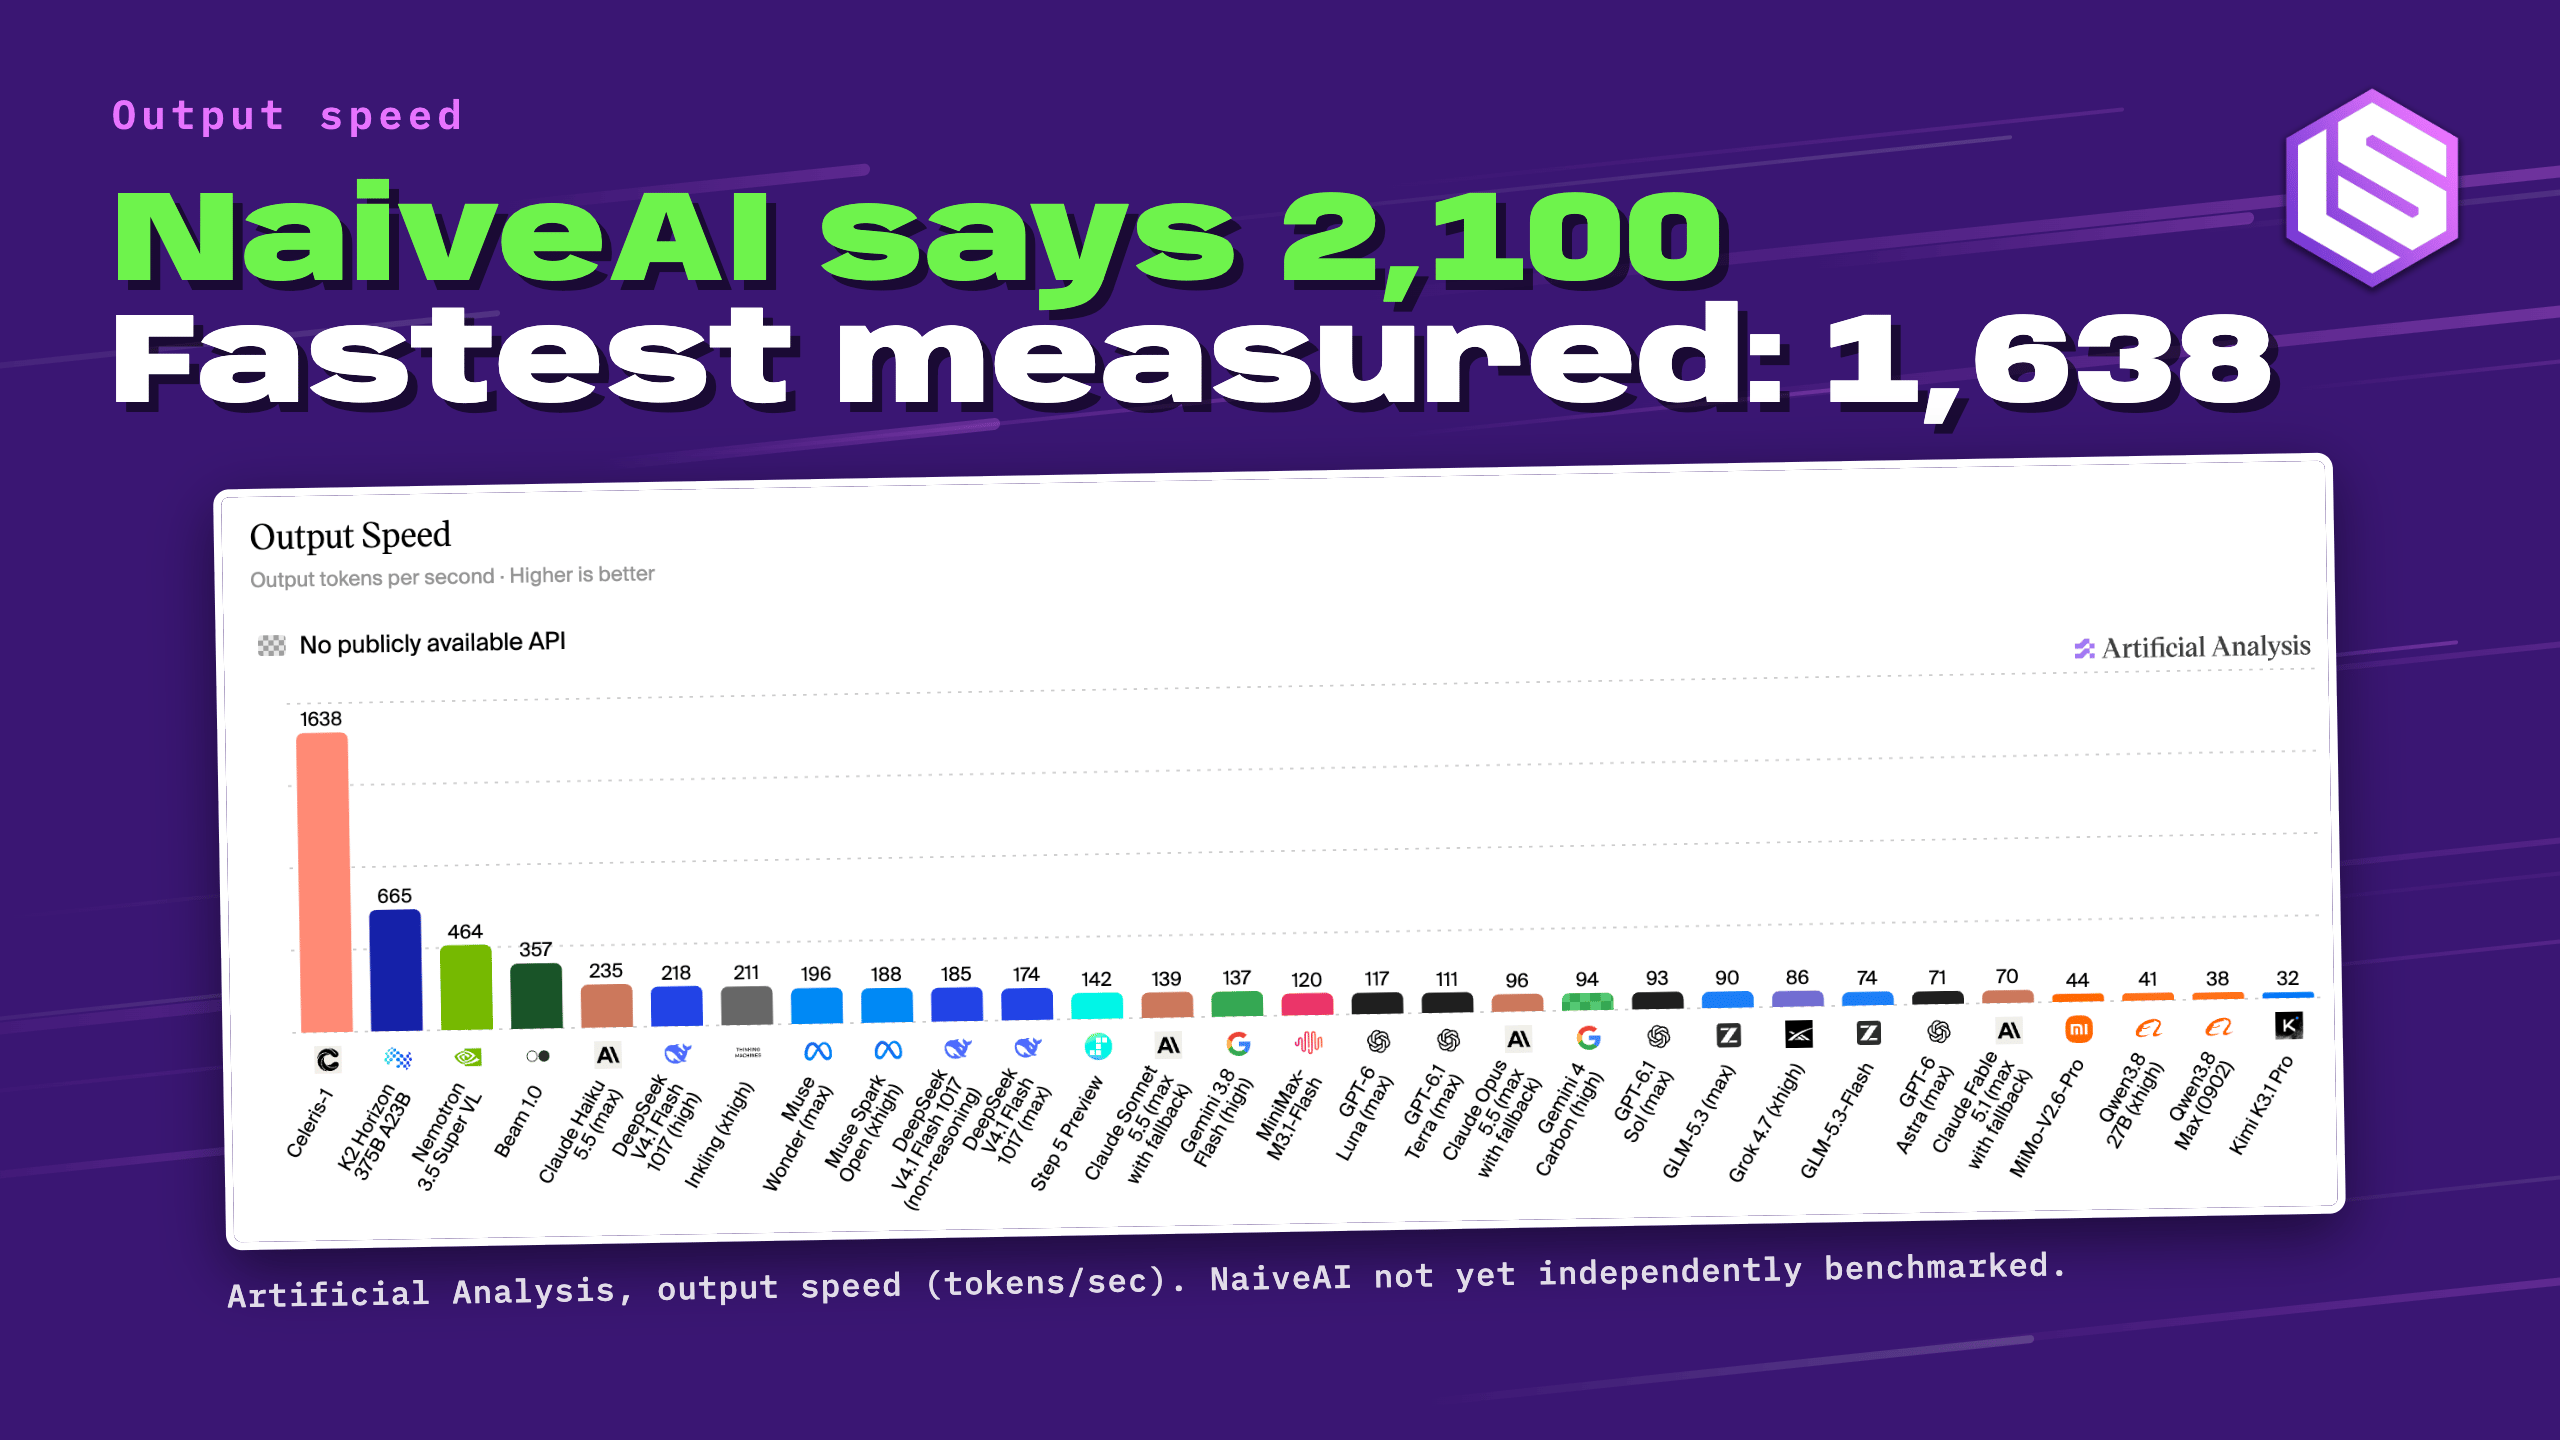
NaiveAI は Artificial Analysis の速度ランキングで首位に立つ見込みです。私たちの実測テストでは、そのコード生成品質は DeepSeek に匹敵することが示されました。
11月10日 · 読了時間 10 分
編集部注:本記事をもって、新しいモデルや製品を実際に試し、客観的なレビューを提供する新シリーズを正式にスタートします。ご提案がありましたら tips@latent.space までお寄せください。
Naive-N0.5-Flash は、AI コーディングタスク向けに特化して構築され、1秒あたりに可能な限り多くのトークンを生成するようにチューニングされた、全く新しい**オープンウェイトモデル(open-weights model)**です。NaiveAI という中国企業によって開発されたこのモデルは、エンジニアリングや研究のワークフローを加速させ、チームがより迅速に実験や反復を行い、複雑な問題を解決できるようにすることを目的としています。
このモデルは Xiaomi の MiMo-V2.5 から派生したもので、NaiveAI が長文脈推論の追加トレーニングを行い、独自開発の推論エンジンである NaiveRT と組み合わせたものです。Naive-N0.5-Flash は大胆なコンセプトを掲げています。それは、大部分が AI によって構築され、AI 研究そのものを行うようにトレーニングされたモデルであり、長期的な目標として再帰的自己改善(recursive self-improvement)の実現を目指しているという点です。
どのような変更が加えられたのかを理解するには、その出発点を知っておくと役立ちます。MiMo-V2.5 は、総パラメータ数 310B、アクティブパラメータ数 15B のスパース Mixture-of-Experts(MoE)モデルであり、48T トークンでトレーニングされています。その言語バックボーンネットワークは MiMo-V2-Flash のハイブリッドアーキテクチャ設計を継承しており、スライディングウィンドウアテンション(SWA)とグローバル自己注意機構(Global Self-Attention)を組み合わせています。
NaiveAI の技術的アプローチは、まさにこれらのウェイトからスタートしました。継続的な多段階トレーニングを通じて、同チームはモデルのチェックポイント(checkpoint)を DeepSeek スパースアテンション(DeepSeek Sparse Attention)層に適合させました。NaiveAI の技術ブログによると、これには MiMo の元の 48T トークンに加えて、さらに約 3.25T トークンが費やされました。 この追加されたトークンのうち、約 3T トークンは固定の 1M コンテキスト長と一定の学習率のもとでトレーニングされています。
ベンチマークテスト:NaiveAI 対 DeepSeek および Z.ai
私たちは Naive-N0.5-Flash の超高速モード(ultrafast mode) を、DeepSeek V4.1 Flash 1017 および GLM 5.3 Flash とベンチマークテストで比較し、その後、これら3つのモデルに同じアプリケーション構築用プロンプト(prompt)を入力しました。
そこで判明したトレードオフは、より難易度の高い問題に直面した際、Naive-N0.5-Flash はより長い推論プロセスを必要とするものの、全体としては最終的な回答を出力するまでの速度が依然として速いということでした。ただし、これにより1回のクエリあたりのコストはわずかに高くなります。もっとも、速度を最優先するユースケースにおいては、この代償は十分に許容できる範囲でしょう。
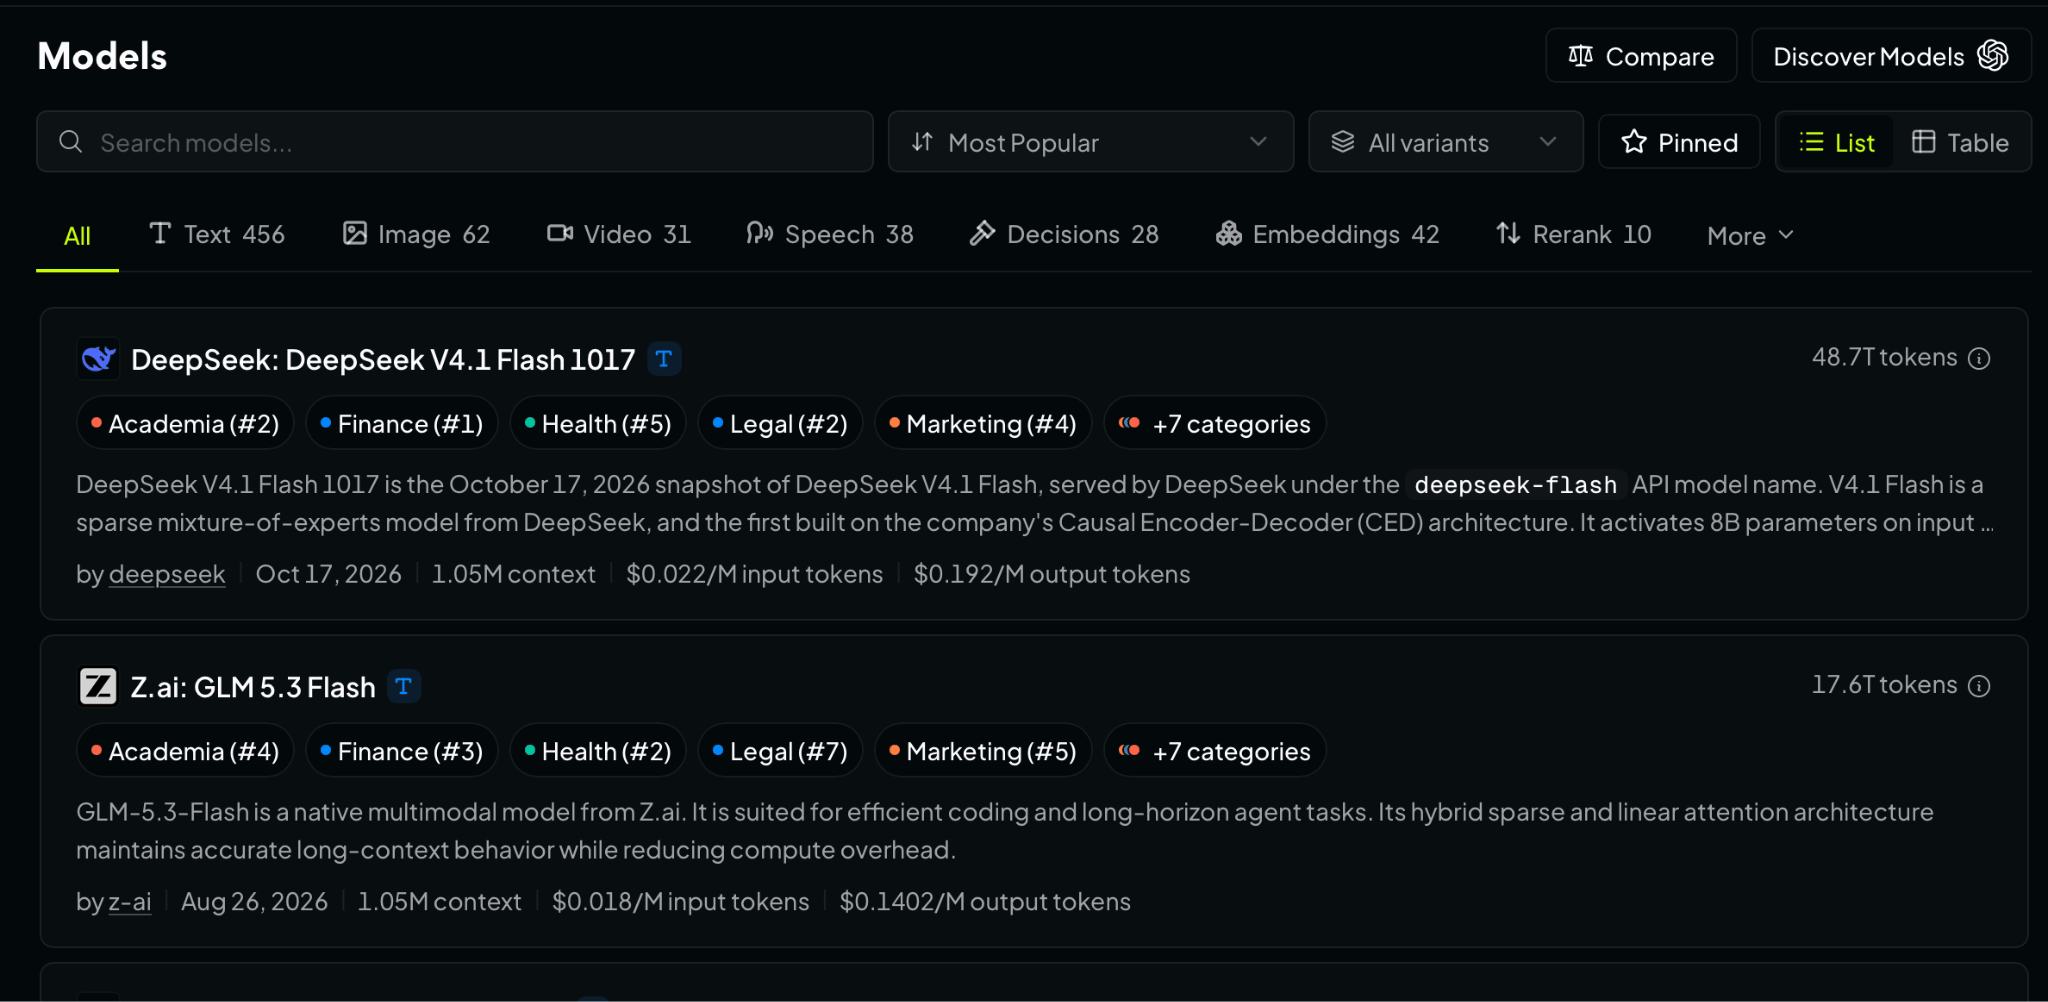
2026年10月末時点で OpenRouter で最も人気のあるモデル。
DeepSeek V4.1 Flash 1017 と GLM 5.3 Flash は、OpenRouter で最も人気のある2つのモデルです。どちらも Flash クラスのモデルに属し、AI アシストによるコーディングにおいて卓越した能力を発揮しています。
本記事の執筆時点では、Artificial Analysis 上に NaiveAI モデルのパフォーマンス統計データはまだ掲載されていません。そのため、今回の比較で使用したモデルの知能指数(Intelligence Index)スコアを以下に示します。