
Agentは使うほど賢くなるのに、なぜ環境に「つまずく」のか?
すべてのタスクを、次の進歩の出発点に
同僚はAgentを使ってレポートを整理し、最後までスムーズに進みました。あなたも同じモデル、ツール、ワークフローを使い、自分のファイルに差し替えただけなのに、何度も読み込みを試し、頻繁にやり直しが発生しています。
モデルもHarnessも変わっていないのに、環境が変わるとなぜうまくいかなくなるのでしょうか?
ファイルの保存場所の違い、データ形式の混在、テンプレートの制約の変化。こうしたことが原因で、それまで有効だった方法が通用しなくなることがあります。モデルは推論能力を提供し、Harnessは実行フローを組み立てます。しかしAgentには、ここはどのような環境で、過去の経験はまだ通用するのか? を判断する役割が残っています。
ここから、Agentが継続的に自己改善していく過程で見落とされがちな問題が見えてきます。Agentはタスクから「どうやるか」を学ぶだけでなく、その経験がどのような環境で有効なのかも判断しなければなりません。
RSI(Recursive Self-Improvement、再帰的自己改善)による継続的な最適化の過程で、Agentはタスクのフィードバックを通じて実行方法を改善し、再利用可能な経験を蓄積できます。しかし環境認識が同時に更新されなければ、過去に有効だった経験が新たな障害になることもあります。たとえば、インターフェースの条件が変わったのに古い呼び出しを再試行し続けたり、データ形式が変わったのに古いルールを使い続けたりするケースです。
失敗したとき、改めるべきは方法なのか、それとも環境に対する認識なのでしょうか?
Agentの新たな難題に、認知科学の古い手がかりが隠れている
認知科学における知識構造の研究は、この2種類の問題を区別するヒントを与えてくれます。
1983年、認知科学者のJohn R. Andersonは、ACT-R関連の理論研究のなかで、人間の知識の2つの重要な形態を体系的に論じました。
- 宣言的知識(Declarative Knowledge):「世界はどうなっているか」を記述する知識。たとえば、閉じた容器は中の物体を隠し、開けて初めて観察できる、といったことです。
- 手続き的知識(Procedural Knowledge):「どう行動すべきか」を記述する知識。たとえば、同種の物体を複数探す必要があるときは、最初の1つを見つけたあとも、ほかに考えられる場所を調べ続ける、といったことです。
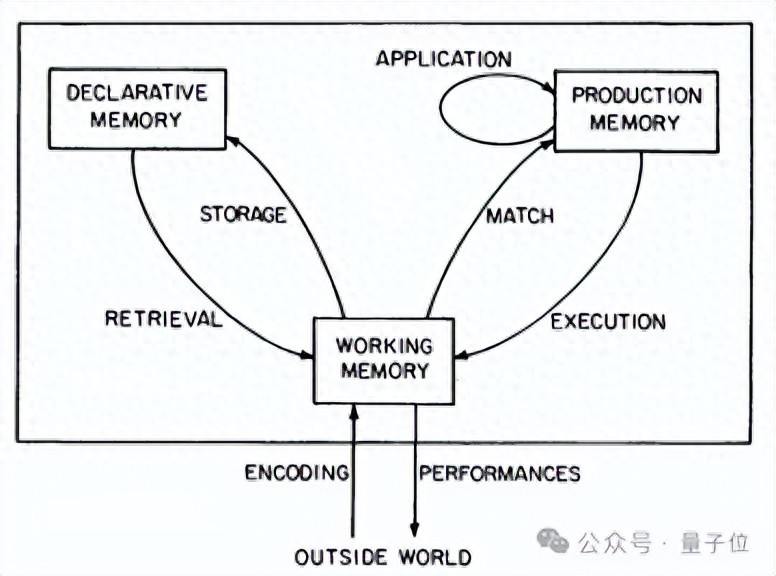
その後、Larry Squireらの研究者が神経心理学の観点から、この区別に生物学的な基盤があることを確認しました。2種類の知識は異なる脳領域が担い、学習速度も取り出し方も異なります。
この視点をAgentに当てはめると、環境を理解することと、やり方を習得することは互いに関連しているものの、検証や更新の方法は異なることがわかります。環境の判断では、現場の事実と合致しているかを照合する必要があります。一方、行動の方法については、該当する条件のもとで有効かどうかを検証しなければなりません。この2つを混同すると、たまたま成功した操作を安定した法則と取り違えたり、環境が変わったあとも無効になった方法を使い続けたりするおそれがあります。
この考え方に沿って、openJiuwenはRSI分野での継続的な探索のなかで、TTSE(Two-Track Self-Evolution、2トラック自己進化) を新たに提案しました。
先に発表した2次元RSIフレームワークは、Harness+Artifactsの2次元最適化によって、Agentが実際のタスクのフィードバックをもとに、作業方法と成果物を継続的に改善できるようにしました。TTSEはさらに、経験そのものの信頼性と再利用性に焦点を当てています。有効な実行方法を蓄積するだけでなく、環境に対する認識を継続的に補正し、環境が変わったあとに経験が無効になるのを防ぎます。
そのためTTSEは、認知科学における宣言的知識と手続き的知識の区別を参考に、タスクで得られた経験を2つのトラックに分けます。
- FACT(環境事実):「この環境がどうなっているか」を継続的に照合・更新します。
- TIP(条件付きテクニック):「この条件のもとでどうすべきか」を継続的に改善します。
TTSEの2トラックフレームワーク:フィードバック駆動の経験自己進化ループを構築する
経験の種類を分けるのは、最初の一歩にすぎません。Agentがタスクのフィードバックから継続的に学び、有効な経験を次のラウンドの実行改善につなげるには、どうすればよいのでしょうか?
これはRSIの中核となる考え方でもあります。実際のタスクのフィードバックで改善を駆動し、その後の実行のなかで検証と最適化を繰り返します。TTSEはこの考え方を、経験管理のレベルで具体化しました。タスクをバッチごとに実行し、既存の経験を新たな証拠で継続的に検証します。そして、残すべき経験、修正すべき経験、退役させるべき経験を判断し、更新後の経験を次のラウンドのタスクに活用します。
このフレームワークは、2トラック知識表現、コールドスタート、オンライン増分進化、最終出力と評価の4つの部分で構成されています。
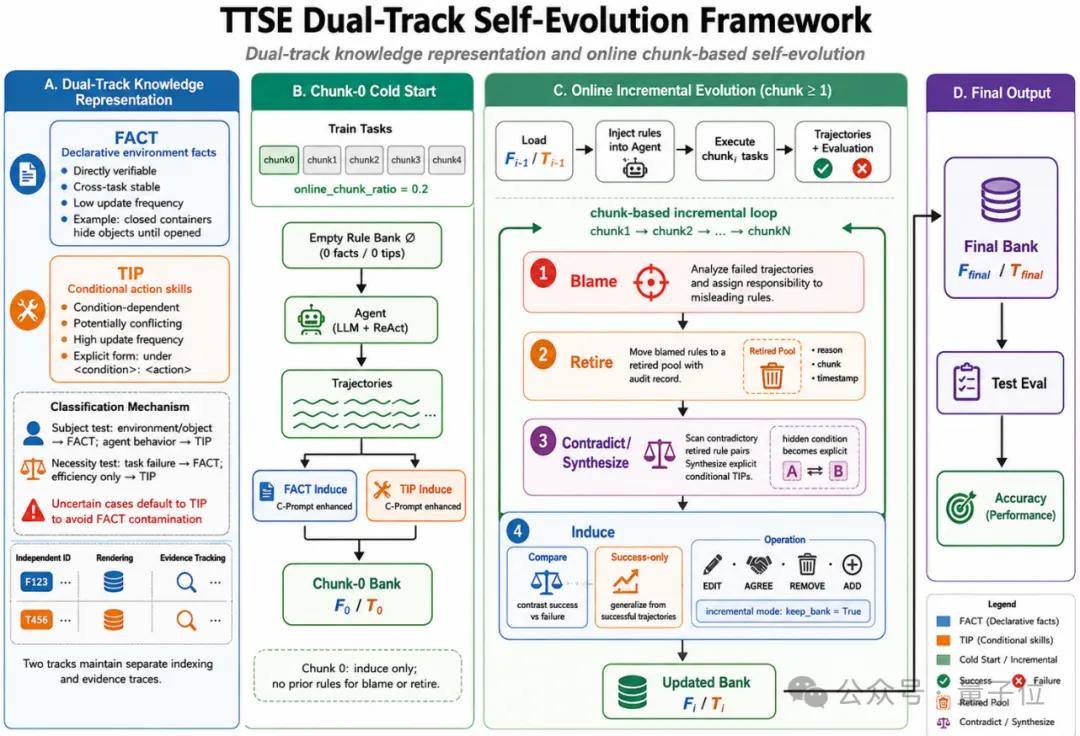
① 2トラック知識表現:環境事実と実行方法にそれぞれ根拠を持たせる
FACTは環境自体の属性や規則を記述するもので、直接検証できることと、適用可能な場面でタスクをまたいで安定していることを重視します。TIPは特定のタスク条件下での実行方法を記述するもので、「どのような条件で、どの操作を実行するか」という形式で表現します。
2種類の知識は、それぞれ独立した番号付け、表示方法、証拠追跡の仕組みで管理されます。これにより、個々の経験を単独で参照、照合、更新できます。実行に問題が起きたときにも、どの事実判断や操作の提案が影響したのかを遡って特定しやすくなります。
分類の際には、その経験が記述する対象と役割から判断します。判断が難しい内容は、十分に検証されていない操作上の経験を環境事実と取り違えるリスクを下げるため、デフォルトでTIPに分類します。
② コールドスタート:最初のバッチのタスクから初期経験を帰納する
TTSEは空のルールライブラリから出発します。Agentが最初のバッチのタスク(chunk 0)を実行し、その実行軌跡からFACTとTIPをそれぞれ帰納して、初期の2トラック経験ライブラリを構築します。
この段階は帰納が中心です。実行に使われた過去のルールがまだないため、古いルールの帰責や退役は行いません。その代わりに、後続の進化の土台となる、タスクの証拠に裏づけられた最初の経験群を作ります。
③ オンライン増分進化:新しいタスクで既存の経験を検証し、修正する
以降のタスクはバッチごとに進みます。各ラウンドで、Agentは前のラウンドのFACTとTIPを読み込み、既存の経験を使って現在のバッチのタスクを実行します。そのうえで、実行軌跡と評価結果に基づき、次の4つのステップを順に行います。
- 帰責(Blame):失敗した軌跡を分析し、実行を誤らせた可能性のあるルールを特定して、経験修正の対象を定めます。
- 退役(Retire):帰責されたルールを退役プールに移し、理由、バッチ、時刻などの記録を残して、調整の過程を追跡できるようにします。
- 矛盾分析と合成(Contradict / Synthesize):退役したルール間の矛盾を調べ、そこに潜んでいる適用条件を見つけ出します。一見対立する経験を、条件がより明確なTIPに合成します。
- 帰納(Induce):成功した軌跡と失敗した軌跡を比較するか、成功した軌跡から有効な経験を抽出し、追加・修正・確認・削除といった操作で2トラック経験ライブラリを更新します。
Blame→Retire→Contradict/Synthesize→Induce は複数のタスクバッチにまたがって循環します。これにより、経験は新しい証拠による検証を受け続けます。環境に対する認識が更新され、その条件下での実行方法も調整されます。
④ 最終出力と評価:経験の進化がもたらす実際の効果を検証する
複数ラウンドの増分進化を経て、フレームワークは最終的なFACTとTIPの経験ライブラリを出力します。そしてテストタスクで、それが正答率やタスクのパフォーマンスにどう影響するかを評価します。
この仕組みの核心は、環境事実と実行方法をそれぞれ蓄積し、個別に追跡できるようにして、継続的な実行のなかで検証と修正を行うことにあります。Agentはバッチを1つ終えるたびに、新しいインタラクションの証拠を次のラウンドで使える経験へと変換します。こうして、環境とのインタラクションから知識の更新へ、さらに行動の改善へとつながるループが徐々にできあがります。
しかし、重要な問いが1つ残っています。環境事実と行動テクニックを分けて進化させることは、従来の単一トラックによる経験管理より本当に効果的なのでしょうか?
仕組みから実証へ:5つのベンチマークでTTSEの2トラック自己進化の有効性を検証
TTSEの方法論と実験結果は、論文「A Two-Track Online Self-Evolution Framework for LLM Agents」で詳しく述べられています。
2トラック経験の仕組みが本当に有効かを検証するため、研究チームはALFWorld、ScienceWorld、GDPevo、SOPBench、PinchBenchの5つのベンチマークで評価を行いました。各実験は独立に3回ずつ繰り返し、手法の実際の効果と実行の安定性を調べています。
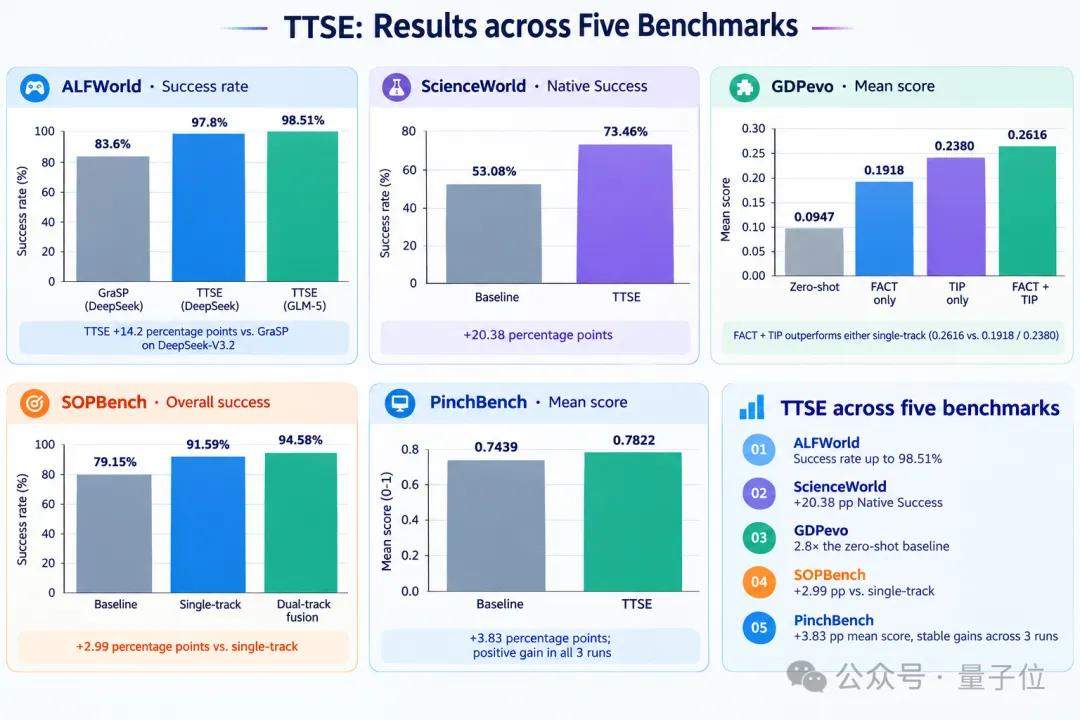
5つのベンチマークで、多面的な向上を確認
- ALFWorld:成功率は最高98.51%に到達。 GLM-5ではTTSEの成功率が98.51%に達しました。DeepSeek-V3.2では成功率が97.8%に達し、これまでの最良手法GraSPの83.6%を14.2ポイント上回り、タスクの実行ステップ数も減少しました。
- ScienceWorld:タスクのパフォーマンスが大幅に向上。 MACRO Rewardは0.7204から0.8534に、Native Successは53.08%から73.46%に向上し、20.38ポイントの改善となりました。
- GDPevo:2トラックが単一トラックを上回る。 FACT+TIPをそろえた完全な方式の平均スコアは0.2616で、ゼロショットのベースライン0.0947の約2.8倍でした。TIPのみ、あるいはFACTのみでは、完全な2トラック方式の水準に届かず、環境事実と行動テクニックをあわせて管理する価値が裏づけられました。
- SOPBench:ベイズ的スキル管理との統合でさらに向上。 全体の成功率は、ベースラインの79.15%から単一トラック方式で91.59%に上がり、2トラック統合方式では94.58% に達して、単一トラック方式をさらに2.99ポイント上回りました。
- PinchBench:実世界のタスクでも安定した向上を維持。 TTSEを非侵襲的な方法でOpenClawに接続し、147件の実世界のエンドツーエンドタスクで独立に3回実行しました。2トラック方式の平均スコアは0.7439から0.7822に上がり、3.83ポイント増加しました。3回の実行で向上の方向は一貫しており、実行間の幅も3.33ポイントから1.61ポイントに縮小しました。
これらの結果は、身体性インタラクション、科学的推論、企業運営、産業プロセス、実世界のエンドツーエンドタスクをカバーしています。TTSEの価値が特定のモデルや単一のシナリオに限られないことを示しています。
アブレーション実験:なぜ2トラックが必要なのか?
GDPevoのアブレーション実験は、より直接的な証拠を示しています。完全な2トラック方式は、事実だけ、あるいはテクニックだけを記録する単一トラック方式を上回りました。
その理由は、環境認識と行動戦略が異なる役割を担っているからです。FACTだけでは、エージェントは環境の制約を知っていても、適切な行動方法を持てません。TIPだけでは、エージェントは操作のテクニックを身につけていても、それが成り立つ条件を正確に見分けられません。両者を組み合わせて初めて、「環境がどうなっているか」と「現在の条件下でどうすべきか」の両方に答えられます。
したがって、2トラック設計は単に経験ライブラリを2つに分けるものではありません。種類の異なる知識を、それぞれの意味と適用条件に従って、帰納、検証、再利用できるようにするものです。
モデルをまたぎ、タスクをまたぎ、実世界の評価に至るまで、実験結果はTTSEの2トラック経験の仕組みの有効性を裏づけるだけでなく、経験学習の層でのRSIの応用可能性も示しています。Agentは、モデルのパラメータを変えなくても、タスクの経験を継続的に蓄積・検証・更新することで、後続のタスクのパフォーマンスを徐々に改善できます。
これは、TTSEが研究フレームワークから実際のオフィス向けエージェント製品へと進むための、実証的な根拠にもなります。
TTSEの2トラック自己進化をWorkSwarmに導入
TTSEは論文の実験で有効性が検証されただけでなく、openJiuwenのWorkSwarm(スウォーム型オフィスエージェント)にも正式に導入されました。
TTSEを実際に体験してみませんか? WorkSwarm 0.2.7以降をインストールして起動し、設定でTTSE自己進化スイッチをオンにするだけで、経験の蓄積と再利用による効率向上を体験できます。
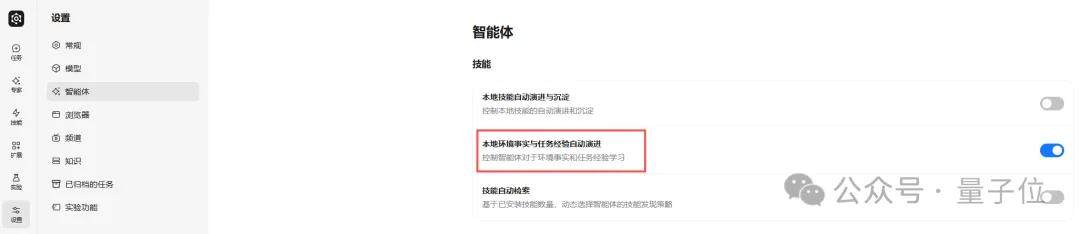
ここからは、2つの実際のオフィスタスクを通じて、TTSEがAgentの実行をどのように速く、効率的にするのかを見ていきます。
TTSEが実際のオフィスシーンへ:経験を効率に変える
日常のオフィス業務では、データクレンジングと分析、文書の編集と整理、レポート作成、情報抽出、フォーマット変換といったタスクで、Agentがすでに広く使われています。ところが、ファイル構造、データ形式、業務要件が異なると、Agentは環境を何度も探索し、ツールの呼び出しを試し、タスクの実行経路を手探りでやり直さなければならないことがよくあります。
TTSEの実際の効果をわかりやすく示すため、チームはExcelデータクレンジングと、文書・表の整理という2つの代表的なオフィスシーンを選び、Agentの初回実行と、経験を注入したあとの実行を比較しました。
結果として、どちらのシーンでも程度の差はあれ効率が向上しました。
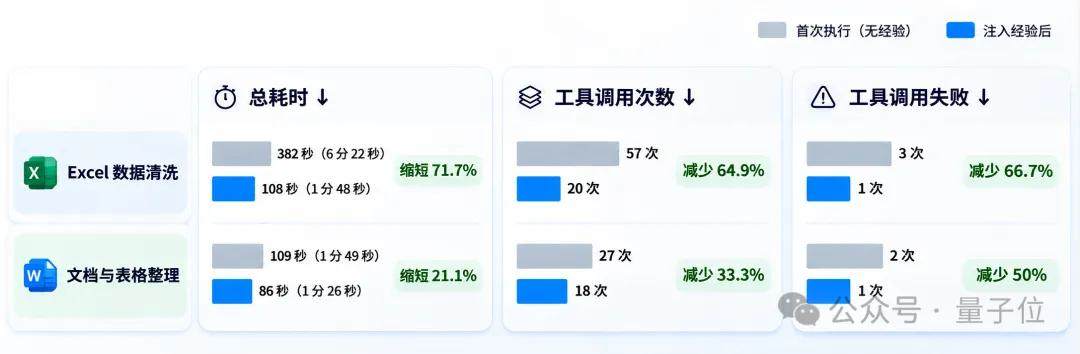
これらの向上はモデルの能力が変わったためではありません。ここで示した比較タスクでは、Agentが過去の実行経験を活用し、環境の制約をより速く見抜いて、適切な処理方法を選べたことによるものです。
では、TTSEは具体的にどのような経験を蓄積し、Agentの試行錯誤をどう減らしたのでしょうか?
ケース1:Excelデータクレンジング——データの識別と処理における試行錯誤を削減
このタイプのタスクの難しさは、データをクレンジングすることだけではありません。入力ファイルの特定、隠れたデータ形式の問題の識別、業務要件に合った重複排除ルールの決定も含まれます。
初回の実行では、Agentには再利用できるタスク経験がなく、入力ファイルの場所を自分で探索し、データ形式を判断し、重複レコードの処理ルールも自力で導き出す必要がありました。プロセス全体でツール呼び出しは57回、うち3回が失敗し、所要時間は合計6分22秒でした。
タスク終了後、TTSEは実際の実行軌跡から、再利用可能なタスク経験を抽出しました。それらは過去の操作の単なる記録ではなく、次回の実行の意思決定に直接影響する根拠となります。
- 入力素材を素早く特定する。 ユーザーがファイルの場所を明示していない場合は、まずworkspace/inputを確認して上流のファイルを直接探します。無関係なタスクディレクトリで何度も探索せずに済み、ユーザーへの不要な問い合わせも省けます。
- データの問題を深く見抜く。 Excel上で一見正常に見える日付、金額、テキストに対して、openpyxlで元の格納値を直接調べます。テキスト型の日付、通貨記号、末尾の空白といった隠れた問題を見つけ、読み取り方法の不備による見落としを減らします。
- 検証済みの重複排除ルールを再利用する。 業務フィールドでグループ化し、最も古い日付のレコードを残して削除件数を記録します。重複排除の基準を一から導き出す必要がなくなり、重複した判断や試行錯誤が減ります。
似たタスクを再度実行すると、これらの経験がツールの選択や処理の意思決定に直接反映されました。ツール呼び出しは20回に、失敗呼び出しは1回に減り、所要時間は1分48秒に短縮されました。
ケース2:文書と表の整理——ファイル探索とフォーマットの試行錯誤を削減
Excelデータクレンジングとは異なり、このタイプのタスクの主な難しさは、ファイルの場所が不明であること、CSVのエンコーディングと区切り文字がはっきりしないこと、Wordテンプレートの構造が複雑なことにあります。初回の実行では、Agentはファイルを一つずつ探索し、形式を識別し、適切なテンプレートの処理方法を決める必要がありました。
文書と表の整理タスクでは、Agentの初回実行は所要時間1分49秒、ツール呼び出し27回、うち2回が失敗でした。タスク完了後、TTSEは実際の実行軌跡から、環境事実と操作テクニックのセットを蓄積しました。
再実行では、Agentはファイルディレクトリを一から探索したり、CSVの読み取り方法を試したりする必要がなくなりました。文書が生成されてからテンプレート置換の問題に気づくこともありません。検証済みの環境経験を直接再利用し、より適したツールと処理経路を前もって選べるようになりました。
2回目の実行は、所要時間が1分26秒に短縮され、ツール呼び出しは18回、失敗は1回に減りました。全体の所要時間は約21.1% 短縮され、ツール呼び出しは33.3%、失敗呼び出しは50% 減少しました。
過去にどの操作を実行したかを単に覚えるだけでなく、TTSEはさらに一歩進んでいます。Agentは環境に対する認識と、特定の条件下で有効な実行方法の両方を蓄積できます。
経験の蓄積から能力の向上へ。鍵となるのは、正しく再利用することです。
2つのオフィスケースは、TTSEが実際のタスクで持つ応用価値を示しています。Agentは毎回ゼロから探索する必要がなく、過去のタスクで有効と確認された経験を、その後の実行の参考にできます。
これこそがRSIの目指す継続的改善のかたちです。タスクを1回実行するたびに、成果物を生み出すだけでなく、次回の実行に役立つ有効な経験を蓄積できる可能性を持たせることです。 TTSEはFACTとTIPの2トラックの仕組みによって、この経験の蓄積を、より検証可能で、更新可能で、再利用可能なものにします。
では、こうした効果は特定のタスクにとどまるのでしょうか。それとも、より幅広いオフィスタスクでも現れるのでしょうか?
オフィス系ベンチマークでTTSEが示す総合的な効果
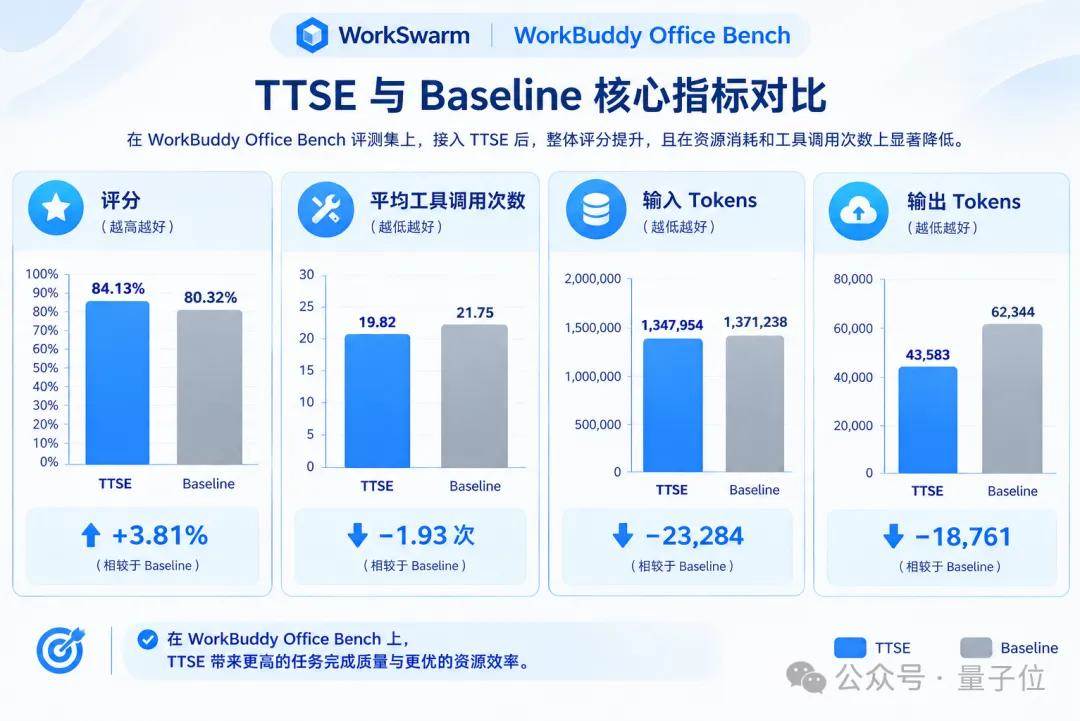
総合的なオフィスシーンでのTTSEの性能をさらに評価するため、チームは業界のオープンソースランキングであるWorkBuddy Office Benchで、TTSEを組み込んだWorkSwarmをテストしました。
TTSEはタスクのパフォーマンスを高めただけでなく、トークン消費とツール呼び出しのコストも効果的に下げました。評価結果によると、ネイティブの状態と比べて、タスクのパフォーマンスは3.81%向上し、入力トークン消費は1.70%、出力トークン消費は30.09%減少し、平均ツール呼び出し回数は2回減りました。
おわりに
私たちは今、Agentが「使い捨てのツール」から「ともに進化し続けるパートナー」へと変わる転換点にいます。
RSIの中核的な価値は、Agentにより多くのタスクをこなさせることだけではありません。実際の実行のたびにフィードバックを得て、経験を蓄積し、その経験を継続的な改善能力へと変えていけるようにすることです。
HarnessとArtifactsの2次元最適化から、TTSEによる環境事実と実行テクニックの2トラック進化まで、openJiuwenは、知能体が継続的に自己改善していくためのさまざまな道を探っています。作業方法と成果物を最適化するだけでなく、環境認識を絶えず補正し、信頼できる経験を蓄積していきます。
TTSEは、経験の自己進化に対して、検証可能で追跡可能な実現の仕組みを提供します。Agentが「どうやるか」を学ぶだけでなく、「どのような環境でこのやり方が有効なのか」も理解し、タスクを実行するたびに自らを磨き続けられるようにします。
経験は、束の間の雲であってはならない。Agentに「どうやるか」を学ばせ、さらに「世界はどうなっているか」を学ばせること。それが、長期的な自律への最初の一歩である。
学術論文:TTSE: A Two-Track Online Self-Evolution Framework for LLM Agents
論文原文:https://arxiv.org/pdf/2609.24289