
速度は上がり、API価格は下がった
正直なところ、新登場のGPT-Image 2.6ほどの実力があっても、画像を100回連続で編集するという高負荷タスクには、あの「名言」を叫ばずにはいられない。
自分で自分を縛っちゃったよ、リナ!
たとえば、まず Image 2.6 に次の元画像を入力する。
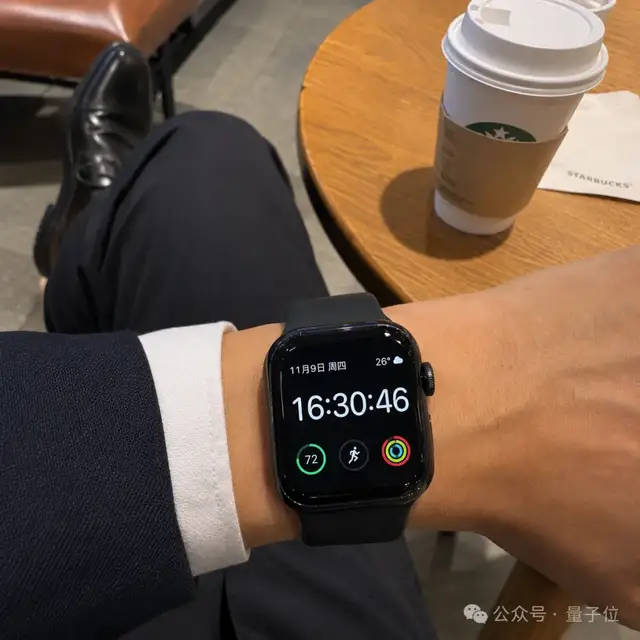
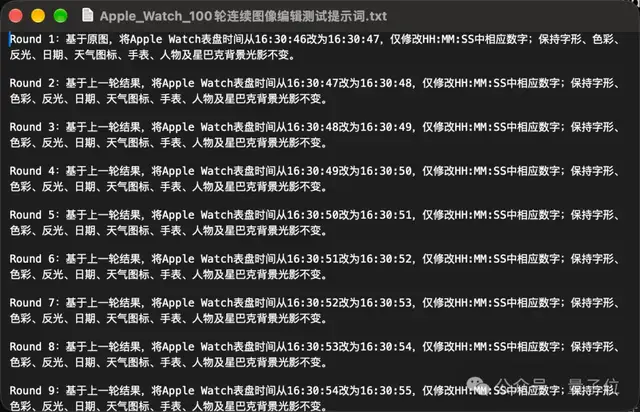
続いて、100ラウンド分のタスクを記したプロンプトを渡す。毎ラウンド、腕時計の時刻を1秒ずつ進め、前のラウンドで生成した画像を次のラウンドの入力にするという内容だ。
ところが、一見簡単そうなこのタスクで、Image 2.6 が出した結果はこうなった(変化を見やすくするため、100枚の画像を1本の動画にまとめた)……
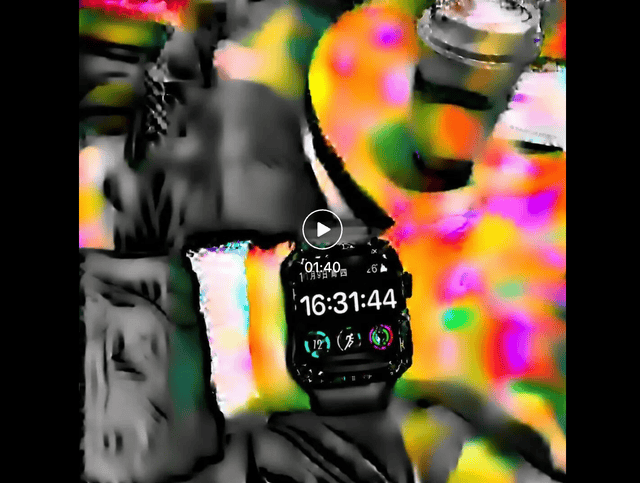
動画はこちら: https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
10ラウンド目あたりから元画像が歪みはじめ、先に進むほど崩れがひどくなっていくのがはっきり分かる。
これが実際の業務だったら、とんでもなく大きな問題になる。
But!!!
新登場の中国製画像生成AIは、この高負荷タスクをきっちりこなしてみせた。結果をご覧いただきたい。
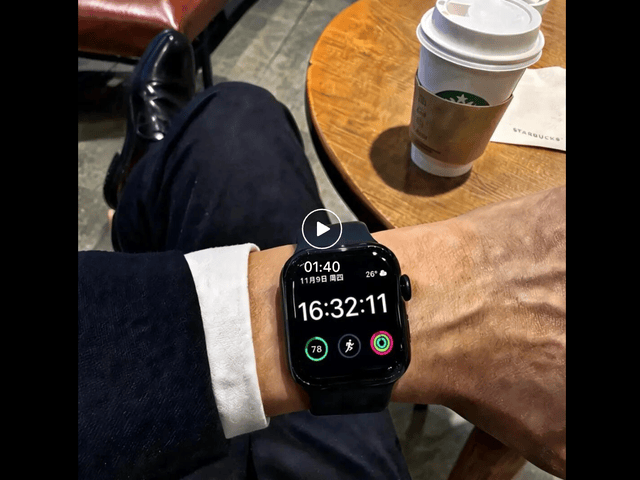
動画はこちら: https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
後半のラウンドでは多少の歪みが残るものの、全体として Image 2.6 よりはるかに忠実さを保っている。
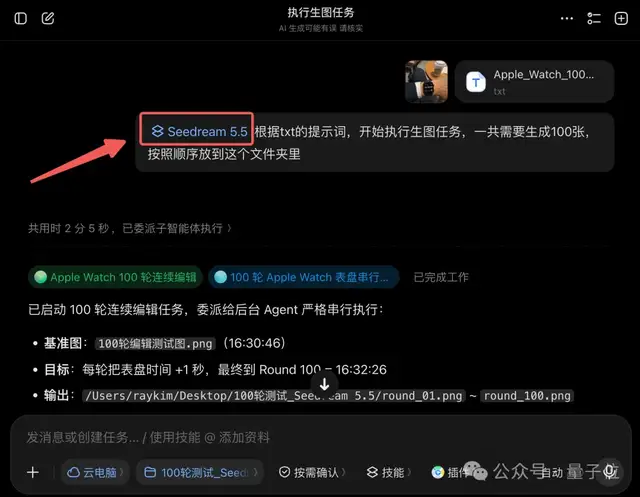
この新しい中国製画像生成AIこそ、ByteDance の Seedream 5.5 だ。
上のタスクは、Doubao で新モデルを呼び出して実行したものである。
とはいえ、100回編集しても崩れないというのは、今回の Seedream 5.5 のアップデートのほんの一面にすぎない。全体を見渡すと、ほかにも次のような特長がある。
- **リアリティの向上:**人物・質感・光の表現が実写に近づき、複数の画像を組み合わせても違和感が出にくい。
- **小さな文字と多言語のレンダリング:**ポスター、ラベル、インフォグラフィックの文字もほとんど誤記がなく、多言語にも対応している。
- **透過画像の生成と編集:**背景透過の画像(PNG)を直接出力できるため、面倒な切り抜きが不要になる。完成画像をレイヤーに分解し、コピーだけを個別に修正したり、別言語版を出力したりすることも可能だ。
それだけではない。Seedream 5.5 は生成速度も以前のバージョンよりかなり速くなった。あわせて、公式情報によると、Seedream 5.5 API は引き続き「入力画像+出力画像」の二段階課金方式で、テキストトークンには課金されない。2K正方形画像の編集を例にとると、1枚あたりのコストは約0.28元で、Seedream 5.0 Pro の半額に満たない。
口先だけでは始まらない。ここからは、じっくり実テストに入ろう。
思う存分「やりたい放題」の実テスト
より複雑な連続編集
最初のテストでは、Doubao でさらに複雑な連続編集に挑戦する。
先ほどの100ラウンドの編集は画像内の腕時計の時刻だけが対象だった。今回は、リアルなリビングの写真をもとに、さまざまなディテールを連続で編集していく。
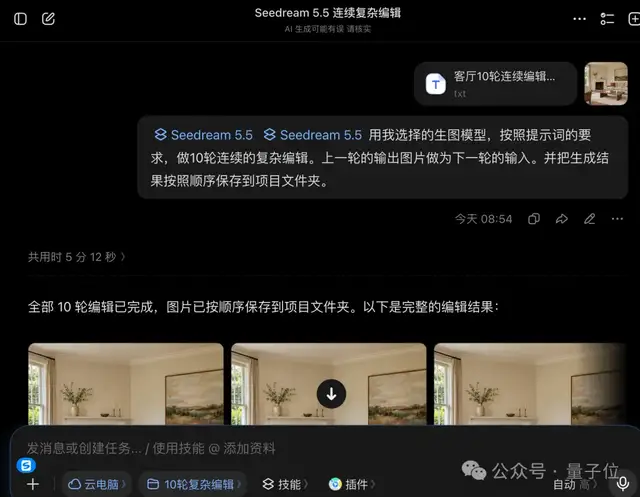
比較しやすいよう、今回も10枚の写真を動画にまとめた。
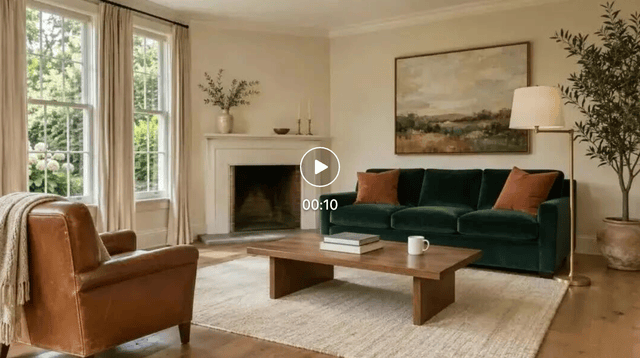
動画はこちら: https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
このラウンドで試されるのは、大規模モデルの記憶力だ。
各ラウンドの入力は直前の出力だけで、モデルは最初の元画像を見られない。そのため、後の工程でひとたびミスが出ると、ミスが次々に連鎖し、誤差が蓄積していく。
そして、これこそが今回 Seedream 5.5 が打ち出している精密な編集とマルチターンでの一貫性である。
高級感のある広告を1枚に合成する
2つ目のテストでは、実務に近いタスクとして複数画像の合成による広告制作を行う。
そのため、あらかじめ3枚の入力画像を用意した。女性モデルの画像、バッグの画像、背景画像だ。
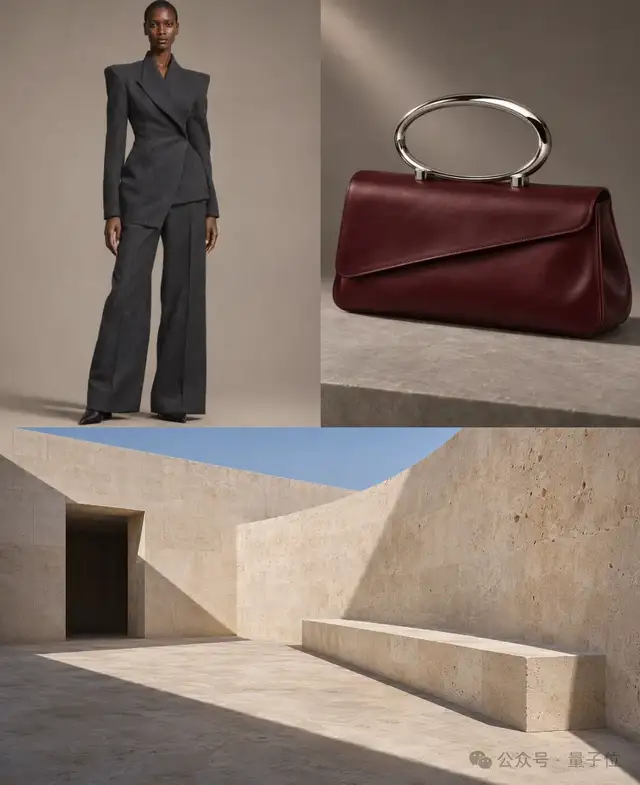
プロンプトもごくシンプルだ。
アップロードした3枚の参考画像を融合し、高級ファッションブランドのハンドバッグ広告のメインビジュアルを作成してください。16:9の横長で、できる限り高解像度のハイパーリアルな写真作品として出力してください。
わずか1分後には、高級商品の広告ビジュアルが完成した。
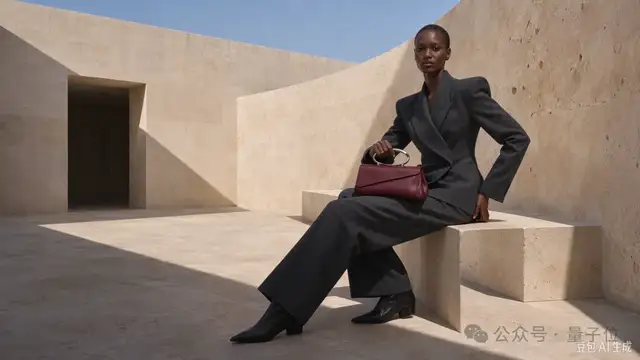
この3枚の入力画像は、撮影条件がまったく異なる。モデルはスタジオのソフトライト、バッグは静物用のサイドライト、背景は屋外の直射日光だ。
複数画像の融合で難しいのは、それらを「同じ撮影で撮ったもの」に見せることである。
仕上がりを見ると、モデルは立ち姿から座り姿に変わったが、スーツの生地、バッグの斜めのフラップと金属リングのハンドルはしっかり保たれ、バッグのサイズも実物に即した比率になっている。
これこそ、Seedream 5.5 が複数画像の融合で実現したアップグレードだ。被写体同士のサイズ、パース、光の関係がより自然に整っている。
半透明のPNG素材の合成でも、Seedream 5.5 はかなり安定している。たとえば今回は、5枚のPNGをそのままアップロードした。
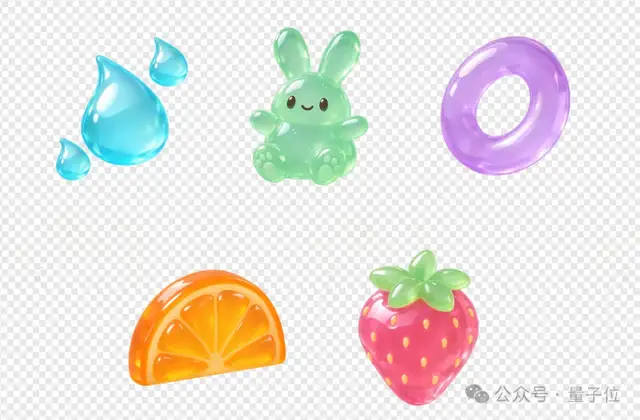
そして、次のようなプロンプトを添える。
アップロードした5枚の透過PNG素材を組み合わせ、カートゥーン調のゼリースタイルの完成されたメインビジュアルとして再レンダリングしてください。アスペクト比は16:9、解像度は3840×2160。テーマは「ゼリーフルーツがふわふわ浮かぶ楽園」で、高品質なアニメーション映画のスイーツワールドのプロモーションアートのように、爽やかで軽やかかつ、明確な構図と空間的な奥行きを持たせてください。
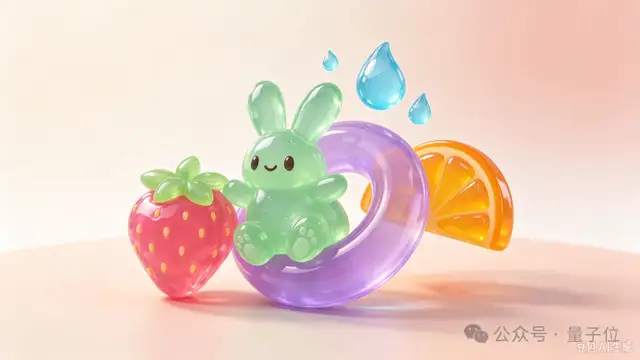
半透明素材は、画像生成モデルにとって昔から難題だった。
透過PNGの縁の処理がうまくいかないと、白いフチやグレーのフチが出てしまう。ゼリーのような質感では、さらに光の透過、屈折、色付きの影も処理しなければならない。
結果を見ると、紫のリングは後ろのオレンジの色を透かし、地面の影もそれぞれの素材の色味を帯びていて、前後の遮蔽関係も明確だ。
映画のスクリーンショットかと思った
リアリティの話をするなら、AIが生成する映画的なカットの表現力も試さないわけにはいかない。
今回のプロンプトは、おおよそ次のとおり。
午前5時、冬のパリ。まだ開店前の古いカフェの中、通りに面した窓辺に40歳前後の女性がひとり座っている。ダークグレーのウールのコートを着て、マフラーは緩め、両手で自然にテーブルの上の白磁のコーヒーカップを包み込んでいる……
Seedream 5.5 に2K高精細画像を一度に5枚生成してもらったところ、速度は相変わらず非常に速く、ほぼ1分以内で完了した。
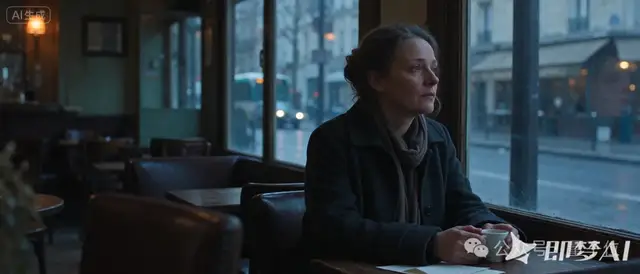
画像が映画のスクリーンショットらしく見えるかどうかは、まず光で決まる。
この画像には2種類の光源がある。窓の外の明け方のやや冷たい空の光と、店内の暖色の壁掛けランプだ。人物の顔やコートにかかる冷色と暖色のグラデーションが、とても自然である。
細部を見ると、窓ガラスには人物のうっすらとした映り込みがあり、窓の外の通りや車のライトは浅い被写界深度で処理されている。人物の皺、緩めたマフラー、どこか疲れた表情も、実在する普通の人らしい。
映像業界にとっては、こうしたビジュアルなら、すでに企画段階のコンセプトアート、絵コンテ、雰囲気の参考資料として使えるレベルだ。
文字だらけのポスターもらくらく対応
リアリティに加えて、優れた画像生成AIには、大量の小さな文字が並ぶ科学ポスターを安定してこなす力も求められる。
そこで、Seedream 5.5 に最近話題の「ワールドモデル」をテーマにしたポスターを作ってもらった。
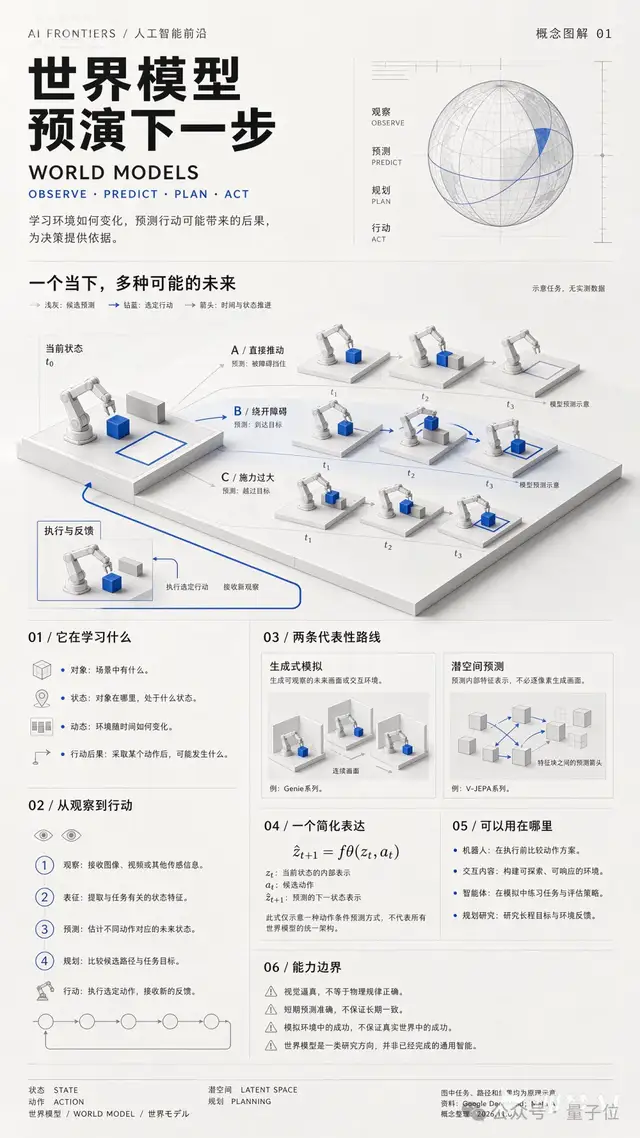
このポスターは情報密度が非常に高く、メインタイトル、各セクションの見出し、本文の小さな文字、フッターの出典表記まで、少なくとも4〜5段階の文字サイズがある。
最も小さい段階を拡大して見ても、文字ははっきりしていて、文字化けはほとんどない。
中国語と英語のほか、フッターには日本語の「世界モデル」も1行入っている。数式の上付き・下付き文字や変数の説明もきちんと対応しており、イラスト内のA・B・Cの3つの経路と t1・t2・t3 の注記も、文章の説明と一致している。
これが、Seedream 5.5 の小さな文字と多言語のレンダリング、そして画像とテキストのレイアウト能力である。
動きを一目見ただけで「真似」できる
アップグレードされた Seedream 5.5 には、もうひとつ特徴がある。複雑な動作でも、一目見ただけで再現できることだ。
たとえば、最近話題の閃身歩の写真と、人物画像を1枚ずつ用意した。
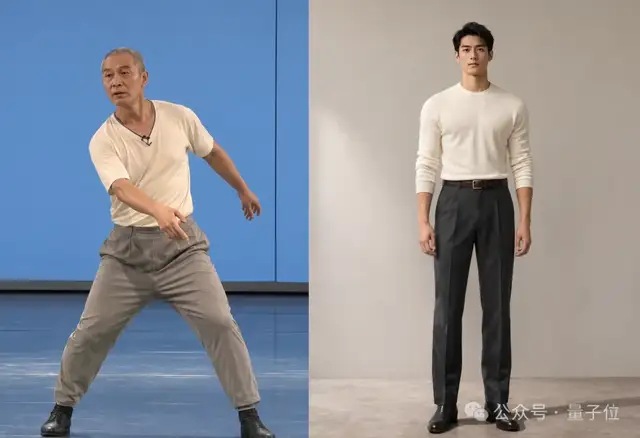
この2枚を Doubao に一度に「食べさせ」、簡単にこう伝える。
参考画像の人物に、元の動作画像の人物と同じ動きをさせて、16:9の画像を出力してください。
こちらもわずか1分で、動作の転写が完了した。
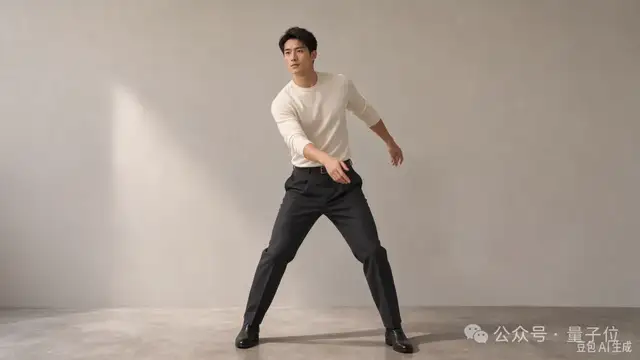
このタスクの難しさは、動作は1枚目から、人物は2枚目から取り、しかも両者の情報が混ざってはいけない点にある。
結果を見ると、大きく踏み出した立ち姿、重心の移動、腕の位置がきちんと転写され、顔を横に向けた表情までついてきている。人物の顔立ち、服装、スタジオの背景は元の画像と一致したままで、アスペクト比も16:9に拡張されている。
さらに、9人分の画像を一度に入力しても、Seedream 5.5 は指定したポーズをとった全員をしっかり生成できる。
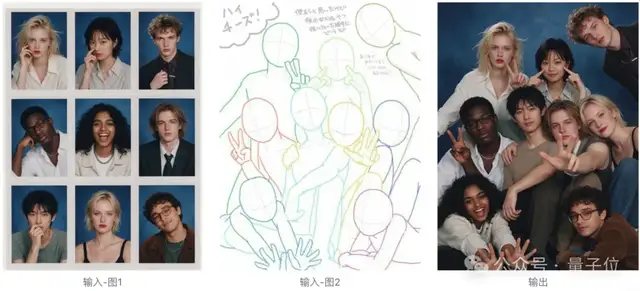
その裏にあるのは、Seedream 5.5 の人体のポーズへの理解と、人物の一貫性を保つ力だ。
編集可能なレイヤーに分解する
次のテストは逆のアプローチだ。
まず完成画像を1枚用意し、画像内の主要な要素を分解したうえで、必要に応じて別バージョンへ編集することを目指す。
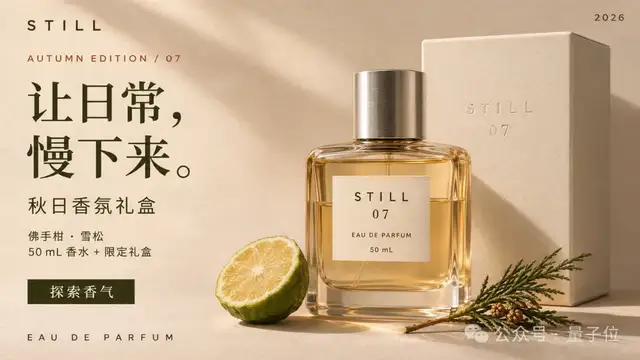
レイヤー分解のプロンプトは次のとおり。
この香水広告の完成画像を、編集可能なレイヤーに分解してください。元のキャンバスの16:9、元の構図、比率、色、オブジェクトの位置は維持してください。実際のレイヤー分解とテキスト認識機能を使用し、「レイヤーの概念図のようなコラージュ」は生成しないでください。
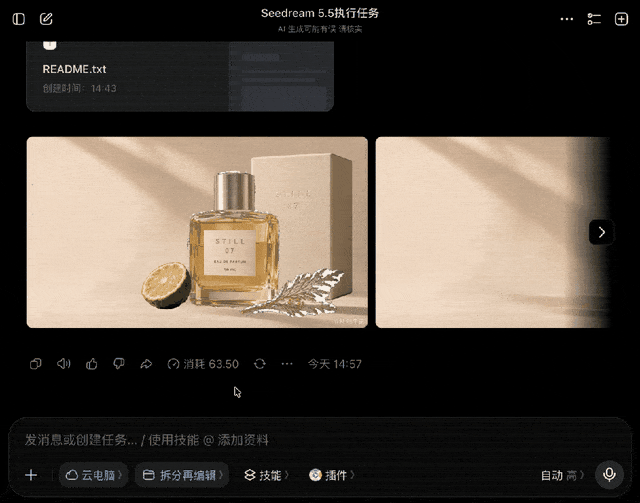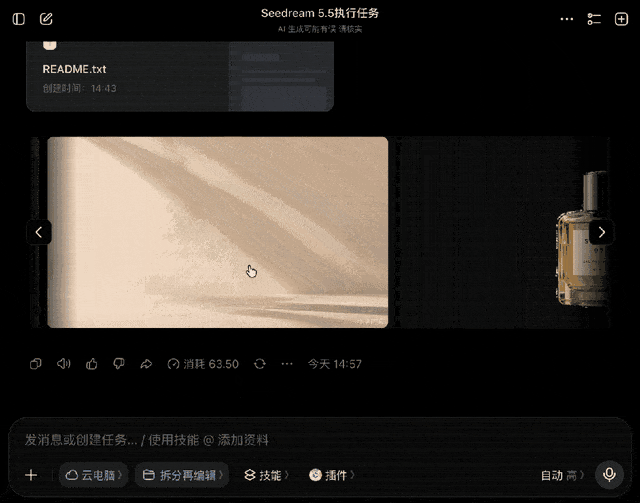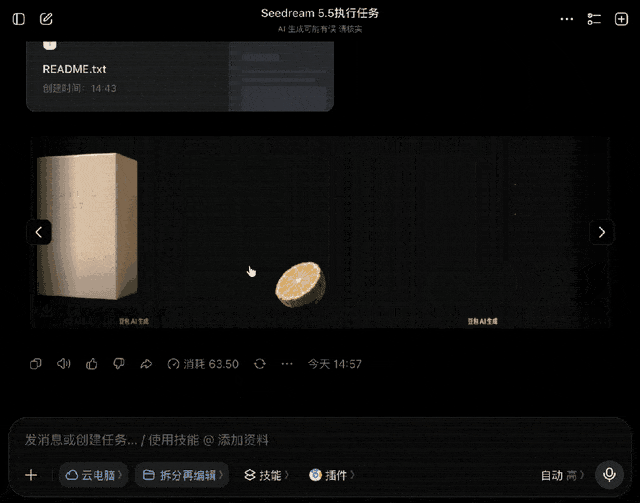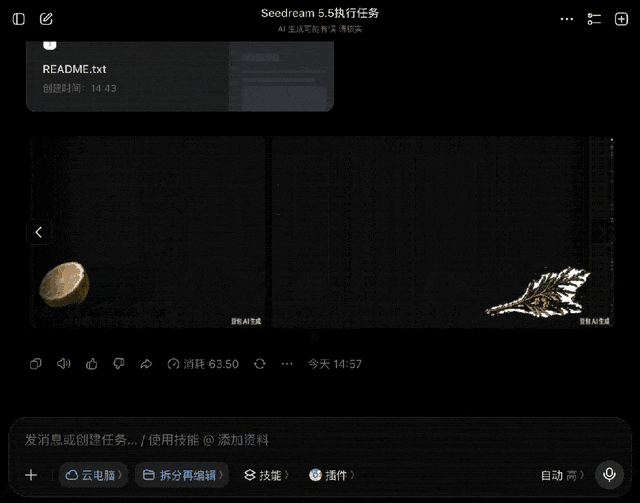
ご覧のとおり、商品画像は Seedream 5.5 によって、指示どおり複数のレイヤーに分解された。
続いて、細部の調整を指示し、英語圏の市場に合う商品画像に仕上げてもらう。プロンプトはおおよそ次のとおり。
すでに分解済みの元の広告プロジェクトをもとに、この市場向けバージョンを作成してください。前の市場向けバージョンを順に翻訳してはいけません。16:9、3840×2160の完成広告画像を1枚出力し、入口が対応している場合は編集可能なプロジェクトも同時に保持してください。
背景、香水瓶、ギフトボックス、ベルガモット、シダーの枝、およびそれらの影のレイヤーはロックし、位置、サイズ、パース、色、質感、光を変えないでください。商品パッケージ上の STILL、07、EAU DE PARFUM、50 mL はそのまま保持し、翻訳や描き直しはしないでください。画面上の STILL のロゴ、AUTUMN EDITION / 07、2026、下部の EAU DE PARFUM も変更しないでください。
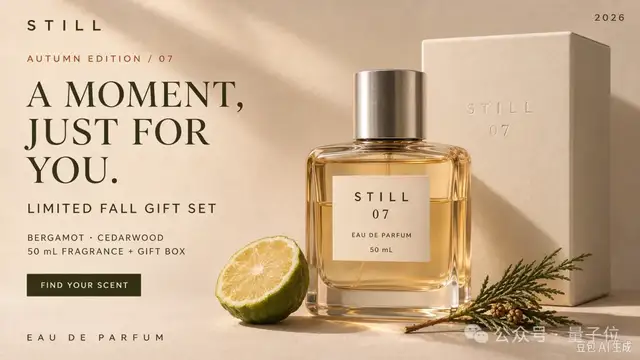
なぜレイヤーに分けるのか。
従来のAI生成画像は「ひとかたまり」だったため、コピーを1文直すだけでも画像全体を生成し直すか、デザイナーが手作業で修正する必要があった。レイヤーに分解してあれば、文字を変えるときは文字レイヤーだけを動かせば済み、ほかの部分には手を触れなくていい。
2枚を比べると、背景、香水瓶、ギフトボックス、ベルガモット、シダーの枝、光と影はすべて元画像と同じで、パッケージ上の STILL、07、EAU DE PARFUM も一文字も変わっていない。
変わったのはコピーだけで、しかも単なる逐語訳ではない。「让日常,慢下来(日常を、ゆっくりに)」は「A MOMENT, JUST FOR YOU.」に、「探索香气(香りを探す)」は「FIND YOUR SCENT」になり、フォントも英語に合うセリフ体に変わっている。
ここで使われたのが、Seedream 5.5 のレイヤー分解とテキスト再編集の能力である。
海外展開するブランドにとっては、1セットのメインビジュアルから複数市場向けのバージョンをすばやく作れるということだ。
GIF?もちろん可能
最後に、以前 Image 2.6 で話題になったGIFの使い方を試してみよう。
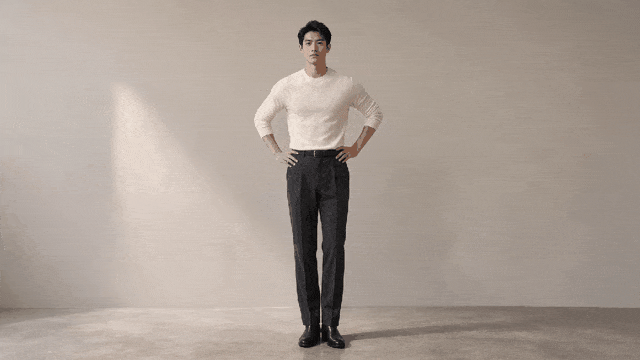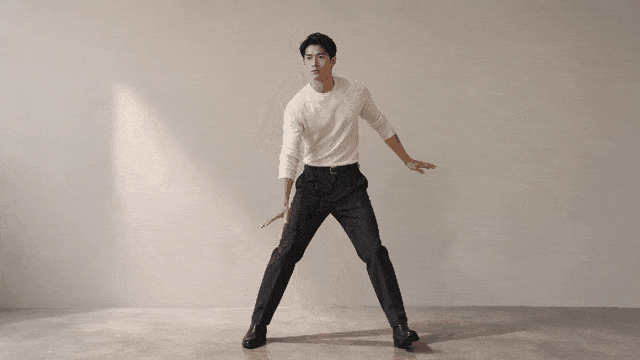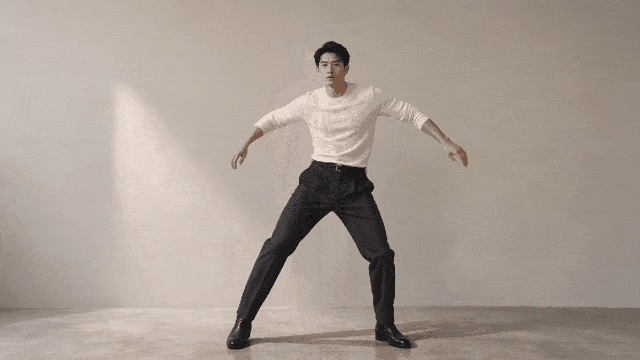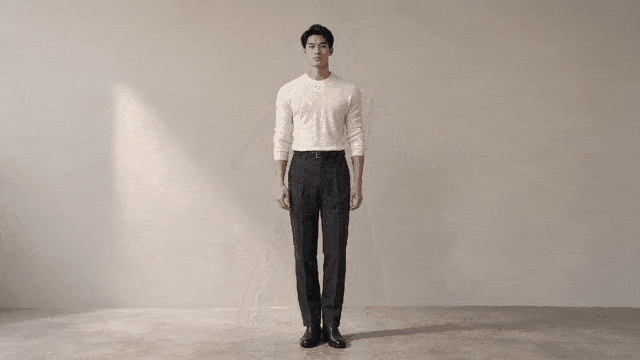
画像には先ほどの「閃身歩」の事例をそのまま使い、今回はこれを動かす。プロンプトは次のとおり。
ネットで「閃身歩」の完全な動画またはGIFを検索し、先ほど生成した人物と Seedream 5.5 を使って、16:9で、サイズが10MBを超えないGIFを作成してください。できるだけ高画質を保ってください。
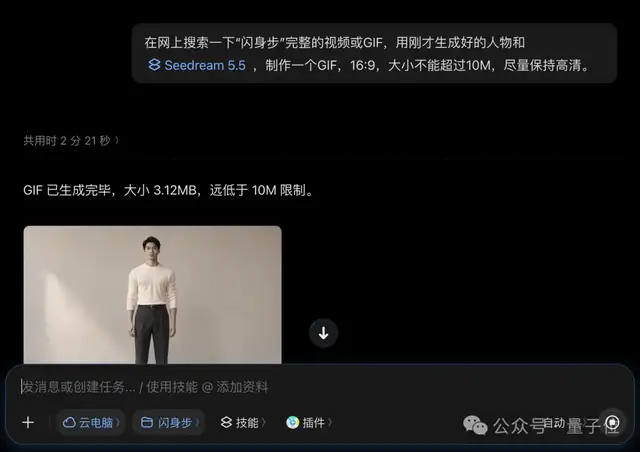
すると、要件を満たしたGIFが、あっさりと誕生した。
つまり、実テスト全体を通して見ると、Image 2.6 にできることは Seedream 5.5 にもできる。そして Image 2.6 にできないことも、Seedream 5.5 ならできてしまう。
これは素晴らしい!
Seedream 5.5:もう自分で自分を縛らなくていい、リナ
率直に言って、いまの画像生成の世界に、きれいな画像を出せるAIはもう十分すぎるほどいる。
足りないのは、50回、さらには100回と編集や修正を重ねても安定を保てるAIだ。
今回の実テストで、Seedream 5.5 から受けた最も強い印象もそこだった。
そして、正確に直せて、安定して直せることは、まさにECの現場が最も必要としている点だ。
商品画像やECのメイン画像は、ほぼ毎日のように修正が入る。色を変える、服を替える、背景を差し替える、コピーを直す、といった具合だ。いまやこうした作業を同じメイン画像の上で連続して行え、1枚の画像からSKUバリエーションを丸ごと展開できる。さらに透過画像の直接出力、レイヤー分解、多言語の文字差し替えが加われば、途中のいくつもの工程を省ける。
映像やコンテンツ制作でも活躍する。
複数画像を融合する際、人物・小道具・シーンのサイズ、パース、光が合うので、参考画像からそのままコンセプトアートや絵コンテを合成できる。パリのカフェのようなリアリティがあれば、企画初期のビジュアル開発にも十分使える。
デザインやマーケティング素材についても同じことが言える。
ポスター、インフォグラフィック、キャンペーンページで最も手を焼くのは小さな文字だ。これまではデザイナーが1文字ずつ補ったり修正したりしていたが、いまは文字量の多いコピーも多言語のテキストも、そのまま配置できる。
さらに前述の価格面での強みもある。能力はトップクラスに迫り、価格は下がっている。毎日大量に画像を作る中小規模の事業者やコンテンツチームにとって、これは計算するまでもなく得な話だ。
最後に、冒頭の「名言」に戻ろう。
基本性能が最も問われる100ラウンド編集というタスクで、Image 2.6 は「自分で自分を縛って」しまった。一方、Seedream 5.5 は、マルチターン編集の安定性において、中国製モデルがすでに海外のトップモデルの先を行っていることを証明してみせた。
現在、Seedream 5.5 は Jimeng、Doubao、Doubao Work で提供が始まっている。興味のある方は、ぜひ自分で試してみてほしい。
One More Thing
最後に、Seedream 5.5 が生成した驚きの画像を、あらためてご覧いただこう。