
最小かつ最も効率的なモデル「Muse Ember」のご紹介
Meta AI が、Claude Haiku や GPT Luna と同クラスのモデル「Muse Ember」を発表しました。Meta は次のように説明しています。
[…] 当社の最小かつ最も効率的なモデルです。複雑な推論の実行や、エージェント(agent)が一日中繰り返し行う作業、つまりツール呼び出し、コーディングのサブタスク、ルーティング、情報抽出、長文ドキュメントの解析に向けて設計されています。
短いプロンプトでの価格は GPT-6 Luna や Claude Haiku 5.5 と同じで、入力は100万トークンあたり 0.10 ドル、出力は100万トークンあたり 0.50 ドルです。本日発表されたもう一つの目玉モデル Claude Fable 5.2 は、その 80倍 にあたる 8 ドル/40 ドルです。
ただし、プロンプトが長くなると料金体系はそれほど単純ではなくなります。Luna、Ember、Haiku はいずれも最大100万入力トークンに対応していますが、それぞれにしきい値があり、超えると価格が上がります。このしきい値を考慮すると、Ember の価格は他の2モデルの中間に位置します。
| モデル | プロンプトサイズ | 入力(USD/100万トークン) | キャッシュ入力 | 出力 |
|---|---|---|---|---|
| GPT-6 Luna | ≤272k | $0.10 | $0.01 | $0.50 |
| GPT-6 Luna | >272k | $0.20 | $0.02 | $0.75 |
| Muse Ember 1.0 | ≤200k | $0.10 | $0.004 | $0.50 |
| Muse Ember 1.0 | >200k | $0.30 | $0.012 | $1.50 |
| Claude Haiku 5.5 | ≤100k | $0.10 | $0.01 | $0.50 |
| Claude Haiku 5.5 | >100k | $0.50 | $0.05 | $2.50 |
とはいえ、今やトークン単価を比べるだけではあまり意味がありません。推論トークンの存在により、同じ問題を解くのに使うトークン数がモデルごとに大きく異なる場合があるためです。
そこで役立つ指標が Artificial Analysis です。
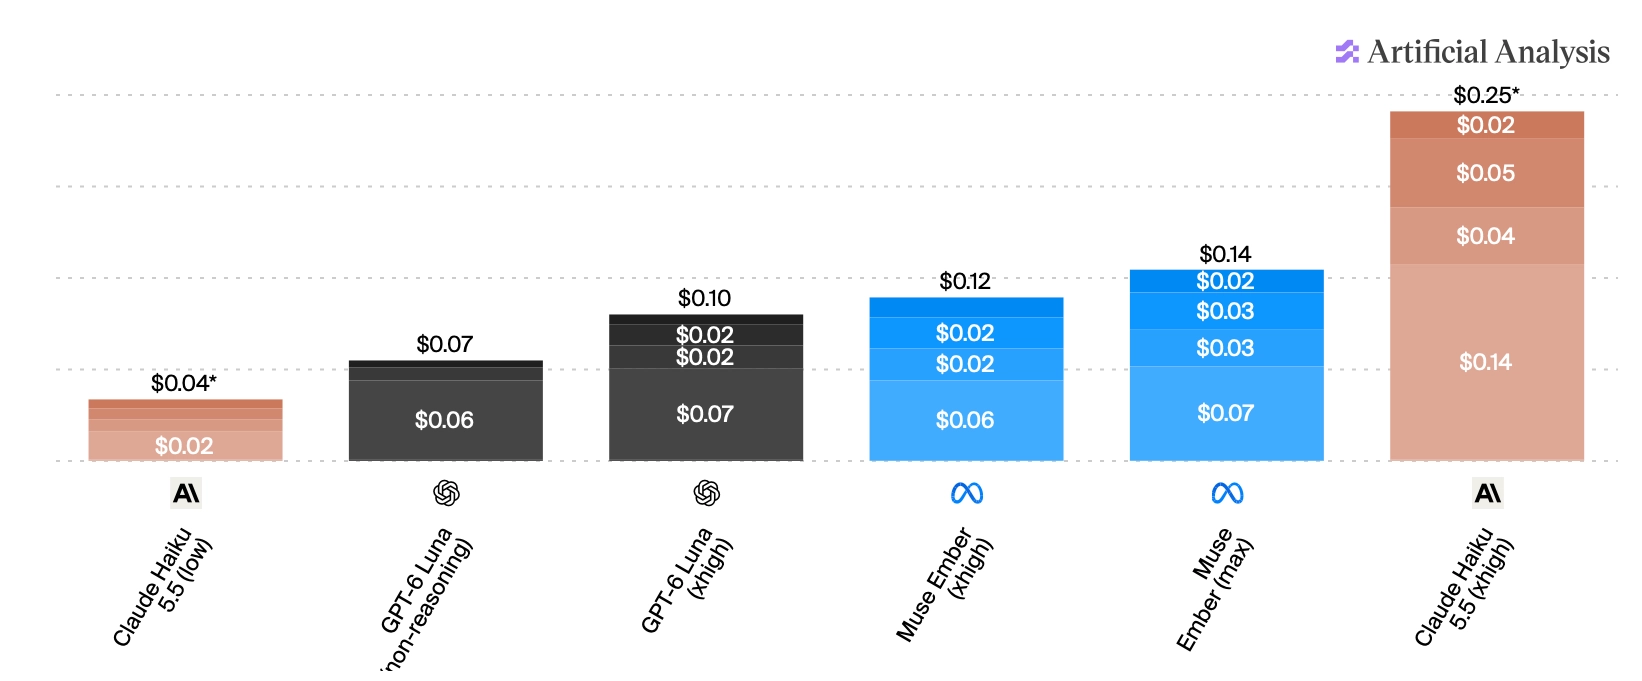
さらに有用なのが、同サイトの「Intelligence Index vs. Cost per Task」グラフです。下図はこの3モデルの状況を示しています。
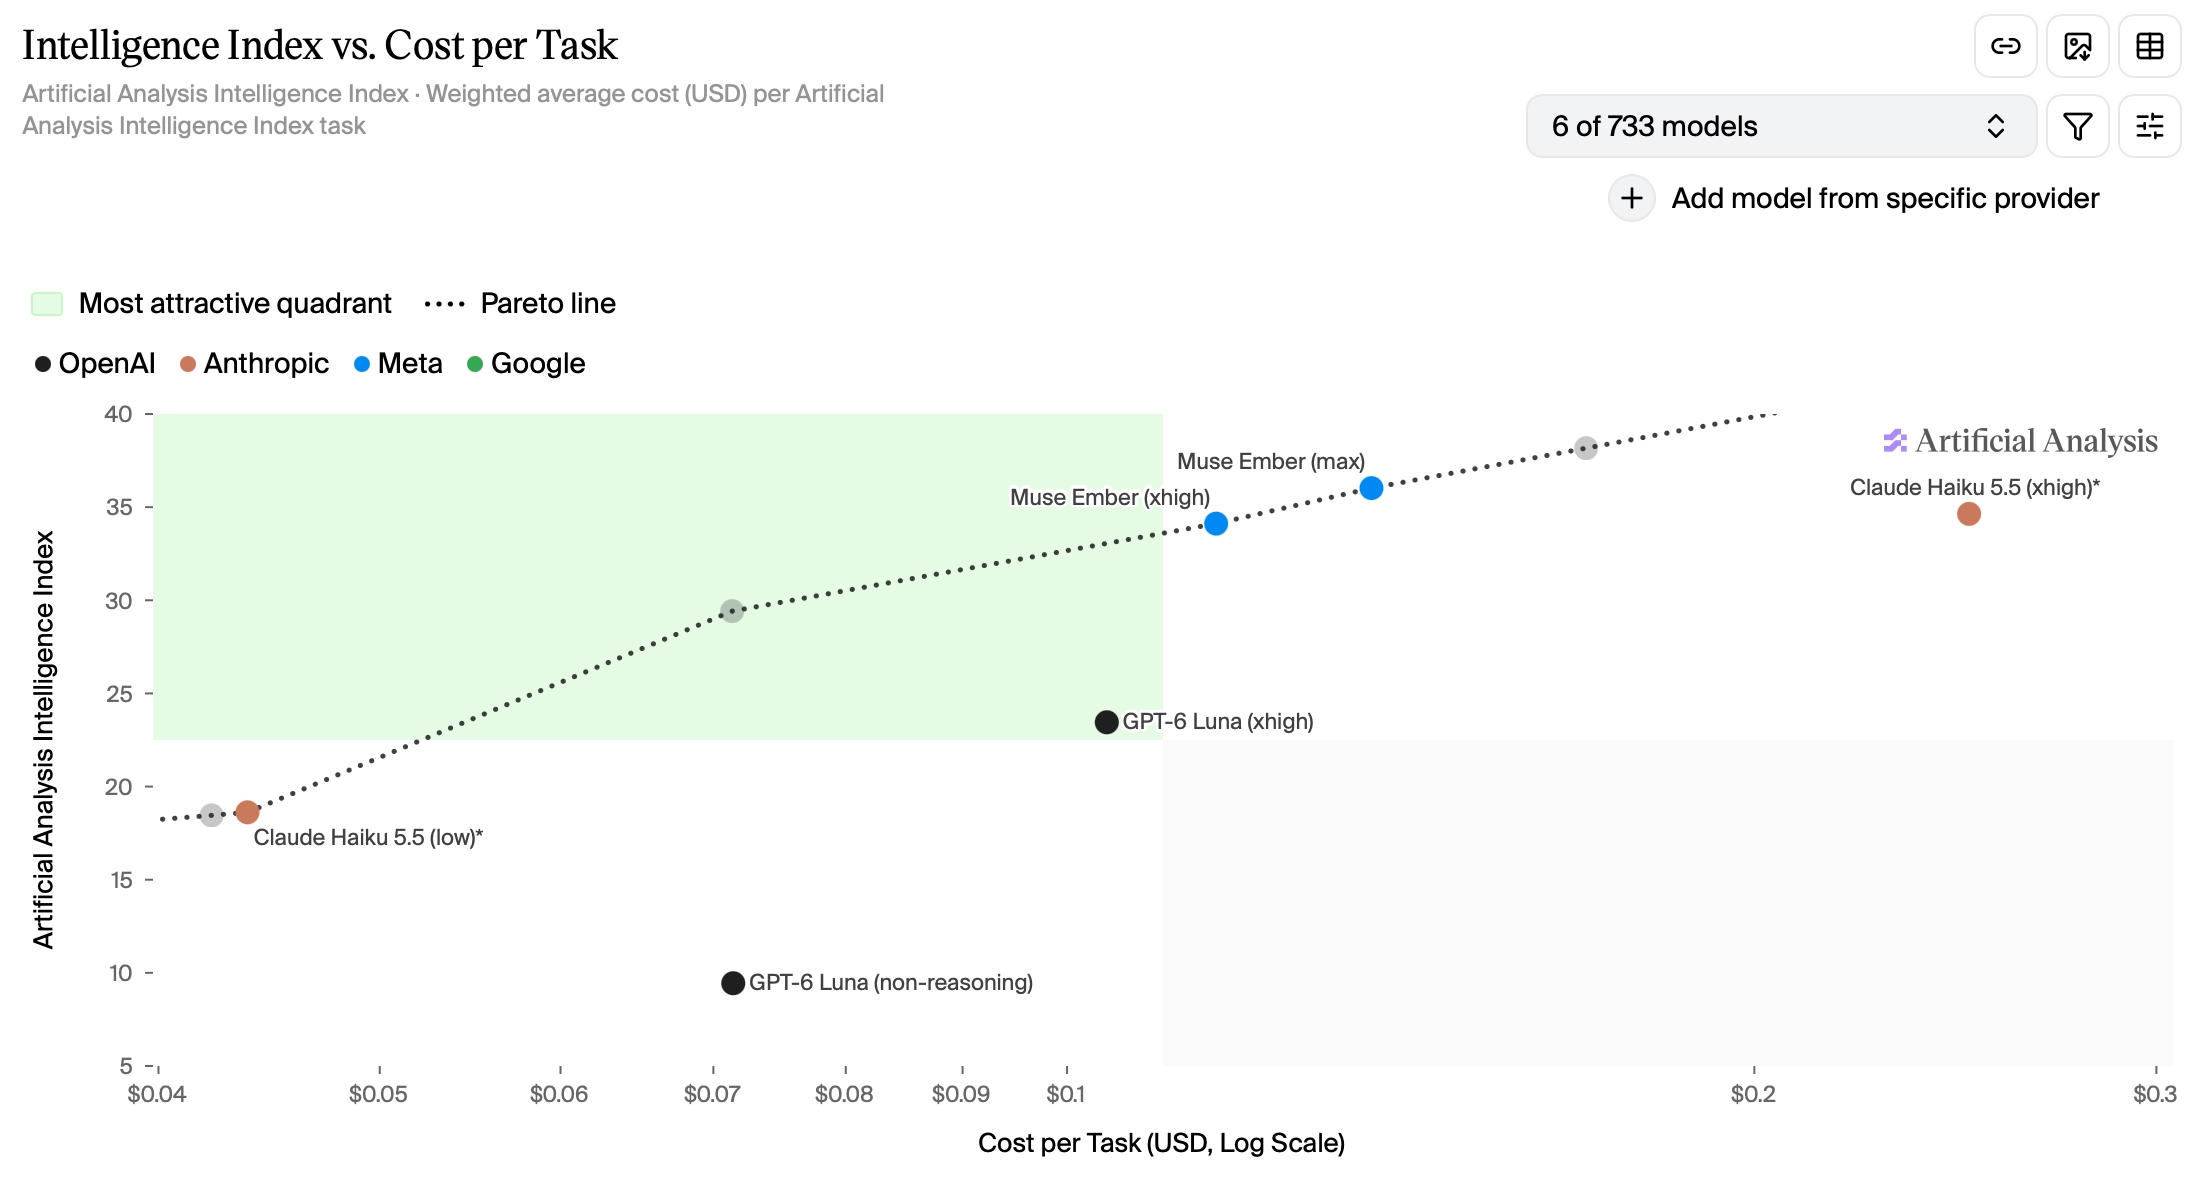
Muse Ember モデルはちょうどパレート線上にあります。つまり、この線上では、どちらか一方の指標を改善しようとすると、もう一方を犠牲にせざるを得ません。Meta も発表の中でこの点に触れています。
完全版の Artificial Analysis リーダーボードでも、効率のフロンティア上に位置しています。タスクあたりのコストがより低く、かつより高いスコアを出しているモデルは存在しません。
(緑色の領域の中ほど、パレート線上にある灰色の点は GPT-6.1 Terra(low)です。Terra シリーズにはもっと注目すべきなのかもしれません。)
Muse Ember には minimal、low、medium、high、xhigh、max の6段階の推論レベルがあるため、自転車に乗るペリカンを6枚レンダリングしました。「high」レベルでは完全な SVG が返ってきませんでした。それ以外の SVG については、意外なことに、推論レベルと出力の見た目の品質との間に明確な対応関係は見られませんでした。
以下は「max」レベルの結果ですが、他のものも見る価値があります。
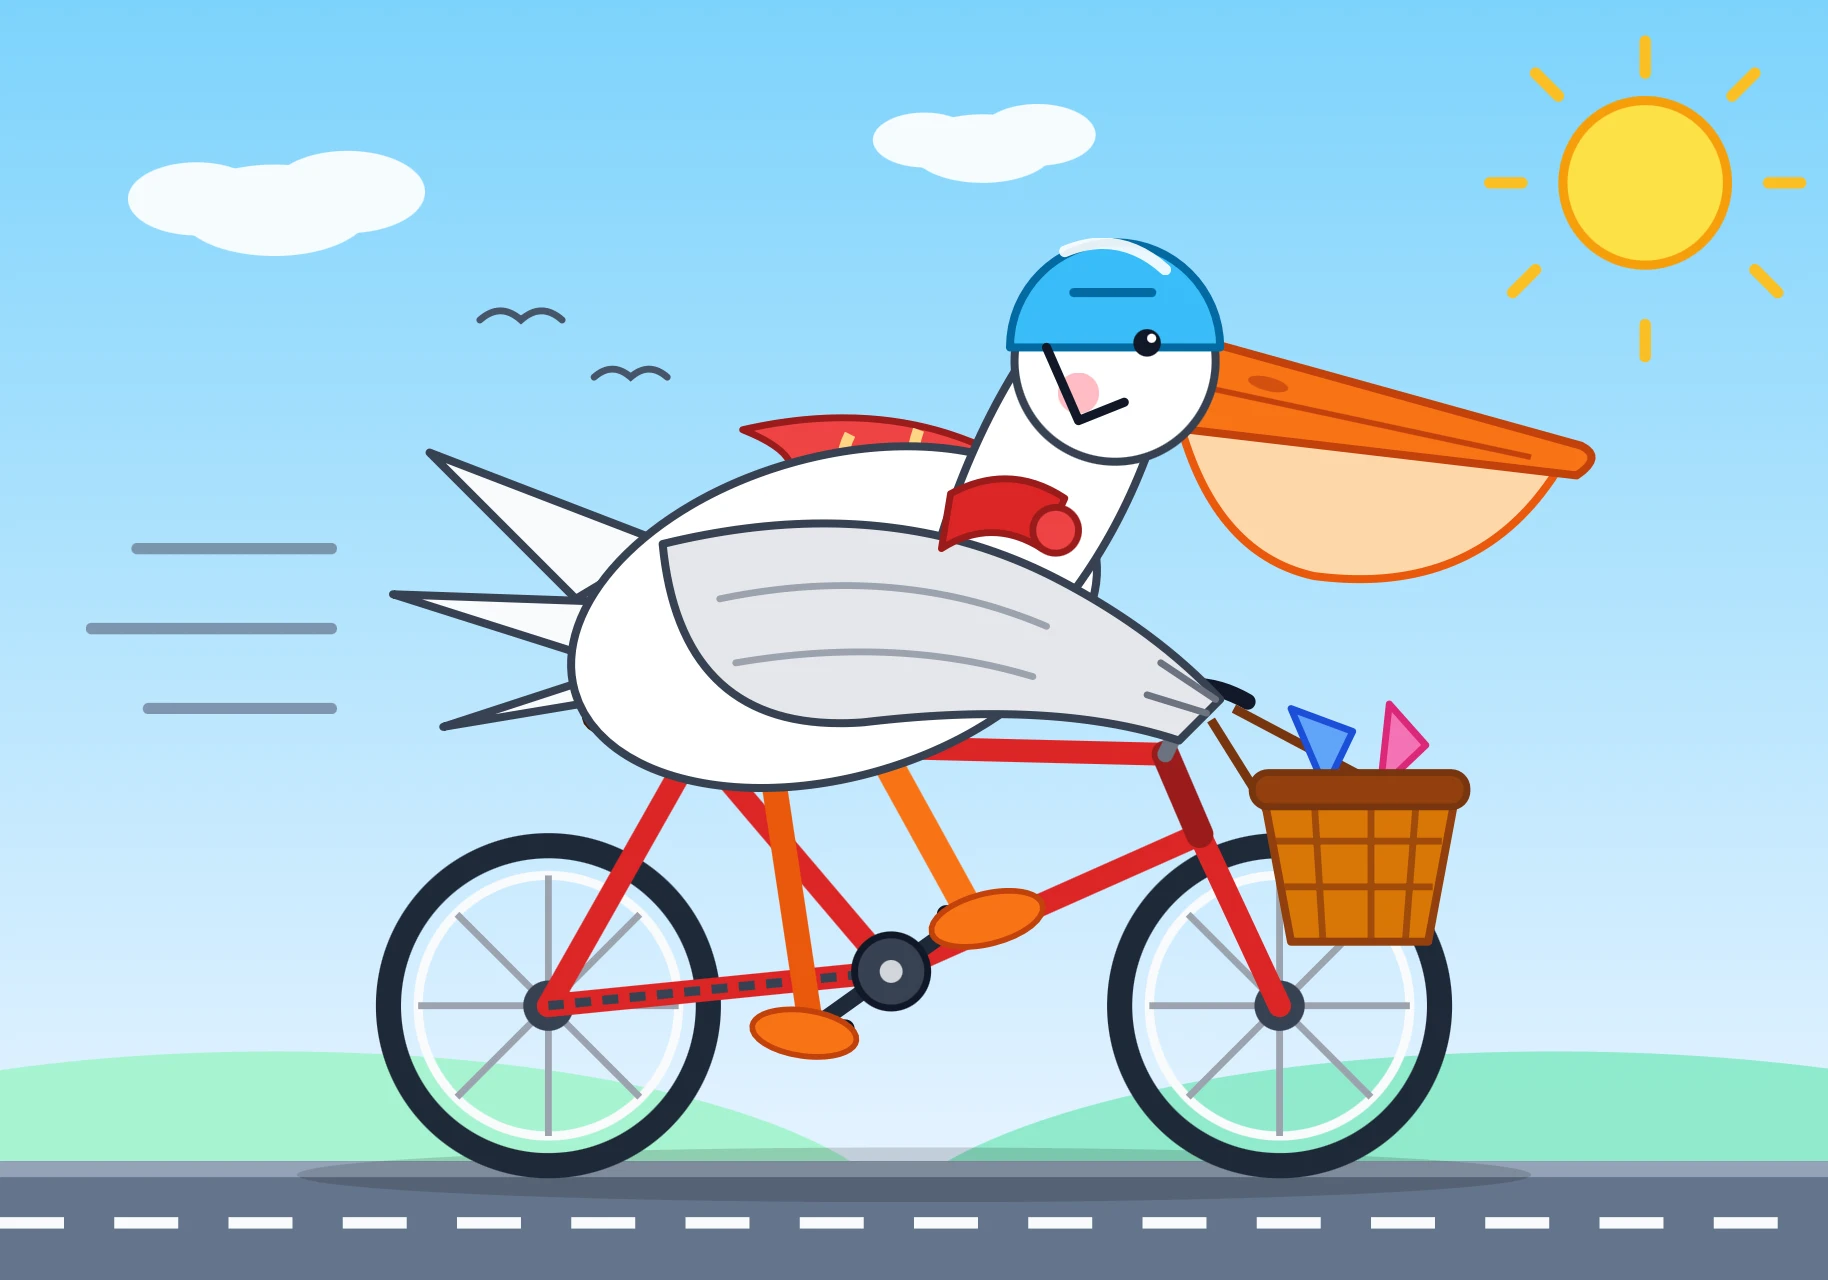
Ember が生成したペリカンは、Muse Wonder で得られた結果と同程度の品質でした。しかも Muse Wonder の価格は Muse Ember の 40倍です。