
MoE 言語モデルにおけるエキスパートの高次プルーニング
はじめに
Mixture-of-Experts(MoE)モデルにより、最先端の大規模言語モデル(LLM)は数千億パラメータへとスケールアップできるようになりましたが、これには根本的かつ非常にコストのかかる課題が伴います。それは、任意のトークンに対して大多数のエキスパートがアイドル状態であるにもかかわらず、推論時にはすべてのエキスパート MLP が VRAM 上に常駐していなければならない点です。例えば、Qwen3.5-122B は 48 の MoE 層のそれぞれに 256 のエキスパートを備えており、約 250 GB に及ぶパラメータの VRAM 使用量のうち、95% がこれらエキスパート MLP 単独で占められています。しかし、任意のトークンに対して各層で実際に使用されるのはわずか 8 つのエキスパートにすぎません。
**エキスパートプルーニング(Expert pruning)**は、この VRAM のボトルネックに対処する最も直接的なアプローチの 1 つです。これは最も使用頻度の低いエキスパートを恒久的に削除する手法です。プルーニングは、エキスパートの動的なロード/アンロードを非実用的にしているレイテンシの問題を回避でき、追加の学習を一切必要とせず、さらに量子化技術と組み合わせることも可能です。こうした非常に魅力的な利点とそのコンセプトのシンプルさから、エキスパートプルーニングが MoE モデルのサイズ圧縮における代表的な手法となっている理由は明白です。課題となるのは、どのエキスパートを削除するのが最も安全かを判断することです。
既存のプルーニング手法は、各エキスパートを独立して評価し、(キャリブレーションデータセットに基づいて)エキスパートごとにスカラー重要度スコアを割り当てて、最も重要度の低いエキスパートを(各層ごとに独立して)削除します。これらは各エキスパートの貢献が互いに独立していると仮定しているため、**1次(first-order)**手法に分類されます。しかし実際には、エキスパート同士は協調的なグループを形成します。私たちは自身の実験において、同時にアクティベーションされるエキスパートに一貫したクラスタリング現象が存在することを観察しており、独立した研究でもエキスパートの協調が MoE の安定した特性であること、そしてモデルの性能にとって極めて重要であることが示されています。こうした相互作用を無視すると、特に高いプルーニング率において最適とは言えない結果を招くことになります。
私たちの最新の論文では、エキスパート間のペアごとの相互作用を考慮した**2次(second-order)**手法である HOPE(Higher-Order Pruning of Experts:エキスパートの高次プルーニング)を導出しました。50% のプルーニング率において、HOPE はすべての手法の中で最高の平均ランクを獲得し、エージェンティックコーディング(agentic coding)タスクにおいて、次点の手法と比較して最大 +6.1% の向上を達成しました。
本稿では、HOPE の仕組みを解説し、既存の手法と比べてどの点で優れているかを示し、ご自身のモデルでどのように適用できるかを実演します。MoE アーキテクチャに馴染みのない読者の方は、Transformers における Mixture-of-Experts(MoE) をご覧ください。
エキスパートは単独で機能しているわけではない
標準的な MoE では、各層に $E$ 個のエキスパートが含まれ、各入力トークン $x$ はそのうちの $K$ 個のエキスパートに独立してルーティングされます(通常は $K = 8$ が選択されます)。ルーティングは単一のネットワーク層によって行われ、各エキスパート $k$ に対して Softmax で正規化されたゲーティング重み $g_{k}(x)$ が生成されます。そしてゲーティング重みが最も高い $K$ 個のエキスパートが選ばれ、アクティブなエキスパートの集合 $T(x) \subset {1, \dots, E}$ が構成されます。この層の出力は $\sum_{k \in T(x)} g_{k}(x) f_{k}(x)$ となり、ここで $f_{k}(x)$ はトークン $x$ に対するエキスパート $k$ の出力を表します。
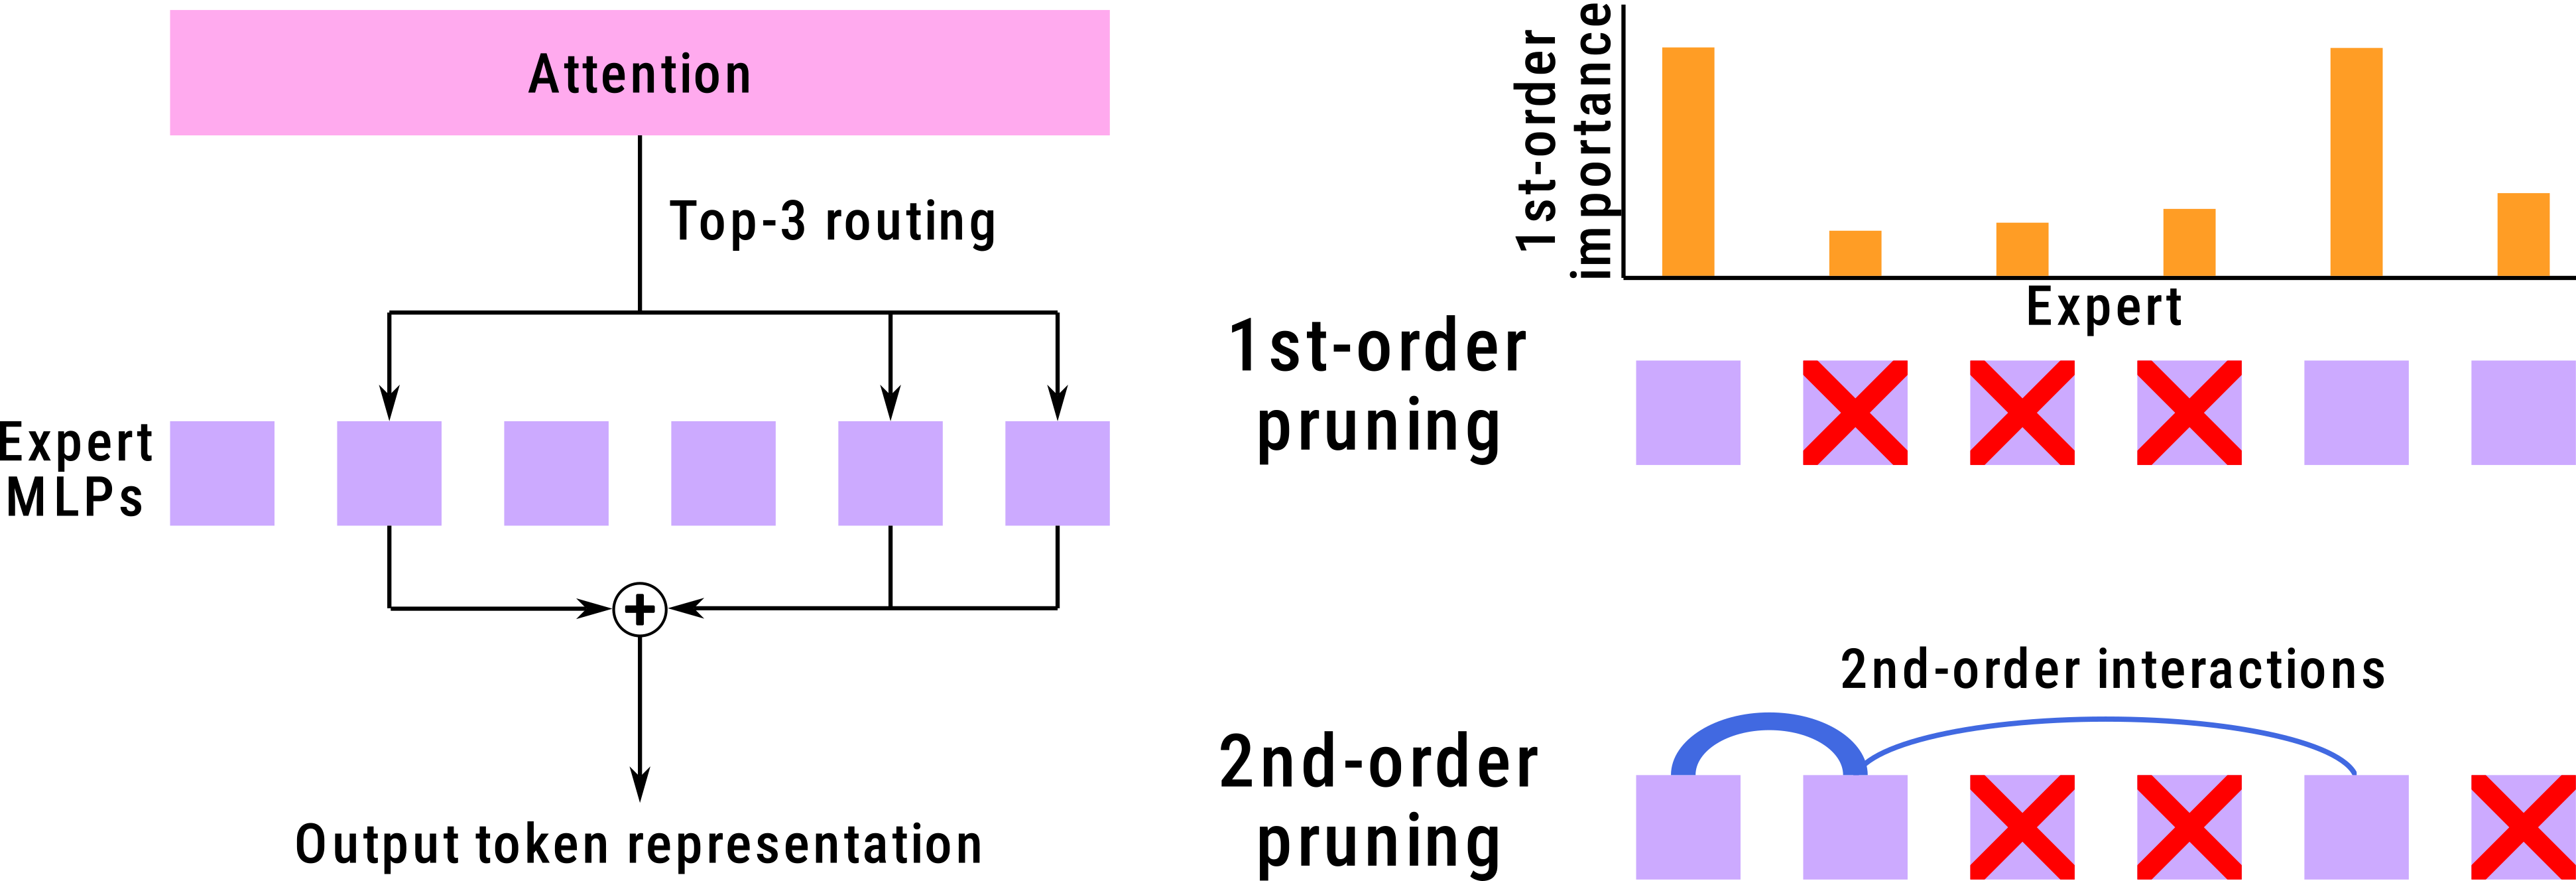
左図:各トークンが Top-K のエキスパートにルーティングされる典型的な MoE 層。右図:1次手法はスカラー重要度スコアに基づいてエキスパートをランク付けして削除するが、最適なプルーニング判断にはエキスパート間の相互作用の強さも考慮される。
重要なのは、選択された集合 $T(x)$ 内のエキスパートは互いに独立していないという点です。エキスパートは安定した協調グループを形成し、常に一緒に共アクティベーションされます。これは先行研究でも観察されているとおり……