
RSIは「無限の速さ」にはなり得ない
RSI(再帰的自己改善)という概念が現在大きな注目を集めていますが、果たしてAIの進化スピードは本当に無限に加速し得るのでしょうか?
Jeff Dean氏の下した結論は「現実的ではない」というものです。
彼は直感的な例を挙げて説明しました。研究者が実験を開始し、深夜2時に終了したとしても、多くの場合は翌朝8時に出社するまで結果は確認されません。
自動化システムを導入すれば、こうした待ち時間を排除し、リアルタイムに次の実験タスクを決定できます。しかし、トレーニング、計算、データの保存、そして結果の評価といった中核となるステップには、依然として物理的な時間が必要です。
基盤モデルを構築し継続的に向上させるには、膨大なトレーニングと実験が不可欠であり、これらのプロセスが無限の速さで完了することは絶対にあり得ません。
先日、スタンフォード大学HAI(人間中心AI研究所)で行われたフェイフェイ・リー(李飛飛)氏との対談で、Jeff Dean氏はRSIが直面する物理的な限界について深く掘り下げるとともに、自身が共同設立した新会社が推進している中核事業を初めて明らかにしました。
講演全体を通して、Jeff Dean氏ならではの極めてシンプルなプレゼンスタイルが貫かれていました。
彼によると、新会社 Discovery Loop では現在、約20件の自己改善ループが稼働し続けており、人間とエージェントが協調して作業できるフレームワークを構築しているとのことです。
同社の目標は、ごく少数の専門家が大量のエージェントと連携して科学研究を進められるようにし、ドメインエキスパートの生産性を20〜50倍に引き上げることです。
この中核チームを迅速に立ち上げるため、会社設立から最初の3週間で、彼らはカフェなどを拠点に400回もの面接を集中的に実施しました。
こうした進化を支える技術ロードマップについて語る中で、Jeff Dean氏は過去に自身の見立てが外れた部分があったことも率直に認めました。
その1つが、コード生成とプログラミング能力です。
Geminiプロジェクトにおいて、プログラミングはもともと注力分野の1つに過ぎませんでした。しかし、コード能力がこれほど広範かつ深遠にモデルの汎用的な複雑問題解決能力を強化・再構築するとは、事前には十分に予測できていませんでした。
さらに、ニューラルネットワークはより特異で不規則なトポロジーへと進化していくと予想していましたが、その進化の流れも当時の彼の想定通りには進みませんでした。
また、AIによる数学的課題の解決について議論する中で、機械が形式的証明を生成できることの価値を高く評価しつつも、それ以上に機械が導き出した結論から、人間が再利用・応用可能な科学的手法を理解し抽出できるかどうかが極めて重要であると強調しました。
Jeff Deanによる基調講演:AIに実験を自律実行させ、専門家の生産性を20〜50倍に引き上げる
実験ループの全プロセスを自動化する
本日ここでお話しできることを大変嬉しく思います。今日は皆様に Discovery Loop をご紹介したいと思います。
私たちのミッションは、機械学習、科学、工学分野における極めて重要かつ困難な課題を自律的に解決できるAIシステムを構築することです。
私たちは、これが数多くの先駆的な科学的発見を加速させると確信しており、これこそが最も胸躍るビジョンだと考えています。
多くの科学分野を見渡すと、そこには共通した研究パラダイム、すなわち「科学と工学における汎用的なサイクル」が存在します。仮説の立案と実験の設計、実験の配備と実行、結果の観察、各指標の評価、そして次の方針の決定です。そして次のステップとは、大抵の場合、新たな反復実験を開始することに他なりません。
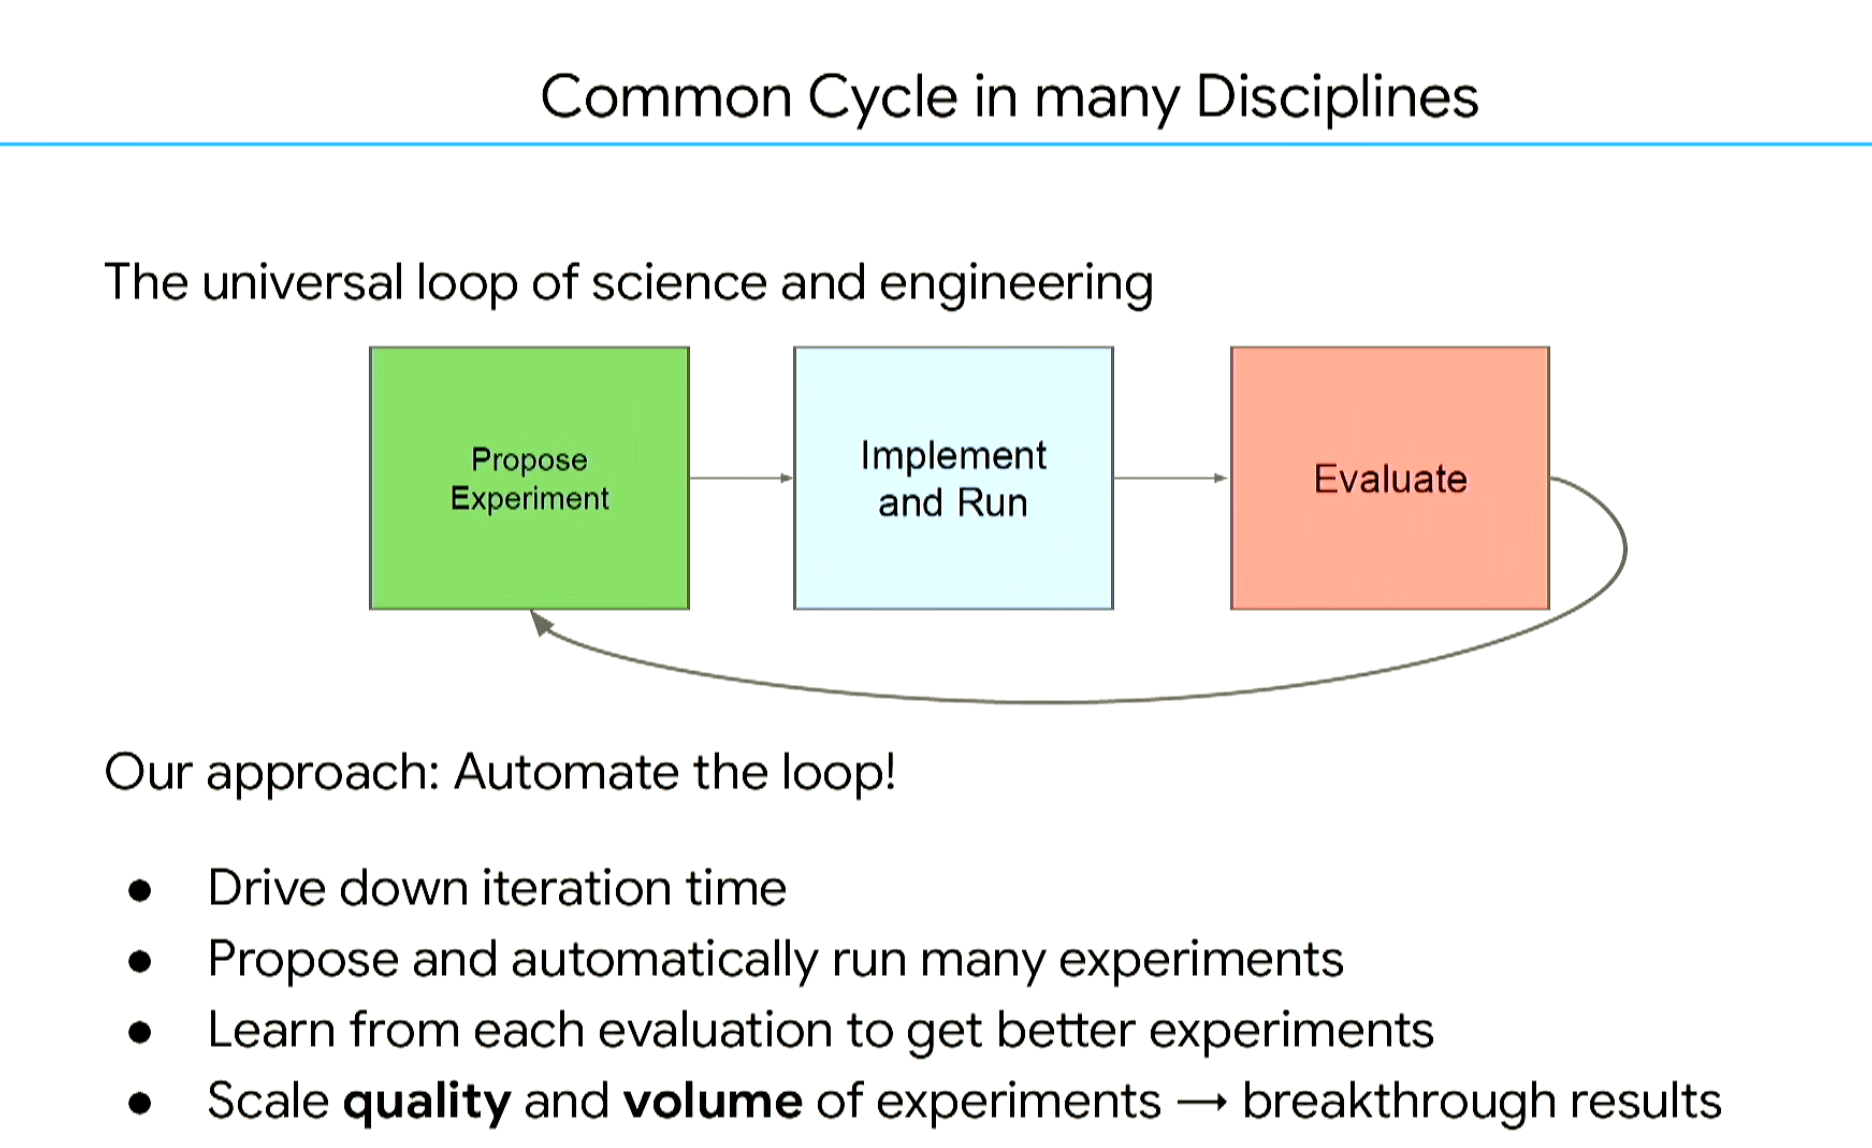
私たちの核となるアプローチは、この一連の実験クローズドループを完全に自動化することです。 1回あたりの反復サイクルを大幅に短縮し、数千から数万規模の実験を24時間体制で自律的に推進し、評価のフィードバックから強化学習を継続して後続の実験に事前知識を効率的に蓄積できれば、実験の幅と質は飛躍的に向上し、最終的にはブレークスルーをもたらすと確信しています。
これこそが、私たちが全力で推し進めている方向性です。
全米技術アカデミー(NAE)が提示した「グランドチャレンジ」に目を向けると、21世紀に解決すべき極めて重要な課題が並んでいます。そして今世紀も、すでに四分の一が過ぎようとしています。
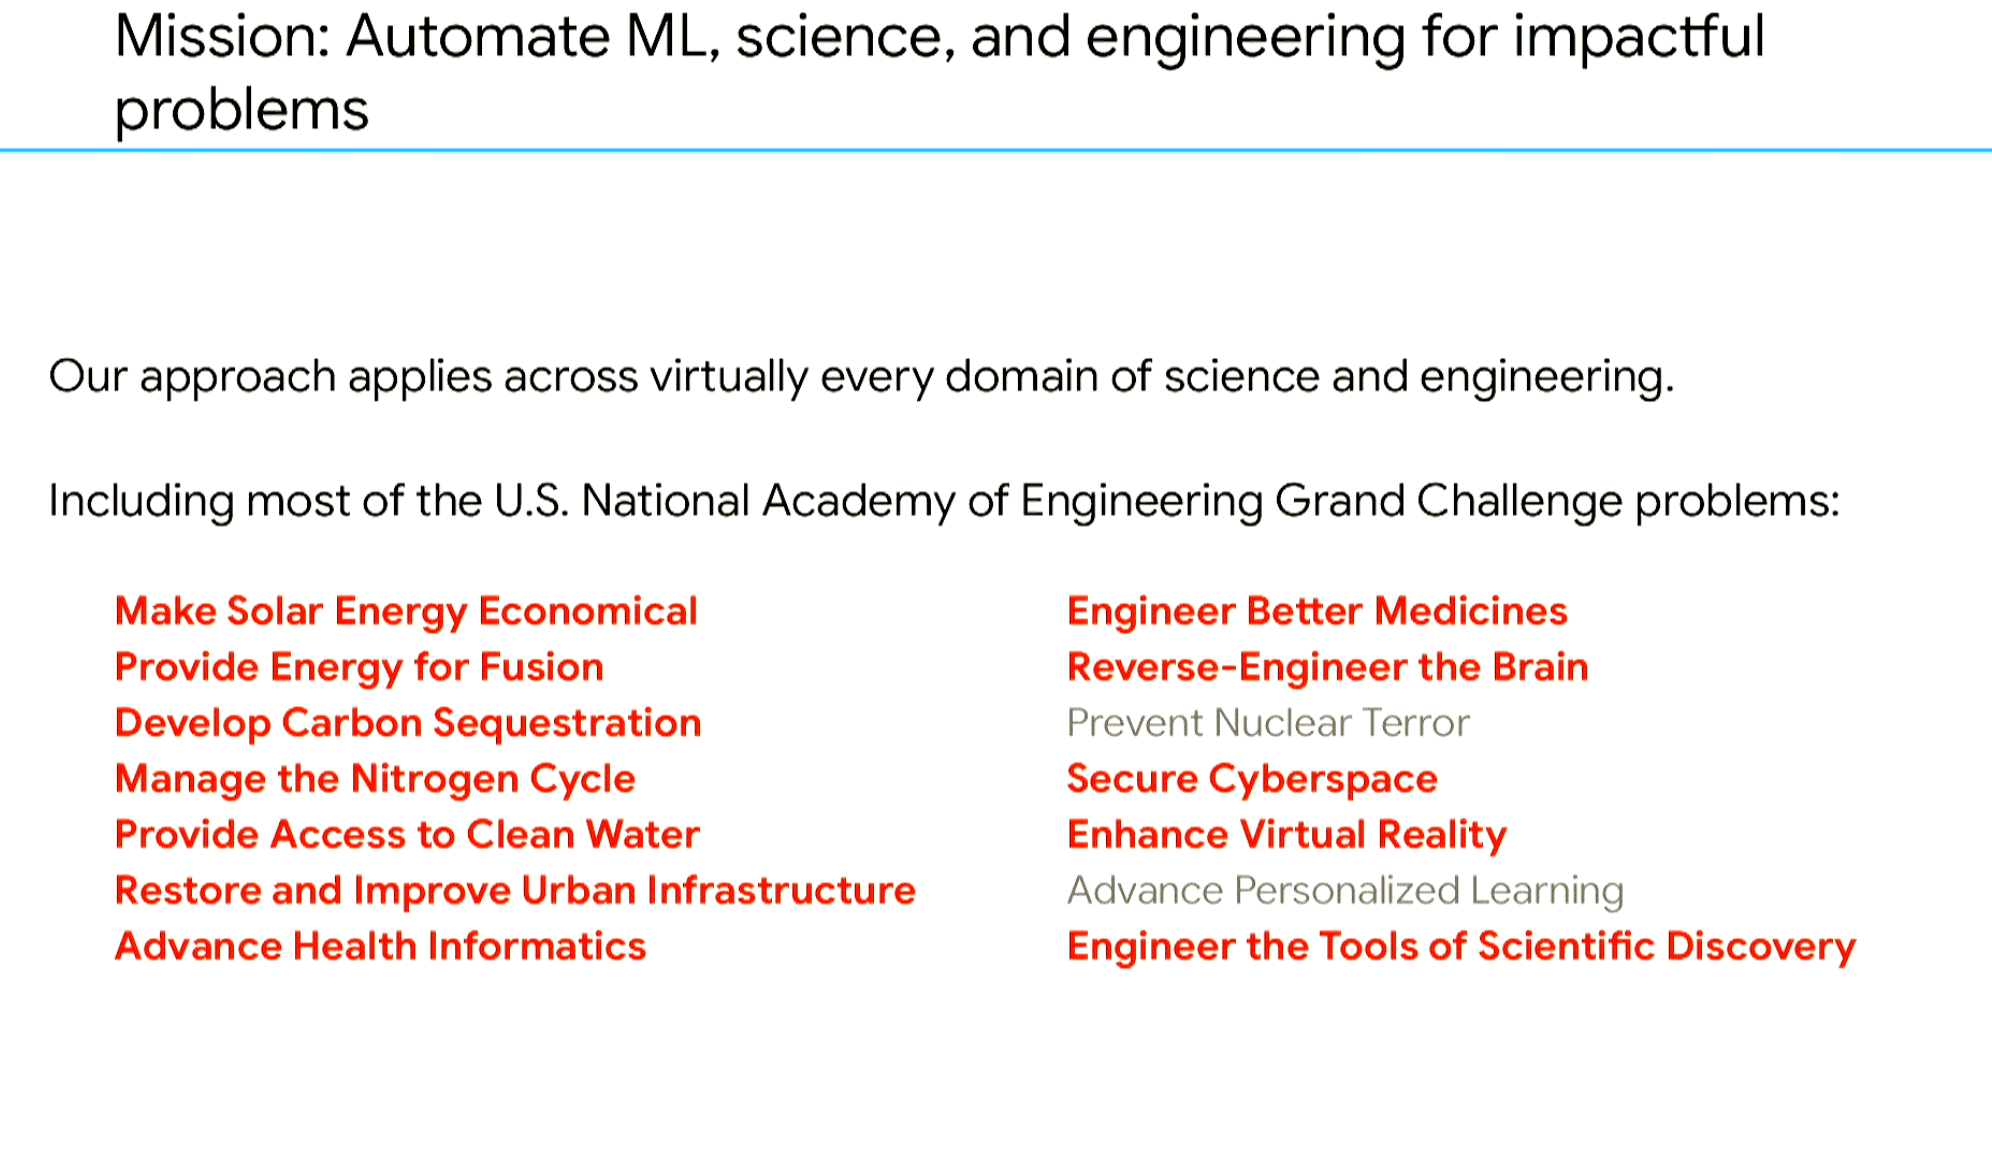
これら重要課題の解決に必要とされる主要な技術分野、特にスライド内で赤くハイライトされた領域を注意深く見ていくと、自動化された科学的発見ループが極めて変革的な役割を果たすと確信しています。
なぜパブリック・ベネフィット・コーポレーション(PBC)を選んだのか?
テクノロジーは適切に用いられれば、世界に計り知れない好影響をもたらします。しかし、その価値を確実に現実のものとするには、適切な組織形態を整え、多様な力を結集する必要があります。これこそが、私たちが独立した企業を立ち上げた大きな理由の1つです。
そのため、私たちは会社形態として**パブリック・ベネフィット・コーポレーション(Public Benefit Corporation: PBC)**を選択しました。
私たちの掲げる公のミッションは明快です。人類が直面する重大な社会課題に対処するコア技術を開発し、テクノロジーの恩恵を広く行き渡らせ、世界中の人々のウェルビーイングを実質的に向上させることです。
4人の共同創業者による技術の蓄積
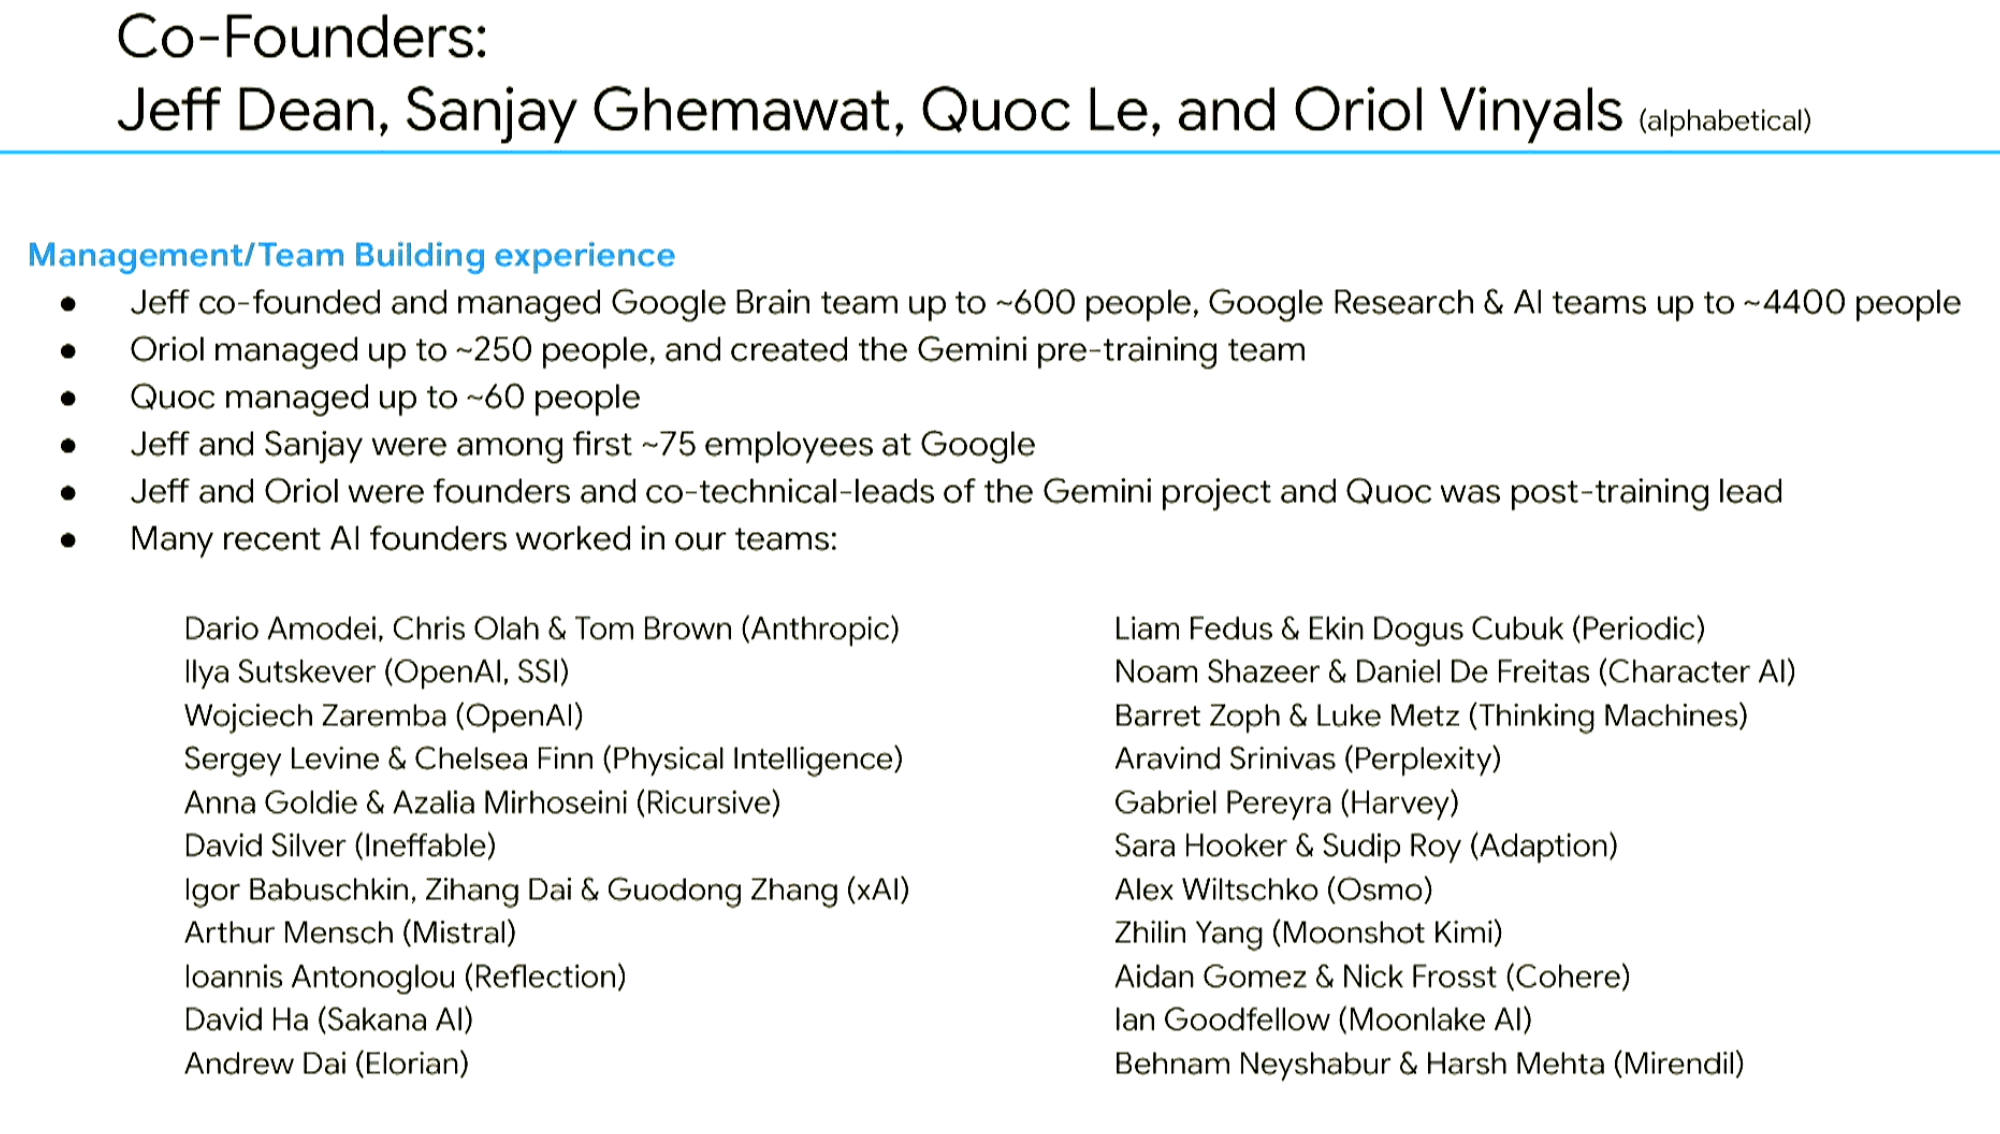
創業チームについて簡単にご紹介します。共同創業者は、Sanjay Ghemawat、Quoc Le、Oriol Vinyals、そして私の4人です。
2人ずつの共同研究・開発の歴史を振り返ると、互いに14年から30年近くにわたり肩を並べて仕事をしてきました。私たちは常に、最も難易度の高いエンジニアリングや研究課題に挑むことを愛し、各自の技術領域において高度な相互補完関係を築いています。
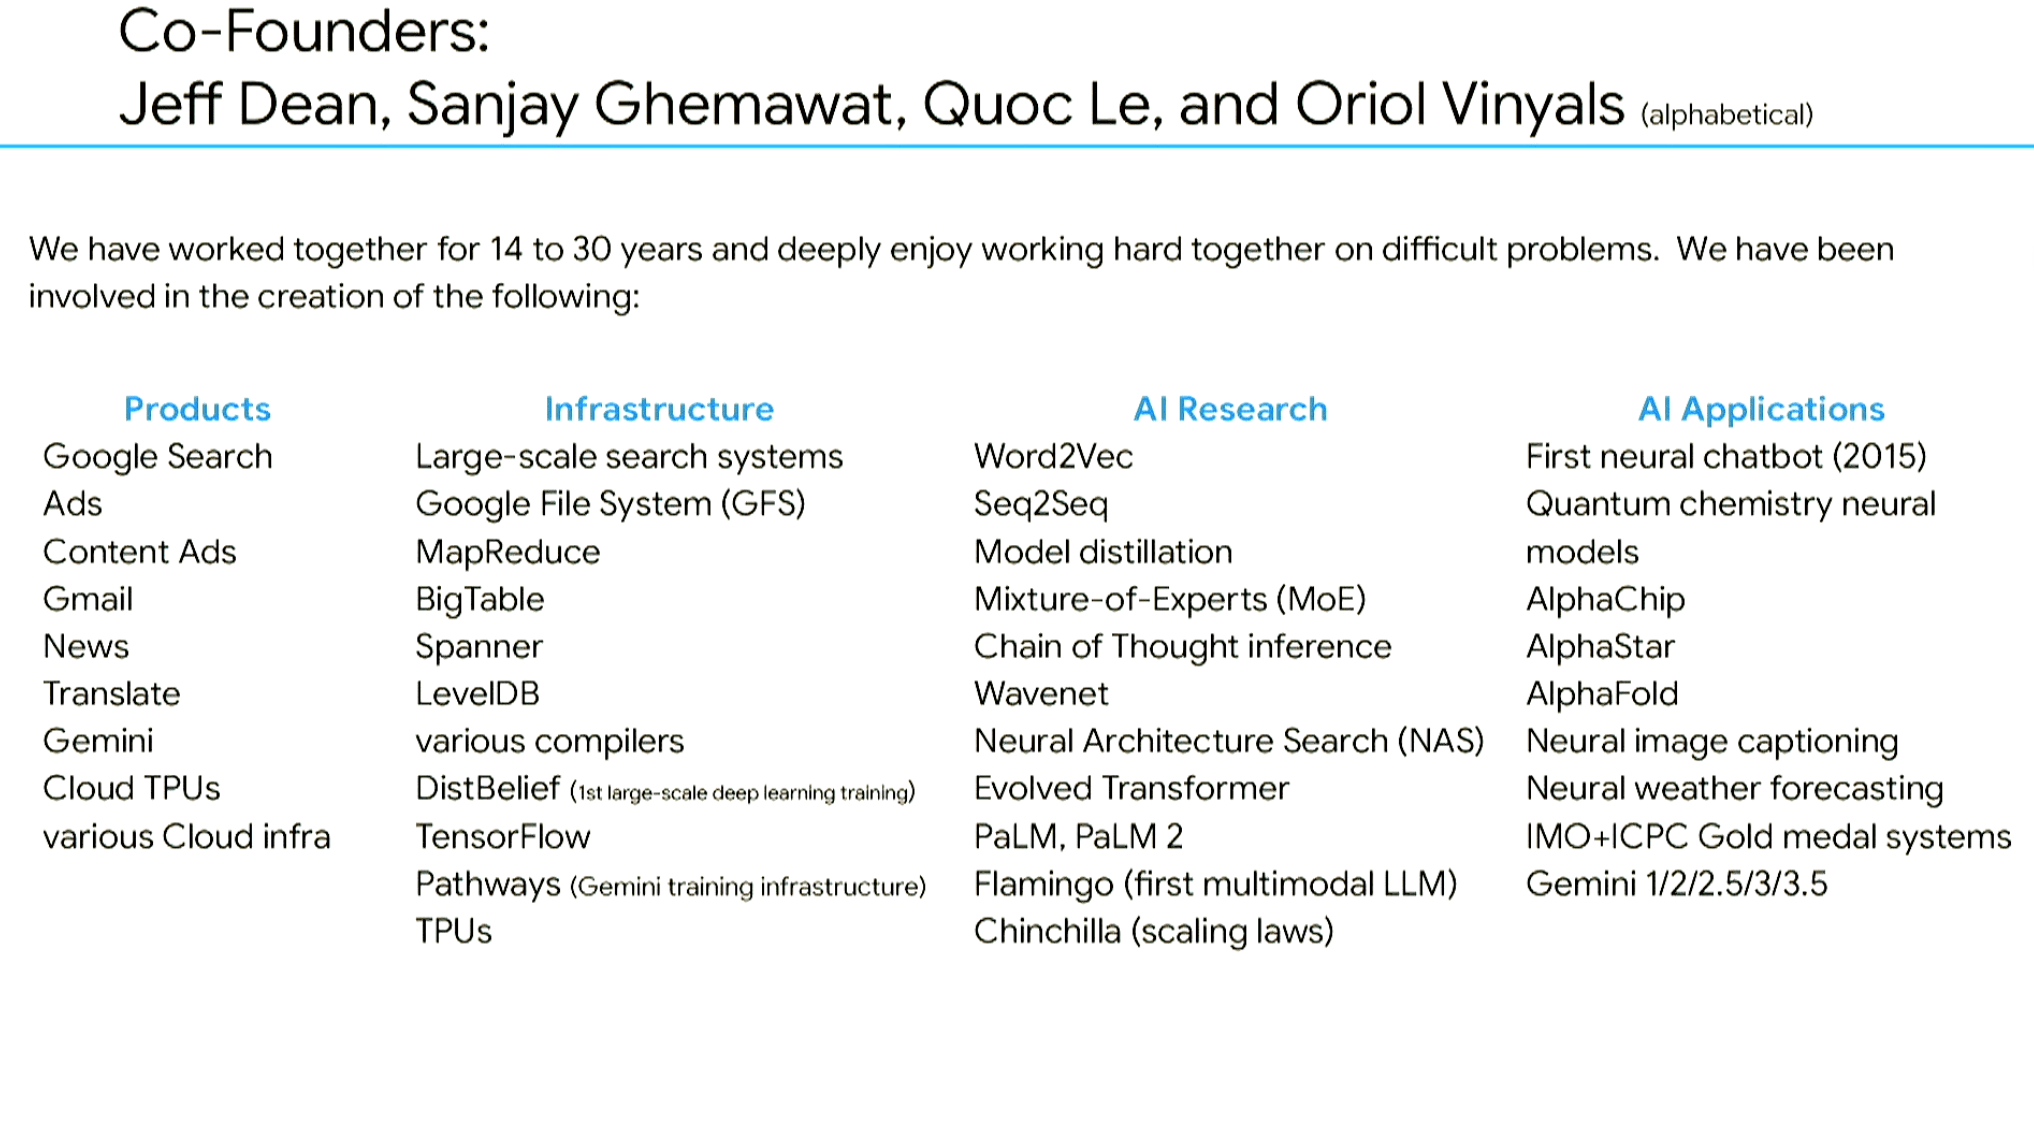
私たちは全員Google出身であり、スライドにまとめられている成果もこの期間に生まれたものです。私たちは複数世代にわたるGoogle検索アーキテクチャ、初期の商用広告システム、コンテンツマッチングエンジン、さらにはGmail、Google News、Google Translateなどのコアプロダクトの開発を主導、あるいは関与してきました。
スライドの2列目はシステムインフラストラクチャです。上半分はペタバイト規模のデータ整理・ストレージ、大規模分散コンピューティングを支える中核システムを示しており、下半分の4つは進化し続ける最先端モデルのトレーニングを支えるために設計された歴代の超大規模機械学習インフラです。さらに、AIの計算力に特化したTPUハードウェアの開発にも深く携わってきました。
AIアルゴリズム研究の面でも、現在多くのフロンティアモデルの基盤となっている主要技術に深く関わってきました。これには知識蒸留(Knowledge Distillation)、混合エキスパート(Mixture of Experts: MoE)、そしてニューラルアーキテクチャ探索(NAS)などが含まれます。
ニューラルアーキテクチャ探索は、実質的に自動実験ループの初期の雛形とみなすことができます。アルゴリズムを通じて、特定のタスクに最適なニューラルネットワークのトポロジーを自動探索するというものです。
また、私たちは異分野へのAIの応用、とりわけ基礎科学研究への展開も長年推進してきました。例えば、私とQuocが関わったAlphaChipでは、強化学習を用いてマイクロチップのマクロセル配置・配線を行いました。OriolはAlphaFoldやニューラルネットワークに基づく気象予測システムの開発に参画しています。
大規模な組織マネジメントの面でも、私は多くの経験を重ねてきました。最大600人規模のGoogle Brainチームを率い、その後Google ResearchとAIチームを統括し、全体の規模は約4,400人に達しました。
ところがある日、自分がQ2の運用予算会議といった管理業務に過度なエネルギーを費やしていることに気づきました。そこで組織改編のメールを一本送り、直属の部下(Direct Reports)の人数を4,400人の体制から一気にわずか4人にまで絞り込みました。
その1週間後、Geoff Hinton氏が退任を発表したため、直属の部下は3人になりました。
その後、私とOriolはGeminiプロジェクトの共同テクニカルリードを務め、Quocは事後学習(Post-Training)領域を統括しました。
さらに誇らしいのは、かつて私たちと同じ現場で共に戦った仲間たちが、のちにAnthropic、OpenAI、Physical Intelligenceといった業界トップ企業の創業者となり、目覚ましい成果を挙げていることです。
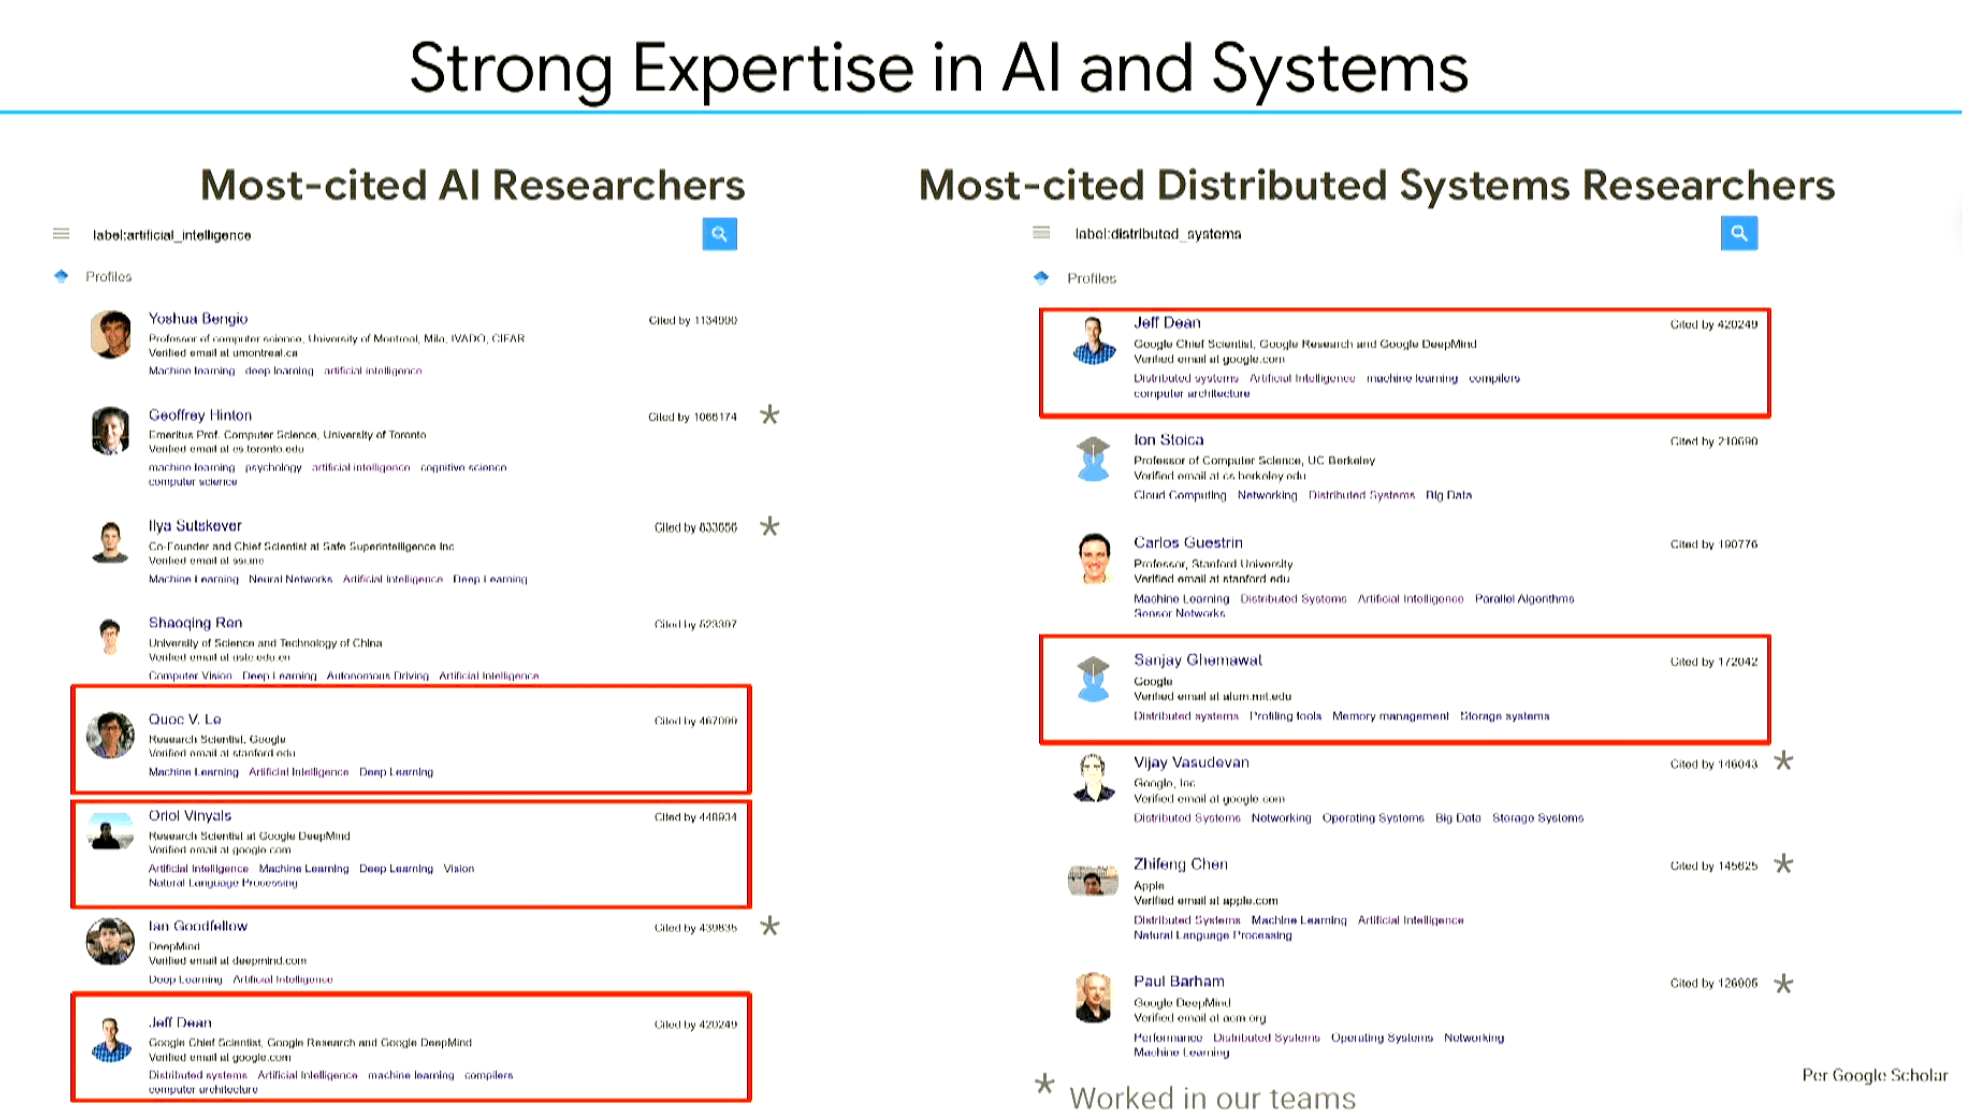
私たちの技術的基盤は、最先端のAIアルゴリズム研究と大規模分散システムアーキテクチャが深く融合したものです。
Google Scholarの被引用数に基づいて作成されたこの図は、AIおよび分散コンピューティング分野のトップ研究者を示しています。赤枠で囲まれているのが私たち4人であり、星印がついている研究者たちも全員、かつて同じチームで働いていた仲間です。
チームビルディングと初期の採用活動
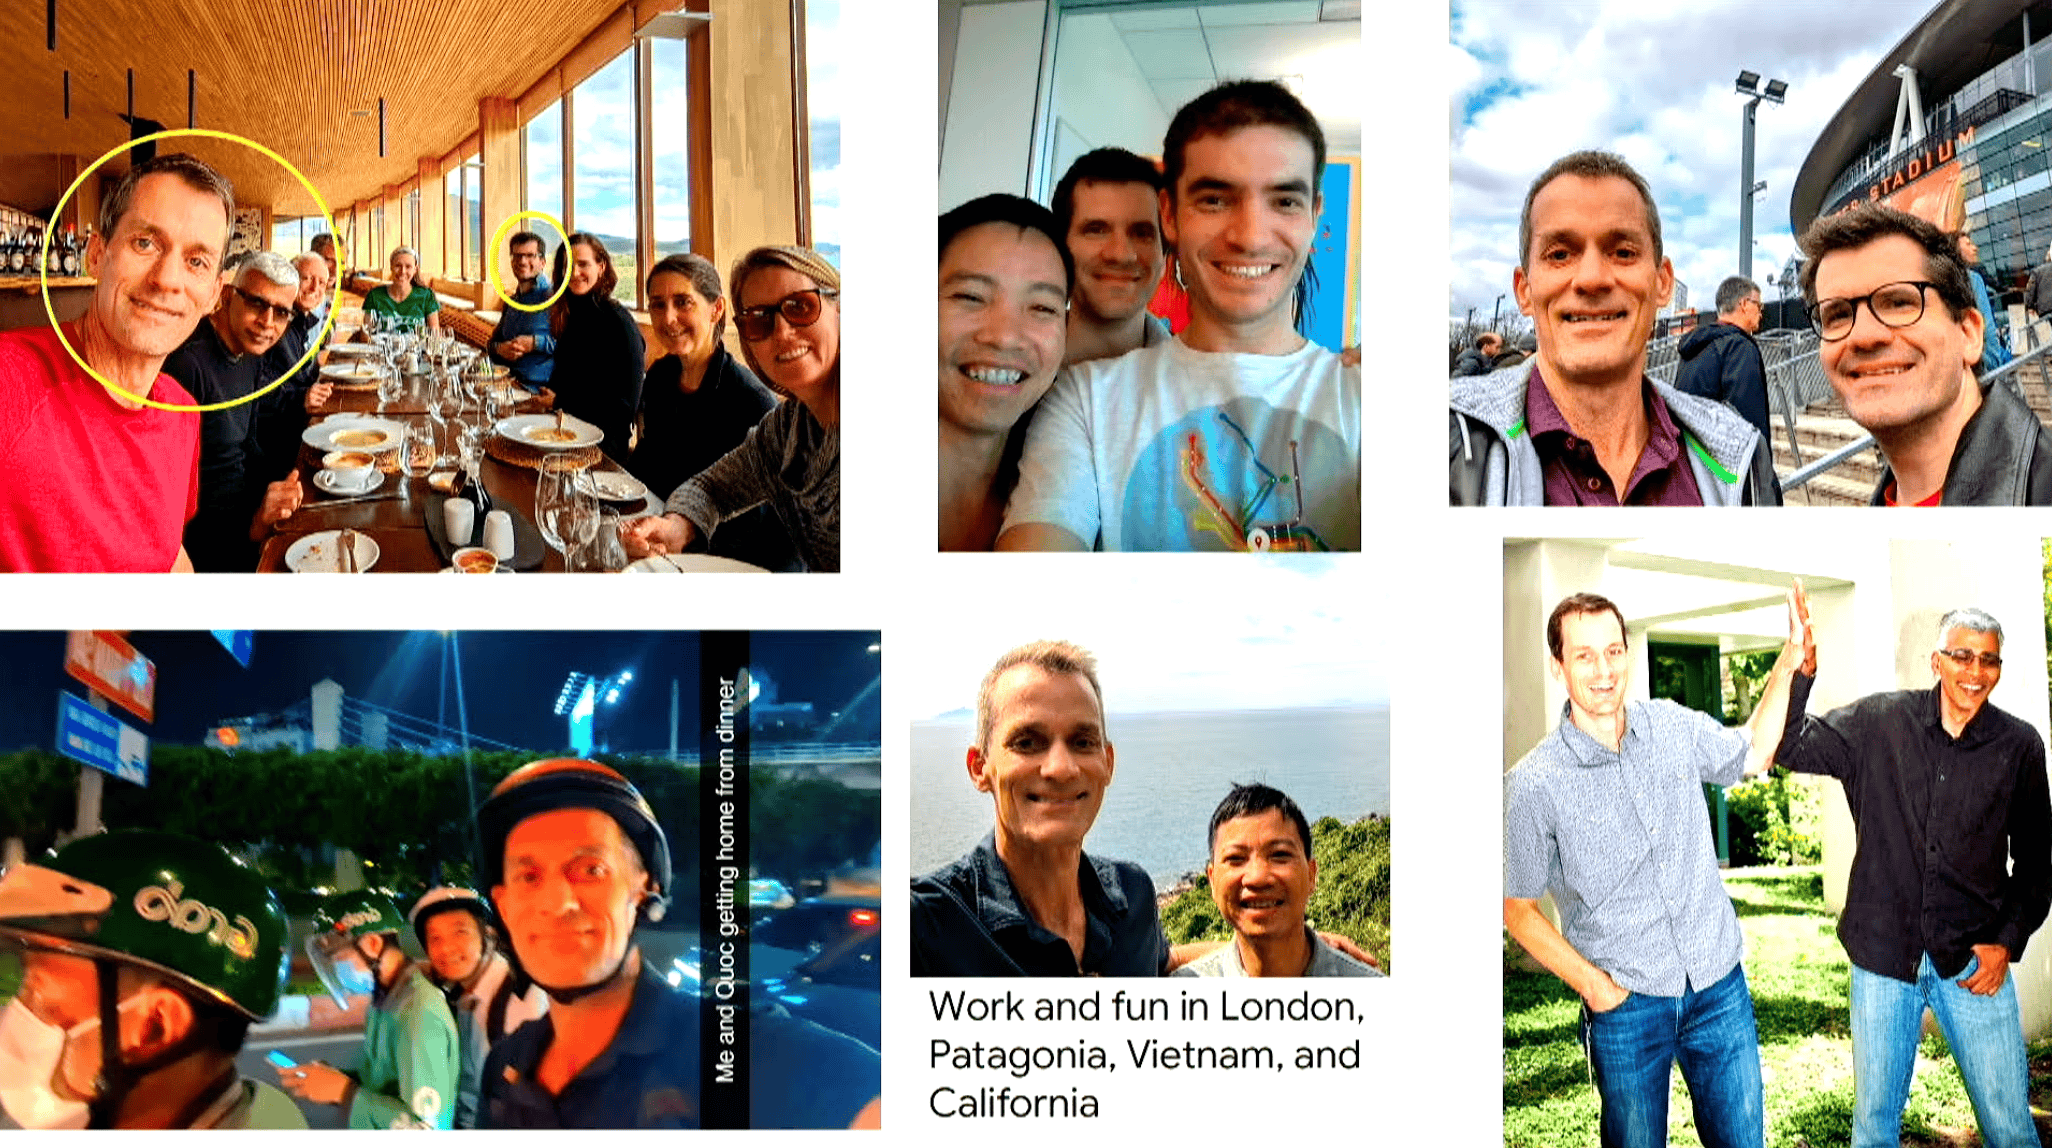
仕事以外でも私たちは非常に気の合う友人同士であり、ロンドン、パタゴニア、ベトナム、カリフォルニアなどを旅してきました。
ある時、私とQuocはベトナムで夕食を終えた後、現地のUberのようなバイクタクシーを相乗りして宿に戻ったことがあります。
会社設立当初のフェーズでは、コアチームの採用に全力を注ぎました。メンバーのバックグラウンドは極めて多彩で、起業の成功経験を持つ者や、代表的なオープンソース/商用プロジェクトを主導してきた豊富な実績を持つ者が多数集まっています。
Go言語のコア責任者クラスのエンジニアリングエキスパートだけでなく、Gemini、DeepSeek、Kimi K3といった主要モデルのコアコントリビューターも名を連ねています。例えば、Kimi K3論文の共著者でありAttention Residuals研究の著者でもある研究者が、最近正式にチームに加わりました。
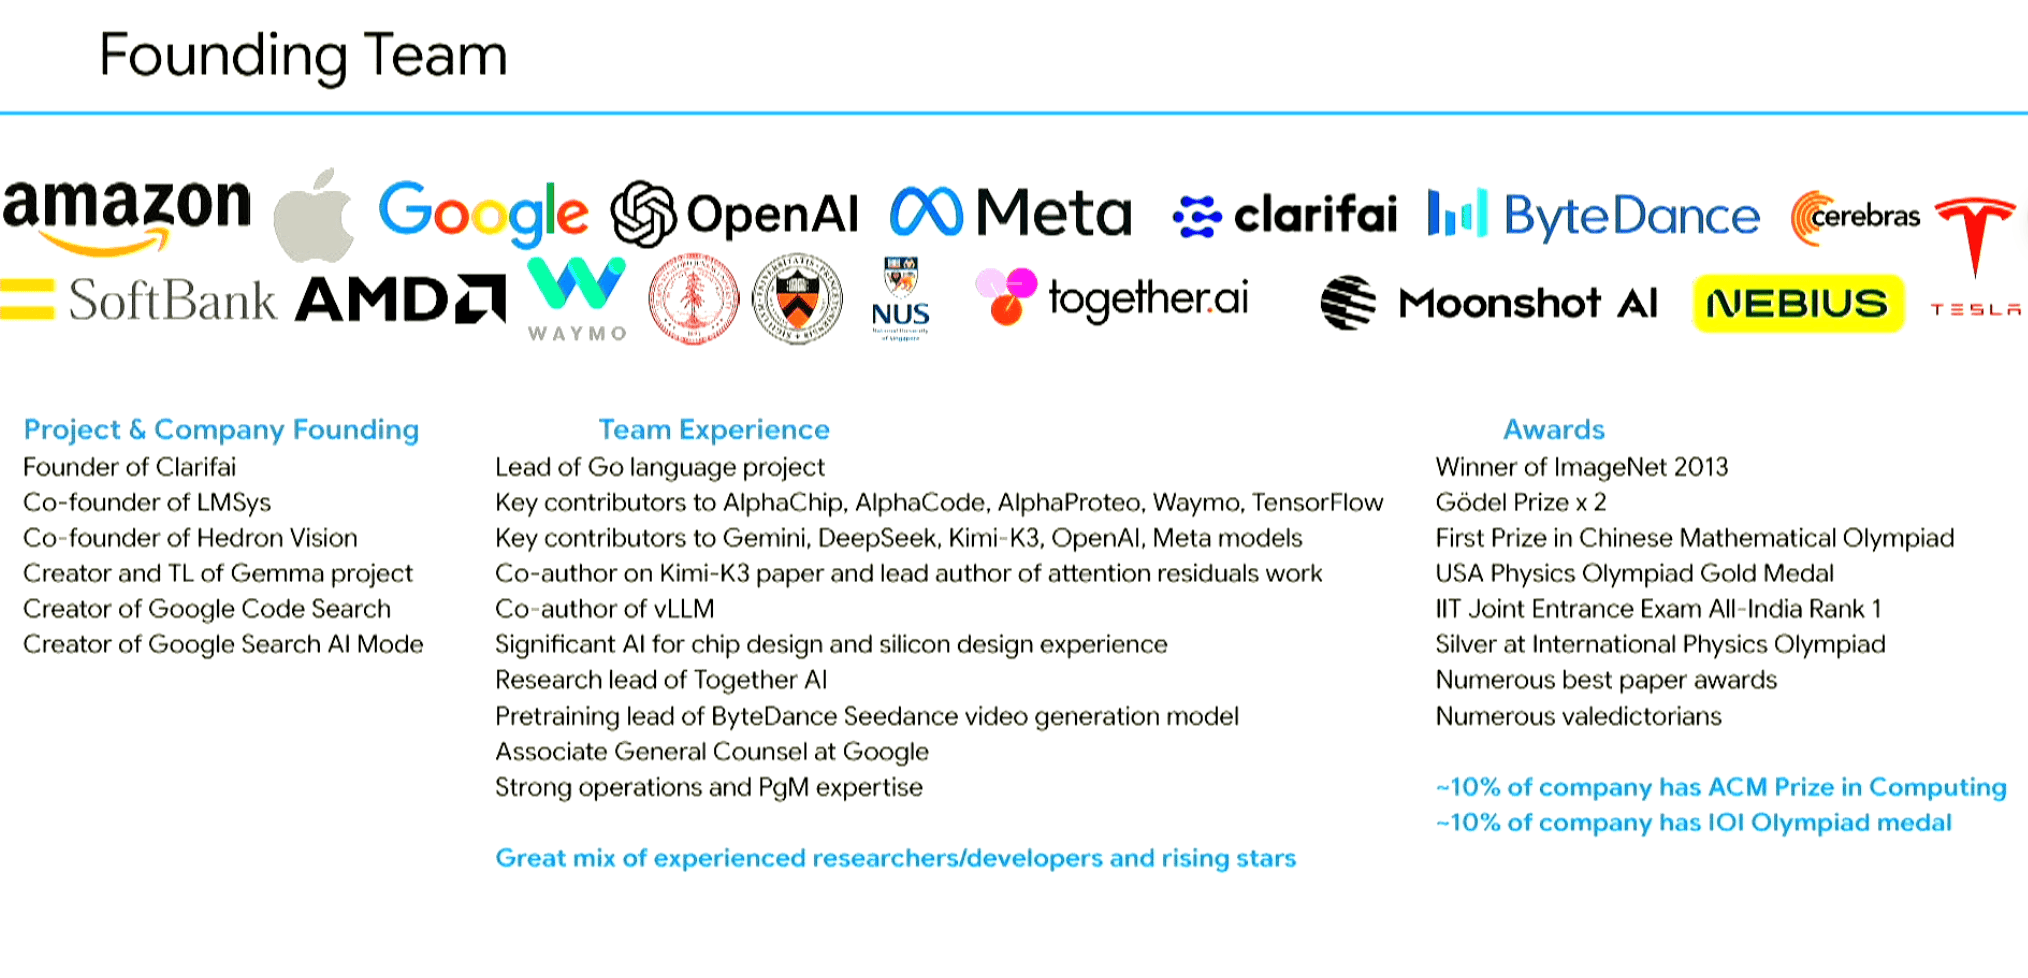
私たちの研究開発チームは、経験豊富なトップエキスパートと次世代を担うリーダーたちが見事に融合した布陣となっています。現在、社員の約10%がACM計算機関連の賞を受賞しており、約10%がIOI(国際情報オリンピック)のメダリストです。
極めて密度の高い人材構成そのものも刺激的ですが、チーム間で発揮される効率的なシナジーこそが、私たちが何よりも大切にしている強みです。
なぜ今これを推進するのか?
その答えは、最先端の基盤モデルの中核能力が、質的変化のクリティカルポイント(臨界点)を越えたからです。これは、過去10〜15年間にわたるAIのフルスタックでの技術蓄積によるものです。
第1に、TPU、GPU、各種専用カスタムアクセラレータを含むハードウェア面の突破口です。第2に、ソフトウェア抽象化レイヤーの大幅な進化により、開発者はかつてない手軽さで先端的なアイデアを実装し、計算グラフを基盤ハードウェアアーキテクチャに高精度にマッピングできるようになりました。
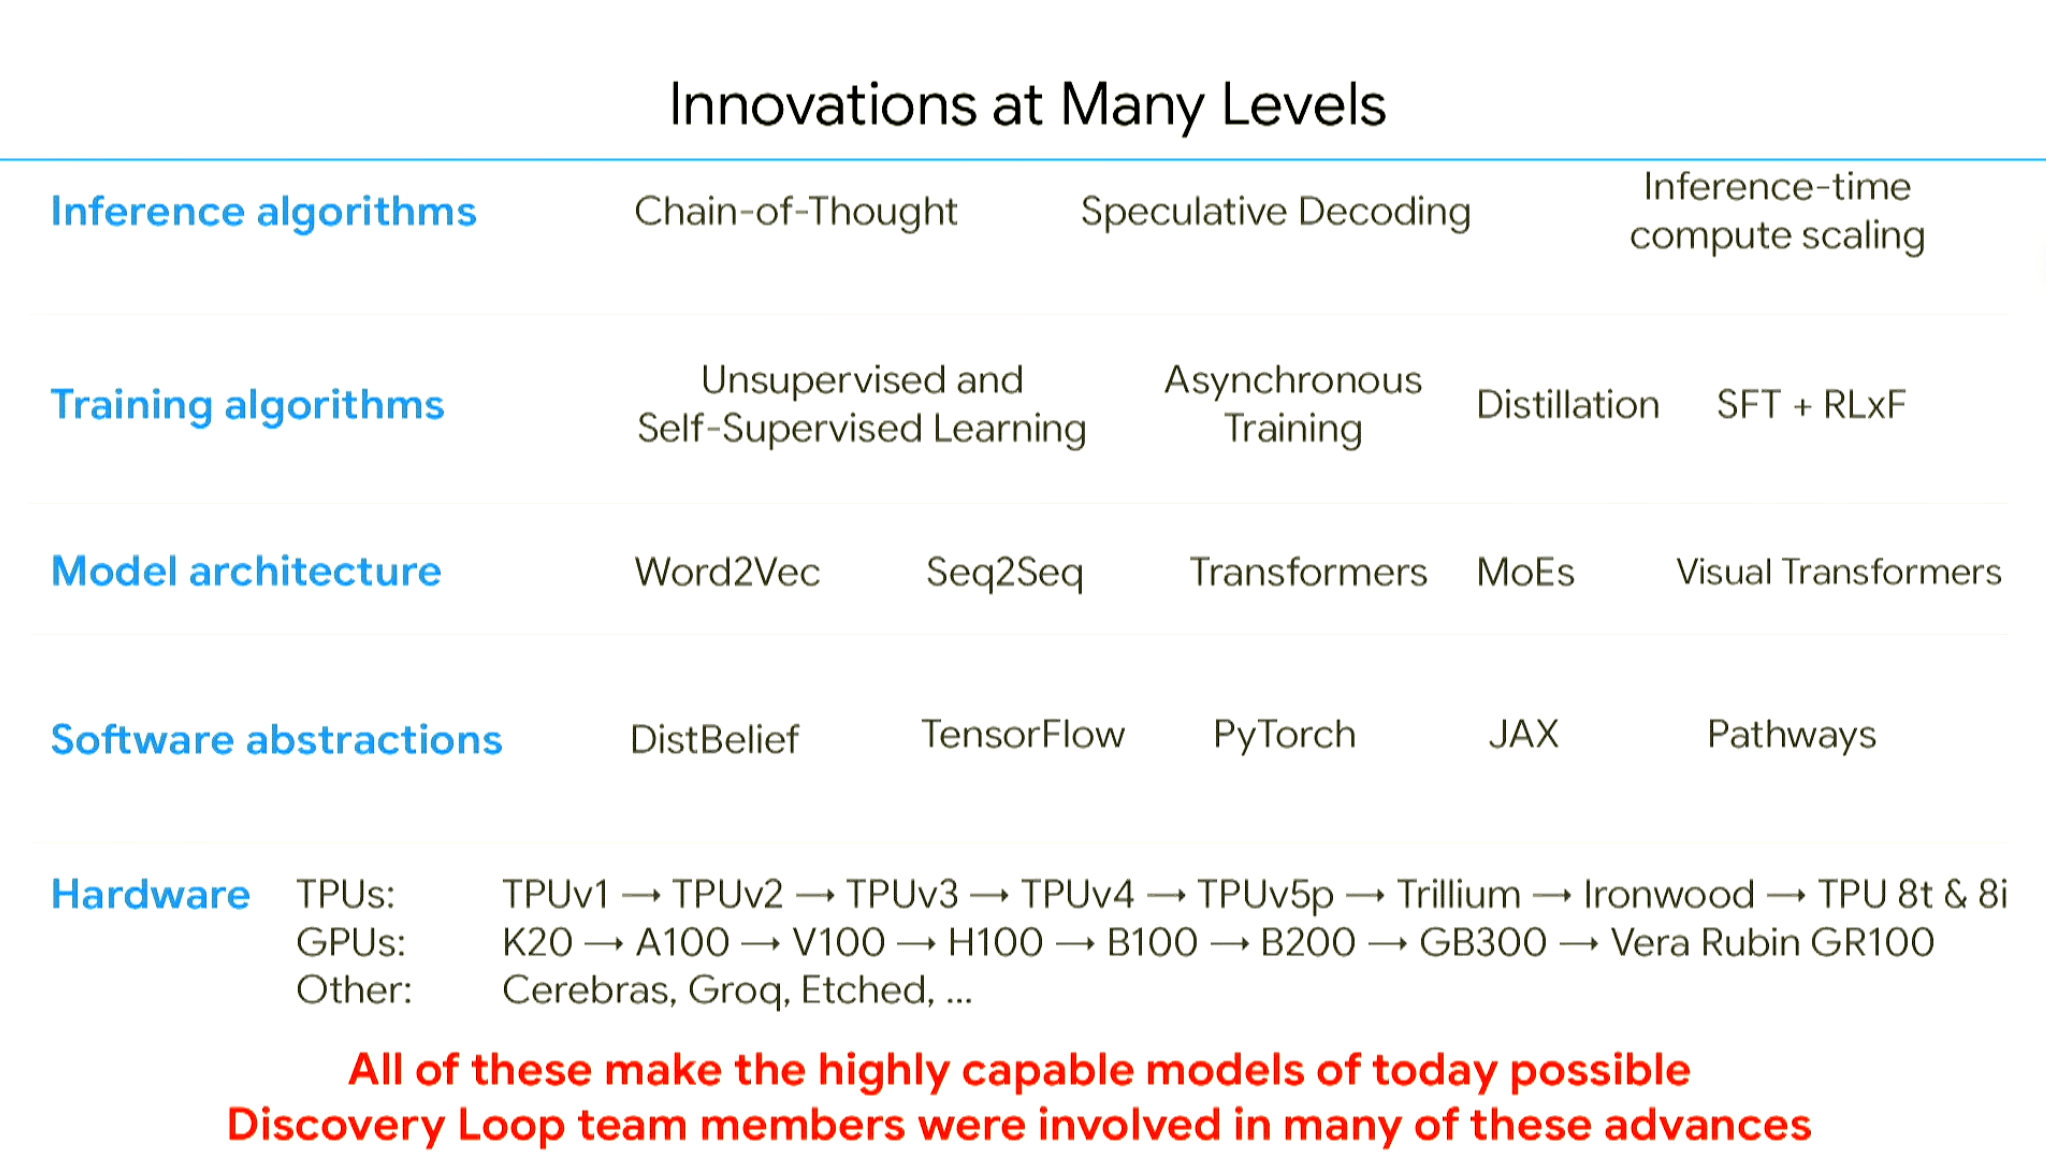
モデルアーキテクチャの面では、初期のword2vecやSeq2Seqから、TransformerやMoEアーキテクチャへの絶え間ない反復進化が見られました。トレーニングおよび蒸留技術の大幅な向上により、コンパクトなモデルであっても驚くべき汎化性能を発揮できるようになりました。
さらに、推論パラダイムも重要な飛躍を遂げました。推論時計算(Inference-time Compute)へのリソース投入、思考の連鎖(Chain of Thought: CoT)推論、マルチパス探索と検証などの戦略を通じて、モデルの推論品質は桁違いの向上を達成しました。
モデルに求められるツール利用、創造性、そして経験の蓄積
しかし、単独の基盤モデルだけでは、真に困難な科学的課題を解決するには到底不十分です。私たちは最高水準の基盤モデルを土台とし、エージェントアーキテクチャと深く組み合わせることで、システムがツール群を自在に呼び出し、複雑なマルチステップのエンジニアリングタスクを実行できるようにしなければなりません。
さらに重要なのは、エージェントシステムが真の科学的「創造性」を発揮することです。科学と工学における質的飛躍の本質は、モデルが異質な領域の洞察をマルチモーダルに統合し、独創性と実行可能性を兼ね備えた全く新しい提案を行い、自律的に実験検証を進められる能力を求める点にあります。
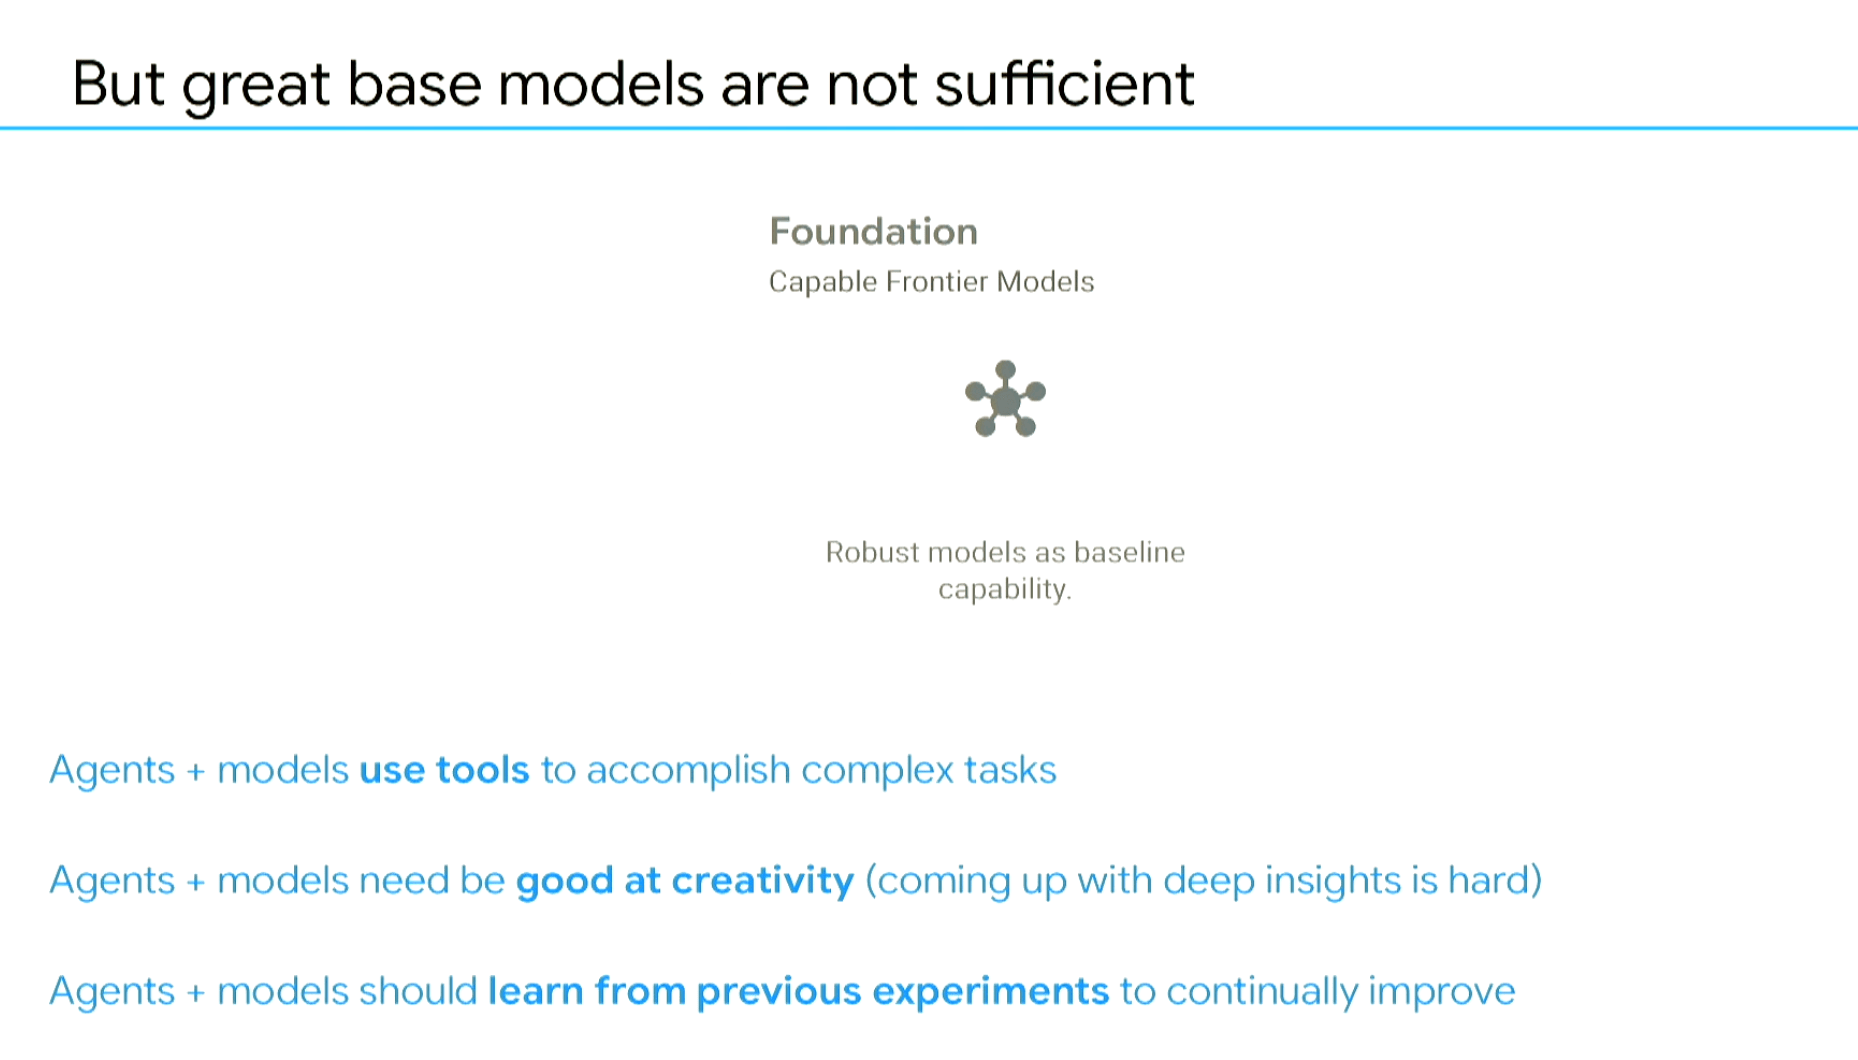
同時に、システムは数多くの実験サイクルを通じて長期記憶と経験の蓄積を形成できる能力を持たなければなりません。
例えば、あるエージェントシステムがすでに5,000件の複雑な工学課題を解決してきたとすれば、5,001件目の未知のタスクに直面した際、過去の最も関連性の高い解法経験や試行錯誤の教訓を迅速に転用・適応できるべきなのです。
大規模プロジェクトのボトルネックは分業と協調のオーバーヘッド
従来の科学研究・開発サイクルは、人間の手作業に大きく依存しています。
課題の規模が極めて巨大化すると、エンジニアリングの複雑さは指数関数的に増大します。まず全体をいくつかのサブ課題や独立したモジュールに分割しなければならず、「いかに科学的かつ合理的に分割するか」自体が極めて難度の高いメタ問題だからです。
各専門領域には多くの研究者が集まり、局所的な手法の有効性を個別に検証します。
その結果、組織内の調整コストやリソース競合、クロスシステム統合時のオーバーヘッドが膨大に発生します。問題をエレガントに分割することは極めて困難であり、各サブ問題の断片的な成果を再びシームレスに統合し直すこともまた、世界クラスの難問です。
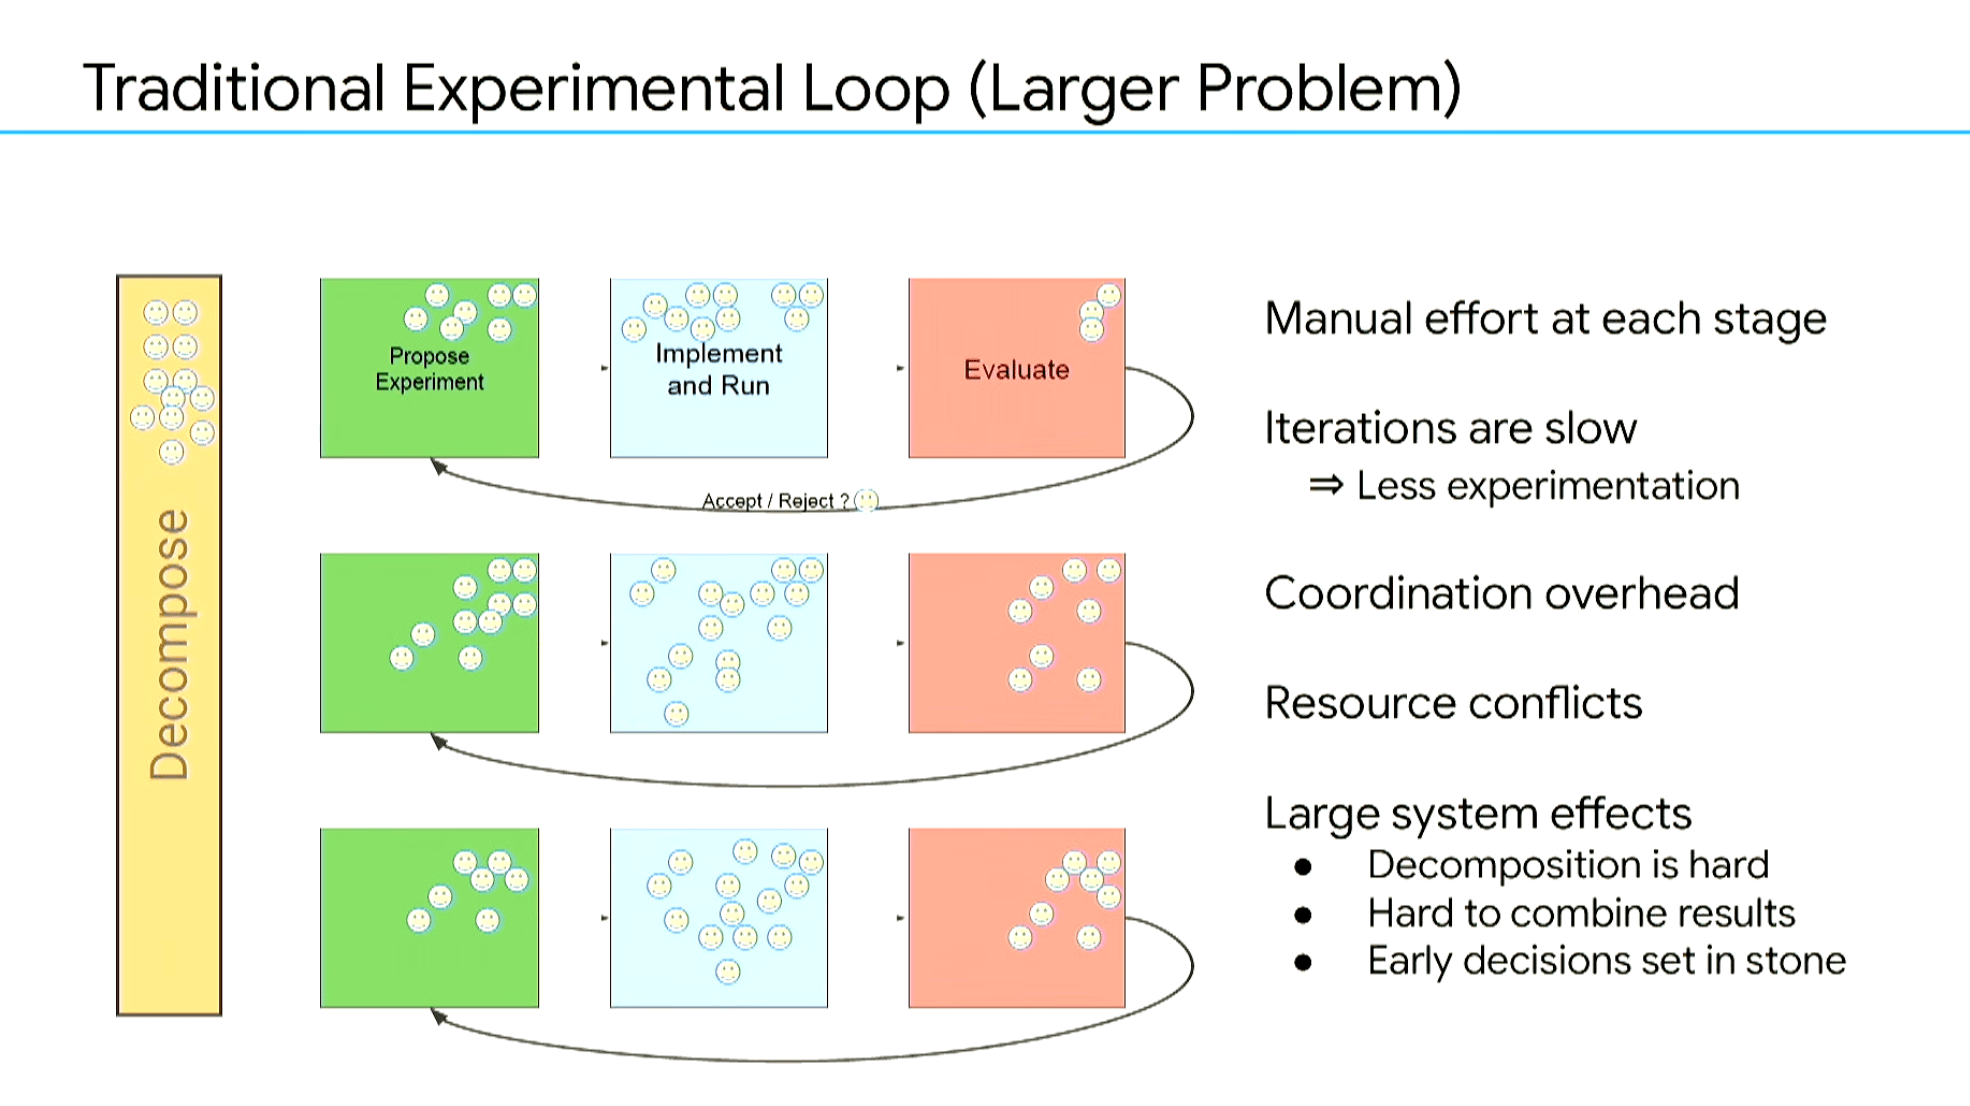
さらに深刻なのは、大規模な開発プロジェクトが本格始動すると、初期のアーキテクチャ分割ロジックが強固に固定化されてしまうことです。ハードウェア全体の開発であれ、先駆的な基盤モデルの開発であれ、途中で初期の構造的決定を柔軟に修正することは極めて困難です。
私たちのアプローチは、自動化システムを基盤とし、ごく少数のトップドメインエキスパートが研究開発の全体像を指揮できるようにすることです。理想的な状態では、インテリジェントシステムが最も科学的価値の高いサブ課題を自律的に探索し、エンドツーエンドで計算リソースをスケジューリングして課題解決まで完結させるべきです。
もちろん進化の過程においては、ハイレベルなガイダンスを提供し、優先順位を判断するためにシニアエキスパートの存在が依然として必要となります。
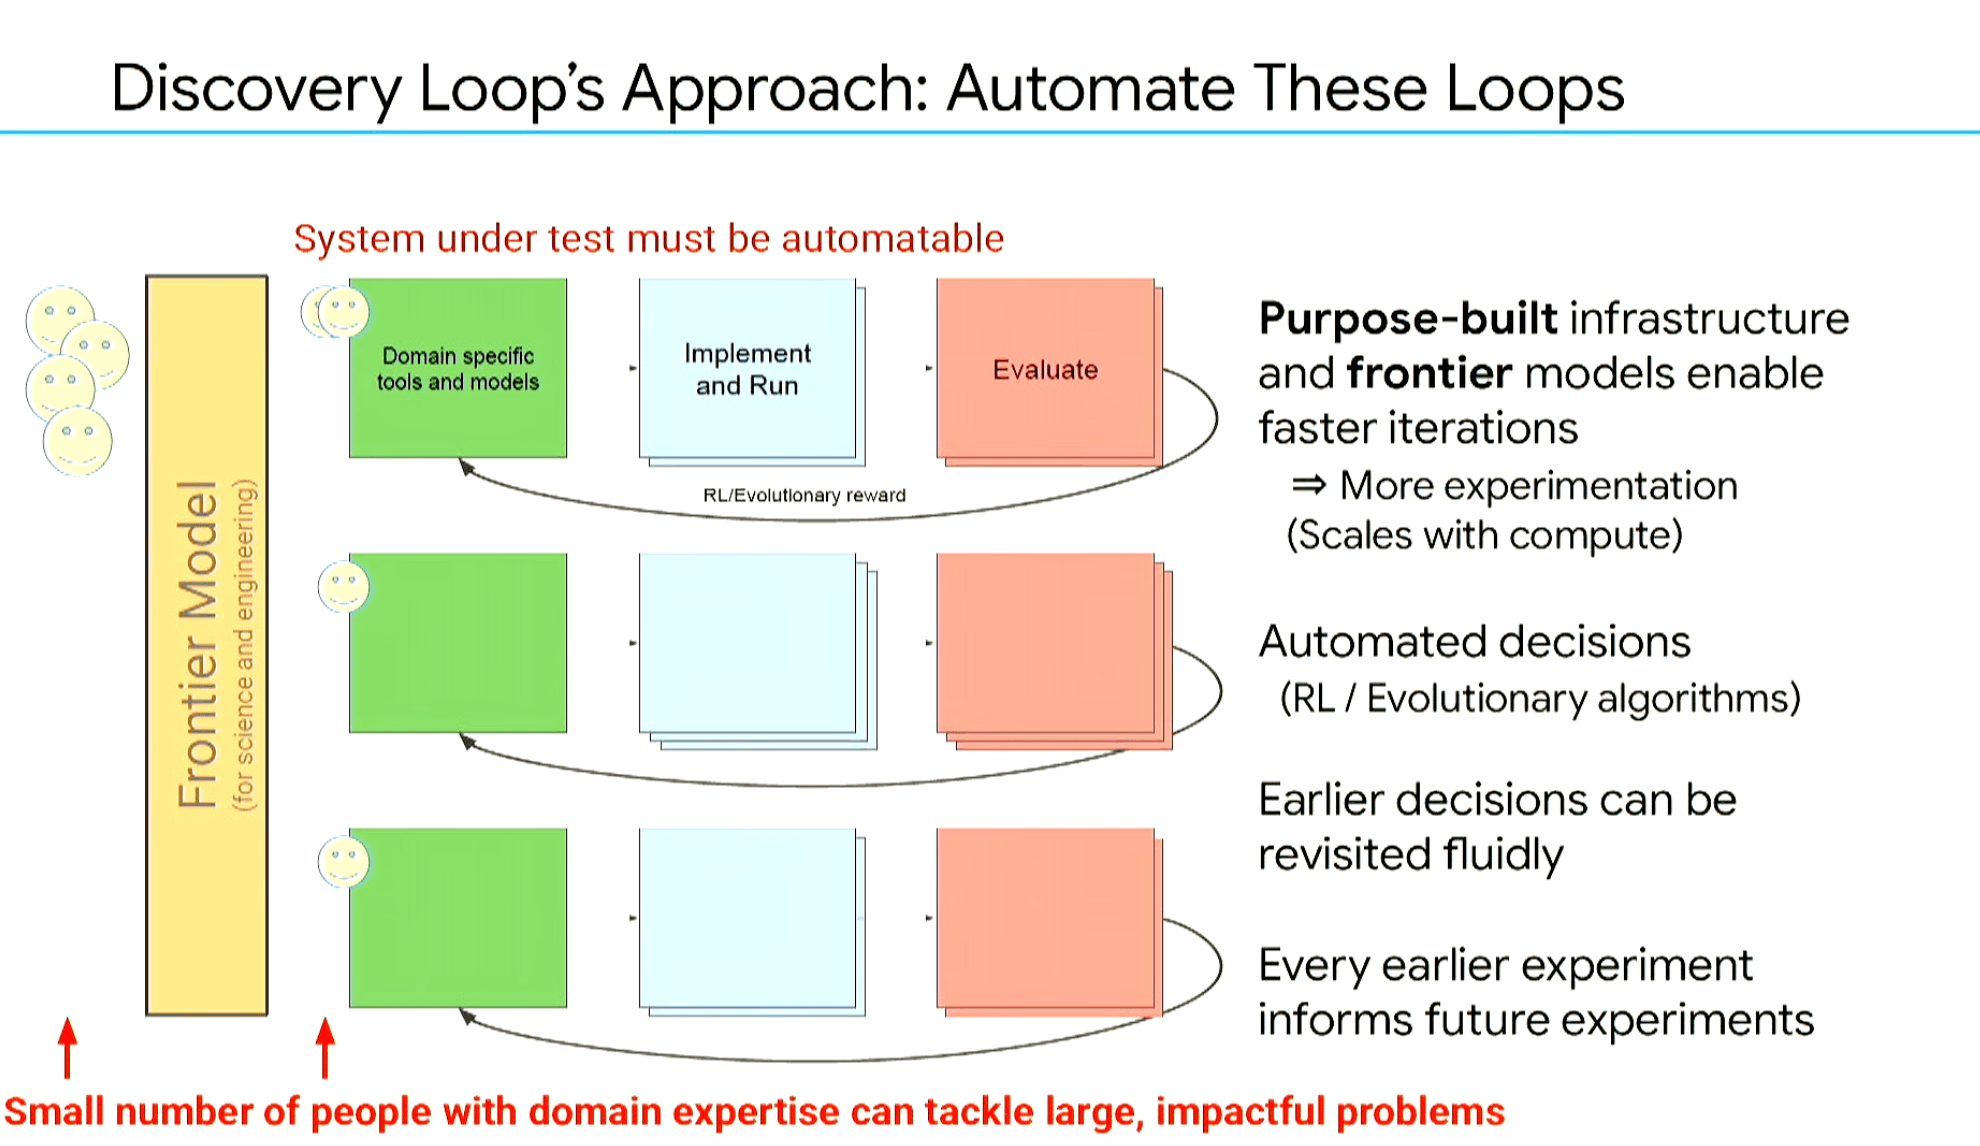
これにより、極めて少数のコアエキスパート集団が、影響力の大きい重大な戦略的タスクを掌握できるようになります。私たちは、カスタム設計されたインフラストラクチャこそが、この協調パラダイムの要であると確信しています。
基盤層は数万件に及ぶ自動実験フローの同時並行稼働を支えるだけでなく、各実験ノードの限界効用を的確に評価し、次に打つべき最適なアクションを動的に収束させる必要があります。
強化学習と進化戦略は、このプロセスにおいて中核的な役割を果たします。初期の意思決定パスを動的に再評価し、柔軟にバックトラックできるようにすることで、初期段階のすべての探索を後続実験のための確実な事前知識へと変換していきます。
すでに約20件の自己進化ループが24時間稼働中
Discovery Loopは現在、どのような進捗を遂げているのでしょうか?
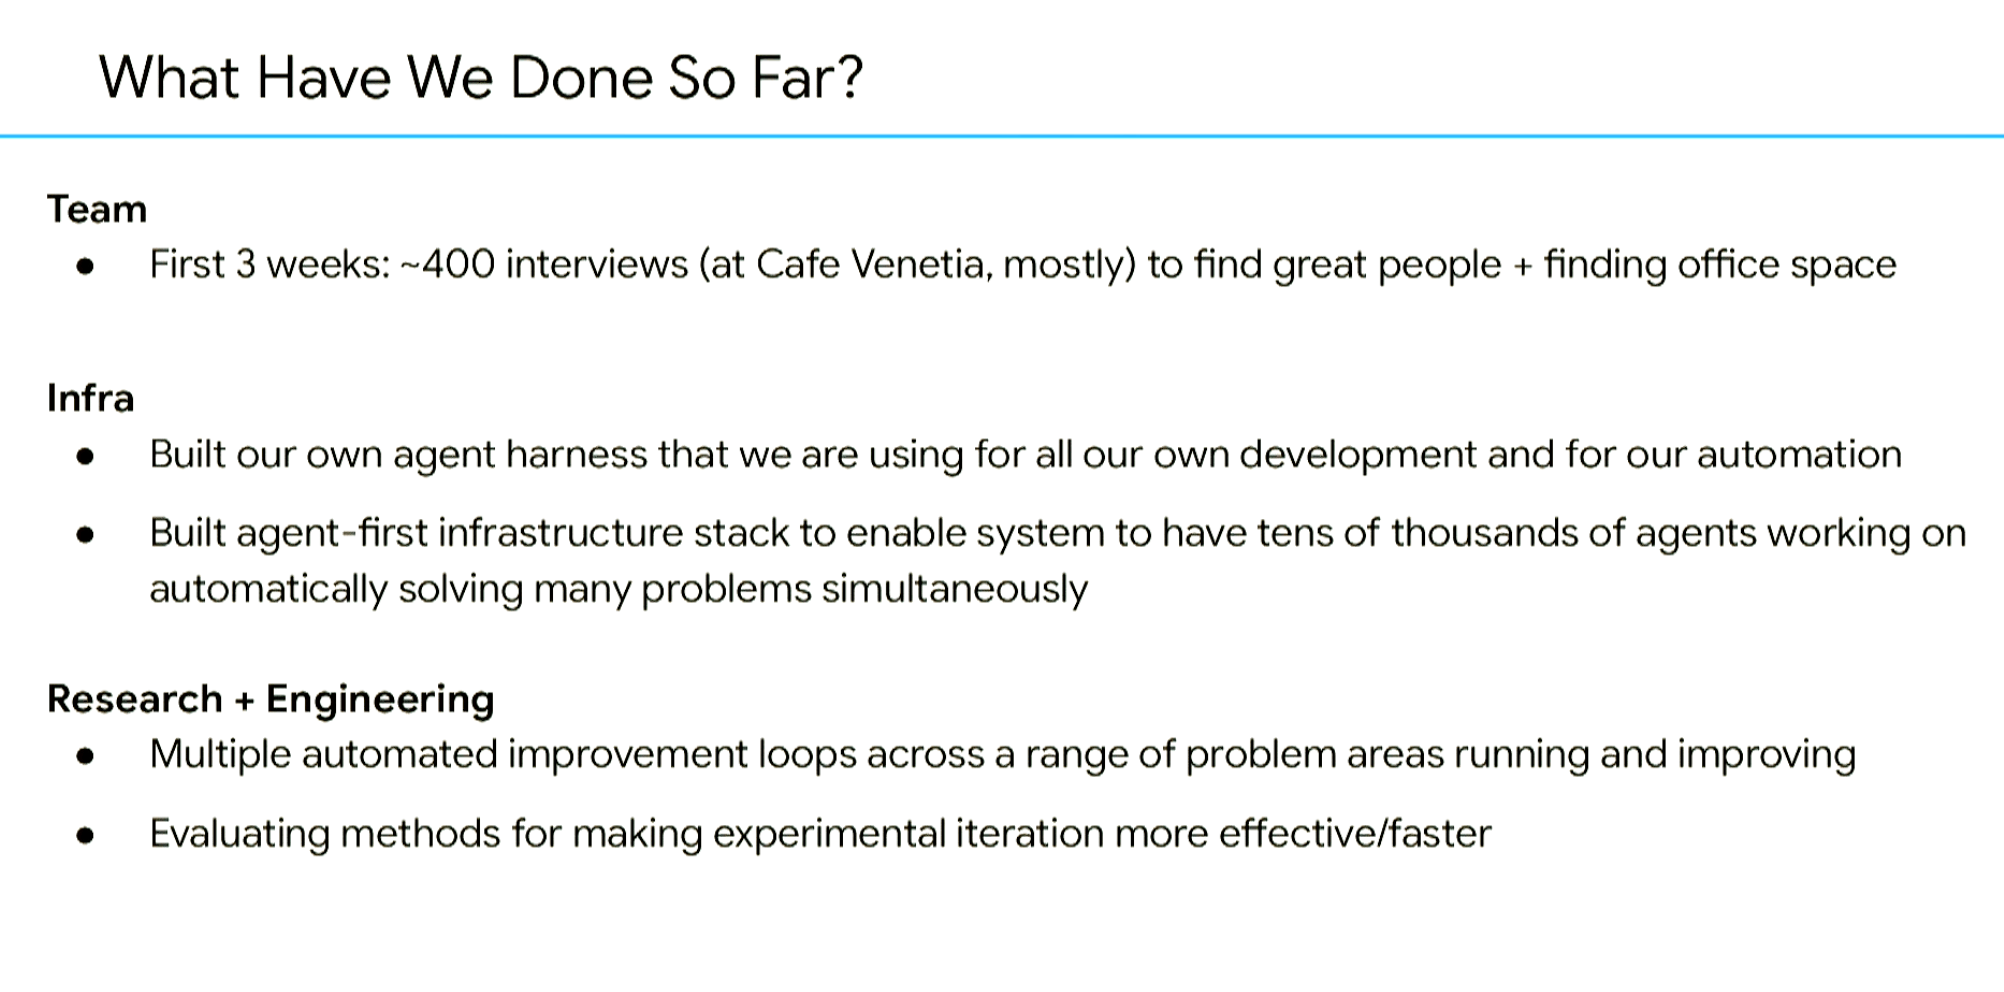
創業からの最初の3週間、私たちのチームはカリフォルニア大学通りの「Cafe Venetia」で400回もの高密度な面接を行い、カルチャーとスキルが最もマッチするトップギークの選定に全力を尽くしました。
現在、会社は旧Zibibboレストランの跡地へと正式に移転し、非常にユニークでギーク感あふれる開発拠点を構えています。
エンジニアリング面では、社内システムの自律的ブートストラップ開発と自動運転を包括的に支える、独自の自律エージェント実行環境(Agent Harness)を開発しました。
このフレームワークは優れた分散協調特性を備えています。エンジニアは個別にAgentと対話してトラブルシューティングを行えるだけでなく、いつでもチームメンバーを招き入れ、「複数の人間が複数のAgentを協調指揮する」マルチエージェント協調モデルを実現できます。
チームメンバーは、施策が実行に移される前にオンラインで直接レビューし、修正コメントを残すことで、実験プランの事前チェックを行うことができます。
一般的なツールとは異なり、私たちのインフラアーキテクチャは初日から大規模なAgentの並行スケジューリングを前提に再構築されており、単なる数十人から百人規模の協業にとどまらず、数千から数万規模のエージェントクラスタによる並列処理をネイティブにサポートしています。
現在までに、システム内では約20件の自律最適化を繰り返す改善ループが、24時間体制で安定稼働しています。
私たちは、実験サイクルの単位反復コストをさらに削減し、過去の評価指標とテレメトリデータの再利用を最大化することで、システムの自己進化能力をいかに加速させるかを継続的に検証しています。
コア目標:ドメインエキスパートの生産性を20〜50倍に解放する
これこそが私たちの現在の主戦場です。ソフトウェアのループによって機械学習タスクの完結サイクルを完全に支援・自動化し、それを足がかりとして、さらに高度な完全自律の科学的探索を推し進めていくことです。
アプローチの起点として、私たちはまず自動化ループを通じて、機械学習アルゴリズムの研究開発と大規模MLエンジニアリング領域自体における最大のボトルネックを解決することに焦点を当てています。
私たちの中期的なコア指標は、ドメインエキスパートの実際の研究生産性を20〜50倍に向上させることです。
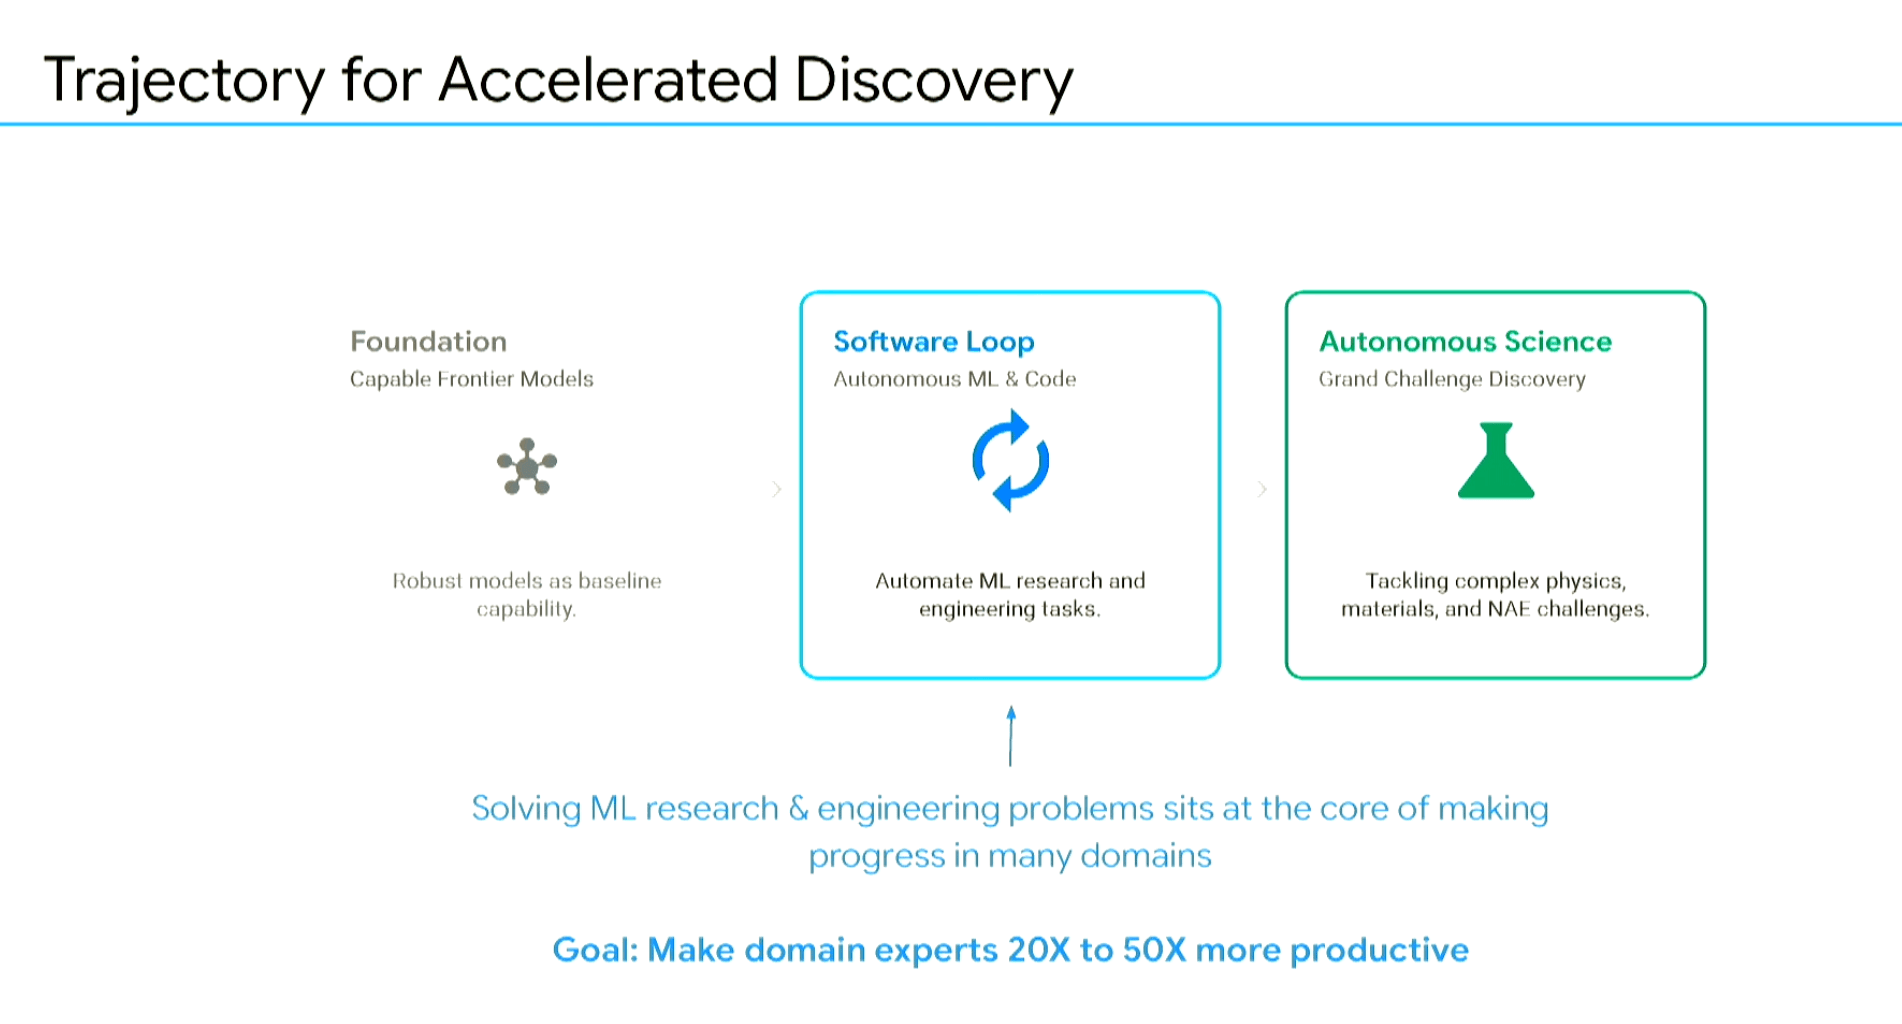
壮大な課題を抱えるすべての科学者やエンジニアが、基礎的・反復的な認知的負荷を減らし、本質的な核心課題に直接集中できるようにしたいと考えています。このパラダイムにおいて、戦略の舵取りを行う主導権は、常に人間がしっかりと握り続けます。
過去15年間にわたる機械学習分野の爆発的進化は、強固なモデル基盤を整え、機械学習、自然科学、工学の自動化という新時代を本格的に切り拓くための土壌を完成させました。
Jeff Dean × フェイフェイ・リー対談:RSIも物理的現実に縛られる、初期の蒸留技術は冷遇されていた
なぜGoogleを離れて起業を決断したのか?
フェイフェイ・リー: Jeff、素晴らしいお話をありがとうございました。これが本日のセッションの締めくくりですね。ちょうど私たち二人が、会場の皆さんとティーブレイクの軽食の間に立ちはだかっている格好です。
Jeff Dean: ははは、この時間帯の進行はいつもプレッシャーがかかりますね。
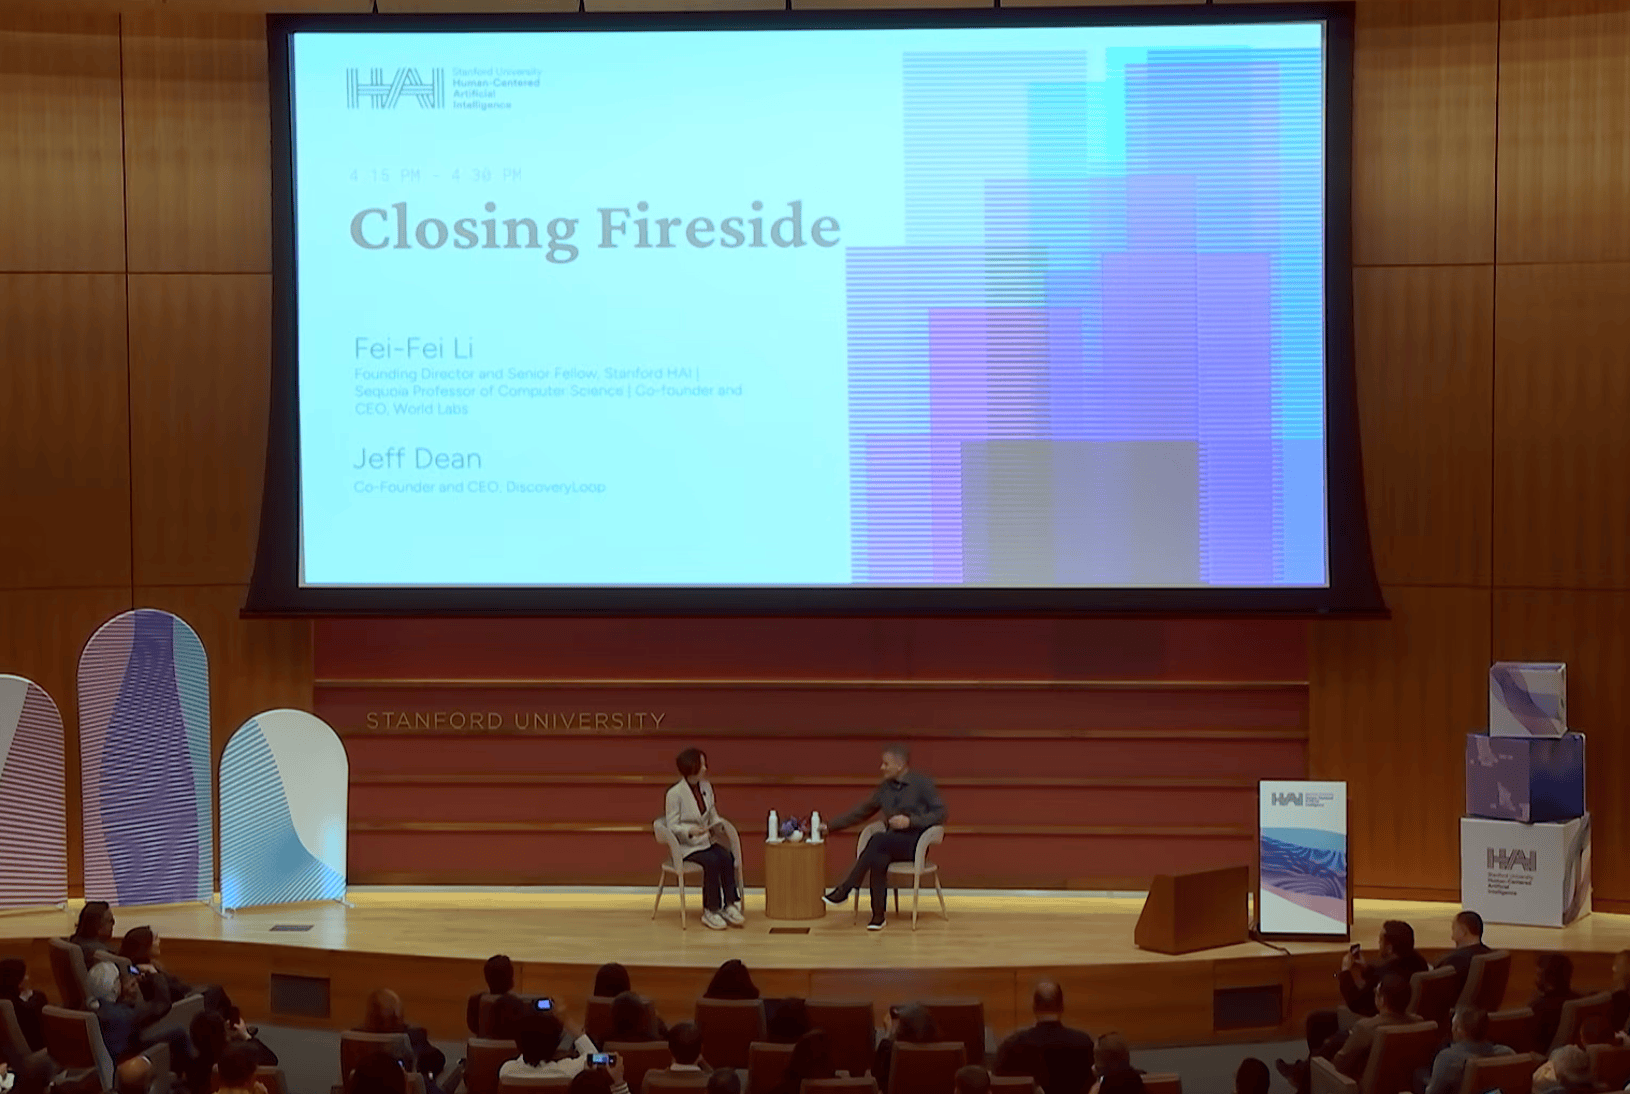
フェイフェイ・リー: もともとは非常にギークな技術的質問を用意していたのですが、対談という形式ですので、質問者と議論のパートナーという両方の役割を務めたいと思います。
まずは改めてお祝い申し上げます。最初の質問は核心に迫るものです。なぜ今、Discovery Loopを立ち上げたのでしょうか?
創業メンバーであるお四方は長年Googleに深く携わってこられました。特にJeff、あなたは1999年にGoogleに入社しています。ここ数年の業界の技術的飛躍は誰もが認めるものですが、この1〜2年の間にどのような決定的な「アハ体験(閃きの瞬間)」があり、あなた、Quoc、Sanjay、Oriolの4人が「まったく異なることをしなければならない、それも既存の枠組みを完全に離れてやるべきだ」と確信するに至ったのでしょうか?
Jeff Dean: その核心は、ソフトウェアエンジニアリングのライフサイクル全体において、自動化システムが発揮する驚くべき支援のポテンシャルを私たちが明確に目の当たりにしたことにあります。
10年前、Quocはニューラルアーキテクチャ探索(NAS)の先駆的な研究を数多く主導しました。本質的にこれは、アルゴリズム自身にコンピュータビジョンや自然言語タスクに最適なモデルトポロジーを自動探索させるという、ある種の初期形態の再帰的自己改善システムでした。
当時すでに私たちはこのアプローチの実現可能性を実証していました。唯一の課題は、当時はシステム全体が探索空間をハードコーディングするための長大で煩雑、かつ高度に特有なPythonのボイラープレートコードに依存していたことでした。
しかし現在では、極めて自然な日常言語を使って、強力な基盤モデルやエージェントクラスタに対して直接マクロな構想を提示することができます。例えば「特定の磁気共鳴画像(MRI)の特徴解析に最も適した専用ニューラルネットワークアーキテクチャを探索せよ」と伝えるだけで、システムがその後の探索と検証をエンドツーエンドで完了してくれるのです。
この対話の次元の飛躍は、計算システムの限界とAIのポテンシャルに対する私たちの認識を根本から塗り替えました。このシステムの信頼性を産業レベルの水準にまで高めることができれば、そこから生み出される産業的価値は計り知れません。私たちは、自然科学と高度な工学領域こそが、このシステムが最大のポジティブなインパクトをもたらす最適な主戦場であると確信したのです。
フェイフェイ・リー: つまり、皆さんを組織から飛び出させて起業へと駆り立てた真の原動力は、閉ループでの自律運用と自己進化の可能性を兼ね備えた、このまったく新しいパラダイムにあったということですね。