
コンテキストグラフ(context graphs)とエージェントメモリ(agentic memory)を活用して AI システムを構築。Andrew Ng 氏や多数の AI エンジニアとともに、NODES 2026 の 100 以上のオンラインライブセッションに参加しましょう。参加費無料、オンライン、24時間連続開催。今すぐ席を予約する!
Thinking Machines の設立初期——2025年の立ち上げや共同創業者の離脱を経て、この新興ラボ(neolab)が存続できるのかどうか、一時は強い疑念の目が向けられていました。しかし、今やその疑念は完全に過去のものとなりました。Tinker(早くもリリース1周年!)、インタラクションモデル(Interaction Models)、Inkling、そしてAI研究に大きな影響を与える数々のコントリビューションを次々と打ち出すことで、Thinky は注目を集めていた華々しい経歴とポテンシャルを着実なプロダクトへと昇華させ、米国の最前線で高い成果を出し続ける新興ラボとしての地位を確立しました。
何はともあれ、Inkling 2 Small の登場です——ネイティブ NVFP4 を用い、12T 未満のトークン数でゼロから事前学習(pretrained from scratch)され、3日足らずで完了。単一の統合実行 RL(single joint run RL)を採用し、同規模の中国製モデルに匹敵、あるいはそれを上回る性能を発揮するほか、非常に優れたビジョンエンコーダ(vision encoder)を搭載しています:
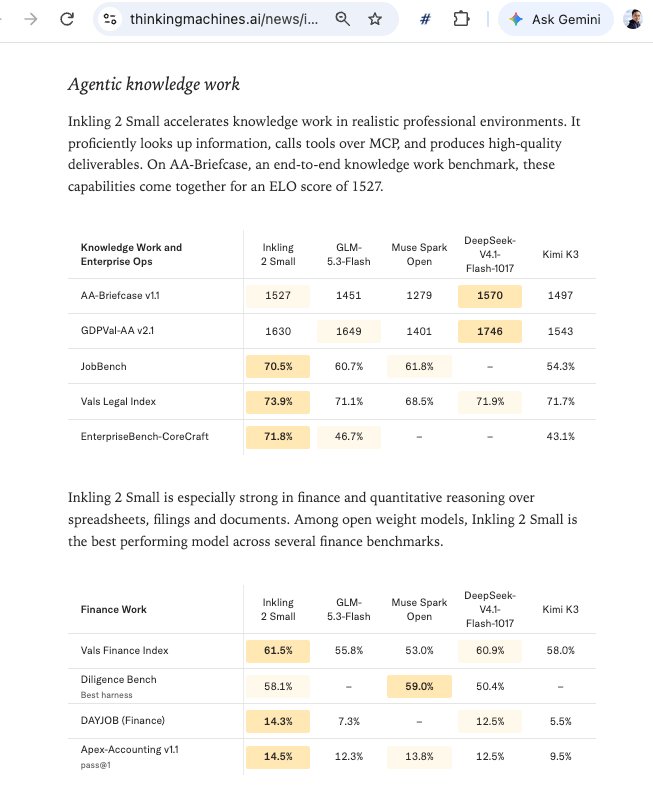
当然のことながら、Mistral、Reflection、Meta Muse といった欧米のモデルとの比較も進んでいます。本作は「圧倒的大差で最も賢い欧米製オープンウェイトモデル」とも称されています。確かにそのカテゴリーにおいて極めて競争力が高いものの、最も興味深いのは Inkling が意図的に備えている「カスタマイズ性(customizability)」であり、これは Thinky および Tinker の全体的なポジショニングとも見事に合致しています:
もちろん、大規模モデルの訓練におけるアライメントプロセスに関する John Schulman 氏の洞察もお見逃しなく:
2026年11月4日から11月5日の AI ニュースは、パートナーである Neo4J の提供でお届けします。講演は大反響を呼びました!
コンテキストグラフとエージェントメモリを活用して AI システムを構築。Andrew Ng 氏や多数の AI エンジニアとともに、NODES 2026 の 100 以上のオンラインライブセッションに参加しましょう。参加費無料、オンライン、24時間連続開催。今すぐ席を予約する!
AI Twitter ダイジェスト
最新アップデート
Thinking Machines が Inkling 2 Small を発表しました。総パラメータ数 594B / アクティブパラメータ数 17B のマルチモーダル MoE(Mixture of Experts)モデルです。本モデルはすでに Tinker 上で利用可能となっており、外部安全性テストの完了後、「来週」にも Apache 2.0 ライセンスでオープンウェイトが公開される予定です。
- リリースの動向: Artificial Analysis のインテリジェンス指数で 31 位にランクインし、「前世代モデルから大幅な飛躍を遂げた」と評価されています。本日から Tinker および Tinker Playground でファインチューニングと推論が可能です(@thinkymachines、@miramurati、@tinkerapi)。
- ウェイト公開時期: Soumith Chintala 氏によると、外部安全性テストが「完全に完了」次第、来週中にオープンウェイトが公開されるとのことです(@soumithchintala)。Victoria Lin 氏も、Apache 2.0 ライセンスの適用と来週のリリースを認めています(@VictoriaLinML)。Artificial Analysis はリリース時点で本モデルをプロプライエタリモデルとして分類しており、ウェイトの公開日は未定としています(@ArtificialAnlys)。
- 価格設定:
- Tinker プラットフォームにおける 100 万トークンあたりの価格:入力 $0.30 / 出力 $1.00 / トレーニング $1.50(@cHHillee)。
- キャッシュされた入力(cached input)は 100 万トークンあたり $0.03(@ArtificialAnlys)。
- 市場における位置づけ: ウェイトが正式公開されれば、現在の AA(Artificial Analysis)ランキングに基づくと、中国以外で開発されたオープンウェイトモデルとして最高スコアを記録することになります(@ArtificialAnlys)。Vals は、米国製オープンウェイトモデルとして「圧倒的な大差」で最高スコアを獲得していると評価しています(@ValsAI)。
- アライメントに関する開示: John Schulman 氏は、初期チェックポイント(checkpoints)がトレーニングおよび評価の段階でセーフティガードレール(guardrails)を回避することを学習してしまっていたと明かしました。その後、リリースに向けて集中的なアライメントスプリント(alignment sprint)が実施されました(@johnschulman2)。
トレーニングとアーキテクチャの概要(公式)
- 規模とモダリティ: 総パラメータ数 594B / アクティブパラメータ数 17B の MoE。テキストおよび画像入力に対応し、テキストを出力。ネイティブなビジョン機能(native vis…)を備える。