
Baidu、最新ベースモデル「文心 5.5 Flash Base」を正式にオープンソース化
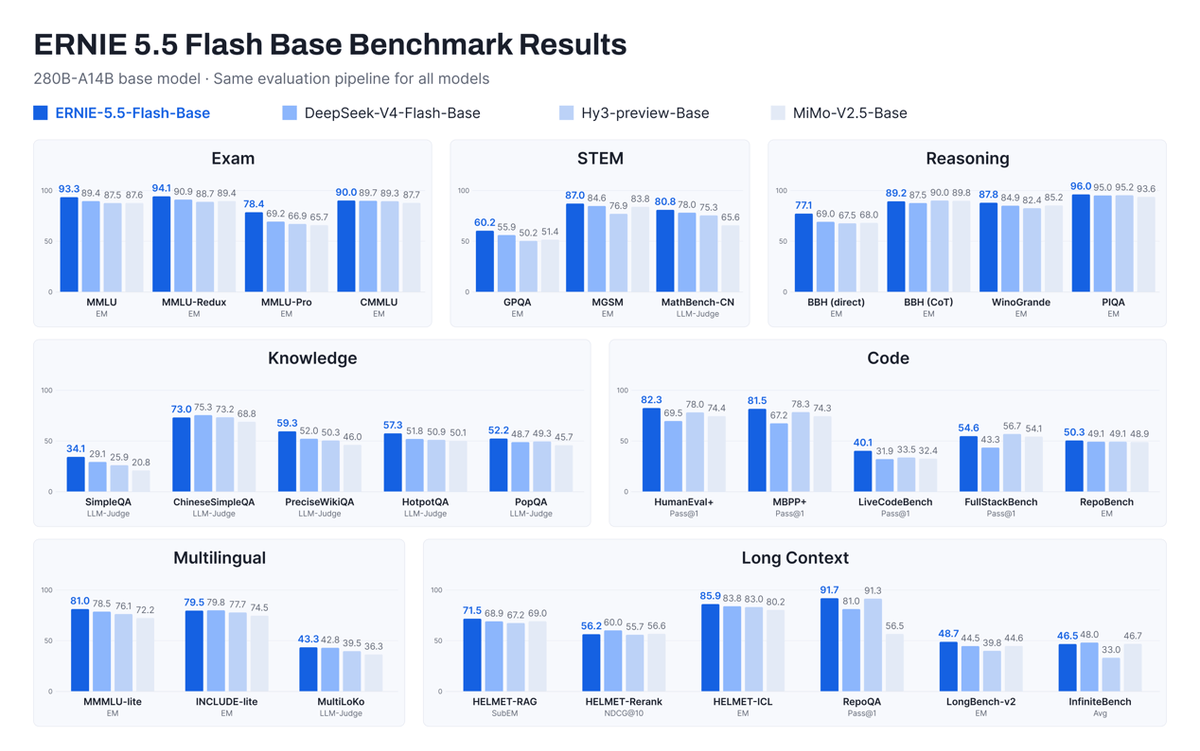
11月5日、Baidu は最新のベースモデル「文心 5.5 Flash Base(ERNIE 5.5 Flash Base)」を正式にオープンソースとして公開しました。本モデルは MoE アーキテクチャを採用しており、総パラメータ数は 2,800 億、トークンあたりのアクティブパラメータ数は 140 億です。33.5 兆トークンに及ぶ事前学習を実施し、事前学習時のコンテキスト長は最大 128K、ファインチューニングおよび推論時には最大 100 万トークンの超長文コンテキストに対応します。知識、推論、数学、コード、多言語、長文コンテキストなど、複数のベンチマークテストにおいて同規模のモデルの中で SOTA(最先端)の性能を達成し、DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base などの同クラスモデルを上回りました。
オープンソース公開URL:https://huggingface.co/baidu/ERNIE-5.5-Flash-Base
大規模言語モデル(LLM)の用途が単一のテキスト質疑応答から長文ドキュメント分析、マルチターンの複雑な対話、さらには AI エージェントタスクへと拡大するにつれ、モデルが処理すべき情報量は爆発的に増加し、計算コストや GPU メモリの消費も著しく増大しています。そのため、モデルの中核性能を担保しつつリソース利用効率を大幅に高めることが、LLM 技術開発における重要課題となっています。
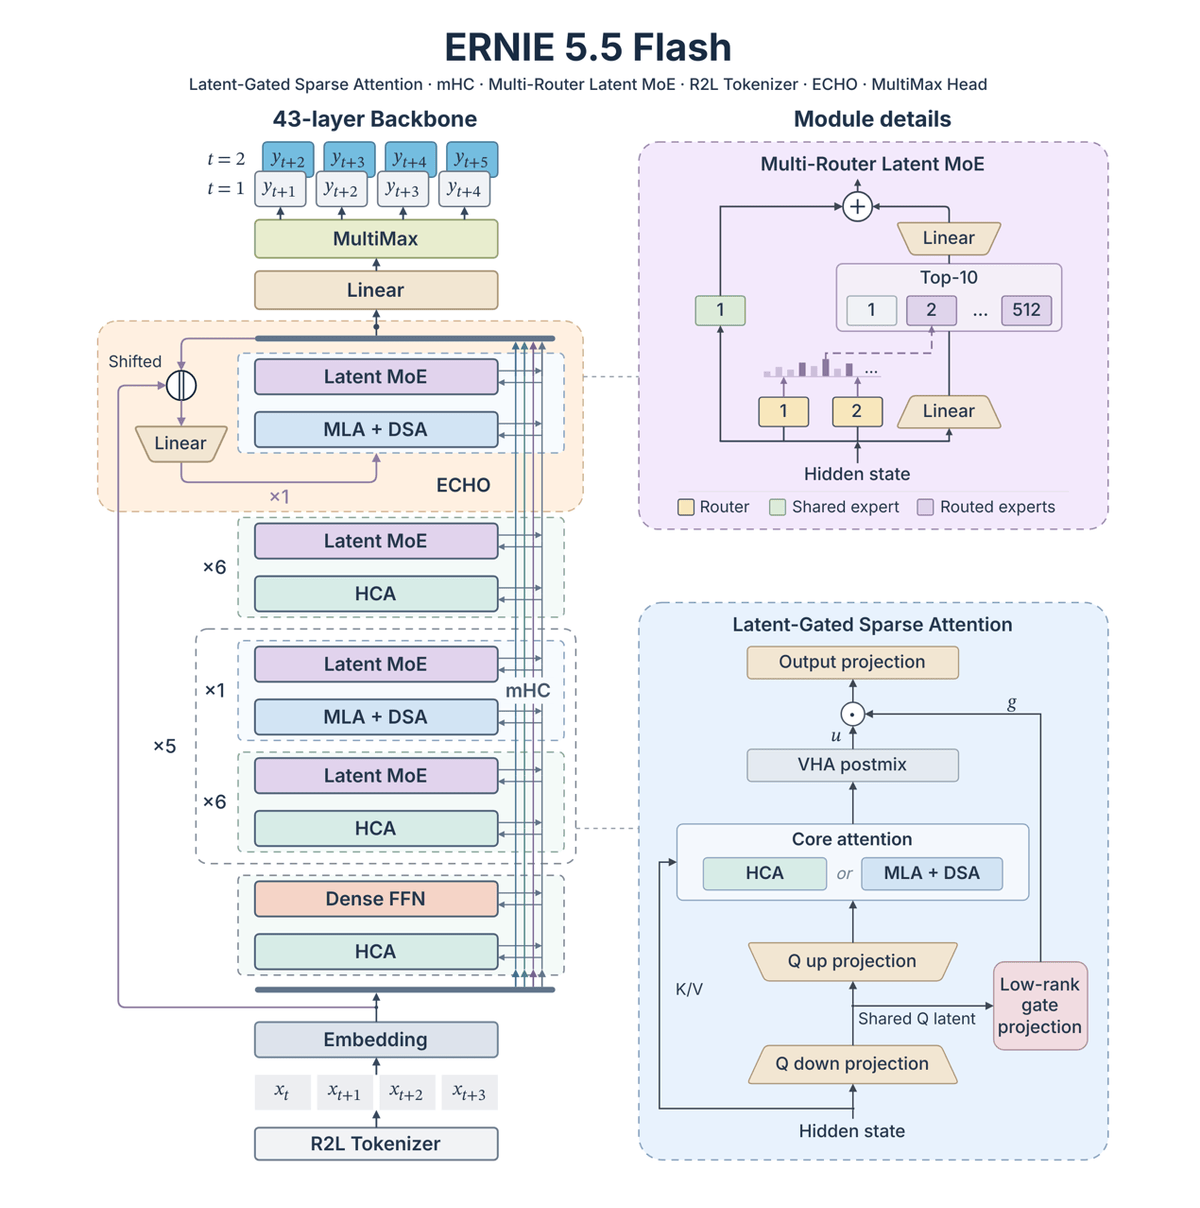
文心 5.5 Flash Base はこの「効率化」を中核テーマに据え、アテンション機構、エキスパートルーティング、学習メカニズムなどの重要技術において体系的な最適化を行い、数々のアルゴリズム革新を実現しました。
-
アテンション機構:開発チームは Latent-Gated Sparse Attention(潜在ゲーティングスパースアテンション)を提案し、ハイブリッドスパースアテンション、低ランクゲーティングアテンション、仮想ヘッドアテンションを高度に統合しました。
- HCA と MLA を連携・組み合わせることで、異なるアテンション層に「過去情報の圧縮」と「過去の特定位置へのきめ細かなアクセス」という役割をそれぞれ担わせています。
- 低ランクゲーティングアテンション(Low-Rank Gated Attention)は、既存の低次元表現を利用して情報ゲーティングを計算することにより、ゲーティングプロジェクションの重みパラメータ数を 75% 削減しました。
- 仮想ヘッドアテンション(Virtual Head Attention, VHA)は、モデルの表現力と学習の質を効果的に高めつつ、推論時にはアテンションオペレーターへシームレスに組み込めるため、追加のオーバーヘッドをほとんど生じさせません。 これらの設計により、長文コンテキスト処理時のリソース負荷を大幅に軽減しながら、重要情報を捉えて処理する能力を十分に維持しています。
-
エキスパートルーティングアーキテクチャ:Multi-Router Latent MoE 設計を採用し、複数の独立したルーターを導入して協調的にエキスパートを選択させることで、ルーティングスコアとエキスパートの実際の実効性との相関を大幅に改善しました。単一のルーターに依存する従来手法と比べ、アクティブなエキスパート数、エキスパートの計算量、通信量を維持したまま、単一のスコアリングバイアスがルーティング判断に与える悪影響を効果的に低減しています。
-
学習目標と推論デコード:ECHO メカニズムを導入しました。独立した MTP(Multi-Token Prediction / マルチトークン予測)補助モジュールを別途追加することなく、バックボーンネットワークの最終層を直接再利用。バックボーン自体に後続トークンの予測を学習させることで、シーケンスの今後の展開を先読みして計画させ、論理推論やコード生成能力を大幅に強化しています。文心 5.5 Flash はわずか 1 ステップの ECHO で事前学習を行いますが、再利用された最終層は投機的デコード(Speculative Decoding)の高性能なドラフトモデルとして機能し、優れたマルチステップ外挿能力を発揮します。同じ「1 ステップのみの学習」という条件下において、そのドラフト生成品質は従来の補助 MTP モジュールを大きく凌駕しています。
アルゴリズムアーキテクチャだけでなく、大規模モデル基盤インフラとの協調的な革新も同様に重要です。開発チームは分散型 Muon オプティマイザを徹底的に最適化し、大規模な Head Dim 向けに設計されたアテンションオペレーター FlashMask-4 をリリースしました。これにより、超大規模学習における通信オーバーヘッド、GPU メモリ使用率、計算効率全般が大幅に改善されました。モデル性能の飛躍は、アルゴリズム設計だけでなく、基盤となる高効率な学習システムによる全方位の連携支援があってこそ実現できることを示しています。
ベースモデルは、事前学習によって培われた汎用的な認知能力を蓄積しているだけでなく、下流モデルのファインチューニングや上位アプリケーションのイノベーションを支える中核的な礎石でもあります。エンドユーザーに直接提供されるアプリケーション特化型モデルとは異なり、Base モデルは開発者や企業に十分なファインチューニングとカスタマイズの自由度を提供し、個別のビジネス要件に応じた専門モデルやバーティカルアプリの構築を可能にします。今回の Baidu によるオープンソース化は、世界中の開発者により競争力のある技術的選択肢を提供するだけでなく、専門モデルの二次開発にかかる学習コストと技術的ハードルを大幅に引き下げることになります。
現在、LLM 業界の競争は、能力の高さ、学習効率、実用的なイノベーションを三位一体で推進する新たなステージへと突入しています。推論モデルやエージェント応用が急速に進化する中、ベースモデルに対する業界のニーズは、単純な能力向上にとどまらず、より効率的な学習パラダイム、柔軟な能力拡張性、そして適応力の高いシナリオ移行性へと広がりを見せています。文心 5.5 Flash Base は、基礎能力の飛躍と学習・推論効率のブレイクスルーを同時に実現することで、開発者やオープンソースコミュニティへ向けて拡張性に優れた技術基盤を提供し、LLM エコシステムの多様な探求と社会実装の加速を後押ししていきます。