
わずか3Bのパラメータ活性化で、10項目のベンチマークが全面向上!
日常生活における人間の直感的な判断も、ロボットにとっては極めて厄介な難題になりがちです。
映像の中で物体が上の方に見えるからといって、現実の3次元空間でも高い位置にあるとは限りません。撮影アングルが変わって家具の見え方が変化しても、それは同一の物体です。画面内で物体が移動した場合、物体そのものが動いている可能性もあれば、単にカメラの向きが変わっただけの可能性もあります……。
こうした空間や状態の微細な変化は、人間なら一目で判別できますが、ロボットの「エンボディド・ブレイン(身体性を持つ知能)」にとっては極めて突破が難しいボトルネックとなっていました。
視点の変化による物体の誤認、カメラの動きの誤判定、タスクの進捗状況の見誤りなどは、いずれもロボットのタスク失敗に直結します。
ロボットが現実世界のタスクを確実に遂行できるようにするためには、モデルは単に「物体を見る」だけでなく、3次元の空間関係を理解し、物体の状態変化を捉え、タスクが現在どの段階にあるかを正確に判断する必要があります。
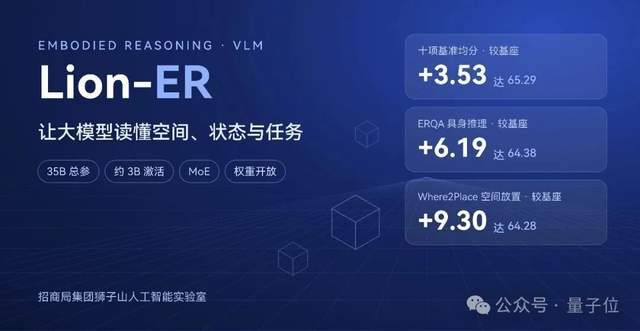
先日、招商局先端技術研究院傘下の獅子山人工知能研究所(Lion Rock AI Lab)は、エンボディド推論ビジョン言語モデル**「馭物™ Lion-ER-35B-A3B」**を発表しました。本モデルはMoE(Mixture of Experts)アーキテクチャを採用しており、総パラメータ数は約35Bでありながら、トークンごとに活性化されるパラメータはわずか約3Bにとどまります。
推論コストを大幅に増やすことなく、10の主要なエンボディド関連ベンチマークにおいてスコアの全面的な向上を達成し、多くのコア能力でより大規模なパラメータを持つ主流モデルを凌駕しました。大規模なトレーニングデータをやみくもに積み上げる従来のアプローチとは一線を画す技術ルートを切り拓き、ロボットが3次元物理世界を真に理解するための足がかりを築いています。
このモデルはどのように作られたのか?
過去数年にわたり、Open X-EmbodimentやDROIDなどの研究成果によって、実世界におけるロボットデータのフロンティアは絶えず拡張されてきました。しかし、データ規模が拡大するにつれて、ある問題が浮き彫りになってきました。
データが増えても、能力の向上に直結するとは限らない。
既存の研究でも、現在のロボットデータセットにおいて、異なるデータ領域の学習の重みを調整するだけで、下流タスクのパフォーマンスに顕著な影響を与えることが示されています。
「馭物™ Lion-ER-35B-A3B」の核心は、単にモデルのパラメータを増やすことではなく、「能力牽引型」のエンボディド・データエンジンを構築した点にあります。膨大なデータを無目的に収集する従来の手法を脱し、モデルが習得すべきコア能力を中心とした順方向の設計を行い、厳密な評価に基づいて弱点を特定し、閉ループでの反復改善とデータの最適化を実現しています。
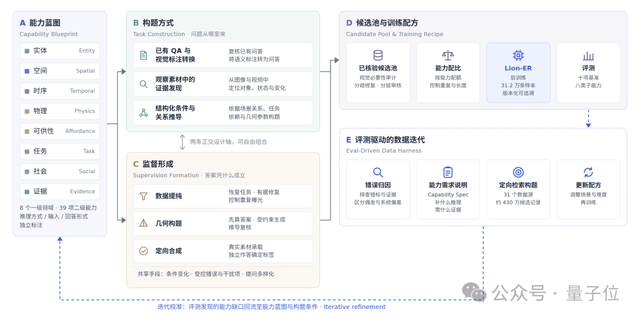 能力牽引型のエンボディド・データエンジン
ステップ1:モデルが何を学ぶべきかを明確にする
獅子山チームは、粒度の細かい「能力ブループリント」を策定しました。
エンボディド推論を**「エンティティ、空間、時系列、物理、アフォーダンス、タスク、社会性、エビデンス」**という8つの第1階層の領域に分解し、さらに39の第2階層の能力へと細分化しました。同時に、推論方式、入力形式、回答形式を独立した次元として個別に定義することで、分類基準の混在による定義の重複を防いでいます。
このブループリントは、モデルがどのような能力を学ぶ必要があるかだけでなく、それらの能力がどのような条件下で呼び出されるべきかも明確にしています。
現実のタスクは複合的な能力を伴うケースが多いためです。例えば、物品が適切な位置に置かれたかどうかを判断するには、タスクの進捗状況の理解と空間関係の推論の両方が求められます。
そのため、チームはブループリントの策定段階で主能力と補助能力を個別に記録し、分解不可能な複合タスクを別途リストアップしました。
学習データのサンプリング段階でも、特定の能力が少数の固定されたシーン、物体、または質問パターンと過度に結びついてしまうことを防ぐため、多様な要素の組み合わせとホールドアウトのバランスを慎重に考慮しています。
ステップ2:抽象的な要件を個別の学習問題へと具現化する
能力ブループリントを策定したあと、それをどのように落とし込み、具体的な学習問題を生成するのか?
チームはこのプロセスを**「能力コンパイル」**と名付けました。
抽象的な能力目標を項目ごとに分解し、「どのようなシーンを設定すべきか、視覚情報をどのように構成するか、どのような質問を投げかけるか、何を根拠に正解を確定するか」へと具体化していきます。
クロスビュー(複数視点)推論を例にとると、まずモデルに提示する視点数、複数の画像間で関連付けるべき対象物体、そして方位を判定する際の基準となる観測者の位置と向きを明確にする必要があります。
同時に、素材自体の厳密な検証も不可欠です。モデルに提供される視覚情報が、確固たる答えを導き出すのに十分であるかどうかをチェックします。キーとなる視点が欠けていたりエビデンスが不足していたりして、推測に頼らざるを得ない問題は、すべて不適格な学習サンプルとして排除されます。
このような問題作成基準は完全に目標能力によって主導されているため、評価で誤答が発覚してから受動的にデータを補強する必要がありません。
能力ブループリントがあらかじめカバーすべき能力の範囲を規定し、ベンチマーク評価はモデルの弱点を正確に特定して穴を埋める役割を果たします。
ステップ3:すべての学習問題に確かな根拠を持たせる
問題作成のアプローチとして、チームは相互に組み合わせ可能な3つの経路を設計しました。「既存のQAやアノテーションからの変換」、「観察素材からのエビデンスの発見」、そして「構造化された条件と関係性からの導出」です。これら3つのアプローチが連動することで、抽象的な能力要件が具体的で回答可能な個別の学習問題へと変換されます。
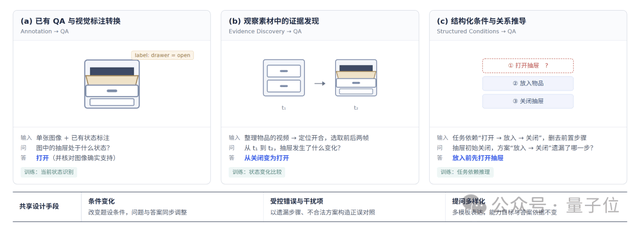 3つの問題作成アプローチの概念図
データの品質検証においては、データ純化、幾何的作問、ターゲット合成という相互補完的な3つのルートを採用しました。
- データ純化: 既存データの徹底的なクレンジングと修正を実施。画像の順序、指示表現の曖昧さ、選択肢と回答のマッピングを細かく精査し、検証可能な誤りを修正するとともに、重複露出率を厳格に制御します。
- 幾何的作問: 信頼性の高い姿勢(ポーズ)、深度、物体の対応関係を備えた素材を対象に、確定した正解および推論に必要な中間の幾何学的関係をあらかじめ算出。それらの事実制約のもとでモデルに問題と解説を生成させます。
- ターゲット合成: 既存の教師信号が不足している場合、実際の画像や映像素材をもとにQAをピンポイントで合成します。合成対象は問題文とアノテーションのみに限定し、生成モデルによる回答はグラウンドトゥルース(真値)としては直接扱わず、独立した回答検証や厳格な人手による監査を必ず通過させます。
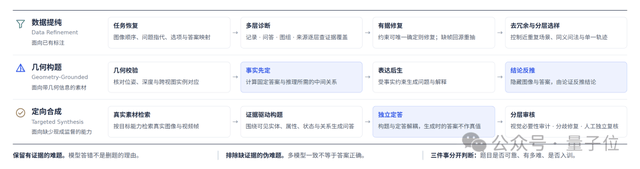 3つの品質検証ルート
プロセス全体を通じて貫かれている基本原則は、**「根拠のある難問は残し、根拠のない『見せかけの難問』は排除する」**ということです。
モデルが間違えたからといって安易にサンプルを削除することはせず、複数のモデルが同一の回答をしたからといってそれだけで正解と見なすこともありません。
モデルが継続してミスをする難度の高いサンプルに対しては、Human-in-the-loop(人間の介在)による再検証メカニズムを導入し、複雑なエンボディドタスク向けに視覚化検証プラットフォームを構築しました。マルチアングルの比較、タイムライン再生、重要エビデンスのハイライト機能などを通じて人手によるチェックを強化し、レビューアが視覚的手がかりと推論の根拠を十分に再現できるようにすることで、モデルの能力限界に起因する問題をデータの不備と誤認するのを防いでいます。
ステップ4:評価結果をデータ反復に直接フィードバックする
適切な学習問題が揃った後は、学習リソースを正確に配分する必要があります。
「馭物™ Lion-ER-35B-A3B」の教師あり学習データセットには、合計312,380件のサンプルが含まれています。学習時には、単にデータソースの量に依存して重みを決めるのではなく、能力の必要度に応じて厳格にリソース予算を配分しています。
サンプルは空間幾何、マルチアングル対応、動作軌跡、タスクプランニングなどのコアなエンボディド能力を重点的にカバーしています。均質で重複した問題を徹底的に削減し、貴重な学習リソースを推論の弱いタイプへと傾斜配分しました。サンプルの選定候補、審査から学習への投入に至る全工程をトラッキング可能にし、学習レシピの再現性と調整可能性を担保しています。
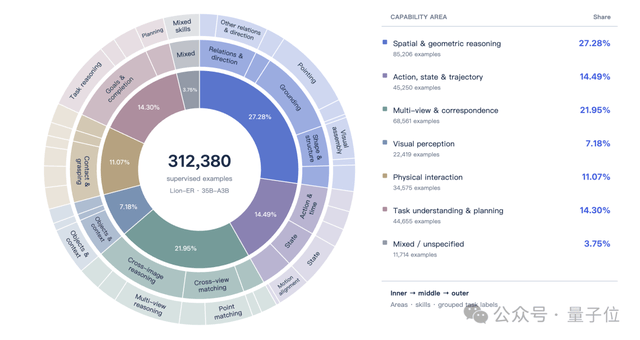 31.2万件の教師ありサンプルの能力構成比
順方向の設計によって網羅的な能力カバレッジを構築したものの、モデルが本当に習得できているか、どこに盲点が残っているのか?
この役割を完全に担うのが「Eval-Driven Data Harness」です。
これは、モデルの誤答から補強すべき弱点を正確に掘り起こし、それを次サイクルの実行可能なデータ生産要件へと変換するための高効率なデータ反復機構です。
このHarness機構のもとでは、評価は学習終了後の静的な「成績表」ではなく、次のデータ生産を推進する新たな出発点となります。
誤答が検出されると、まずアノテーション、視覚的エビデンス、スコアリングロジックに不備がないかを検証し、偶発的なミスと系統的な能力不足を切り分けます。能力のギャップが確認されたら、31のデータソース、約430万レコードにおよぶ膨大な素材プールから、推論ロジックは同一でシーンが異なる新たな素材を検索。問題作成と検証を経て学習に追加し、最終的に新たな評価ループによって改善効果を検証します。
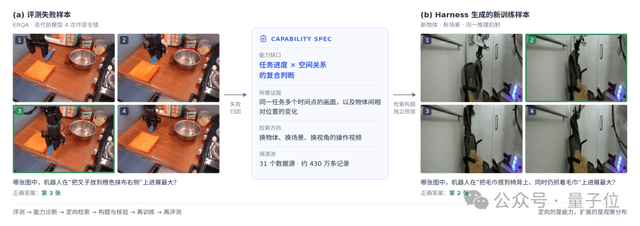 1度の評価失敗が、いかにして新しい学習データ群へと変換されるか
例えば、画面上の2次元的な「上/下」の位置関係を3次元空間の高さと混同しやすいというモデルの課題に対しては、上下に複数の設置面を持つ複雑なシーンを優先的に選定し、空間幾何構造を統合して高低を判断せざるを得ない状況を作り出しました。同時に、左/右、前/後の関係に遮蔽や遠近法の変化を加え、混同しやすいエッジケースを集中的にカバーしています。
さらに、インスタンスセグメンテーション、深度マップ、幾何学的拘束を組み合わせることで、配置領域の物理的な妥当性も厳密に検証しています。
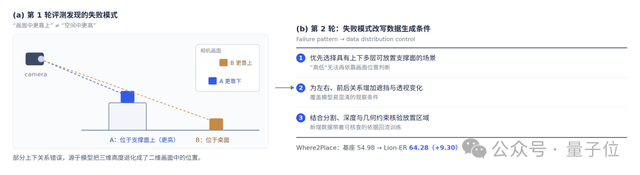 「画面で上にある」≠「空間で高い」。失敗パターンが次サイクルのデータ条件を直接アップデートする
要約すれば、能力ブループリントがカバーすべき方向性を定め、Eval-Driven Data Harnessが認知の盲点を継続的に補正します。
これにより、データは使い切りの静的なリソースから脱却し、モデルの能力とともに進化し続ける動的なアセットへと変化したのです。
活性化パラメータ約3Bで、10項目のベンチマークすべてが向上
能力牽引型データエンジンの後押しにより、「馭物™ Lion-ER-35B-A3B」は推論時の活性化パラメータがわずか約3Bでありながら、10項目の公開ベンチマーク評価すべてにおいてスコアの向上を達成し、一部の重要指標ではより大規模なパラメータを持つモデルすら上回りました。
評価は一貫してavg@4(各問題に対してモデルが4回独立して回答し、その平均スコアを算出)を採用しています。
対象となった10の公開ベンチマークにおいて、「馭物™ Lion-ER-35B-A3B」の等権重総合平均スコアは65.29に達しました。
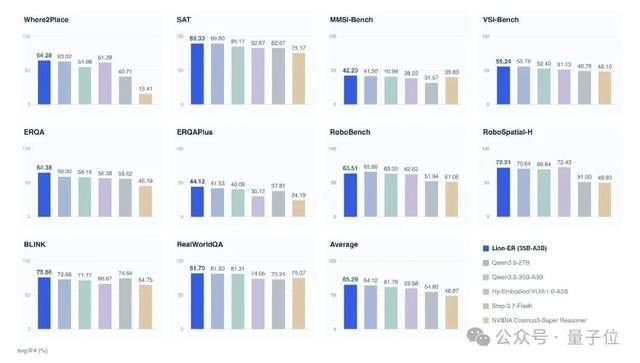 10項目のベンチマーク項目別比較棒グラフ(青色が「馭物™ Lion‑ER‑35B‑A3B」)
個別項目のテスト結果を見ると:
- Where2Place(空間配置評価)のスコアは64.28に達し、ベースモデルから9.30ポイント向上。
- ERQA(エンボディド推論ベンチマーク)のスコアは64.38に達し、ベースモデルから6.19ポイント向上。
- SAT(空間推論ベンチマーク)は89.33を記録。
- ERQAの軌跡理解サブ項目では68.18に達し、ベースモデルから12.12ポイントと大幅に向上。
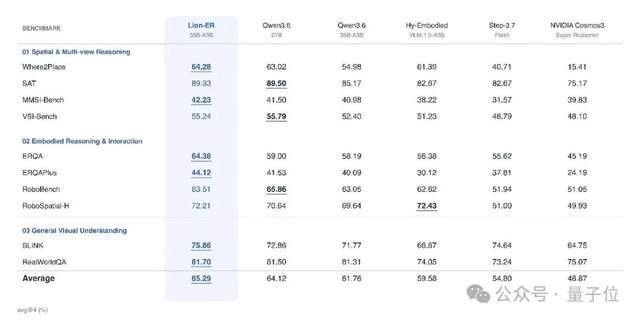 10項目のベンチマーク全成績(avg@4、青色の列が「馭物™ Lion‑ER‑35B‑A3B」)
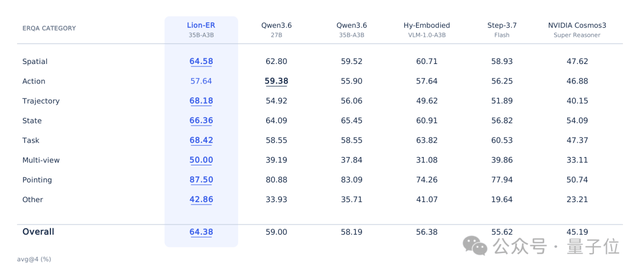 ERQAの能力カテゴリ別成績比較(avg@4、青色の列が「馭物™ Lion‑ER‑35B‑A3B」)
総合評価の結果、「馭物™ Lion-ER-35B-A3B」は10のベンチマークすべてにおいて、採用したベースモデルのスコアを大幅に上回りました。
公開ベンチマークの4つの実例から見る能力の差
以下の4つの評価ケースはいずれも公開テストセットから抽出したものです。同一の問題に対して、「馭物™ Lion-ER-35B-A3B」、ベースモデルのQwen3.6-35B-A3B、およびQwen3.6-27Bがそれぞれ4回の独立した回答テストを行いました。
問題1:方向の識別――カメラはどちらに向かって回転しているか?
ロボットアームの1人称視点カメラから連続撮影された2枚の入力画像です。画面内のボトルが全体的に上へとずれており、モデルはカメラがどちらの方向に回転しているかを判断する必要があります。
ベースモデルの正解は1回のみ、Qwen3.6-27Bは全問不正解でした。対して「馭物™ Lion-ER-35B-A3B」は2フレーム間の視差変化のパターンを正確に捉え、カメラが下向きに回転していることを正しく推論し、4回の回答すべてで正解しました。
ロボットにとって、画面内の物体に相対的な変位が生じた場合、まず運動の主体が何であるか――物体そのものが動いているのか、それともカメラの姿勢が変わったのか――を切り分けることが大前提となります。
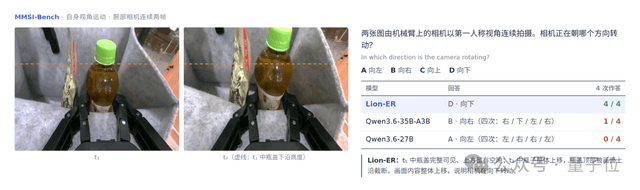 点線は同一の高さ基準線:t₂においてボトルは画面内で全体的に上方に移動している
問題2:軌跡の選択――どの経路ならタスクを完了できるか?
画面上には、異なる色で示された4つの動作軌跡の候補が提示されています。ロボットアームのタスク目標は、電源タップから充電器を抜き取り、画面右側へと移動させることです。モデルは実行可能な正しい経路を選択しなければなりません。
比較対象の2モデルはいずれも、右に伸びる紫色の長い弧線に惑わされ誤った選択をしました。この軌跡は一見すると目標エリアに向かっているように見えますが、始点が充電器に届いていません。操作対象に触れることすらできなければ、引き抜いて配置するという以降のアクションは当然実行できません。
「馭物™ Lion-ER-35B-A3B」は無効なルートを論理的に1つずつ除外できました。赤の軌跡はタップの左側に逸れており、紫はターゲットに届かず、黄色は後方のホースに向かっています。充電器に正確に到達して引き抜き、右側の所定エリアへと正常に移送できるのはオレンジの軌跡だけであり、4回の回答すべてで正解を選びました。
この問題で主に問われているのは、目標の意図、移動ルート、物理アクションを閉ループでマッピングする能力です。経路の終点を判断するだけでなく、軌跡全体が対象物体に対して有効に作用するかどうかを検証する必要があります。
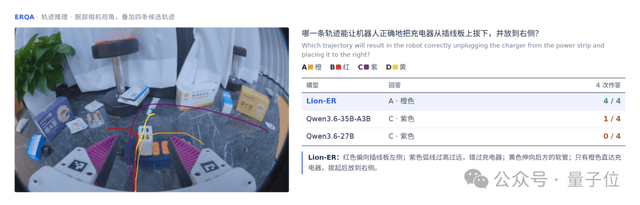 4つの候補軌跡のうち、「引き抜いて右側に置く」を完遂できるのはオレンジ色のみ
問題3:クロスビュー推論――絵画は撮影者のどちら側にあるか?
同一の屋内シーンで撮影された3枚の写真が提示されており、蝶の絵画は3枚目の写真にのみ写っています。問題は、1枚目の写真を撮影した際、この絵画が撮影者のどちら側に位置していたかを推論することを求めています。
この問題に答えるには、複数の画像を頭の中で連結し、3次元空間のレイアウトをメンタルリコンストラクション(頭の中での再構築)する能力が必要です。絵画は3枚目のリビングルームの壁に掛かっており、他の2枚の写真と組み合わせることで空間構造全体を完全に復元できます。1枚目の写真を撮影したとき、撮影者は階段の足元で階段に向き合っており、その背後にリビングがあるため、絵画は必然的に撮影者の「後方」に位置します。
比較対象の2モデルはいずれも「左側」と誤答し、4回とも正解できませんでした。「馭物™ Lion-ER-35B-A3B」は4回とも正しく推論しました。
絵画を認識すること自体は基礎的な視覚認識ですが、本問の難しさは、指定された視点と向きに主体的に切り替え、複雑なクロスビューの3次元空間ロジック推論を完遂しなければならない点にあります。
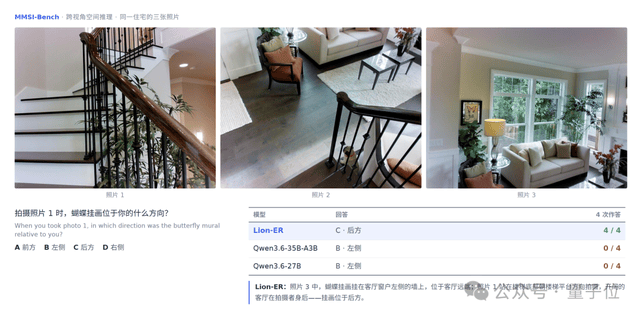 3枚の写真から「メンタルマップ」を組み立て、写真1の視点に戻して回答する必要がある
問題4:進捗の確認――このステップのタスクは完了したか?
ロボットの作業動画の一部で、目標はテーブル上の寿司ロールを鍋に入れることです。問題は「動画の現在のフレームにおいて、第1段階である『寿司ロールへ移動する』アクションは完了しているか?」というものです。
ベースモデルは4回のテスト中3回でこのステップを「完了した」と誤認し、Qwen3.6-27Bも半分の確率で同様の誤認をしました。「馭物™ Lion-ER-35B-A3B」は4回の回答すべてで「未完了」であると正確に識別しました。
このテストをクリアするためのコアは、ロボットアームが「寿司ロールに近づいている途中」なのか「正確な位置に到達した」のかという2つの物理状態を精密に見分ける点にあります。
画面上で動作が発生しているからといって、タスクのステップが達成されたとは限りません。モデルは運動に伴う状態遷移を厳密にモニタリングし、目標の最終状態が真に満たされているかを確認する必要があります。進捗の判断を誤ると、ロボットは後続の動作シーケンスを早まって呼び出してしまい、時系列プランニング全体が破綻することになります。
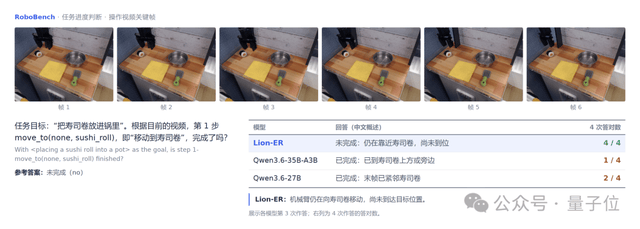 「近づいている」と「到達した」の差は、画面上ではほんのわずかな変位にすぎない
これら4つのケースは、それぞれカメラの運動解析、インタラクション軌跡のプランニング、クロスビューの空間マッピング、動作の時系列進捗判定に対応しており、ロボットが高レベルな自然言語の指示を現実の物理的オペレーションへと落とし込むための極めて重要な技術的基盤を形成しています。
エンボディド大規模モデルは画面を認識するだけでなく、物理的現実を理解しなければならない
現在、マルチターンの対話や汎用的な画像理解能力を備えたマルチモーダル大規模モデルは当たり前のものとなりましたが、現実の物理世界に真に向き合い、物理的なロボットを動かすことのできる「エンボディド・ブレイン」は依然として不足しています。
ロボットが現実環境で堅牢な作業を行うためには、2次元画面の見かけ上の認識にとどまることなく、視覚的な投影と真の3次元物理空間を明確に区別できなければなりません。
「馭物™ Lion-ER-35B-A3B」が示したものは、優れたベンチマークデータにとどまらず、成熟し再現可能なメソドロジーそのものです。
能力をデータ設計のコア単位とし、評価をデータ生成を駆動する直接の源泉とする。 能力ブループリントの構築からデータレシピのチューニング、個別の評価での躓きから次のターゲットサンプルの生成に至るまで、すべてのステップが明確なゴール指向、信頼性の高いエビデンス、そしてエンドツーエンドの追跡性を備えています。
現在、「馭物™ Lion-ER-35B-A3B」のモデルウェイトはHugging Face上でオープンソースとして全面公開されており、フォーマットはBF16 Safetensorsを採用。Transformers、vLLM、SGLangなどの業界主要推論フレームワークとネイティブに互換性があります。
開発者は、空間関係の理解、シーン状態の分析、タスク進捗の判定、物理空間の制約といった観点から適応評価を進め、具体的な画像、動画、作業フローと組み合わせて、エンボディドQA、シーンのインテリジェントな意思決定、ロボットシステムの統合・実用化を深く探索することが可能です。
招商局獅子山人工知能研究所は、今後もエンボディド・エージェントを軸に研究を進め、ツール呼び出し、マルチターン・インタラクション機構、物理実行フィードバックなどの高レベルな学習データを重点的に拡充していくとしています。また、長期にわたる複雑なタスクにおける連続的な意思決定や自律的なフォールトトレランス・復旧に取り組み、この能力駆動型データエンジンを進化させ続けることで、実物理環境におけるロボットの定常的な稼働に向けた強固な技術基盤を提供していく方針です。
Hugging Face モデルURL:
https://huggingface.co/cmriat/lion-ER-35B-A3B