
20億パラメータ(2B)の小型モデルでありながら、あらゆる種類のドキュメントから必要なフィールドを正確に抽出可能。検証したすべてのフロンティアLLM(frontier LLM)を上回るパフォーマンスを発揮し、コストはわずか数分の一に抑えられます。
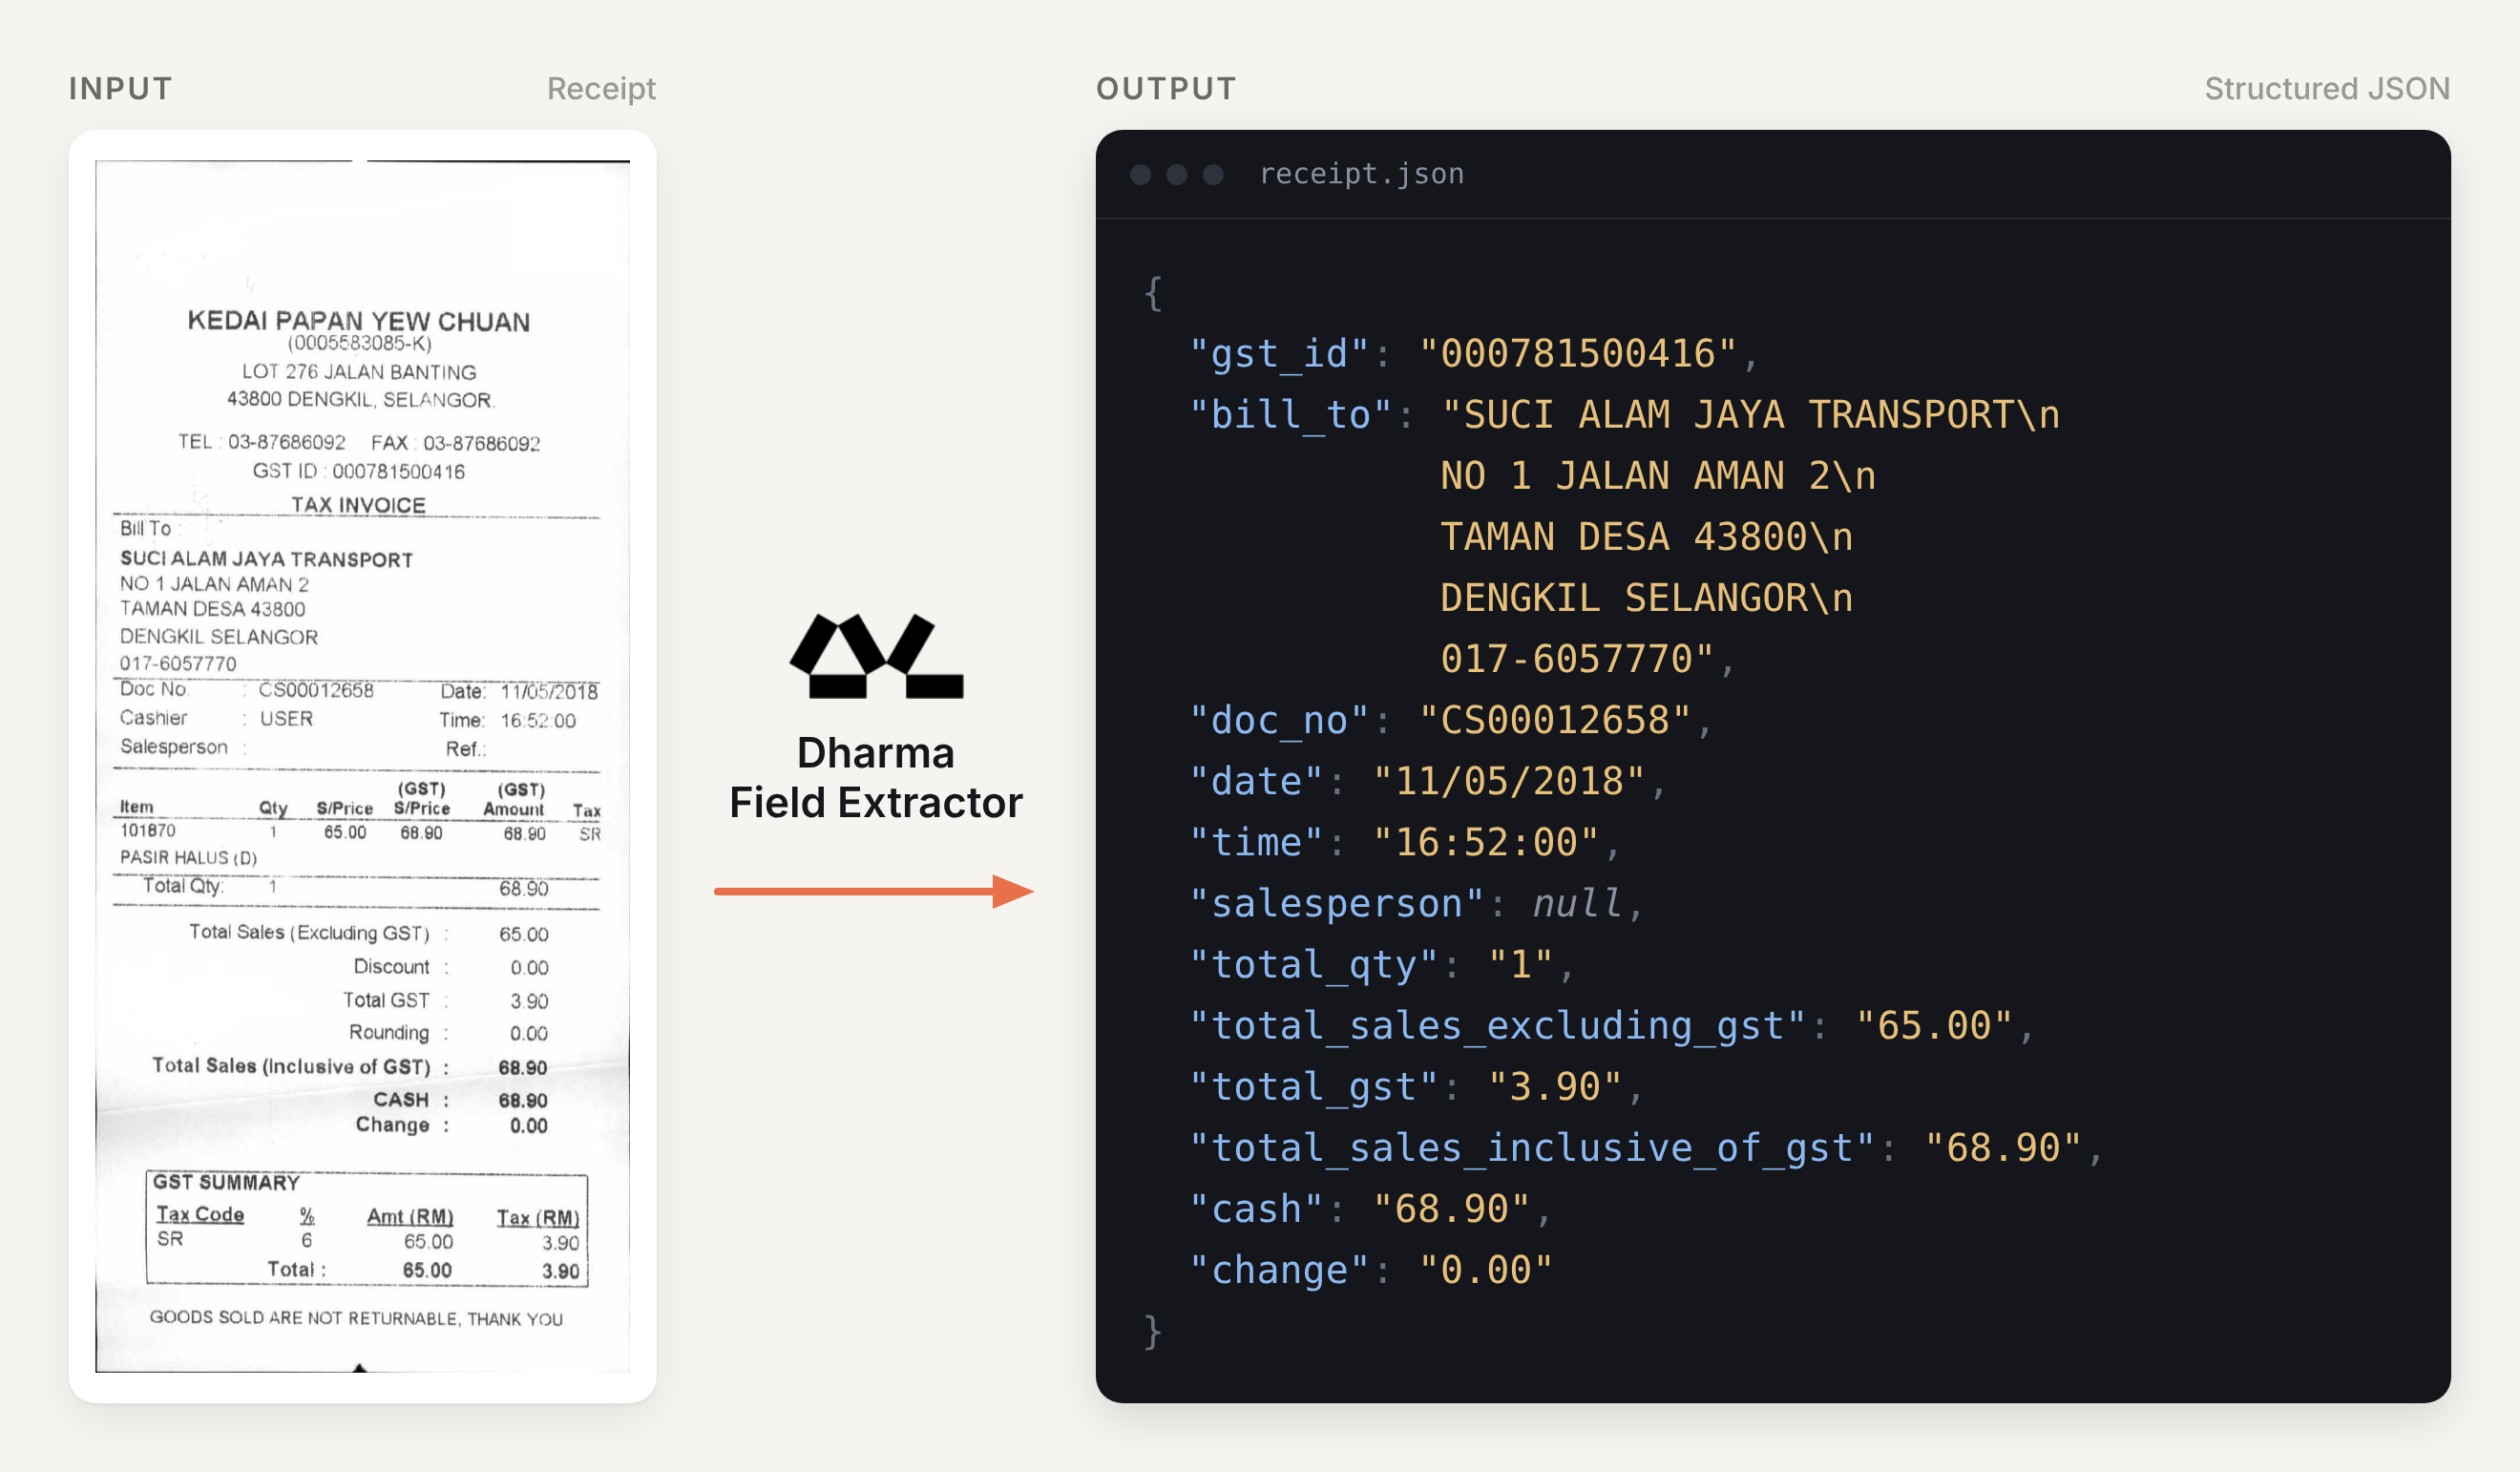 今年4月、当社は契約書や裁判記録、請求書、身分証明書、各種フォームまで、幅広い文書タイプ向けに光学文字認識(OCR)を最適化した専用モデル DharmaOCR-LITE をリリースしました。このモデルの基となった論文は、ドメイン特化(domain specialization)における具体的かつ厳密に検証された好例を示しています。すなわち、タスクに特化してトレーニングされた小型モデルは、特定のタスクにおいて汎用的なフロンティアモデルのAPIを凌駕できるということです。
OCRはページ上のテキストを出力し、元のレイアウトやフォーマットを忠実に再現します。契約書を最初から最後まで通読したり、手書きの原稿をデジタルアーカイブ化したりといったように、ドキュメント全体を処理することが目的であれば、まさにうってつけの技術です。
しかし、現実のビジネス現場にはこれとは全く異なるニーズが存在します。ページ全体の内容ではなく、「特定のフィールドだけを抽出し、後続システムがそのまま利用できる形式に変換したい」というケースです。例えば、請求書の明細を1行ずつのリストとして取得したい場合、検査依頼書から患者名・検査項目・日付を抽出してスケジューリングシステムに直接投入したい場合、あるいは身分証明書からデータを読み取って従業員データベースの対応するカラムに直接マッピングしたい場合などが挙げられます。
こうした文書に対して通常のOCRをそのまま実行しても、抽出されるのは行ごとに並んだテキストの塊にすぎません。どの文字列が検査項目で、どれが日付なのか、どの数値が合計金額を表しているのかまでは判別できないのです。データベースに書き込む前に、人間がコードを書いて個々の値を正しいフィールドにマッピングする作業が依然として必要になります。
現在では、プロンプトを工夫することで汎用的なフロンティアLLMでもこの作業をこなすことができます。しかし、多くの企業が抱える高頻度・大量処理が求められる業務環境において、要件が明確に定まったタスクにフロンティアモデルのAPIを利用すると、コストやレイテンシの面で過度に高価なアプローチになってしまいます。
そこで私たちは、この課題に特化した専用モデルを開発しました。このフィールド抽出モデル(Field Extractor)は文書画像を入力として受け取り、2つのモードに対応しています。「認識可能なすべての要素を抽出するモード」と、「指定された厳格なデータスキーマ(schema)に従って値を埋め込むモード」です。出力は型定義された構造化JSONデータとして返され、フィールドごとに整理されるとともに、階層構造を持つドキュメントであれば適切なネスト構造も維持されます。請求書であれば、各明細が数量や金額を含む整列済みリストとして出力され、合計金額も付与されます。身分証明書であれば、システムが求める保存用フィールドや定義済みのキー名にそのままマッピングされます。単一のモデルチェックポイントでこれらすべてのシナリオに対応でき、ドキュメントのタイプごとにファインチューニングを行う必要はありません。
こちらから実際にお試しいただけます。
モデルの機能
例えば、毎朝システムにサプライヤーからの請求書が届き、各請求書からシステムに入力すべき項目が「サプライヤー名」「請求書番号」「支払期日」「合計金額」の4つだけだとしましょう。これは、検査依頼書をスケジューリングシステムに取り込む場合や、契約書をコンプライアンス管理システムに取り込む場合とまったく同じロジックです。後者のようなケースで真に必要なのは、契約の当事者、契約期間、債務不履行条項、違約金の金額といった情報です。ページ全体のドキュメントが必要なわけではなく、必要なのは特定の