
QRコードをスキャンして量子位をフォロー
< img id=“wx_img” src=“https://www.qbitai.com/wp-content/uploads/imgs/qbitai-logo-1.png” width=“400” height=“400”>

長尺動画の記憶精度が急上昇、質疑応答の遅延は最大97%削減
允中 凹非寺より
量子位 | 公式アカウント QbitAI
openJiuwen AgentMemoryに、マルチモーダル記憶機能OmniMem-Lensが正式に実装されました。秒単位の盲目的な動画分割こそが記憶の断片化を招く元凶であり、実際の「イベント」単位で記憶することこそが正解です。リコール精度は最大**45.7%向上し、オンライン質疑応答のレイテンシは最大97%**削減されました。
すべてのAgentを悩ませる問題:3時間の動画をどう「記憶」するのか?
AIエージェント(Agent)とマルチモーダルモデル(VLM)が急速に進化する現在、私たちはAgentに単なるテキスト処理だけでなく、より高度なタスクをこなすことを求めるようになっています。
例えば、「3時間の新製品発表会をすべて視聴し、製品のハイライトをすべて抽出する」ことや、「丸一日の監視カメラ映像を分析し、異常なイベントにフラグを立てる」といった作業です。
しかし、既存のAgentが超長尺の動画を処理しようとすると、膨大な情報量が瞬時にコンテキストウィンドウの上限を超えてしまい、処理能力や精度が著しく低下してしまいます。
現在、業界で広く行われている手法は、長尺動画を一定の時間枠(例えば1分ごと)で機械的に細かく分割し、Agentに個別に記憶させるというアプローチです。
この方法はまるで「群盲象を評す」ようなものであり、Agentの記憶に2つの致命的な問題をもたらします。
① 記憶の細断——根拠の断片化
本来は一連の流れである講師の解説が途中で分断され、前半と後半がAgentによって別々に処理・保存されてしまいます。ユーザーが質問した際、Agentは文脈を無視した不完全な根拠しか取得できず、その結果、ハルシネーション(幻覚)が多発することになります。
② 記憶の希薄化——根拠の埋没
わずか数秒の決定的なアクションが、前後数分間の無関係な背景映像と無理やりひとまとめにされてしまいます。Agentが詳細を検索する際、重要な情報が大量のノイズに埋もれてしまい、リコール精度が急落します。
問題の本質は、Agentが「秒単位」で動画を記録しているのに対し、人間は「イベント単位」で動画を理解しているというギャップにあります。
例えば、昨日観た映画を思い出すとき、人は「主人公の出会い → 誤解 → 和解」といったプロットごとに記憶するのであって、ストップウォッチで60秒ごとに区切って覚えるわけではありません。しかし、現在のAgentはまさにストップウォッチを持って映画を記憶しようとしているのです。
さらに厄介なのは、市販されている動画イベント分割ソリューションの多くが、映像だけを見る、あるいは音声だけを聞くといった単一モーダルに依存している点です。しかし、どちらのアプローチも破綻しがちです。画面が長時間動かない場合、実際には話題が変わっていることに気づけず、セリフがないシーンでは手がかりを一切拾えません。
これは計算リソースの不足ではなく、記憶を分割する起点においてすでに「焦点」が失われていることが原因です。
OmniMem-Lens:Agentに人間のような「イベント単位」の記憶を
Agentに人間の脳と同じように長尺動画を処理させるため、開発チームはopenJiuwen AgentMemory 0.2.0において、**OmniMem-Lens(マルチモーダル記憶レンズ)**機能を正式にリリースしました。
AgentMemoryにおける動画マルチモーダル記憶処理のコア技術であるOmniMem-Lensは、視覚と聴覚という2つのトラックを通じて動画内のイベントを先駆的に理解し、記憶コンテンツを体系化します。これにより、Agentの動画記憶において、初めて真の「イベント単位での保存・取り出し」が実現しました。
チームはこれを、自動でピントを合わせ、階層的に整理できる「スーパー海馬」をAgentに搭載することだと位置づけています。
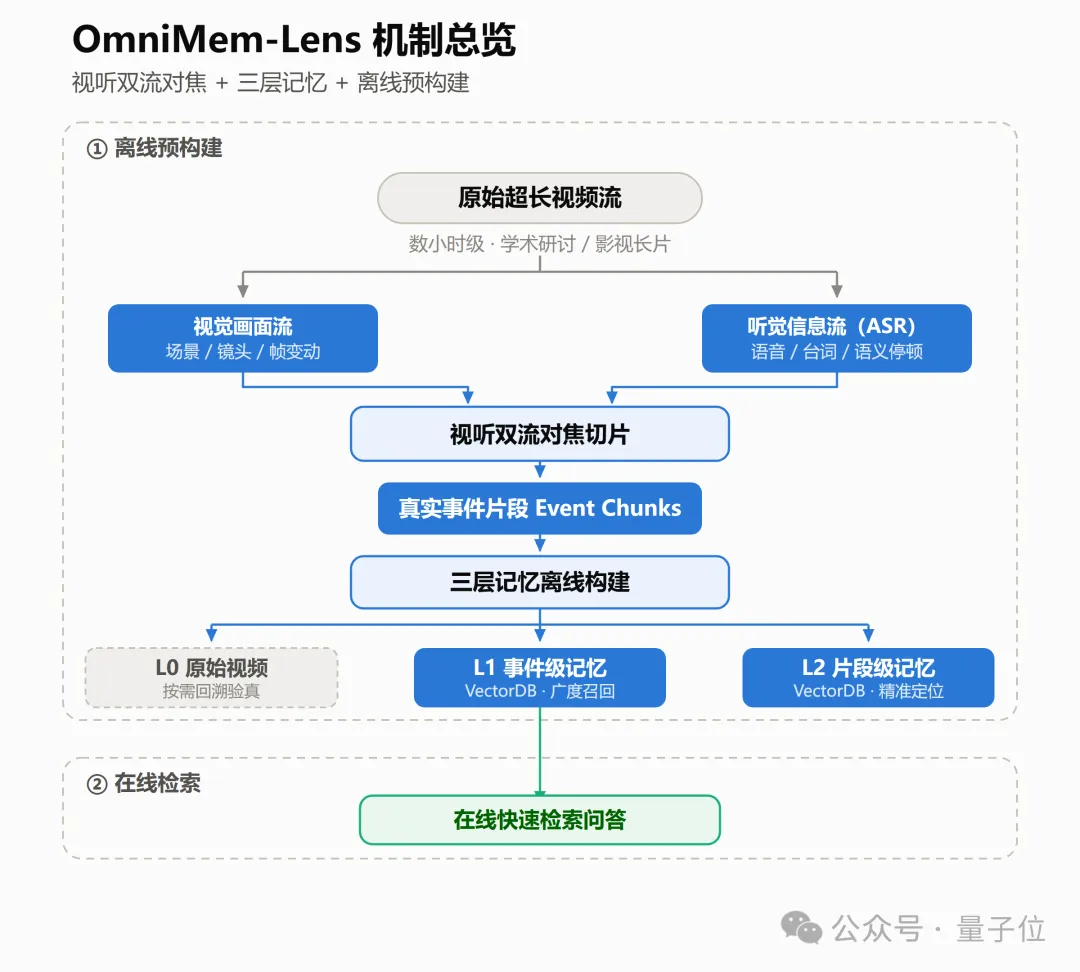
本技術が実現した3つのポイントは、「実際のイベントに沿った分割」「記憶の階層化保存」「オフライン構築とオンライン高速検索」です。
視覚と聴覚の連携:人間の脳のように、実際のイベント単位で記憶
OmniMem-Lensは、Agentに「目」と「耳」を同時に与えます。目は映像を捉え、画面の切り替わりを検知してフラグを立てます。耳は音声を聴き、画面に変化がなくても話者がトピックを変えたことをASR(音声認識)の文字起こしによって識別します。
2つの情報ソースによるクロスフォーカスにより、長尺動画は実際のイベントの境界で適切に分割され、Agentの動画理解が文脈から切り離されることはなくなります。
3層の記憶構造:粒度に応じた階層保存で、詳細の振り返りと全体把握を両立
ユーザーからの質問ごとに、必要とされる証拠の粒度は異なります。OmniMem-Lensはバックグラウンドで3層の記憶ユニットを構築します。
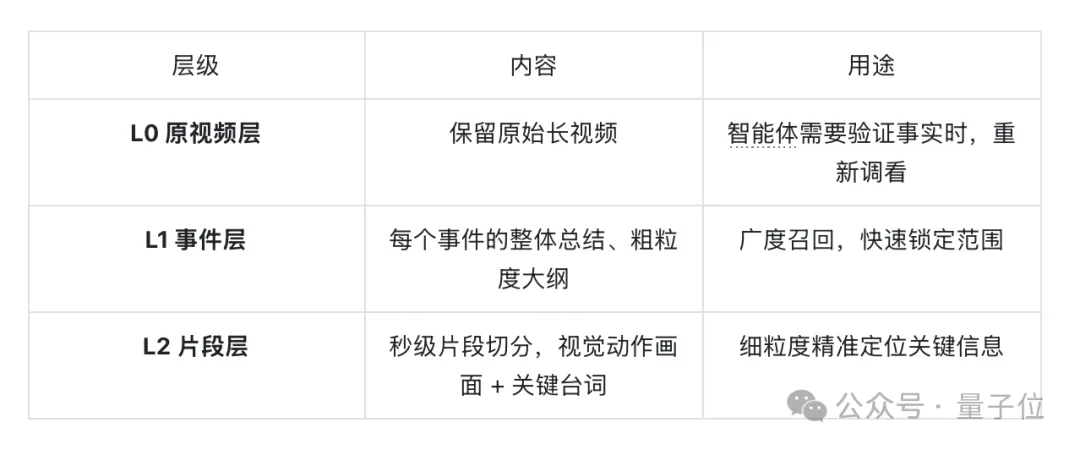
概要から詳細まで網羅されており、検索時には必要なレベルの情報を互いに干渉することなく取得できます。
目次と索引が付いた本をイメージしてください。目次(L1)は大まかな章を探すのに役立ち、索引(L2)は特定のフレーズを特定するのに役立ち、原文(L0)はいつでも振り返って検証できます。
また、L1とL2の記憶ユニットは完全にテキスト化およびベクトル化されており、主要なベクトルデータベースとシームレスに連携できます。既存のRAG/Agent技術スタックを持つ開発者にとって、ほぼ改修なしで導入が可能です。
記憶はオフラインで構築、回答はオンラインで検索:重い処理は事前に行い、ユーザーには高速なレスポンスを提供
アプローチの異なる質問が来るたびに、Agentが数時間の動画を最初から見直していては、応答が極めて遅くなるだけでなく、膨大な計算リソースを消費してしまいます。
OmniMem-Lensは、負荷の大きな記憶整理タスクを事前にオフラインで完結させます。質問を受けたAgentは記憶を直接参照するだけでよいため、秒単位のレスポンスで的確に回答できます。
オンライン検索のフローは非常にシンプルです。ユーザーのQueryはまずL1/L2の記憶ユニットとセマンティックマッチングを行い、洗練されたマルチモーダル記憶を素早く特定します。視覚的な詳細検証が明確に必要な場合にのみ、システムはL0層から正確な動画フレームをオンデマンドで取得します。この「軽量なテキストインデックス+必要なときのみ元の動画を取得」というアーキテクチャにより、動画記憶の検索効率が劇的に向上しました。
OmniMem-Lensの設計思想は、プロ用カメラのようにイベントの境界をデュアルフォーカスで捉え、プリズムのように記憶構造を階層的に屈折・整理することにあります。これにより、長尺動画に対するAgentの理解は、機械的な分割から精密な透視へと進化します。
実測データ:精度は全面的にリード、遅延は最大97%削減
実力を証明するには、データを示すのが最も確実です。チームは3つの主要な長尺動画QAベンチマークを選定し、OmniMem-LensとQwen3-VL-8Bモデルを組み合わせた動画記憶QAと、VLMモデルであるQwen3-VL-8Bを直接使用した動画QAとの比較検証を行いました。
以下の表の要点:
「リコール精度」が高い=見つけ出した根拠がより正確
「オンライン遅延」が低い=回答までの待ち時間がより短い
① 記憶のリコール精度:3つの評価データセットで全方位リード
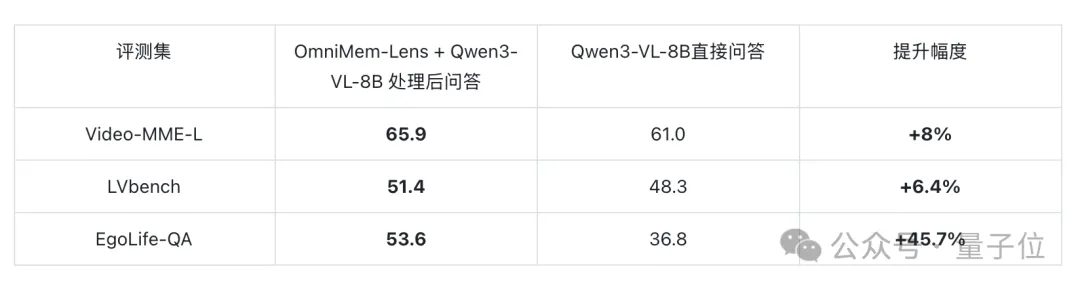
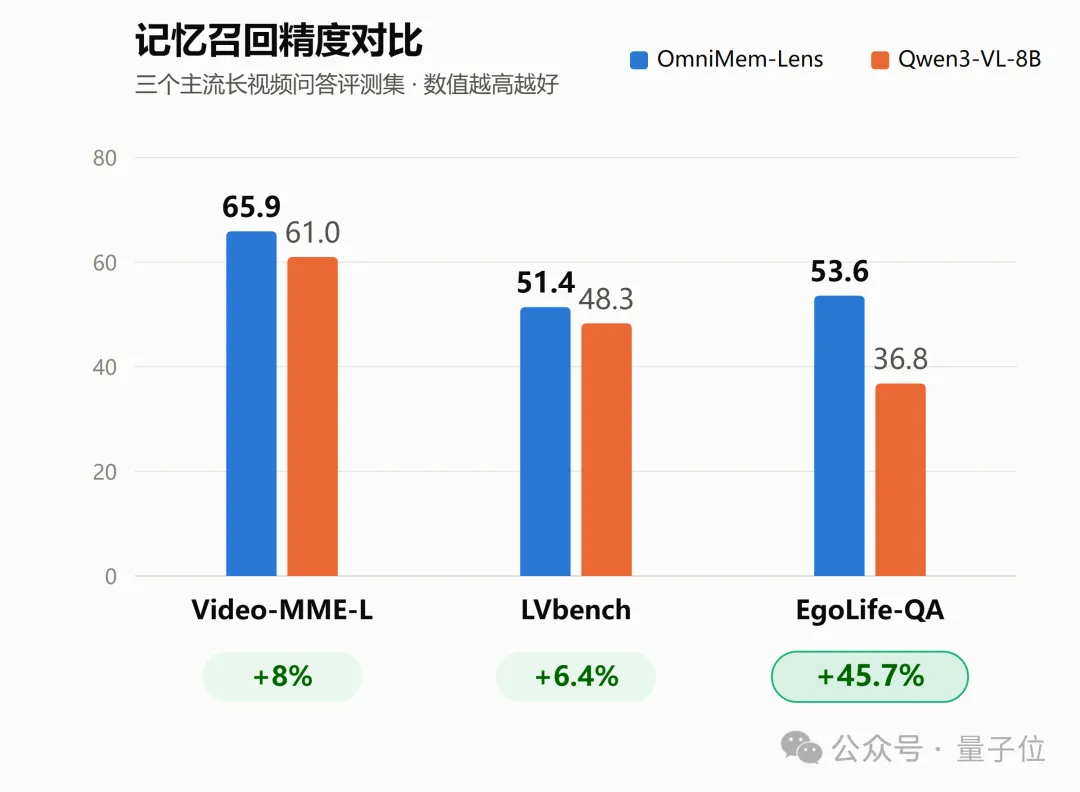
汎用的な長尺動画ベンチマークVideo-MME-Lで8%、長尺動画理解ベンチマークLVbenchで6.4%向上しました。
最も際立っているのは**EgoLife-QAにおける+45.7%**の改善です。このベンチマークは一人称視点で丸一日の日常生活を記録したもので、イベントが密集し細かなディテールが多く含まれます。まさに固定分割が破綻しやすく、「実際のイベント単位で記憶を整理する」価値が最も発揮されるシナリオです。
② オンライン質疑応答の遅延:「動画を見直す」から「記憶を直接引く」へ
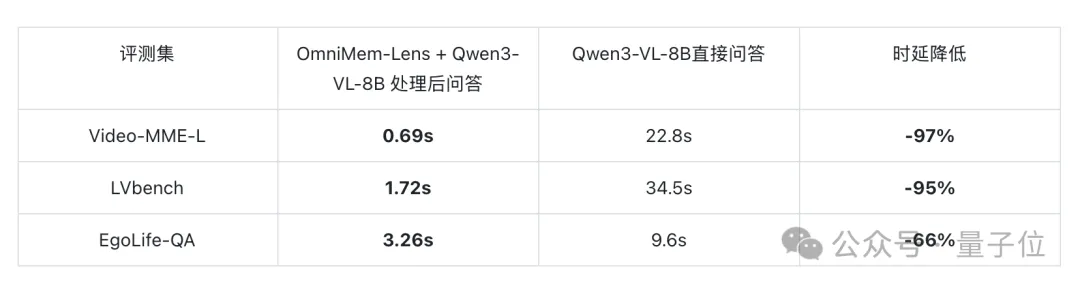
動画が長くなるほど、VLMが直接回答する際に読み込むべきフレーム数が増加し、遅延も長くなります。LVbenchにおいてQwen3-VL-8Bは34.5秒の待機が必要でしたが、OmniMem-Lensはわずか1.72秒で完了し、実に20倍の高速化を達成しました。
日常生活に例えるなら、VLMの直接回答は、質問されるたびに3時間の映画を最初から最後まで見直してから答えるようなものです。一方、OmniMem-Lensは、映画鑑賞時にすでにノートを取っている映画評論家のようなもので、聞かれた場面のノートをめくって即座に回答します。
2つの具体例:「焦点のブレた盲目的分割」と「正確な透視」の差
事例1:因果関係の分断
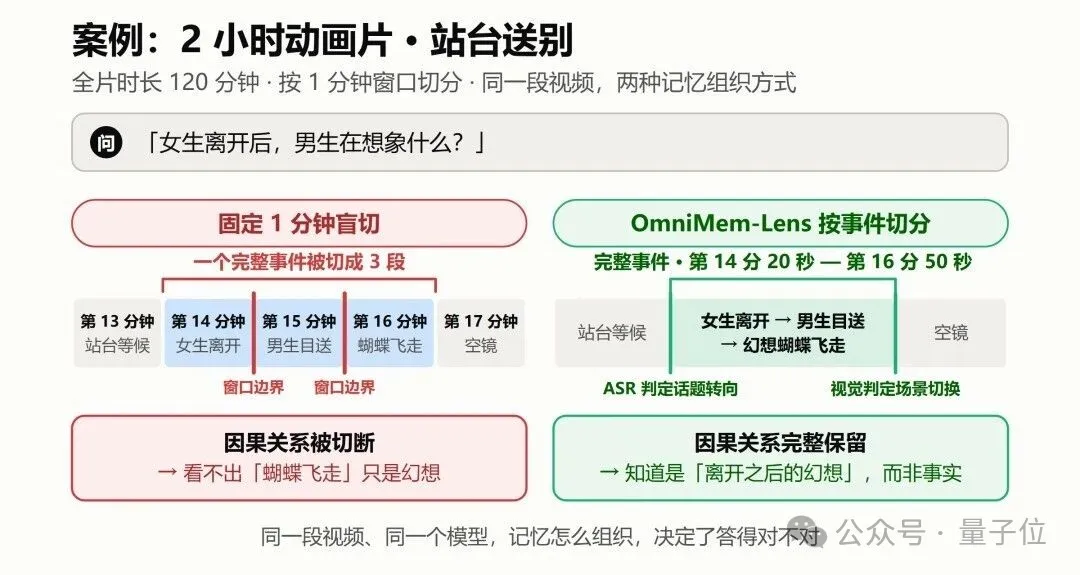
2時間のアニメ映画を例にとります。駅のホームで少女が立ち去り、少年が見送ります。少女が去った後、少年は彼女が蝶になって飛び去る幻想を抱きます。
固定の1分間分割では、この120分の動画を120個のクリップに細切れにします。しかし、「少女の立ち去り → 男年の見送り → 蝶の幻想」という一連のイベントは、14分20秒から16分50秒にかけて発生しており、第14、15、16ウィンドウの境界によって2箇所で分断されてしまいます。
その結果、断片は互いに無関係な3つの記録になってしまいます。14分目「少女が立ち去る」、15分目「少年が見送る」、16分目「蝶が飛び去る」。
ユーザーが「少女が去った後、少年は何を想像していましたか?」と質問した際、検索されたクリップには「少年の見送り」と「蝶の飛翔」しかなく、その蝶が単なる幻想であることを示す手がかりが一切残りません。その結果、Agentはそれを現実に起きたことと誤認し、的外れな回答をしてしまいます。
一方、OmniMem-Lensはこのイベントを1つのまとまり(14分20秒〜16分50秒)として記憶に保存します。ASRストリームが話題の転換を聞き取り、視覚ストリームがシーンの切り替わりを捉え、両方のフォーカスが合致した境界で適切にカットします。「少女が去った後に幻想を抱く」という因果関係が完全に保たれるため、現実と幻想が明確に区別され、正確な回答が可能になります。
同一の動画であっても、記憶の整理方法の違いが「答えられない」と「的確に答えられる」の決定的な差を生み出します。
事例2:静止画面では「耳」が鍵を握る
上記の例は視覚的な手がかりでも解決の糸口があります。しかし、次のシナリオでは目だけでは不十分です。
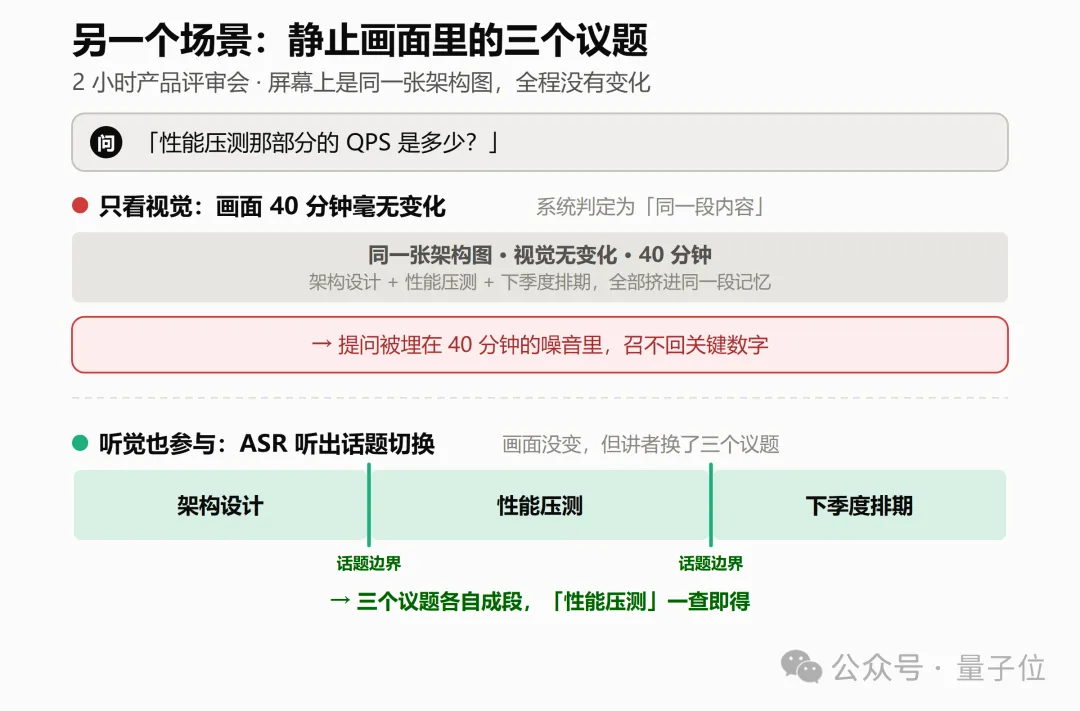
2時間にわたる製品レビュー会議で、画面には40分間にわたり全く同じシステム構成図が表示され続けていました。しかし、この40分の間に、登壇者は「アーキテクチャ設計」「負荷テスト」「次期スケジュールの調整」という3つの独立したテーマを順に説明していました。
視覚のみに頼る手法(および固定ウィンドウ分割)では、「静止画像が40分間継続している」と認識され、同じセグメントと判定されて3つのテーマが単一の記憶にまとめられてしまいます。ユーザーが「負荷テストのセクションでのQPSはいくつか?」と尋ねても、重要な数値が40分間のノイズの中に埋もれてしまい、適切に取得できません。
OmniMem-LensのASR音声ストリームは、画面に変化がなくても登壇者が話題を変えたことを検知できます。音声の内容が切り替わった瞬間にセグメントが分割され、3つのテーマが個別のブロックとして保存されるため、質問に対してピンポイントで回答を引き出すことができます。
これこそが視覚・聴覚のデュアルストリームの強みです。視覚が機能しないときは聴覚が補い、聴覚が機能しないとき(セリフのないカメラアングルの切り替えなど)は視覚が補います。単一の手段では見落としが生じますが、2つのアプローチを交差させることで信頼性が担保されます。
WorkSwarmはまもなくopenJiuwen AgentMemoryとの連携に対応し、日常の会話に含まれる動画コンテンツを記憶し、議論の際に素早く思い出すサポートを行う予定です。
おわりに
Agentが真に人間に代わって複雑なタスクをこなすためには、優れた「実行力」だけでなく、優れた「記憶力」が不可欠です。
OmniMem-Lensは、Agentに「実際のイベント単位での記録」と「階層化による高効率な検索」をもたらすことで、長尺動画シナリオにおけるAgentの記憶の断片化、検索精度の低さ、応答の遅さという課題を解決しました。マルチモーダルAgentのために高精度かつ超高速レスポンスを実現する記憶基盤を構築し、長尺動画を前にしても「一度見たら忘れず、淀みなく受け答えできる」状態を実現します。
OmniMem-LensはopenJiuwen AgentMemory 0.2.0において正式に利用可能となっています。ぜひ体験や開発へのご参加をお待ちしております。
この記事が役に立ちましたら、ぜひいいね、お気に入り、シェアをお願いします。また、コメント欄で「あなたのAgentは長尺動画の記憶をどのように処理していますか?」についてもぜひご意見をお聞かせください。
プロジェクトURL:https://gitcode.com/openJiuwen/agent-memory/
*本記事は量子位が許諾を得て掲載したものであり、見解は原作者に帰属します。
著作権は所有者に帰属します。無断での転載および使用を禁じます。違反した場合は法的責任を問われることがあります。
- Xiaomiが150元のAIガジェットをオープンソース化、人気沸騰でパーツまで値上がり2026-11-02
- 19プロジェクト中18件が成功、6つのGPCRターゲットを全てヒット!国産AI創薬が技術の限界を再び打破2026-10-28
- 中国AIがNVIDIA GPUの性能ランキングを席巻、ある企業が88項目で首位を獲得2026-10-28
- フィジカルAIはいかにして現場へ浸透するのか?Unitreeエコシステムカンファレンスが示した答え2026-10-26
QRコードをスキャンしてモーメンツで共有
関連記事
@CEO、あなたの次の専属秘書は必ずしも人間である必要はない
ローカル展開、即座に利用可能
聞楽2025-09-17
わずか4ステップで独自Agentを構築!達摩院の新オープンソースフレームワークは初心者でも利用可能
オープンソースLLMをコアコンポーネントに採用
白交2023-09-16
Auto Research時代、模範解答のない47のタスクがAgent能力の必須ベンチマークに
本格的な「反復的最適化」時代へ突入
鄧思邈2026-05-13
AI主導のもと、ブランドの質の高い成長が打開の鍵に丨Alimama未来商業賞の授賞式が閉幕
AI時代において、あらゆるカテゴリーは再構築する価値がある。
量子位2025-03-20
北京は「Agentはすでに世界を作れる」と語り、杭州は「発明されたばかりの電球にすぎない」と語る
産業界と学術界の意見の相違
十三2026-07-25
エビ養殖時代は終わり?デプロイ不要・24時間365日稼働・自己進化する「サイバーラバ」が登場!
エビを育てるよりラバを飼う時代へ
夢瑶2026-03-16
人気記事
首位の座を奪取!Agibotのデュアルモデルが多数のランキングを総なめに 2026-10-30
人工知能の最新トレンドを追い、テック業界の新たなブレイクスルーを報道
量子位 QbitAI All Rights Reserved © 北京極客伙伴科技有限公司 京ICP備17005886号-1