
2026年7月30日、Transformers は T5 において PyTorch の Scaled Dot-Product Attention(SDPA)を有効化しました。その副作用として、UMT5 のデコーダーが未来のトークンを参照(attend)できるようになってしまいました。学習中、本来予測すべき正解を「カンニング」できてしまう状態だったのです。クラッシュやエラーが発生しなかったため、このバグは main ブランチに2か月近く潜伏することになりました。
後にこれらのコミットをリプレイ検証したところ、CPU 上で動作する小型の UMT5 モデルは、すべてのコミットにおいてこの問題を検出していました。本記事では、このモデルとそれを取り巻くテスト体系について紹介します。
なぜバグが main ブランチに混入するのか
Transformers は750種類以上のモデルタイプをサポートしており、そのテストスイートは非常に大規模です。main ブランチには88,000件以上の CPU テストがあり、日次の定期実行ではさらに200,000件以上の GPU テストが走っています。 モデルのテストはその一部にすぎず、パイプライン(pipelines)、学習(training)、分散実行、量子化、アテンションカーネル(attention kernels)などのテストも行っています。
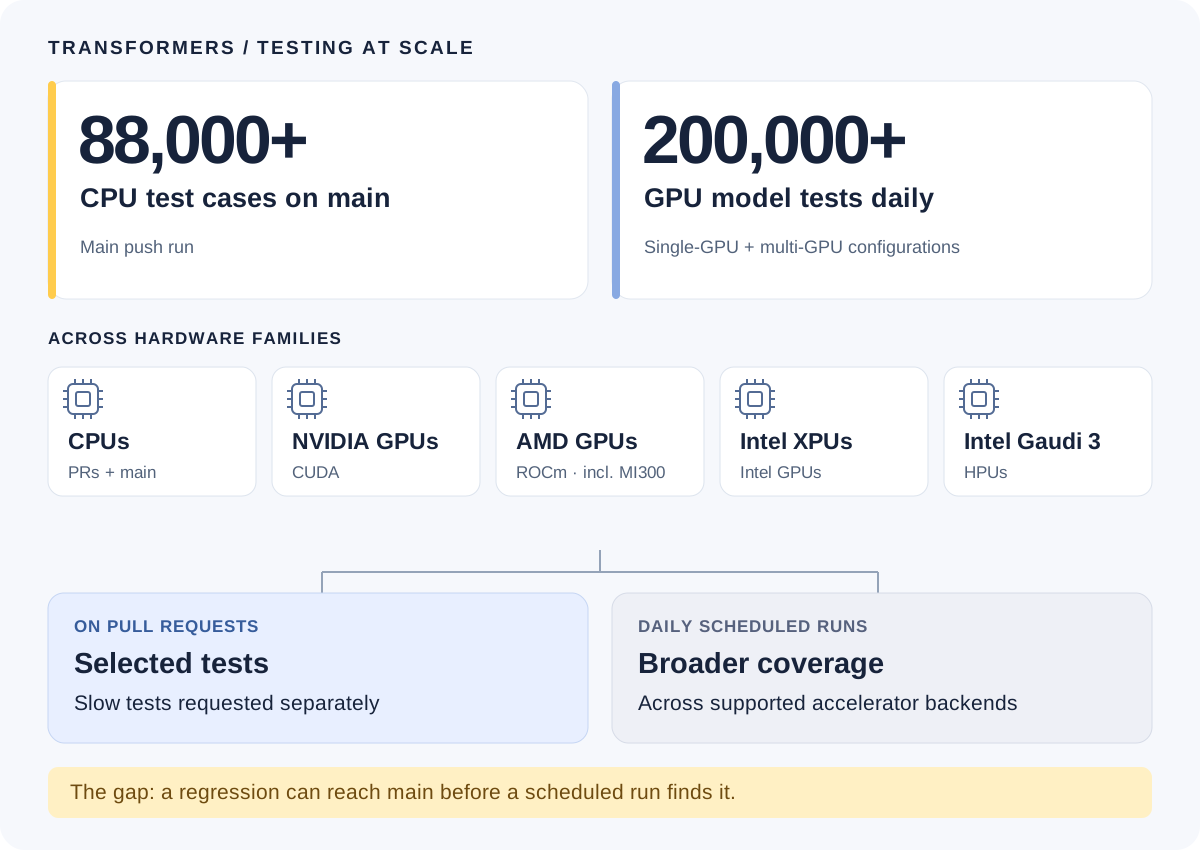
統合テストでは、実際のチェックポイントをロードし、実機ハードウェア上でモデルの API を呼び出して検証を行います。しかし、すべての PR(Pull Request)でフルテストスイートを実行することは、終日膨大な GPU を占有することを意味し、現実的ではありません。そして、定期実行ジョブがリグレッション(regression)を検知したときには、すでに main ブランチへマージされてしまっている可能性があります。
そこで私たちが取ったアプローチが、モデルの縮小(ダウンサイジング)です。私たちは**テストフィクスチャ(fixture)**を構築しました。これは実際のチェックポイント構成に基づいて作られた小型モデルであり、層数が少なく幅(hidden size)も狭いものの、元のモデルが持つすべてのレイヤータイプを保持し、トークナイザーやプロセッサーファイルもそのまま維持されています。一度公開すれば何度でも再利用可能です。このフィクスチャに対して、低コストな CPU ランナー上で「高速な統合テスト」を実行します。私たちの CPU に関する調査 では、実験的な UMT5 フィクスチャの重みサイズはわずか 66 MB でした(元のチェックポイントは 1,227 MB)。
これは超巨大モデルにも適用できます。標準的な GPU ランナーには収まらないモデルであっても、そのフィクスチャであれば CPU 上で動作させることができます。
モデルのインテグレーターは、これまでも小型のテスト用モデル(Transformers の tiny-random-* チェックポイントなど)を作成してきました。しかし私たちは、「単にモデルをロードしてフォワードパス(forward pass)を実行するだけ」にとどまらない検証手段を備えた、汎用的なソリューションを求めていました。なぜなら、UMT5 の例のバグはフォワードパスを何の問題もなくパスしてしまうからです。
フィクスチャは完全な統合テストを完全に置き換えるものではありませんが、PR の段階でバグが main ブランチにマージされる前にキャッチするチャンスを与えてくれます。
モデル統合コントラクト(Model Integration Contracts)の導入
transformers-mic は、こうしたテストをパッケージ化するための標準提案です。モデル統合コントラクト(Model Integration Contract、略称 MIC)は、次の3つの要素で構成されています。
- fixture: 前述の縮小版モデル。一度公開され、バージョンが固定(ピン留め)される
- 使用パターン(usage path): ユーザーがモデルに対して行う一般的な操作(テキスト生成や1ステップの学習など)を示す、実行可能な Markdown サンプル
- ベースライン(baselines): そのサンプルを実行した際に記録され、人間によってレビューされた出力結果
フィクスチャ上でその使用パターンを実行し、同じベースラインデータが再現されれば、コントラクトが成立している(満たされている)と判断できます。
1つのコントラクトは、単一のチェックポイントではなく、1つのアーキテクチャと1つの使用パターンを対象とします。互換性のあるチェックポイント同士は1つのフィクスチャを共有しつつ、それぞれ期待される結果を個別に保持できます。これらは huggingface-mic で公開しています。
例えば、SmolLM のコントラクトでは「The capital of France is」といったプロンプトを用いて生成を行い、そのトークン ID を記録済みの回答と照合します。モデルとトークナイザーをロードした後の生成コード(単一プロンプト用に簡略化)は以下のようになります。
inputs = tokenizer("The capital of France is", return_tensors="pt")outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)new_tokens = outputs[:, inputs["input_ids"].shape[1]:]print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))さらに、トレーニング損失(training loss)の比較、勾配が有限値(finite)であるかのチェック、オプティマイザのステップ(optimizer step)によって重みが更新されているかの検証なども行います。詳細は usage.md をご参照ください。
Hub 上の fleet データセット は、各 MIC を固定された特定のリビジョン(revision)に紐づけ、ベースライン記録時に使用された依存パッケージのバージョンも記録します。CI の各実行でも使用した fleet のバージョンが記録されるため、後から確実に再現することが可能です。
PR では、差分によって変更されたファイルに基づいて、実行すべき MIC をフィルタリングして決定します。
UMT5 のリグレッション
私たちは Transformers の過去5か月分のコミットに対して、固定された MIC をリプレイ実行しました。この小型の UMT5 フィクスチャは、2026年7月30日にリグレッションが混入したコミットから、それが修正されるまで一貫してエラーを報告し続けました。