
📄 テクニカルレポート | 🤗 データセット | 💻 コード
私たちは、長文脈状態追跡(long-context state tracking)のためのベンチマークである StateBench を公開しました。これは、長大なドキュメントの進行に伴い、作中のエンティティに関する情報の変化を言語モデルがどれだけ追跡し続けられるかを評価するベンチマークです。
状態追跡は、コード内の変数の代入や名前変更の把握から、物語の中で登場人物が移動したりアイテムが手渡されたりする流れの追跡に至るまで、数多くのタスクの基盤となっています。例えば、ある推理小説で殺人事件が起きる前に「ジョンがナイフをメアリーに渡した」と書かれていた場合、各登場人物の状態の変化を正確に把握しておくことが極めて重要になります。しかし、すべての状態追跡タスクが同じ難易度というわけではありません。最新の更新を1回見つけ出すだけで済むものもあれば、より難易度の高いタスクでは長い変化の連鎖を追跡する必要があり、たった1つのステップを見落としただけで最終的な答えを誤ってしまうこともあります。例えば、上記の推理小説のより難易度の高いバリエーションとして、「エドワードがジョンのリュックにナイフを入れた後、ジョンがそのリュックの中身をメアリーに手渡した」という状況の追跡が挙げられます。
長い依存関係の連鎖を伴う複雑な状態追跡において、Transformer アーキテクチャには理論的に証明された限界が存在します。この限界を克服すべく、実行中のメモリを前方に伝達し続けられる Gated DeltaNet のような、再帰型(recurrent)やハイブリッド型のアーキテクチャが誕生しました。既存の状態追跡ベンチマークは極端に難易度が高いケースに偏りがちですが、こうした新しいアーキテクチャ設計が普及するにつれて、研究者は各アーキテクチャが具体的にどのタイプの状態追跡に対応できるのかを明らかにする必要があります。最も困難な状態追跡タスクにおける挙動の差異だけでなく、より単純で日常的に現れやすいタスクにおける各アーキテクチャの性能を把握することも不可欠です。
そこで私たちは、さまざまな複雑さの状態追跡タスクを網羅する StateBench ベンチマークを開発し、異なるアーキテクチャを持つ言語モデル間の性能差を検証しました。その結果、これらのタスクで直接訓練された再帰型やハイブリッド型のモデルは、Transformer を大きく上回る汎化能力を発揮することがわかりました。一方で、Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna などのフロンティアモデルであっても、入力が長くなるにつれて、より複雑な形式の状態追跡では破綻をきたしてしまうことが明らかになりました。
状態追跡の4つのレベル
StateBench は4つの難易度レベルで構成されており、徐々に複雑さを増す状態更新操作を扱います。プログラマーの視点で見れば、これらの状態追跡の複雑さのレベルは、サポートされる変数代入操作の違いとして捉えることができます。
-
R自明な問題(R-trivial problems):イミュータブルな代入(immutable assignment)を用います。変数の値は決して変更されないため、モデルは最初に代入された値を特定するだけで済みます。コードで言えば
let x = 4;のようなものであり、実生活に例えるなら変更されることのない生年月日のようなものです。 -
非周期問題(Aperiodic problems):値による再代入(reassignment by value)を許容します。モデルは最新の値を見つけ出す必要があり、それ以前の古い値は無視できます。コードでは
x = 4の後にx = 2を実行するようなものであり、実生活に例えるなら最新の設定値が現在の温度を決めるサーモスタットのようなものです。 -
可解問題(Soluble problems):自己参照型の更新(self-referential updates)が加わります。各更新は現在の値に基づいて行われるため、モデルは単に最新の代入を探すだけでなく、変更を順次フォワードしていく必要があります。コードでは
x = x + 5のようなものであり、実生活に例えるなら得点が入るたびに現在の合計スコアへ加算されていくゲームのスコアのようなものです。 -
一般有限問題(General finite problems):参照による代入(assignment by reference)が加わります。ある変数が別の変数の現在の値を取得できるため、異なる更新処理の間に依存関係が生まれます。コードでは
x = yや2つの変数の値の入れ替えに相当します。マジシャンが5つのカップのいずれか1つの下にボールを隠し、カップの位置を次々と入れ替える場面を想像してみてください。ボールを見つけるには、それらの入れ替え操作によってボールの位置がどう変化したかを逐一追跡し続けなければなりません。これこそが、5つのオブジェクトが連続したスワップによってどのように並び替えられるかを追跡する $S_5$ 状態追跡問題の本質です。これは4つのレベルの中で最も難易度が高く、状態追跡の限界に関する先行研究でも議論されてきました。
これらのレベルは、変数代入という観点から直感的に理解できるだけでなく、クローン・ローズ理論(Krohn–Rhodes theory)に裏付けられた、理論的根拠のある状態追跡の分類でもあります。代数学のこの分野では、状態追跡問題(有限モノイド上の語の問題(word problems over finite monoids)として見なせるもの)をどのように基本単位(原子的なプリミティブ)へ分解できるかを説明します。本ベンチマークの各レベルは、異なるプリミティブの集合から構築できる状態追跡問題のクラスにそれぞれ対応しています。
これら4つのレベルを公平に比較するため、私たちは変数代入を含む1つの一般有限シーケンスから出発し、そこから3つの簡略化バージョンを派生させることで、難易度レベルごとに1つずつ、計4つの比較可能な StateBench 問題を生成しました。これら4つの問題は、変数の数、使用される値、およびシーケンス内で代入が発生する位置がすべて同一であり、異なっているのは代入のタイプのみです。
主な検証結果
事前学習済みモデル
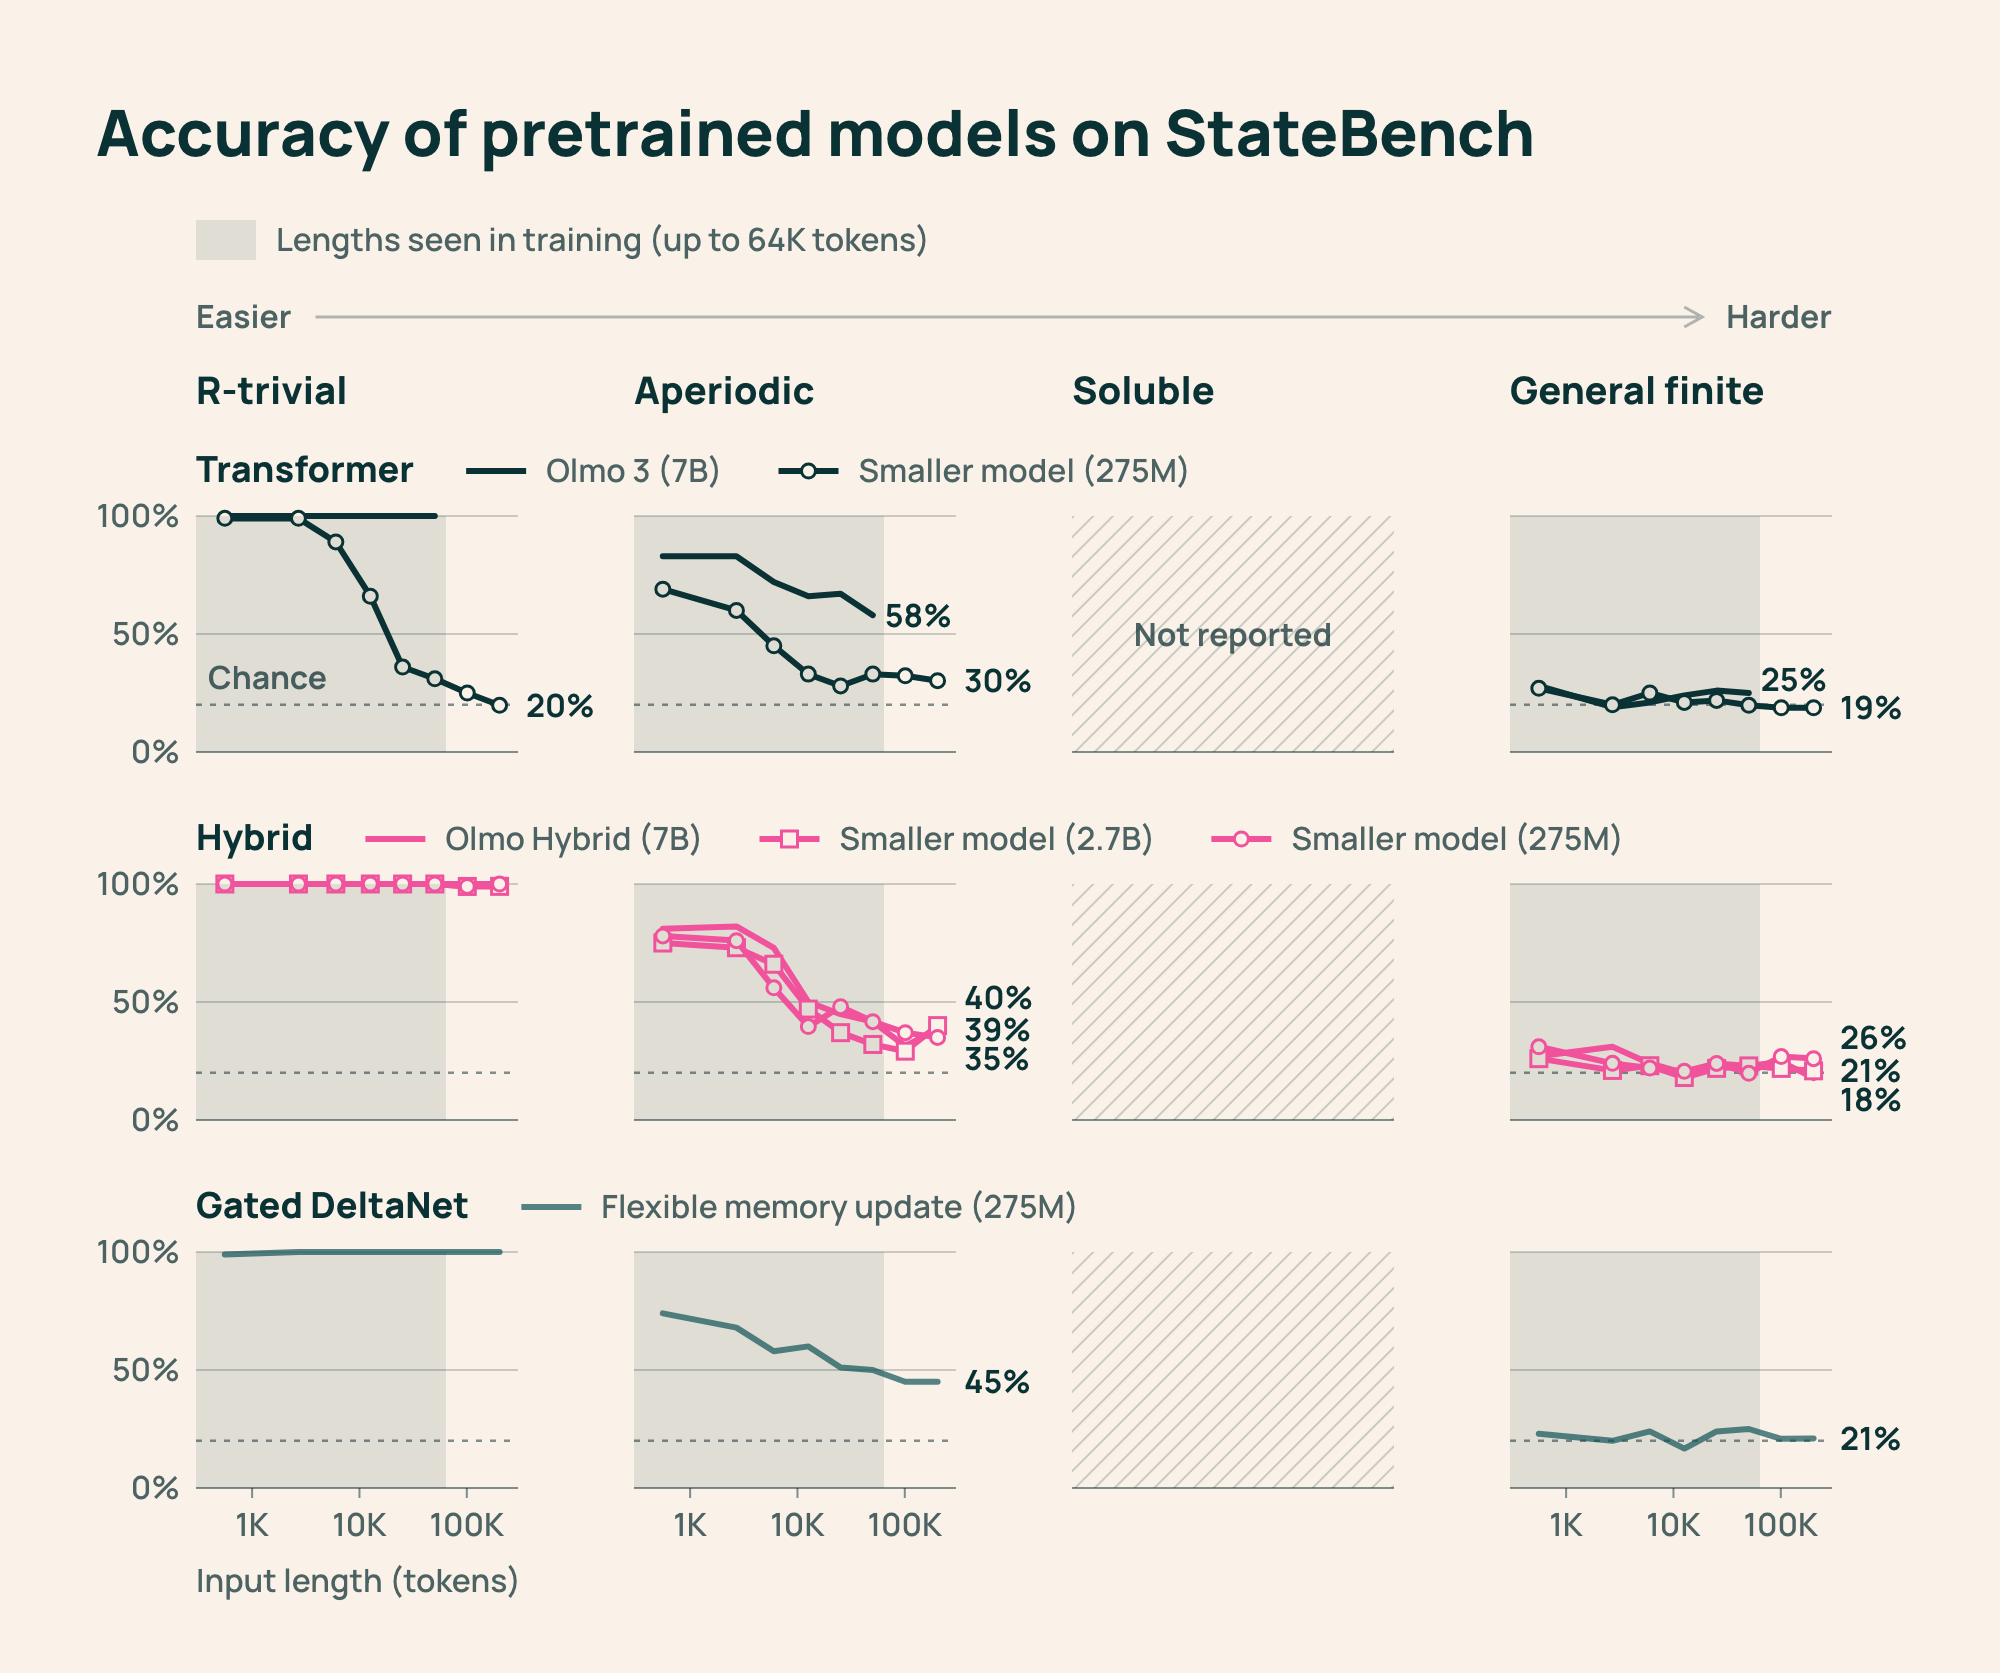
私たちは、オープンソースの一連の事前学習済みモデルを StateBench の「R自明」「非周期」「一般有限」の各レベルでテストし、どの段階で状態追跡が破綻するのか、またアーキテクチャごとの挙動が理論的な予測と一致するのかを検証しました。標準的な理論的仮定の下では、Transformer はR自明な問題を堅牢に処理でき(可解問題や非周期問題もある程度は対応可能)、一般有限問題では破綻すると予想されます。対照的に、より柔軟なメモリ更新メカニズムを備えた Gated DeltaNet は、原理上4つのレベルすべてに対応可能です。
まず、訓練データとコンテキスト長が完全に公開されているオープンソースの事前学習済みモデルをテストしました。これには、Olmo 3(Transformer ベース)と Olmo Hybrid(Gated DeltaNet 層を組み込んだもの)という2つの70億(7B)パラメータモデル、および2億7500万(275M)と27億(2.7B)パラメータの小型モデルが含まれます。これらのモデルはすべて同じデータで事前学習されており、学習時にはどのモデルも64,000トークンを超えるコンテキストに接していませんが、今回のテストでは大半のモデルに対してその長さを大幅に超える入力で評価を行いました。
各モデルの評価結果から、ほぼすべてのモデルがR自明な問題では良好なパフォーマンスを示すものの、入力が長くなるにつれて非周期問題での正解率は徐々に低下し、一般有限問題では終始ランダムな推測と同水準にとどまることがわかりました。また、問題の提示フォーマットが結果に決定的な影響を与えています。2億7500万パラメータのハイブリッドモデルや Gated DeltaNet モデルは、RULER スタイルのR自明問題では満点に近いスコアを記録したものの、同じ問題をスプレッドシートの編集という形式で表現すると、正解率はランダム水準近くまで急落しました。こうした乖離が生じることこそが、StateBench が同一の基底問題を複数のフォーマットでテストする理由の1つです。
フロンティアモデル
続いて、Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna の4つのフロンティアモデルをテストし、変数代入シーケンスを読み取らせた上で、各変数の最終的な値を出力させました。
4つのモデルはいずれも、R自明な問題と非周期問題では良好なパフォーマンスを維持しました。しかし、可解問題と一般有限問題では入力長の増加に伴って正解率が急激に低下し、最も長い一般有限問題では13%以下にまで落ち込みました。この要因の1つとして考えられるのが感度(sensitivity)です。これら高難度のレベルでは、最終的な答えに影響を及ぼすステップ数が格段に多くなるため、途中の更新を1つでも見落としてしまうと、正しい結果を導き出すための許容マージンがほとんど残らないことになります。