
GPT-6 Astra が、小型モデルの重み(ウェイト)を直接読み取り、編集できるようになりました。
MIT が行ったある実験が、LLM コミュニティに大きな衝撃を与えています。
パラメータ数 0.8B の「源神」こと Qwen3.5 を Astra に渡し、そのわずか 0.016% の重みを変更しただけで、モデルの性能が劇的に向上したのです。
この全プロセスにおいて、再トレーニングはもちろん、勾配降下法すら一切行われていません。
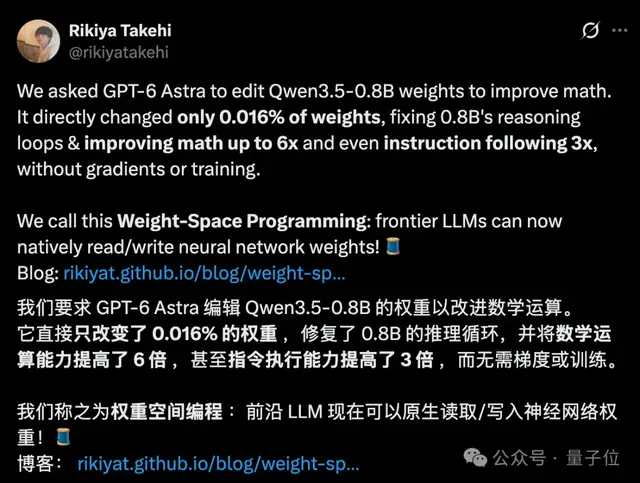
まったく同じサンプリング設定の下で、MATH-500 のスコアは 7.9% から 48.1% へと急上昇し、数学的推論能力は元の約 6倍 に達しました。
さらに、最適化を求めていなかった指示追従能力までもが、同時に 3 倍に向上しました。
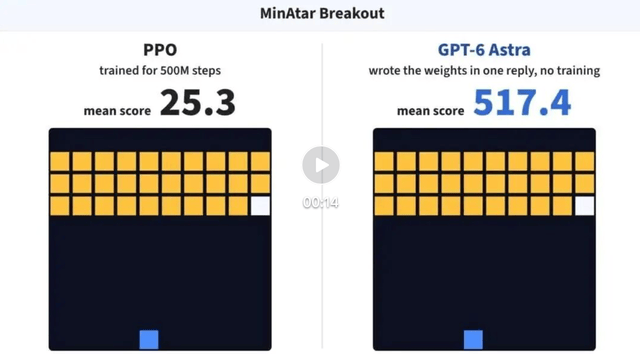
既存モデルの修正にとどまらず、Astra に小型ゲーム用ネットワークの重みをゼロから記述させた結果も同様に目覚ましいものでした。
たった 1 回の応答で出力された重みだけで、テストスコアは 5 億ステップ訓練された PPO ベースラインモデルの 20 倍以上を記録したのです。
動画リンク:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
研究チームはこの手法を次のように名付けました。
Weight-Space Programming(重み空間プログラミング)。
Astra によるモデル重みの大幅改変
簡単に言えば、この手法は大規模モデルにニューラルネットワークの静的な重みを直接分析させ、その機能メカニズムや欠陥を自律的に判断させたうえで、要求に応じてピンポイントで修正を行わせる、あるいはゼロから全く新しいネットワークを構築させるというものです。
具体的なプロセスとして、まずは最も直感的な Qwen の実験 を見てみましょう。
研究チームは、Qwen3.5-0.8B のすべての重みを含む Python 環境を Astra 用に用意し、「モデルの数学能力を可能な限り高めること」という極めて明確な要求を提示しました。
通常、モデルのトレーニングでは出力と正解ラベルの差から損失(Loss)を計算し、誤差逆伝播(バックプロパゲーション)によって勾配を求め、オプティマイザがパラメータを更新します。
しかし今回、どのパラメータを修正し、どのような修正戦略を採用するかは、完全に Astra 自身の分析によって決定されました。
分析の結果、この小型モデルの数学的パフォーマンスが推論の無限ループによって大きく損なわれていることが判明しました。
問題を出されると、モデルは似たようなテキストを繰り返し生成し続け、いつまでも答えを出せなくなっていたのです。初期の 96 回のテスト回答のうち、実に 85 回が 32,768 トークンの上限まで走りきってしまっていました。
実際、この問題は Qwen 公式のモデルカード(Model Card)でも言及されていました。
Astra はこの不具合の兆候をレイヤーごとに追跡し、最終的にループの根本原因を**フィードフォワードネットワーク(FFN)**に特定。第 15 層と第 19 層の各 64 個の出力チャネルにおいて、関連する重みの数値的な影響を精密に修正しました。
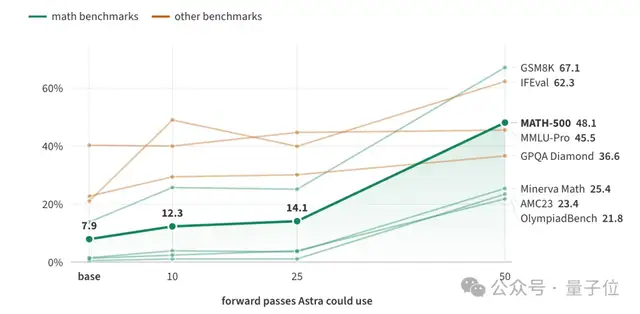
その結果、MATH-500 のテストでトークン上限に達する割合は、93.0% から 33.1% へと激減しました。
研究チームはさらに、Astra に対して 10 回、25 回、50 回のフォワードパス(順伝播)による評価バジェットをそれぞれ設定したところ、修正後のモデルの MATH-500 スコアはそれぞれ 12.3%、14.1%、48.1% に達しました。
注目すべきは、Astra が省略したのはバックプロパゲーションと勾配トレーニングであり、モデル内部の診断や推論検証のプロセスはそのまま完全に維持されているという点です。
では、静的な重みだけから、どのようにしてこれらの手がかりを見つけ出したのでしょうか?
まずは、その「重みの読み取り」能力を見てみましょう。
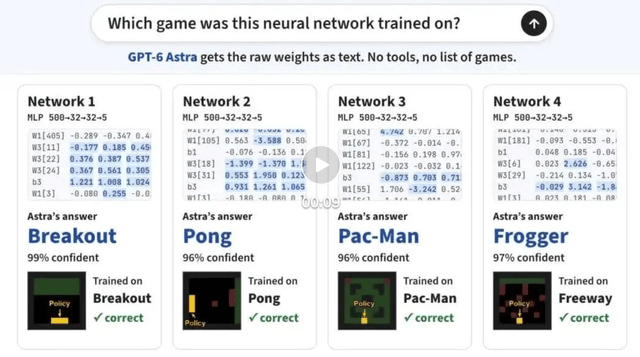
研究チームは、それぞれ異なるゲームをプレイする 4 つの小型ニューラルネットワークをトレーニングし、その生の重みをテキスト形式で Astra に入力しました。これら 4 つのネットワークは、モデルアーキテクチャ、入力チャネル、アクション空間が完全に同一です。
その結果、Astra は対応する 4 つのゲーム(ブロック崩し『Breakout』、ピンポン『Pong』、パックマン『Pac-Man』、ハイウェイ『Freeway』)を正確に識別しました。
動画リンク:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
ブロック崩しを例にとると、Astra は主に重みパラメータの空間的なクラスタリング位置を分析することで、該当する結論を導き出しました。
画像生成を行う拡散モデルに対しても同様で、モデルの重みから円、四角、三角といった幾何学的特徴を認識することができました。
ただし、局所的な細部においてはわずかなズレも見られました。元のネットワークが実際に生成したのは塗りつぶされた図形であったにもかかわらず、Astra はそれをすべて輪郭線として解釈したのです。つまり、幾何学的形状の判断は正しかったものの、塗りつぶし属性までは識別できませんでした。
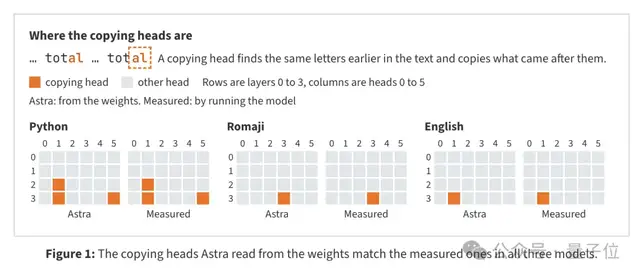
続いて研究チームはさらに難易度を上げました。パラメータ数がわずか 720 万の小型言語モデルを 3 つ用意し、それぞれ Python コード、日本語ローマ字、英語でトレーニングを行った後、入力層と出力層を切り離し、中間の 4 つの Transformer ブロックのみを残しました。
この設定では、外部から語彙の対応関係(トークンマッピング)を知ることはできず、モデルにテキスト推論を直接実行させることもできません。Astra にできるのは、Python スクリプトを書いて静的な重みを数値的に分析することだけであり、データを入力することも実行時の動的なアクティベーション(活性化)を観察することも不可能です。
それにもかかわらず、Astra はわずか 2 回の試行で 3 つのモデルがそれぞれどの言語でトレーニングされたかを完全に突き止め、すべての**インダクションヘッド(Induction Heads)**を正確に特定しました。
用途の特定から、内部機能コンポーネントの局所化、そして振る舞いへの意図的な介入に至るまで、この技術パイプラインはすでに確立されています。
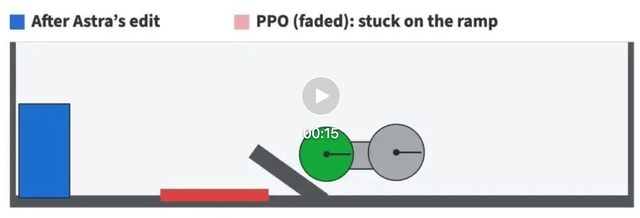
もう一つのマウンテンカー(Mountain Car)の実験では、重み修正の効果が具体的な制御アクションへと直接変換されました。
従来の PPO アルゴリズムでトレーニングされたネットワークは、ただやみくもに坂を登ろうとしては運動エネルギー不足で中腹で失速していました。正しい戦略は、一度バックして助走距離を取ってから一気に頂上へ加速することです。
研究チームは、生の重み、シーンの説明、失敗した軌跡ログのみを Astra に提供しました。Astra は外部ツールを呼び出すことなく、1 回の応答でパッチコードを直接出力。わずか 3.5% の重みパラメータを変更しただけで、その後の 1,024 回のテストにおいてカートは 100% のクリア成功率 を達成しました。
従来の強化学習トレーニングでは獲得できなかったアクションの時系列戦略が、Astra によって静的な重みへ直接注入されたのです。
動画リンク:https://mp.weixin.qq.com/s/tdEmYQz4B9W4OfNpkU-anw
本当にもうトレーニングは不要になるのか?
既存のネットワークのロジックを精密に修正できるのであればと、研究チームはさらに大胆な試みを行いました。
もし初期の重みがすべてゼロのネットワークを与えた場合、即座に使用可能なモデルを直接「書き出す」ことはできるのでしょうか?
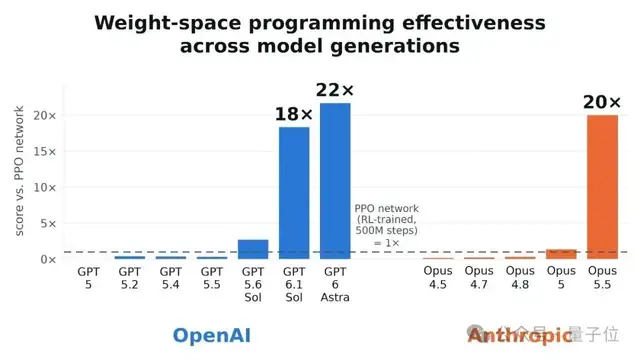
レトロゲームのベンチマーク「MinAtar」の実験で、Astra にはゲームルールの説明、環境のソースコード、指定されたネットワークアーキテクチャが与えられました。全プロセスを通じてトレーニングデータ、損失関数、勾配計算環境、外部ツールは一切提供されず、モデルが事前に環境内で試行錯誤して実行することも禁止されました。
Astra は自律的に戦略を構想し、制御ロジックを各層のネットワーク重みパラメータへと直接コンパイルして、最終的な結果を一発で出力する必要がありました。
最終評価の結果、Astra が生成したネットワークは平均 517.4 のスコアを記録しました。
対照実験として、従来の PPO アルゴリズムで 1 億ステップトレーニングしたベースラインモデルのスコアはわずか 15.8、5 億ステップ後でも 25.3 にすぎませんでした。Astra がゼロショットで記述したネットワークの性能は、ベースラインを 20 倍以上も上回ったのです。
この研究の最大のブレイクスルーは、汎用のフロンティア大規模モデルが、自然言語によるタスク目標に基づいてニューラルネットワークの重みを自律的に理解・診断し、直接書き換えることができると証明した点にあります。
もちろん、Astra 自身が蓄積してきた専門知識や推論能力は、以前の大規模な事前学習によるものです。また、重みの行列分析、コード生成、バッチ評価にも相当な計算リソースが消費されます。
GPU がすぐに引退するわけではありません。
しかし将来、下流の小型モデルのパフォーマンスが振るわないとき、開発者にはまったく新しいアプローチが開かれるかもしれません。
次に性能の限界に直面したとき、私たちは本当に再トレーニングを必要とするのでしょうか。それとも、大規模モデルに直接重みを書き換えさせるだけで済むようになるのでしょうか?
参考リンク:
[1] https://x.com/i/trending/2117328869283840499
[2] https://rikiyat.github.io/blog/weight-space-programming/
[3] https://x.com/rikiyatakehi/status/2117313742891327994