
CWE-bench は、最先端のサイバーセキュリティ能力の限界を検証することを目的としています。Collinear AI が能力の限界を押し広げ続ける中で、CWE-bench v2 では誰でも実行して自身のモデルを評価できる 100個のタスクからなる公開データセット をリリースしました。評価環境の設定は従来と同様です。エージェントには実際のオープンソースリポジトリのブランチと簡潔な指示が与えられ、既存の機能を損なうことなくセキュリティ脆弱性を特定・修正することを目指します。採点メカニズムは完全にプログラムによって実行されるため、評価結果は確定的(deterministic)であり、誰でも追加コストなしで再現可能です。すべてのプログラムによる検証は、LLM審査員パネル(judge panels)の協力を得て入念に設計されており、難易度と公平性の双方が保たれています。また、未知のタスクにおけるモデルの進捗を継続的に追跡するためのホールドアウトセット(held-out set)も管理しています。ホールドアウトセットでモデルの評価を行いたい場合は、cyber@collinear.ai までお問い合わせください。
私たちの目標は、徹底的かつ網羅的であることです。防御側は攻撃者が悪用しうるあらゆる侵入経路を先回りして予測する必要があり、一度のミスも許されません。今回の100のタスクは、幅広い脆弱性カテゴリにわたる91種類の異なるCWE(共通脆弱性タイプ一覧)を網羅しています。このベンチマークで優れた結果を出すには、潜在的な攻撃者が悪用しうる複数の脆弱なアタックサーフェスを深く理解する必要があり、見慣れたパターンを認識するだけでは決して十分ではありません。
継続的な品質向上のための厳格な取り組みの一環として、各タスクについて以下の項目を満たしているかを検証しました。
- 指示文が、人為的に作られた評価用シナリオではなく、現実の開発現場の指示のように自然に読めるか?
- 採点対象となるすべての動作が、指示から推測可能であるか?
- ベリファイア(verifier)が検証しているのは、特定の修正コードの構造ではなく、正しい動作そのものであるか?
- 初期のコードではテストが失敗し、リファレンス修正を適用すると合格するか?
- 新しい修正を適用した後も、既存の機能が正常に動作し続けているか?
- アップストリームの既知のパッチをそのまま暗記して適用するような手法を、ベリファイアが無効と判定できるか?
また、すべてのタスクは人手によるレビューも受けています。このデータセットのオープンソース化も、品質改善の取り組みの一環です。各タスクに対するフィードバックや、公開データセットへのコントリビューションを心よりお待ちしています。
評価結果
評価結果はHub上の2箇所でトラッキングされています。CWE-benchデータセットページのリーダーボードではオープンウェイトモデルを対象としており、自動的に更新されます。各研究機関やコミュニティは、モデルリポジトリに結果ファイルを含むPRを提出するだけで結果を追加できます(ガイド)。Gemini、Claude、GPTなどのAPI限定モデルを含む完全な比較を確認するには、CWE-benchリーダーボードSpaceをご覧ください。新しいモデルはこのSpaceへPRを提出することで追加できます。
データセットページにおけるオープンウェイトモデル:
API限定モデルを含む、評価済みの全モデル:
評価対象となった11種類のモデルのうち、Gemini 4 Argonがpass@1で67.8%、pass@4で81.0%を記録して首位に立ち、Claude Opus 5.5(pass@1 67.3%、pass@4 78.0%)をわずかに上回りました。全タスク中95件がいずれかのモデルによって解決されており、これらのタスクが実際に解けるものであることを示しています。しかしながら、最高パフォーマンスを誇るモデルであっても、各試行において依然として19%のタスクを解決できておらず、ロングテール問題の克服にはまだ程遠い状況です。公開テストセット、採点ツール(grader)、評価ハーネス(harness)はすべてオープンソース化されています。ぜひお使いのモデルを実行して、その実力を試してみてください。
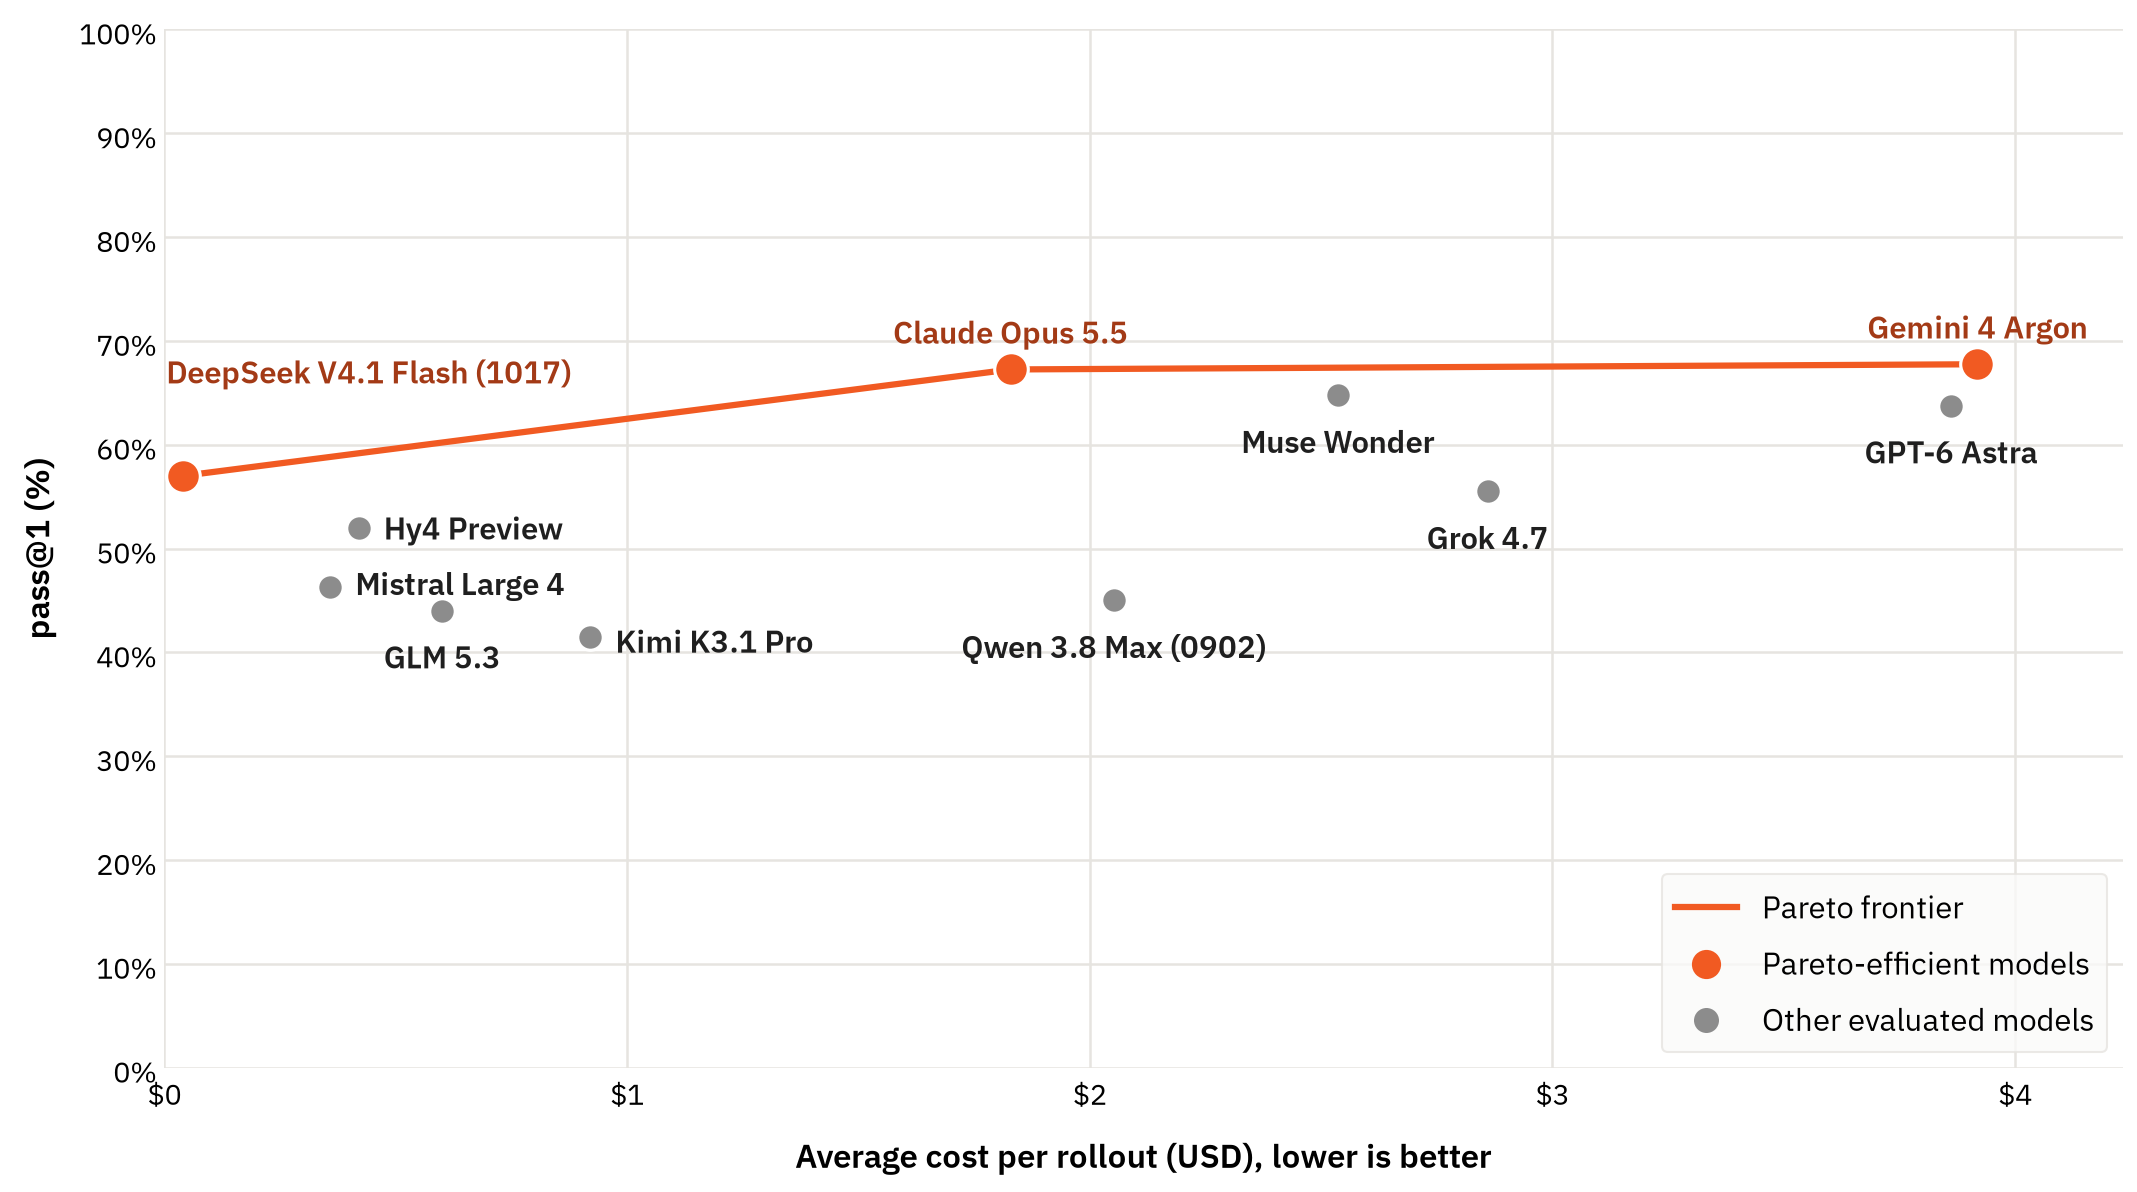
コスト面では、DeepSeek V4.1 Flash (1017)、Claude Opus 5.5、Gemini 4 Argonがパレートフロンティア(Pareto frontier)を形成しています。DeepSeekは1回のロールアウトあたりわずか0.04ドルのコストで57.0%のpass@1を達成しました。Opusはコスト1.83ドルでパス率を10パーセントポイント押し上げ、Geminiは3.92ドルのコストでわずかに首位に立っています。
Hub からの実行
各タスクは自己完結型の Harbor タスク(Docker化された環境、1つの指示、および確定的なベリファイアを含む)となっており、本データセットでは regi