
RSI(再帰的自己改善)をOCRに適用したところ、驚くべき成果が得られたという。
最近、パラメータ数がわずか1.3Bの中国発オープンソースモデルが、ドキュメント解析の領域で主要ベンチマークを次々と席巻し、注目を集めています。
OmniDocBench、olmOCR-Bench、DocParsingBenchという3大ベンチマークテストのすべてで首位を獲得しました。
ベンチマークスコアの話はひとまず置き、まずは実際の処理結果をご覧ください。
手書きの高度な数学ノートも、ワンクリックでMarkdown形式に変換されます。
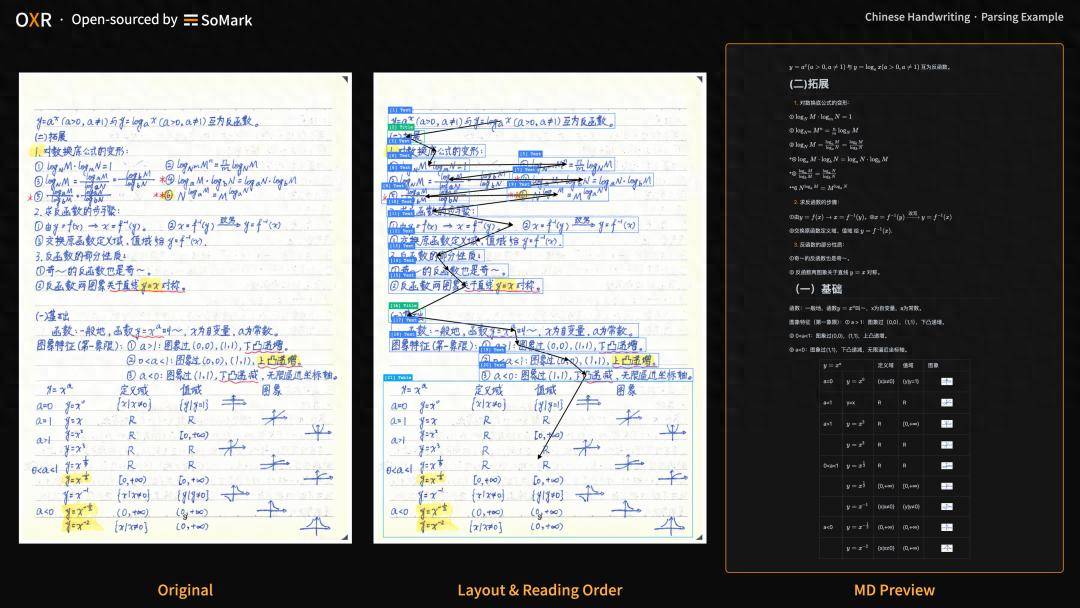
さらには、複雑な化学分子の構造式までも完全に復元可能です。
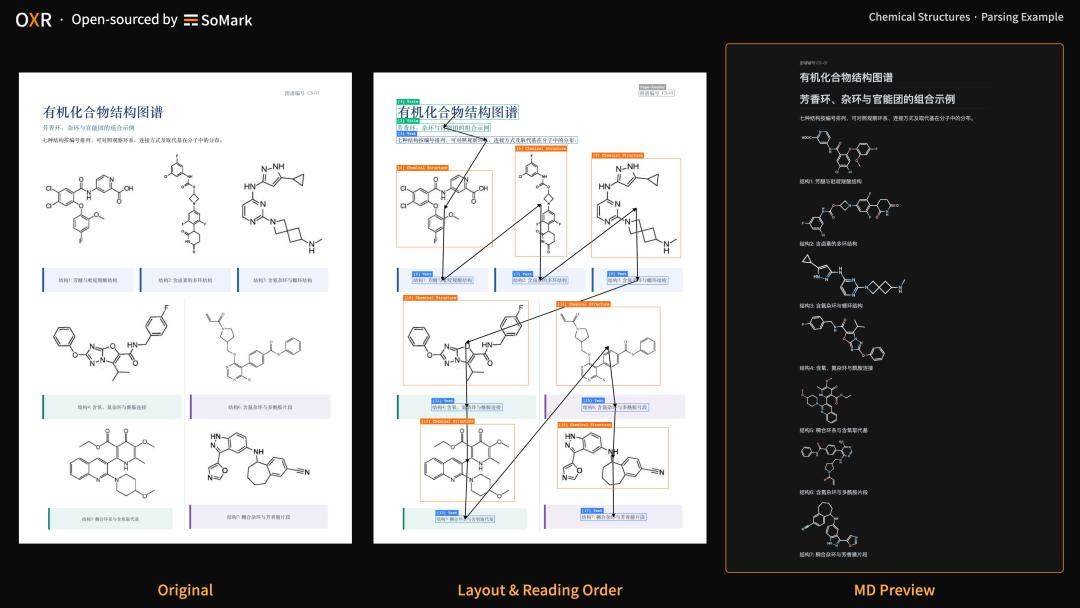
その実力は非常に高く、まさに「あらゆるものを解析できる」レベルに達しています。
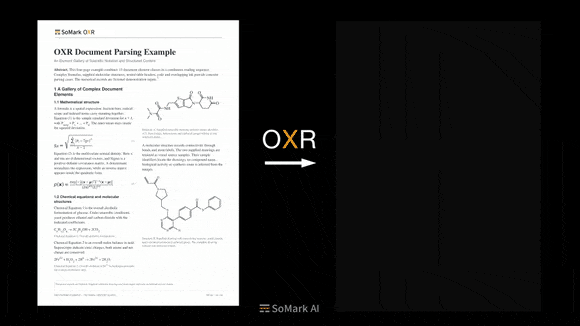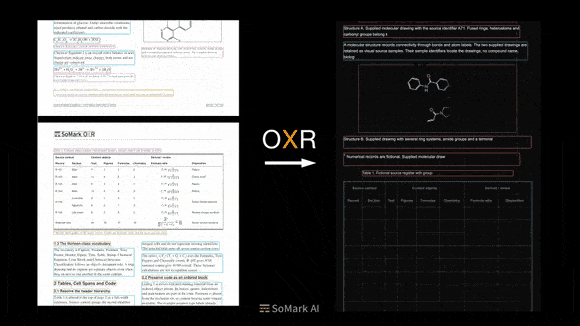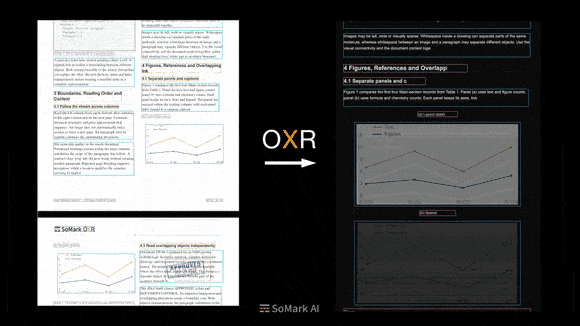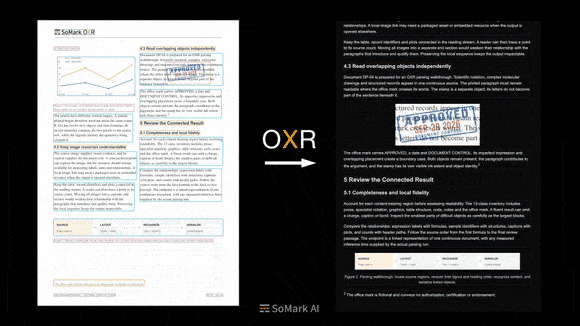
さらに驚くべきはその処理速度です。
RTX PRO 6000 1枚の環境において、100ページのエンドツーエンドなドキュメント解析をわずか101秒で完了します。
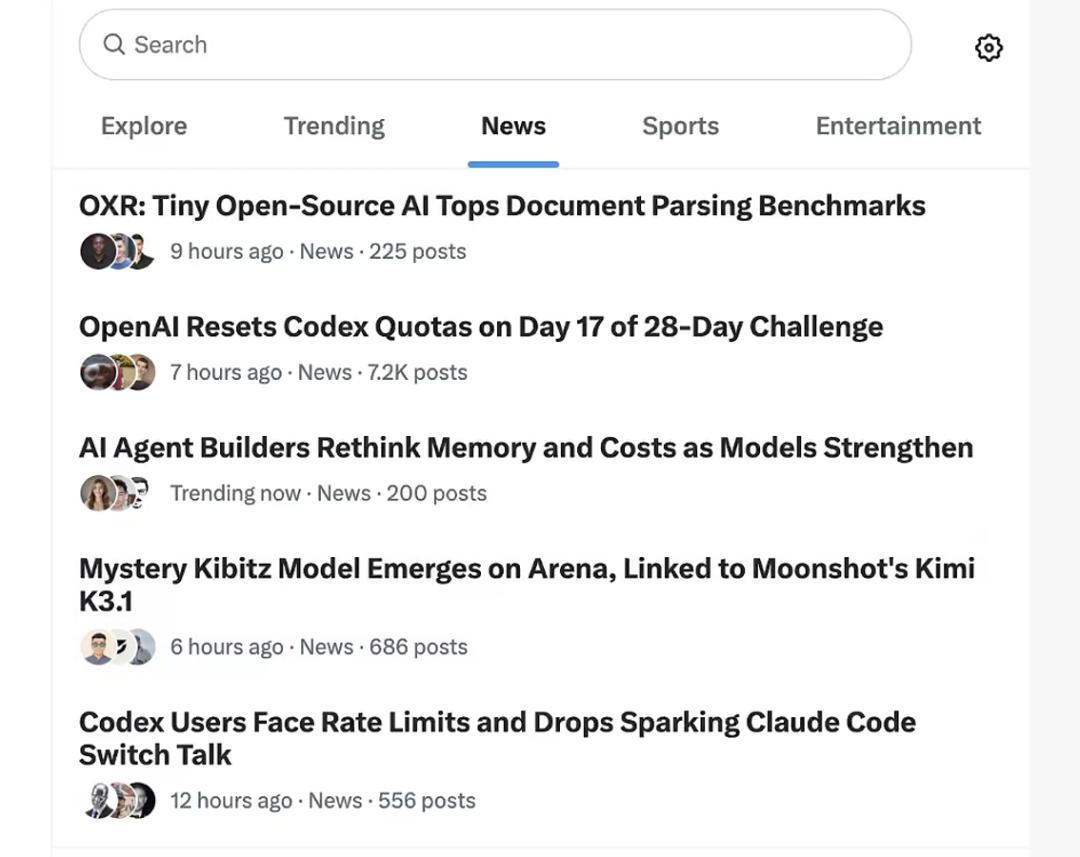
このモデルは海外の開発者コミュニティでも瞬く間に話題となり、すでに1.1K以上のGitHub Starsを獲得、一時はX(旧Twitter)のトレンドデイリーニュースにもランクインしました。
これらすべてのブレークスルーを支えているのが、現在のAI領域で最も注目されているコアメカニズム――
RSI(Recursive Self-Improvement:再帰的自己改善)です。
自己進化能力を備えたこの新世代OCRモデルは、OXR(Optical “Everything” Recognition)と名付けられています。
3大ベンチマークで世界1位を獲得
ドキュメント解析は、一見すると技術的ハードルがそれほど高くないように思われがちですが、実際には現在も完全な解決には至っていないエンジニアリング上の難関分野です。
ごく一般的なPDFドキュメントであっても、従来のOCRでは満足のいく結果が得られないケースが多々ありました。段組レイアウトで読み取り順序が乱れる、手書きの数式が文字化けする、ページをまたぐ複雑な表の構造が崩壊する、といった問題が日常茶飯事でした。化学構造式に至っては、多くのツールがノイズとして無視してしまう始末でした。
このような低品質な抽出結果をRAGシステムに入力してしまうと、後段のLLMの推論能力がどれほど優れていようとも、Tool Callツール呼び出しチェーン全体が破綻してしまいます。
しかし今、AIが高品質なコンテキストを取得する上での大きなボトルネックとなっていたこの課題に、決定的なブレークスルーがもたらされました。
- OmniDocBench:97.18点で1位を獲得(上海人工知能研究所が公開、10種類の複雑なドキュメントを網羅)。
- olmOCR-Bench:87.84点で1位を獲得(著名なAI研究機関Ai2が開発、単体テストレベルの難問7,000問以上を収録)。
- DocParsingBench:87.76点で首位を獲得(5大業界、14の実業務シナリオを網羅)。
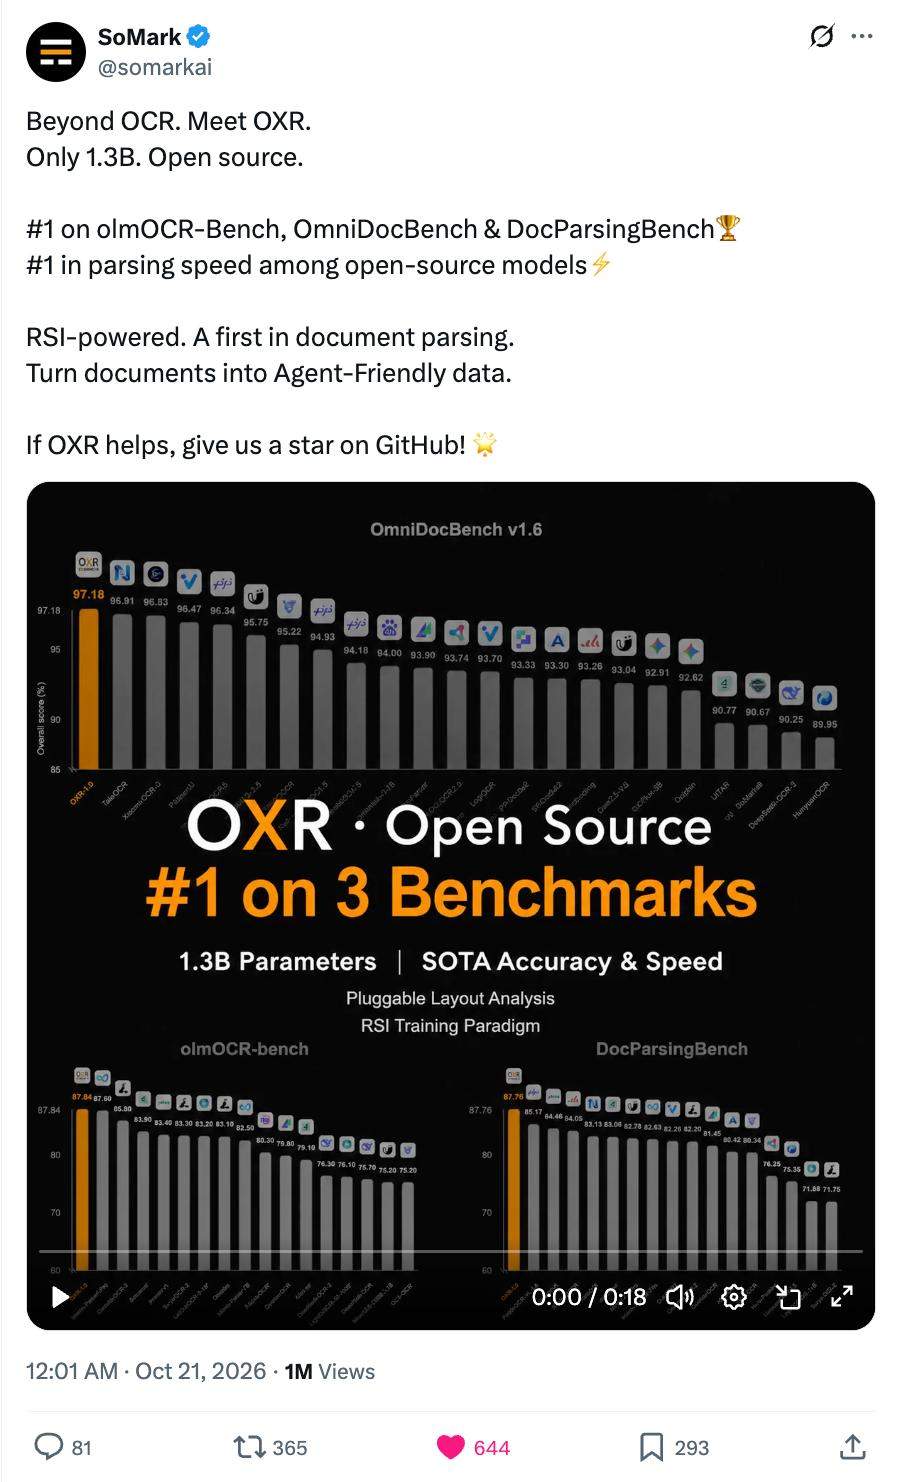
オープンソースのドキュメント解析モデル「OXR」は、世界的な権威を持つ3つのベンチマークすべてで頂点に立ちました。
さらに、一連の評価プロセスと評価コードはすべてオープンソースとして完全公開されており、誰でも結果を追試・再現できます。
実際に試してみても、従来のソリューションを明確に凌駕していることが実感できます。従来のツールは画像を雑に文字列へ変換するだけで、文書構造の再構築は後段の大規模モデルによる推測に頼りきりでした。一方、OXRは13種類のドキュメント要素をワンストップで解析可能です。
対象となる要素には、表、数式、コードブロック、画像、化学反応式、脚注、ヘッダー、フッター、印章(スタンプ)などが含まれます。
実利用シーンにおけるパフォーマンスは以下の通りです。
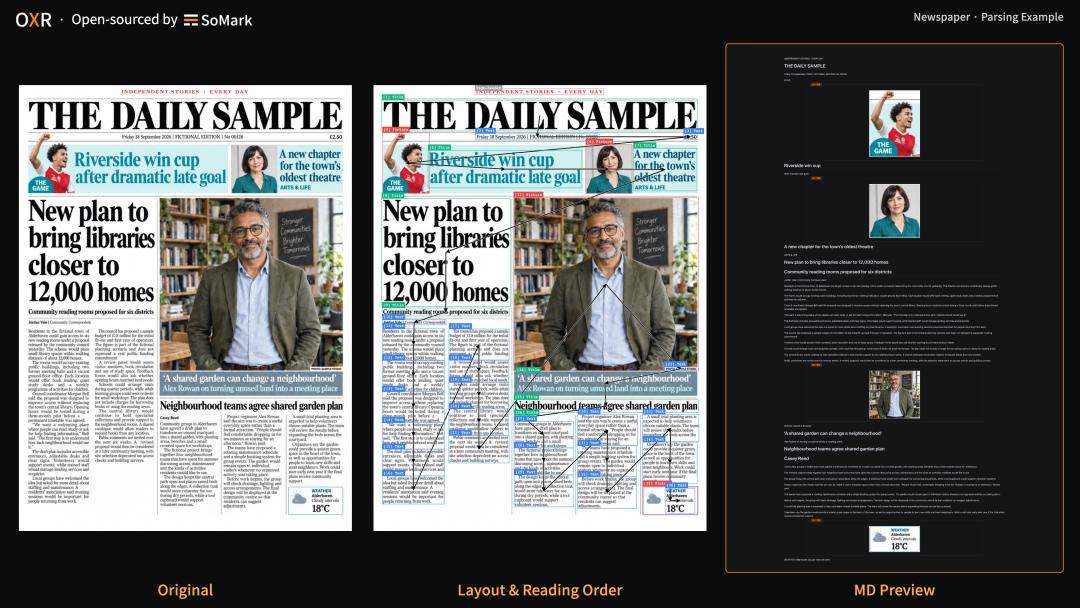
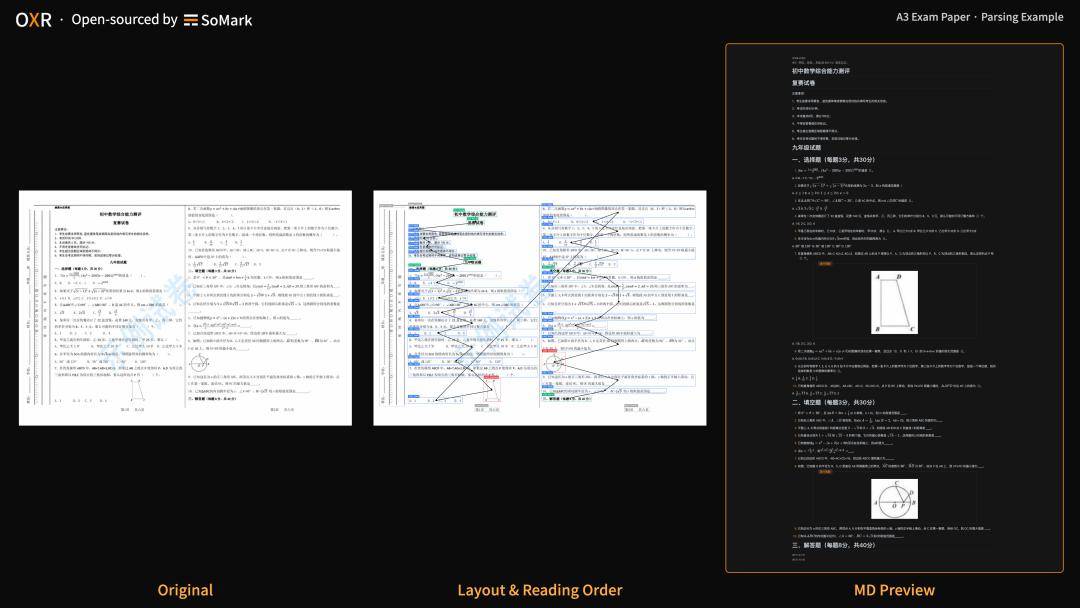
雑誌を解析する際は、元のセマンティックな階層構造と閲覧順序を完全に保持した構造化Markdownを出力します。
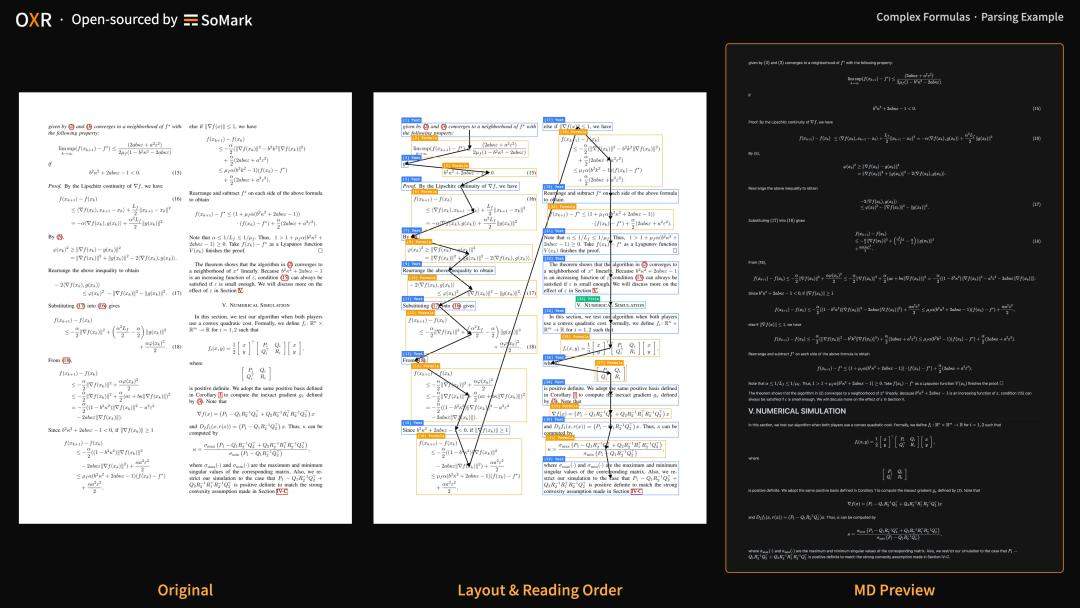
数式を解析する際は、標準的なLaTeXコードに直接変換されます。
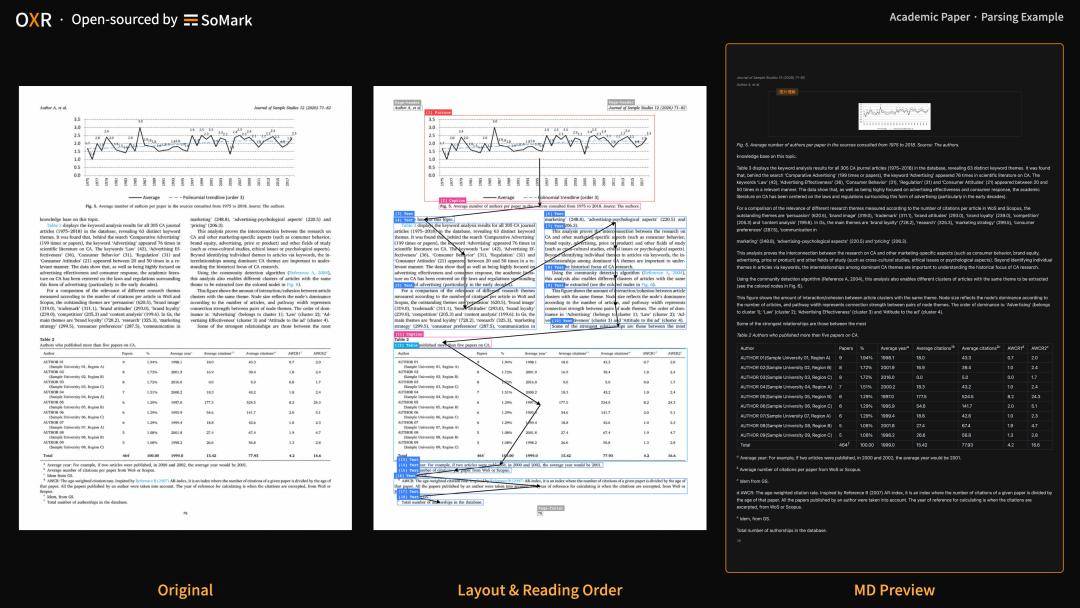
学術論文を解析する場合も、2段組のレイアウトに惑わされることなく、LLMによる煩雑な補助ツール呼び出しを介さずに高品質な結果を出力できます。
さらに、複雑な数学の試験問題も正確に認識可能です。
そして、同様に喜ばしいのが完全オープンソースであるという点です。
数百億パラメータを誇る一般的なLLMとは異なり、特定領域に特化した小型モデルのオープンソース化は、一般の開発者にとってより実利的な価値を持ちます。27B規模のモデルであってもローカルでのデプロイには依然として高いハードルが存在しますが、OXRのパラメータ数はわずか1.3Bです。
これは、RTX 3060のような一般的なコンシューマー向けGPU上でも、フルスペックの性能を維持したままローカル環境へデプロイし、高速に稼働させられることを意味します。
海外の開発者コミュニティからも絶賛の声が寄せられています。
では、わずか1.3Bの軽量モデルが、いかにしてこのSOTA(State-of-the-Art)レベルの精度を達成したのでしょうか?
その秘密は、ポストトレーニング段階に導入された仕組み――**RSI(再帰的自己改善)**にあります。
RSIトレーニングの全貌
これまで業界内では、「極めて高い認識精度を実現するには、数百億パラメータ規模の巨大モデルと膨大な人手によるアノテーションを投入するしかない」という固定観念が長らく支配的でした。
しかし、ドキュメント解析の領域において、アノテーションデータは埋めることのできない底なし沼のようなものです。レイアウトは千差万別で、専門的な数式、コード、図表が複雑に入り組んでおり、すべてを人手でラベリングするのは極めてコストがかかるだけでなく、アノテーション自体のヒューマンエラーも無視できません。現実世界に無数に存在するロングテールのエッジケース(Corner Case)を網羅することはほぼ不可能です。
そこで開発チームは、ある逆転の発想に至りました。ドキュメント解析タスクには、見落とされがちな重要な特性が存在します。それは――**「あらゆる入力に対して、極めて客観的かつ確定的な正解が存在する」**ということです。
文字の綴り、セル結合(複数行・複数列)の配置整合性、数式記号の完全性などは、すべてプログラムによって厳密に測定可能です。
正誤の基準が明確かつ客観的であるならば、なぜシステム自身の手で自律的なクローズドループを回せないのでしょうか?
これに着目したチームは、OXRのポストトレーニングにおいて、ドキュメント解析に特化した再帰的自己改善(RSI)トレーニングパラダイムを全面的に導入しました。追加の人手によるアノテーションに頼るのではなく、AIシステムが自ら誤りを検出し、原因を分析し、次サイクルの学習データを自律生成して自己イテレーションを行うという設計です。
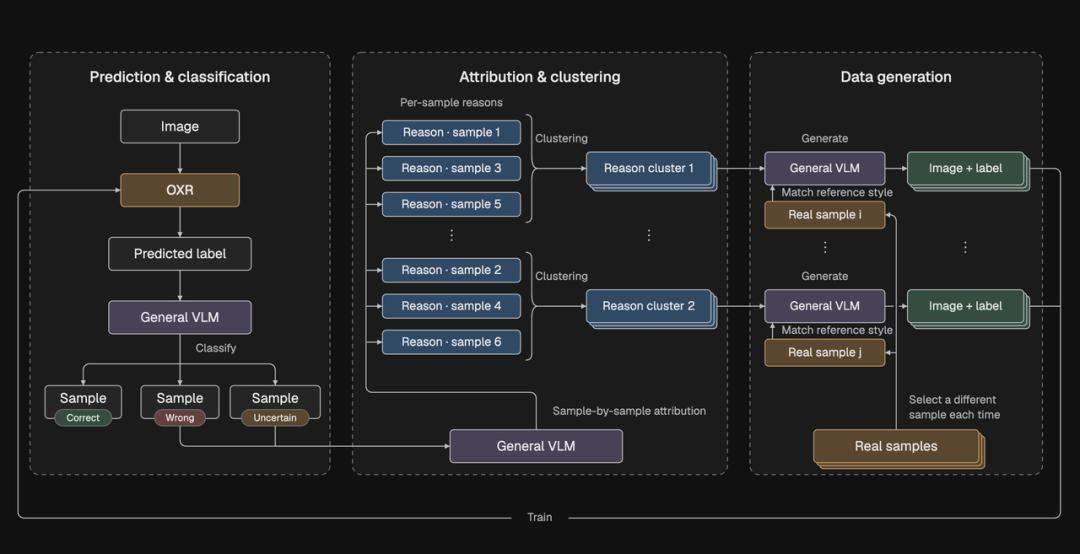
このRSIプロセスは、主に以下の3つのフェーズで構成されています。
1. 予測と分類(Prediction & Classification)
OXRはまず、ラベル付けされていない大量の実ドキュメントを一括解析します。
続いて汎用マルチモーダル大規模モデル(General VLM)が介入し、元の画像、解析結果、評価指標を組み合わせてサンプルを以下の3つに分類します。
- Correct:完全に正解。そのままパス。
- Wrong:明らかな誤り。詳細な分析パイプラインへ送致。
- Uncertain:予測の確信度が不安定、あるいは分布の境界付近に位置するもの。同様に分析パイプラインへ送致。
ここで Uncertain という分類を設けたことが極めて重要なポイントです。無理に白黒つける二元分類を行ってしまうと、評価モデル自身の不確実性が誤った擬似ラベルとして焼き付けられ、次サイクルの学習データを汚染してしまいます。Uncertain を設けることで、不安定なサンプルを安全に隔離できるのです。
さらに、システムはOXRに対して**複数回のロールアウトサンプリング(Rollout Sampling)**を実施します。同一ドキュメントにおいて複数回のサンプリング結果に大きなバラつきが見られる場合、確信度不足と判断され、仮に偶発的に正解が出力されたとしても Uncertain に分類されます。
最後に、セマンティクスを損なわない範囲で、意見の分かれたサンプルに対してわずかな画像ノイズ(リサイズ、不可逆圧縮、軽微なぼかし、平行移動など)を加えます。ノイズ付加によってモデルの出力のブレが大幅に拡大した場合、そのモデルが視覚的な微細変化に対して脆弱であることを示しています。このノイズパターンは「特徴的な病因」として記録され、次フェーズでの集中的な補強に利用されます。
2. 原因分析とトレーニング計画(Attribution & Training Planning)
エラーサンプルおよび境界サンプルを抽出した後、システムは失敗の根本原因を正確に特定する必要があります。
このフェーズでは汎用VLMが診断役を担い、各サンプルの問題点を1つずつ分析します。セル結合の配置崩れなのか、あるいは手書きの続け字の認識エラーなのかといった具体的な要因を洗い出します。
診断によって生成された自然言語による説明は、SigLIP2に入力されて特徴ベクトルが抽出され、独立したクラスタリングアルゴリズムによって明確な**原因クラスター(Reason Clusters)**へとまとめられます。例えば、財務諸表と化学実験の記録データは見た目や内容がまったく異なりますが、クラスタリングによって「いずれも極めて特殊な複数行・複数列のセル結合構造が原因で失敗している」と判明した場合、その構造的欠陥が共通の重点克服課題として抽出されます。
3. データ生成(Data Generation)
原因クラスターが明確になったことで、データ合成パイプラインには極めて精度の高いターゲットがインプットされます。
OXRのアプローチは、原因クラスターを構造上の難所として入力し、実サンプルプールをレイアウトや視覚スタイルの基準として用いるというものです。新規データを生成するたびに、実サンプルからレイアウト特徴を抽出してアンカーとし、そこに強化すべきレイアウトの難所を埋め込みます。また、先行のノイズテストで浮き彫りになった視覚的脆弱点も合成プロセスへ組織的に組み込むことで、トレーニングを通じてモデルの堅牢性を段階的に高めていきます。
厳格なバリデーションを経た合成データは直接フィードバックされ、次世代OXRのトレーニングに活用されます。1回のイテレーションが完了すると弱点が克服され、新たな実サンプルテストによってさらに深いレベルの課題が露呈し、システムは次のサイクルへと進みます。
こうして、RSIによる本物の正の自己進化ループが確立されました。イテレーションを重ねるごとにデータ分布は網羅的になっていきます。これこそが、OXRがわずか1.3Bというモデルサイズで圧倒的な「知能密度」を達成できた本質的な理由です。データの質が極めて精緻であれば、パラメータ数をただ増やして丸暗記させる必要などないのです。
軽量でプラグイン可能なアーキテクチャ
高い認識精度に加え、OXRは推論速度の面でも際立っています。RTX PRO 6000 1枚で、100ページのドキュメントのエンドツーエンド解析をわずか101.0秒で完了します。
このパフォーマンスは、単に「モデルサイズが小さい」からだけではなく、ドキュメント解析のアーキテクチャそのものを再構築したことによってもたらされています。
近年の業界における技術の変遷を振り返ってみましょう。
- 従来のパイプライン型アプローチ:レイアウト検出、テキスト認識、テキストの順序付けを、それぞれ独立した小型モデルに順次処理させる手法。フローが冗長で、保守コストが高い。
- エンドツーエンド純VLMアプローチ:タスク全体を画像からシーケンスへの直接マッピングとして扱い、単一のマルチモーダル大規模モデルがページ全体のテキストとレイアウトを一括出力する手法。アーキテクチャは統一されるものの、自己回帰による長系列生成が計算リソースを大量に消費するため、推論速度が極めて遅い。
- PaddleOCR-VL アプローチ:レイアウト解析(LA)と読み取り順序(RO)を前段の小型モデルに統合し、後段の認識(Recognition)モデルと接続する2段階デカップリング構成。レイアウト検出速度を劇的に向上させ、近年の業界における代表的なソリューションの1つとなったが、アノテーション段階でレイアウト情報と読み取り順序を不可分に結びつける必要があり、データ処理コストが跳ね上がる。
これら各アプローチの利点と欠点を徹底的に分析した結果、OXRチームはタスクの再構築を伴う新アーキテクチャを提案しました。独立した軽量モデルが**レイアウト解析(LA)に専念し、OXRメインモデルがコンテンツ認識(Recognition)と読み取り順序の推論(RO)**を同時に担う構成です。
すなわち、Layout Analysis (LA) -> Recognition + Reading Order (RO) という設計です。
この役割分担は、実務上の実装において大きなメリットをもたらします。
第1に、読み取り順序の計算に伴う余分なオーバーヘッドがほぼゼロになります。 処理パイプライン全体の中で、読み取り順序の推論にかかる計算コストはテキスト認識に比べて極めて小さくて済みます。OXRでは読み取り順序の処理をメインモデルに統合したことで、追加のレイテンシが発生しないだけでなく、メインモデルが本来持つコンテキスト理解能力(Content-Aware)を活用することで、読み取り順序の判定精度を大幅に向上させることに成功しました。同時に、前段のレイアウト解析モデル(LA)は順序付けタスクの制約から解放されて役割がシンプルになり、高スループットな軽量物体検出ネットワークを直接採用できるため、システム全体の並行処理能力が飛躍的に高まります。
第2に、レイアウト解析モジュールの完全な疎結合・プラグイン化が実現します。 実際の業務シナリオによって、レイアウト分割に求められる要件は千差万別です。 例えば図文混合エリアにおいて、ある業務では1枚の大きな画像として抽出したいのに対し、ナレッジベース構築の現場ではテキスト部分を本文として抜き出したい場合があります。また、密集したコマ割り漫画などでは、ユースケースによって切り出しサイズの基準がまったく異なります。
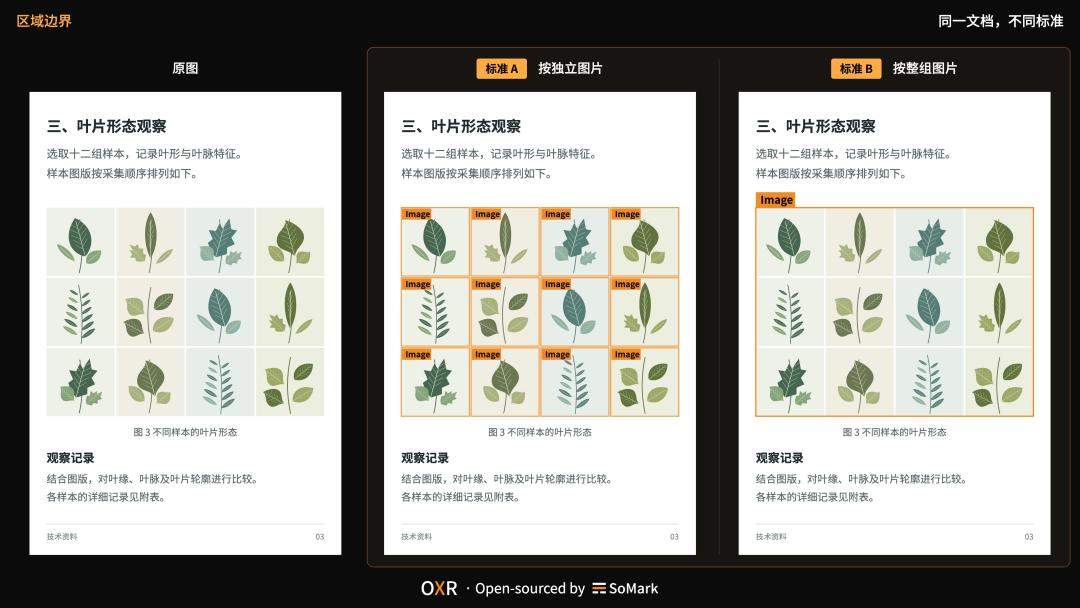
OXRのアーキテクチャにおいて、レイアウト解析は完全に独立したコンポーネントとなっているため、極めて低コストでのカスタマイズや差し替えが可能です。
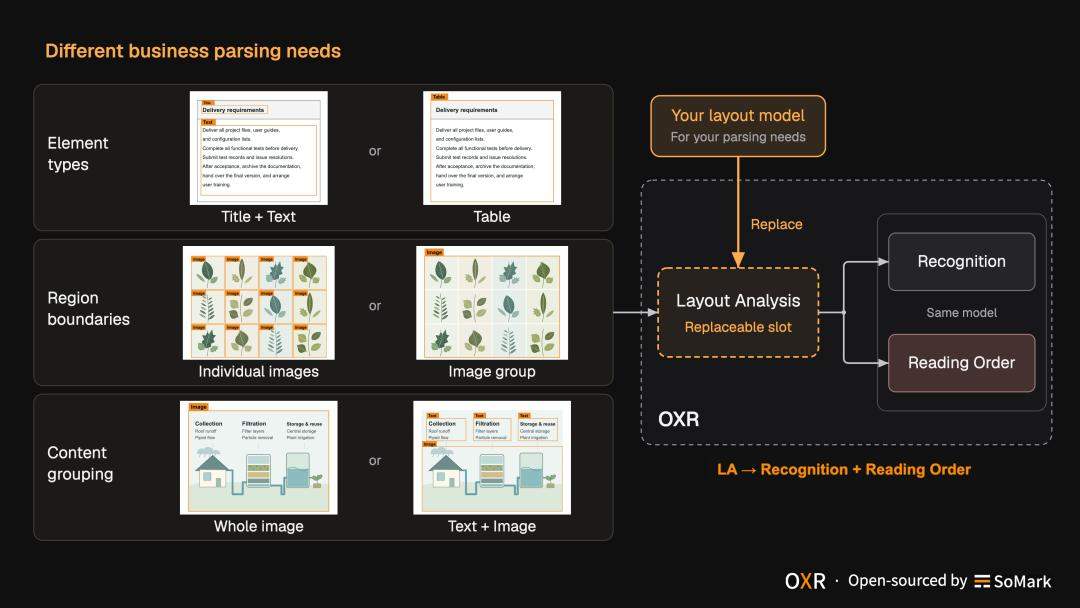
古文書のデジタルアーカイブや医療領収書などの特殊なレイアウトを扱う際も、独自に学習させたレイアウト解析検出器をシームレスに組み込みつつ、OXRが持つ強力なバックエンド認識機能と構造化生成能力をそのまま活用できます。
すぐに使えるエコシステム
開発者が容易に検証できるよう、公式からは現在、ユーザー登録不要・API Key不要の無料体験インターフェースが提供されています。
サーバーの負荷が許す限り、このオープンソース体験環境はコミュニティに向けて継続的に開放される予定です。
実際のライティングやナレッジ管理の用途において、この解析インターフェースを従来のツールと比較すると、複雑なPDFレイアウトに対する再現精度の向上は目を見張るものがあります。
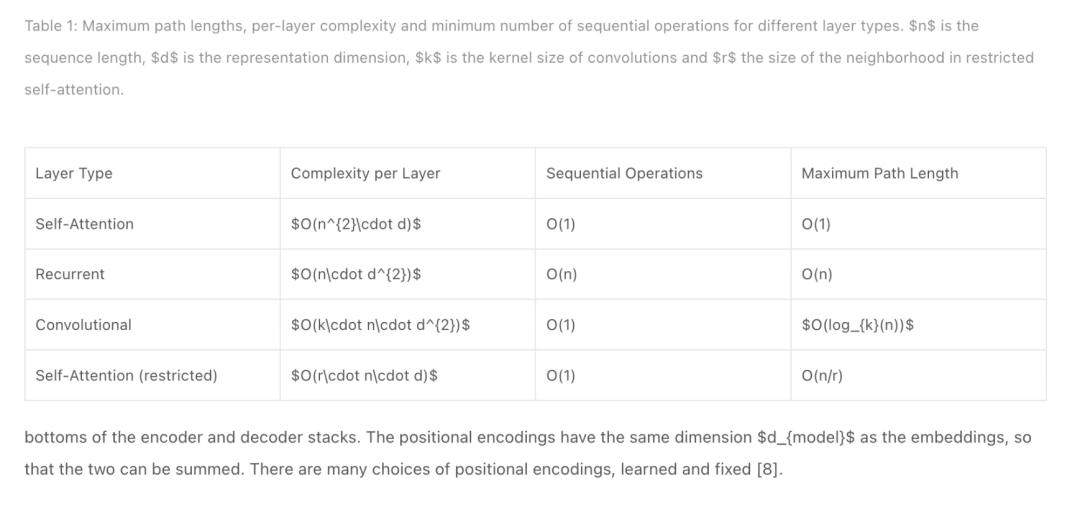
ローカル環境でのデプロイを検討しているユーザー向けには、主要な推論フレームワークへの最適化がすでに施されています。下位の推論エンジンを手動で再コンパイルする必要はなく、公式のDockerイメージまたはCLIからワンコマンドでサービスを起動できます。
現在、OXRのモデルウェイト、ソースコード、ならびにベンチマーク評価の完全な再現手順はすべてオープンソースとして公開されています。
さらに高度なフォーマット対応(Word、PPT、Excelの処理など)やディープなカスタマイズ後処理機能を求めるエンタープライズ向けには、開発チームよりSoMarkと呼ばれる商用グレードのドキュメントエンジンも提供されています。
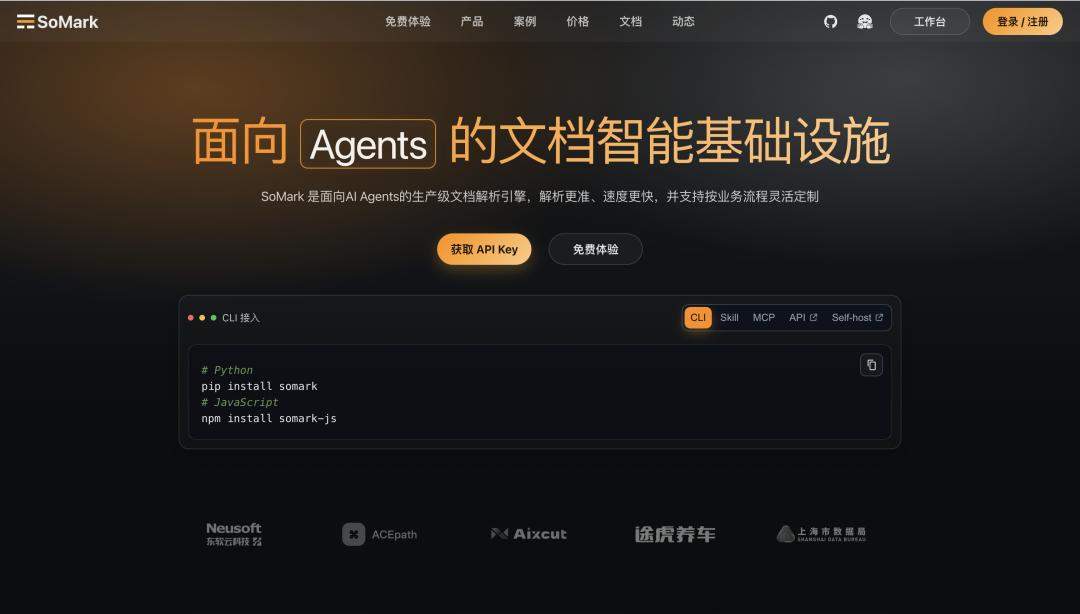
One More Thing
なぜ今、ドキュメント解析という分野に改めてリソースを投じる価値があるのでしょうか?
AIエージェントが生産性やワークフローを急速に再構築しつつある現在、過去数十年にわたって各業界に蓄積されてきた最も中核的でディープなプライベート業務ナレッジの大部分は、依然としてフォーマットがまちまちで複雑なPDF、スキャン文書、帳票といった形式のまま眠っています。
入力データが文字化けや行の乱れ、崩壊した表の破片だらけであれば、後段のLLMの推論能力がどれほど優れていようとも、ハルシネーションやロジックの破綻を避けることはできません。
従来のOCRから新世代のOXRへと至る中で、この技術が担う使命は静かに変貌を遂げました。それは、人間が扱う物理ドキュメントと大規模モデルの理解能力をつなぐ「構造化のハブ」であり、複雑で非構造化な画像・テキストを、AIエージェントが理解・消費可能な高品質デジタルアセットへとロスレスに変換することに他なりません。
新たな技術トレンドが次々と語られる現代において、現場の実シナリオに存在するエンジニアリング上のロングテール課題に実直に向き合うことこそが、強固な技術基盤を築く近道です。基盤となるデータ資産の解析アプローチが成熟していくにつれ、エージェント時代における業界インフラのパズルも、確実にその完成度を高めていくことでしょう。
- GitHub: https://github.com/SoMarkAI/OXR
- Hugging Face: https://huggingface.co/SoMarkAI/OXR