
以前にもAscendの3つのランキングで首位を独占
金磊 凹非寺より
量子位 | 公式アカウント QbitAI
ソースコードなし、論文なし。完全にゼロからのスタート。
今朝、完全に人間の介入を排したAIエージェント「ForgeKernel」が、DeepSeekのオリジナル実装を一切参照することなく、インターネット上の観客の目の前で、DeepSeekの最新コアカーネルの実行速度を**9.8%**向上させました!
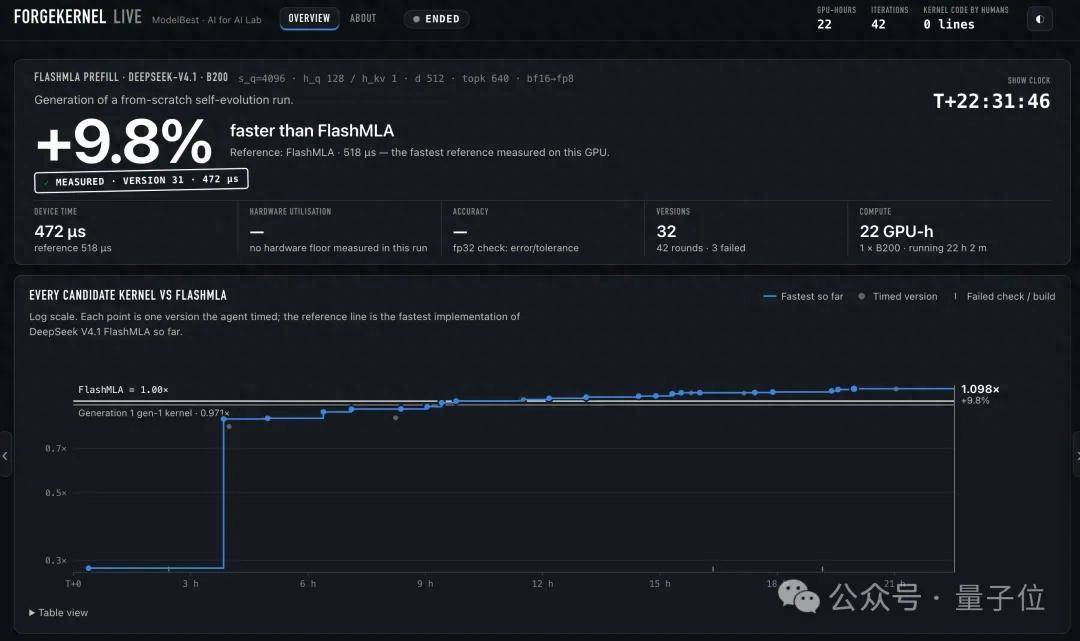
この公開ライブ配信に要した時間はわずか22.5時間(低レベルカーネルの設計という観点から見れば、極めて短時間です)。業界内の多数の開発者から瞬く間に大きな注目と関心を集めました。
具体的には、今回の配信では1つのエージェントがNVIDIA B200プラットフォーム上で、DeepSeek-V4.1のコアであるFlashMLA Prefillカーネルをゼロから最適化し、元の性能を超えるプロセスが実演されました。
FlashMLAは、DeepSeekがオープンソース化した高性能Attentionコアカーネルライブラリであり、10月20日に新たにオープンソース化された推論フレームワーク「DeepInfer」にも密接に統合されています。このカーネルライブラリは業界公認のトップInfraチームによって生み出されたものであり、人類が手作業で書き上げたカーネルの最高峰とも言える存在です。
前述のとおり、AIに与えられたのはそのカーネルの数式定義とターゲットハードウェアの制約のみでした。完全に**「ゼロスタート」**の状態で、自律的なイテレーションと進化を通じて段階的にチューニングを進める必要があったのです。
この22.5時間の間、コードのリファクタリングやパフォーマンスデータの変動がリアルタイムかつ明確に配信画面に映し出されました。
- 第1バージョンは正確性の検証をパスしたものの、1回の実行時間が1834マイクロ秒に達し、実行効率は低い状態でした。
- 開始から4時間足らずで実行時間は593マイクロ秒まで短縮され、短縮率は67.6%に達し、ゼロから業界トップレベルの実装の約9割の水準に追いつきました。
- 7時間前後でシステムはコア構造における重要なブレークスルーを達成し、自身の先行バージョンを超えただけでなく、人間が手書きしたFlashMLAを初めて打ち負かしました。
- 午前9時過ぎ、配信は無事に終了しました。最終的に生成されたバージョンの所要時間は472マイクロ秒となり、FlashMLAの518マイクロ秒と比較して9.8%高速化されました。
最適化プロセス全体で42回のイテレーションが行われ、32の進化バージョンが生み出されました。消費したのはB200 GPU 1枚と約22のGPU時間のみであり、このプロセスにおいて人間のエンジニアが書いたコードの行数は0行です。
手書きカーネルの最高峰の性能が、人間が1行もコードを書かずに自動生成されたカーネル群によって塗り替えられたのです。
では、これは一体どのようなエージェントなのでしょうか?
それこそが、面壁智能(ModelBest)によるカーネル自動生成システム——ForgeKernelです。そして本配信の終了後、面壁智能進化実験室はOpenBMBコミュニティと共同で、同システムのオープンソース化を正式に発表しました。
特筆すべきは、今回の配信がForgeKernelの初舞台ではないという点です。数日前にも、目覚ましい実績によって大きな話題を呼んでいました。
国産コンピュートプラットフォームの3部門で首位を独占
10月27日、Ascend(昇騰)CANNの公式アナウンスにおいて、ForgeKernelに対する公式な評価が公開されました。
なんと、CANNBenchの950DT、950PR、A3という3大ハードウェアランキングで同時に首位を獲得したのです!
これら3つのランキングはそれぞれ3種類のAscendハードウェアプラットフォームに対応しており、その結果はいずれもエンジニアリング面で極めて高い参考価値を持っています。
まず950DTランキングを見てみましょう。これは3つのランキングの中で最も直接的な商業的・経済的価値を持つ指標です。
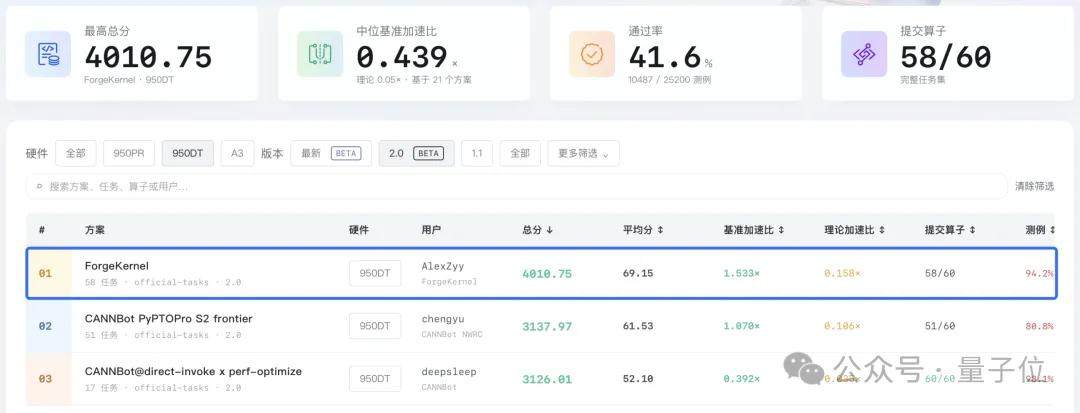
ForgeKernelはこのランキングにおいて4010.75ポイントを獲得して首位に立ち、2位に27.8%の差をつけました。ベースラインに対するスピードアップ比は1.533倍に達し、2位の約1.43倍となりました。
これは、ハードウェア投資が同等である場合、システムの有効計算能力が約50%向上し、企業のコンピュートリソース調達コストおよびエンジニアリング展開コストが直接約半分に削減される見込みがあることを意味します。
このランキングがとりわけ注目を集めた理由は、950DTがまったく新しい世代のハードウェアであり、対応するカーネルライブラリがまだ初期構築段階にあって、人手による適合には長期間を要する状況下で、ForgeKernelがいち早く高効率な適応を完了し、圧倒的な首位を獲得したためです。
この事実は、新ハードウェアのリリース直後のタイミングであってもAIが高品質なカーネルを迅速に生成できることを証明しており、チップのテープアウトからソフトウェアの最適化完了までの長い「空白期間」が大幅に短縮されつつあります。
950PRは、3つのランキングの中で最も競争が激しかった部門であり、上位3者のベースラインスピードアップ比はいずれも1.3倍を超えていました。
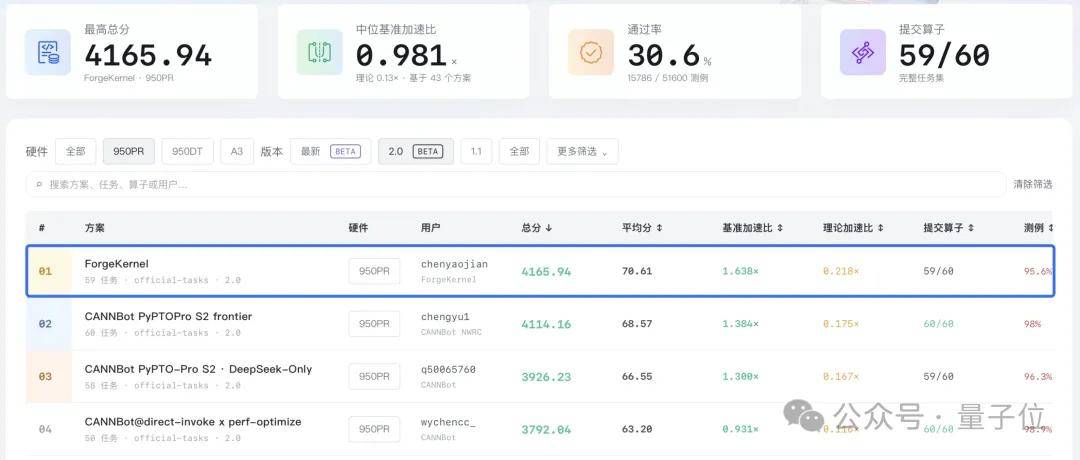
ForgeKernelはこのランキングで4165.94ポイントを獲得し、首位を堅持しました。ベースラインに対するスピードアップ比は1.638倍に達し、2位の約1.18倍となりました。
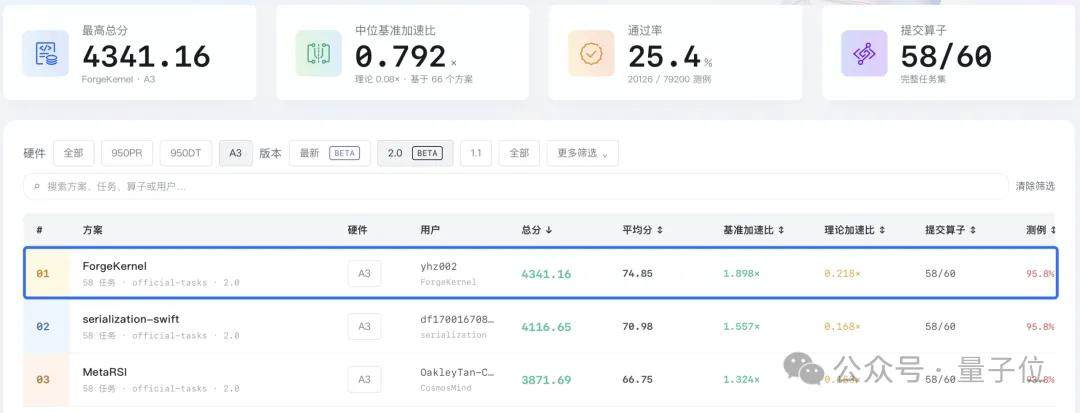
最後はA3ランキングです。これは現在業界で大規模に商用展開されているAscend 910Cに対応しています。
10月15日に締め切られたCANNBench v1.1において、同システムはすでにA3ハードウェアランキングで首位を獲得していましたが、v2.0の公開後も依然としてその座を守り続けています。現在の総合スコアは4341.16、ベースラインスピードアップ比は1.898倍に達し、2位の約1.22倍となっています。
今回の公開ライブ配信において、ForgeKernelはNVIDIA B200ハードウェアおよび成熟したCUDAエコシステム(数十年におよぶ業界のエキスパートの知見が蓄積された環境)上で動作しました。一方、CANNベンチマークのテストでは、独立したハードウェア/ソフトウェアアーキテクチャとツールチェーンを備えたAscendエコシステムが対象でした。
ソフトウェア・ハードウェアのエコシステムが大きく異なる2つの環境において、ForgeKernelは同一のコアアーキテクチャをベースとしながら、双方のプラットフォームで見事に首位を獲得したのです。
これは一体どのようにして実現されたのでしょうか?
師を持たずに自ら学ぶ自己進化体系
ハードウェア上でモデルがどれほど高速に動作するかは、低レベルのコアカーネルが決定的な役割を果たします。
同一のモデルアーキテクチャや同一の物理チップであっても、実行効率の高いカーネル群に置き換えるだけで、最終的なスループットとレイテンシには顕著な差が生まれます。
長年にわたり、高性能カーネルの研究開発はベテランエンジニアによる手作業の1行ごとの最適化に大きく依存しており、開発サイクルは長く、専門的なハードルも極めて高いものでした。CUDAエコシステムが今日の強固な堀を築けたのは、長年の人的リソースと経験の蓄積によるものです。対して、国産コンピュートプラットフォームが新たなアーキテクチャを発表するたび、あるいは大規模言語モデルの分野で新しい構造が生まれるたびに、エンジニアはカーネルをゼロから書き直す必要に迫られていました。
人間のエキスパートの供給能力は、モデルとチップの爆発的な進化スピードにもはや追いつけなくなっています。
局面を打開する道はどこにあるのでしょうか?
10月27日、ForgeKernelチームは清華大学などの研究機関と共同で、arXiv上に『JustGoal: With Only a Goal, the AI Baseline Is Above the Expert Kernels』と題する学術論文を発表しました。
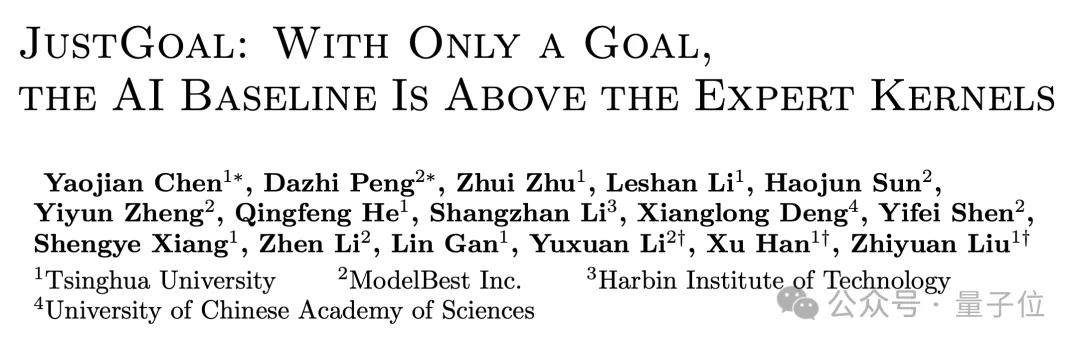
この研究はまったく新しいアプローチを提案しています。モデルには最終的な性能最適化の目標のみを与え、特定のカーネルに関する専門知識を教え込まず、固定化されたエンジニアリングパイプラインも設定せず、LLM自身にコード記述の探索経路を自律的に見つけさせるというものです。実験結果によると、B200プラットフォームにおいて、モデルが自律生成したカーネルは10個のテストタスク中8個で、人間が保守しているオープンソースの高性能カーネルライブラリを直接打ち負かしました。
研究チームは同一のモデルを、マサチューセッツ工科大学(MIT)のソン・ハン(Song Han)教授らのチームが開発に携わった専用フレームワーク「KDA-0.5」上で動作させました。しかし、単一設定の最適化タスクにおいて、その平均パフォーマンスはJustGoalの0.95倍にとどまりました。これは、カーネルの最適化能力がモデル本来の汎用的な推論能力と進化能力にますます依存するようになっており、エキスパートが事前設定したルールやテンプレートが、かえって制約になり得ることを示しています。
もちろん、「目標指向型(Goal-oriented)」にも限界があります。LLMはミクロな細部のチューニングには長けているものの、マクロなアーキテクチャ設計を自律的に制御することは難しく、最初の数回の試行で局所最適解に早期収束してしまい、既存のフレームワーク内での微調整にとどまる傾向があります。ForgeKernelはまさにJustGoalの理論的基盤の上に立ち、この課題に特化したシステムレベルのブレークスルーを実現しました。
その中核メカニズムは、以下の3大柱で構成されています。
- 動的・静的の疎結合化(動静分離):アーキテクチャ設計と低レベル実装を切り離し、マクロなアーキテクチャを段階的なマイルストーンとして抽象化することで、複雑さを段階的に解消。
- 経験の蓄積:実機での検証を経た有効なチューニングの知見をグローバルナレッジベースに統一保存し、異なるカーネル間での転移・再利用をサポート。
- 対戦型イテレーション:前回のラウンドで生成された最高性能のバージョンを次ラウンドのベースライン(対戦相手)とし、全自動の自己対戦型進化を実行。
これら3つのメカニズムは、ライブ配信の中でも完全に発揮されていました。
ForgeKernelはまず自身の先行バージョンを次々と超えていき、その後に手書き最適化されたFlashMLAを一挙に上回りました。
後期のディープチューニング段階では、システムはQ行列のバースト的なロードがKVデータのメモリアクセス・転送と基盤帯域を奪い合っていることを自律的に検知し、Qのリクエストタイミングに対してマイクロアーキテクチャレベルのフロー制御を能動的に適用。これにより、さらに2.4%の性能向上を引き出すことに成功しました。従来、このようなハードウェアとソフトウェアの深層に潜むボトルネックの特定には、経験豊富な低レベルシステムのエキスパートが不可欠でした。
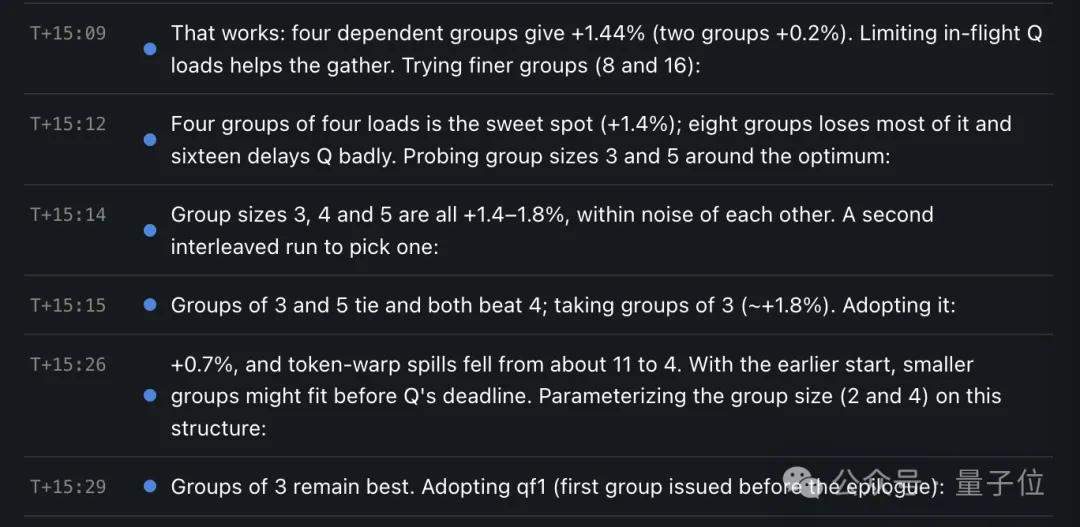
△ForgeKernel Liveにおけるエージェントの実行ログ
より広範な評価データセットにおいて、ForgeKernelは29項目の主要なカーネル比較タスクのうち、24項目で人間のエキスパートによる極限の実装と同等以上の結果を収めました。また、業界の他の3大トップエージェントシステムが公開している最強カーネル7種に対しても、全面的に同等以上の性能を達成しています。
さらに重要なのは、この成果を異なる国産ハードウェアプラットフォームへスムーズに再現できる点です。ForgeKernelは、その基底ロジックにおいていかなる単一のハードウェアにも依存していないためです。
カーネルの具体的な実装コードは、特定のチップのマイクロアーキテクチャの特性に厳密に適合させる必要があり、単純な流用はできません。しかし、ForgeKernelの最適化探索パラダイムは極めて汎用的であり、いかなるアーキテクチャに対してもプロセスを固定化していません。NVIDIAプラットフォームからAscendプラットフォームへ移行する際、システム側で必要な作業は、低レベルのプロファイリングプローブをNCUからmsprofへ切り替えることだけです。ターゲットハードウェアのマイクロアーキテクチャ特性は、エージェント自身がそのチップ上での動的な実測を通じて自律的に学習し、蓄積していきます。
これにより、ForgeKernelは異なる国産チップ間を低コストで迅速に移行でき、次世代の国産ハードウェアが登場した際も、低レベルの適合スタックを一から数か月かけて再構築する必要がなくなります。
もたらされる確かなビジネス価値
現代のAIコンピュート規模において、低レベルカーネルの1%の高速化は一体何を意味するのでしょうか?
Gartnerの最新予測によると、2026年の世界におけるAIインフラ支出は約1兆4800億ドルに達するとされています。この規模から逆算すると、計算処理の実行効率が1%向上するごとに、ハードウェアおよびエネルギーコストが約148億ドル節約される計算になります。
国産コンピュートチップにとって、この恩恵はとりわけ顕著です。
NVIDIAのCUDAエコシステムは10年以上にわたる人手による最適化を経ており、既存の高性能カーネルが極めて豊富であるため、AIがさらに性能を引き上げられる物理的マージンは相対的に限られています。一方、国産コンピュート向けのカーネルライブラリは現在も構築途上であり、極限までチューニングされていないカーネルが数多く存在するため、AIの介入によってもたらされる性能向上の余地(弾力性)は明らかに大きくなります。
ForgeKernelチームが本システムを用いてモデル学習フレームワークのチューニングを行った際、同様の最適化パラダイムによって、NVIDIAハードウェア上では5%〜10%の性能向上が得られたのに対し、国産チップ上では20%〜30%ものシステムレベルの高速化が直ちに実現されました。これは、ForgeKernelが学習および推論シナリオにおける国産チップのエネルギー効率の弱点を極めて迅速に補い、世界のトップエコシステムとのエンジニアリング格差の縮小を加速させられることを意味しています。
コード生成の限界費用がゼロに近づくにつれ、かつてはエンジニアの人件費の制約から実施が難しかった「特化型カスタマイズ」(特定のモデルアーキテクチャや単一モデルのチップに合わせてカーネルセット全体を深くカスタマイズするなど)が、十分な商業的実現可能性を持つようになります。
現在、これら人間のエキスパートを凌駕するカーネル群はベンチマークの枠を飛び出し、実際の産業向けプロダクション環境へと進出し始めています。
すでにForgeKernelが生成した高性能カーネルは本番環境レベルの学習フレームワークに正式に組み込まれており、国産チップおよびNVIDIAプラットフォーム上でMiniCPM5-1B規模の大規模長期学習による安定性検証を完了しています。
このコンピュートインフラの再構築の中で、重要なトレンドが起こりつつあります。それは、DeepSeek-V4.1をはじめとする高性能大規模言語モデルが、カーネルの生成とエンドツーエンドのコンパイル・チューニングを本格的に担い始め、そうしてAIによって生成された高効率カーネルが国産コンピュートプラットフォーム上で安定稼働しているという点です。
「国産モデルがカーネルを書き、国産チップがそのカーネルを動かす」という技術的完結(エコシステムの閉環)が急速に形成されつつあります。
これは単なるカーネルエンジニアリングにおけるブレークスルーにとどまらず、産業界における「機械の再帰的自己改善(Recursive Self-Improvement, RSI)」の現実の姿を反映したものです。すなわち、AIの研究開発やインフラチューニングの主体が、人間のエンジニアからモデル自身へと徐々に移行しつつあるのです。
面壁智能進化実験室のチーフサイエンティストである**李宇軒(Yuxuan Li)**氏が指摘するように、コードには自動テストや実行による検証が可能な「生来の確実性」が備わっているため、純粋な理論研究よりもエンジニアリングの実装現場の方が、より早く進化のループを完成させやすいのです。
かつては、FlashAttentionのようにデータフローやハードウェアパイプラインの再構築を必要とするトップレベルのカーネルの場合、経験豊富なエキスパートチームであってもアーキテクチャレベルの飛躍を遂げるには数か月から半年を要するのが常でした。しかし現在の開発プロセスでは、現在の人類の最高峰の実装を超えるカーネルチューニングタスクであっても、最短わずか2日で完結できるようになっています。
ForgeKernelの全面的なオープンソース化に伴い、このカーネル自動生成の方法論も公共のインフラストラクチャへと昇華され、各チップメーカーや大規模モデル開発チームに対して、かつてないエンジニアリングのデリバリー効率を提供することになるでしょう。
これまで国産チップがトップエコシステムを追撃する際、最大の障壁となっていたのは、ハードウェア自体の理論TOPS性能ではなく、CUDAエコシステムが十数年を費やし膨大な数のアルゴリズムエンジニアによって築き上げてきたカーネルライブラリとソフトウェアスタックの壁でした。しかし、自己進化型エージェントのパラダイムのもとでは、人海戦術によって構築された時間の壁は急速に打破されつつあり、エンドツーエンドの自動探索がハードウェアとソフトウェアの協調における最適解を直接導き出しています。
**「国産モデルがカーネルを書き、国産チップがそのカーネルを動かす」**という流れが低レベルシステムエンジニアリングの新たなパラダイムへと進化する中で、ソフトウェアエンジニアリングの主役は静かに交代しつつあります。しかし、これは人間の専門家が退場することを意味するのではなく、その開発における職責が構造的な再編を迎えていることを意味しています。
エンジニアは、1行ずつアセンブリや低レベルロジックを磨き上げる「コードの職人」から、シミュレーション環境を構築し、自己進化の目標を定義し、検証指標を設計する「システムアーキテクト」へと進化しつつあるのです。
人と機械の協調が「AIによる自律的な記述」と「人間による高次元での制御」へと進化する中で、国産チップが「動く」から「十全に性能を発揮する」へと至る技術的な溝は、AIの手によって時間単位のスピードで急速に埋められつつあります。