
拡散モデルでエージェントをどう作るのか?
驚いた。日々 AI の最前線を追っているつもりが、あっという間に時代に取り残されてしまいそうだ。
画像や動画の生成専用だと思われていた**「拡散モデル(Diffusion Model)」**が、今やコードを書き、Web ページを生成し、ツールを呼び出してエージェントとして動くようになったとは、誰が予想できただろうか。
つい先ほど、拡散智能(Diffusion Intelligence)がまったく新しい拡散言語モデル「Clover-35B-A3B-Preview」を発表した。
名前に「拡散」の文字が入っているものの、実際に使ってみると、コード生成、Web ブラウジング、外部ツール呼び出し、HTML 生成に至るまで、使い心地は我々が使い慣れた大規模言語モデル(LLM)と何ら変わりない。
実際に試してみて、まず感じたのは「とにかく速い」という一言に尽きる。
例えば、太陽系シミュレータの生成を指示すると、Clover は約 1 秒ほど思考した後、わずか 4〜5 秒でインタラクティブに操作できるシミュレータを丸ごと生成し終えた。
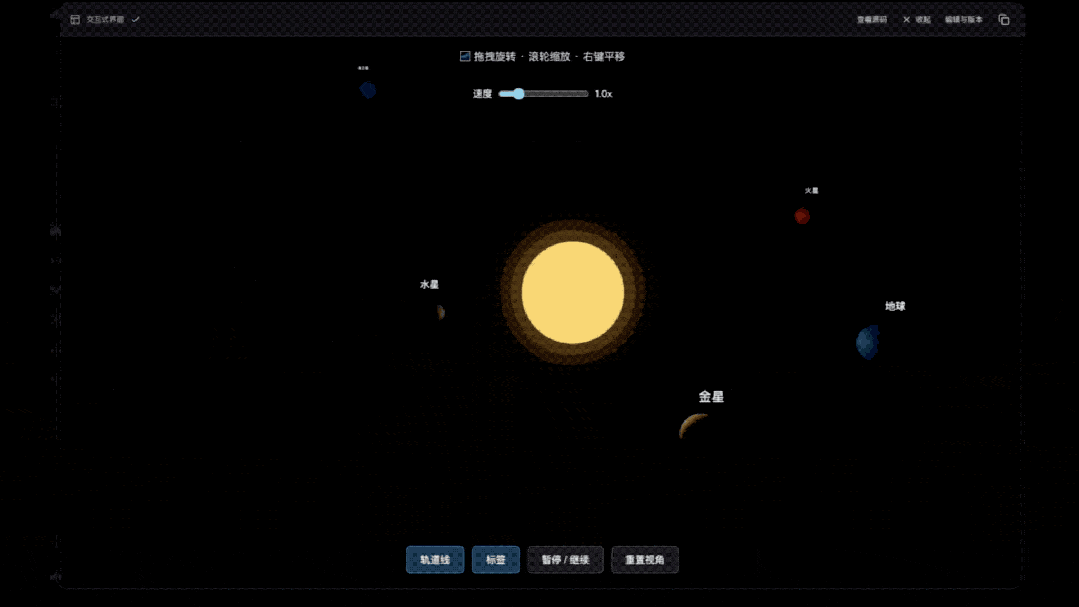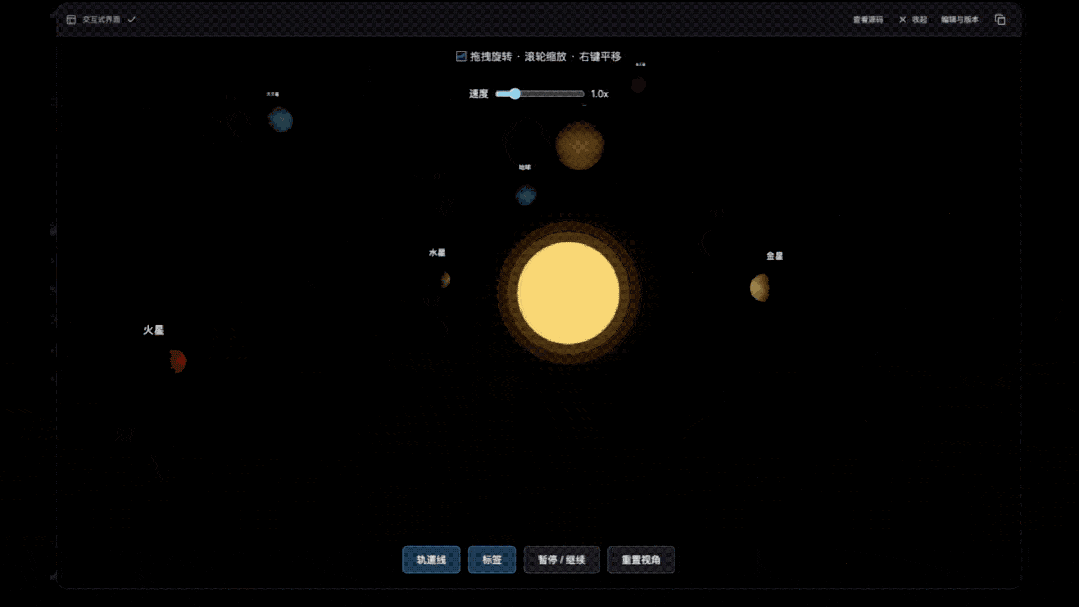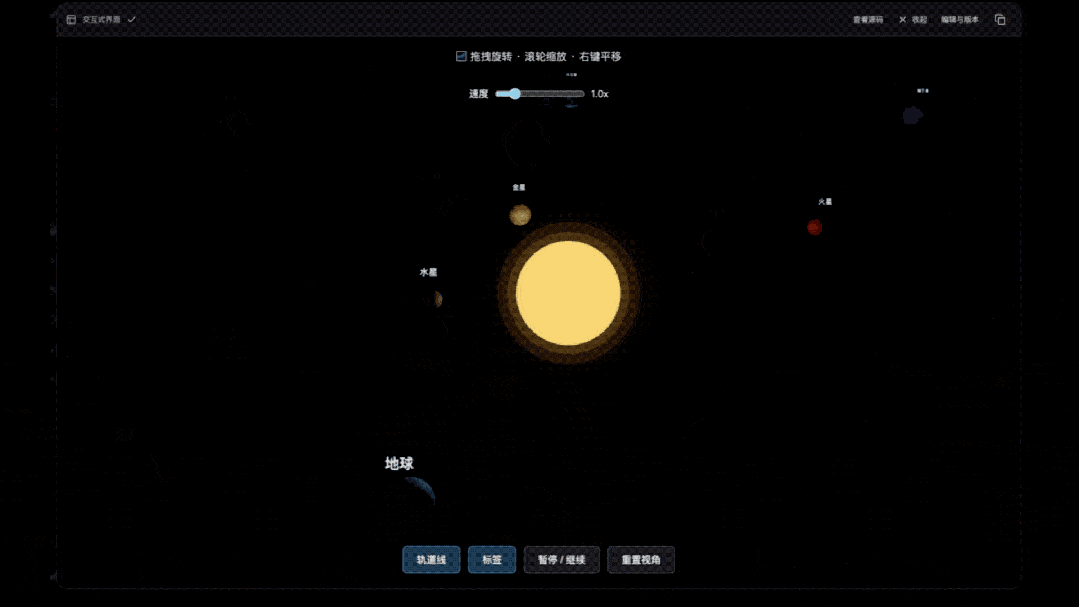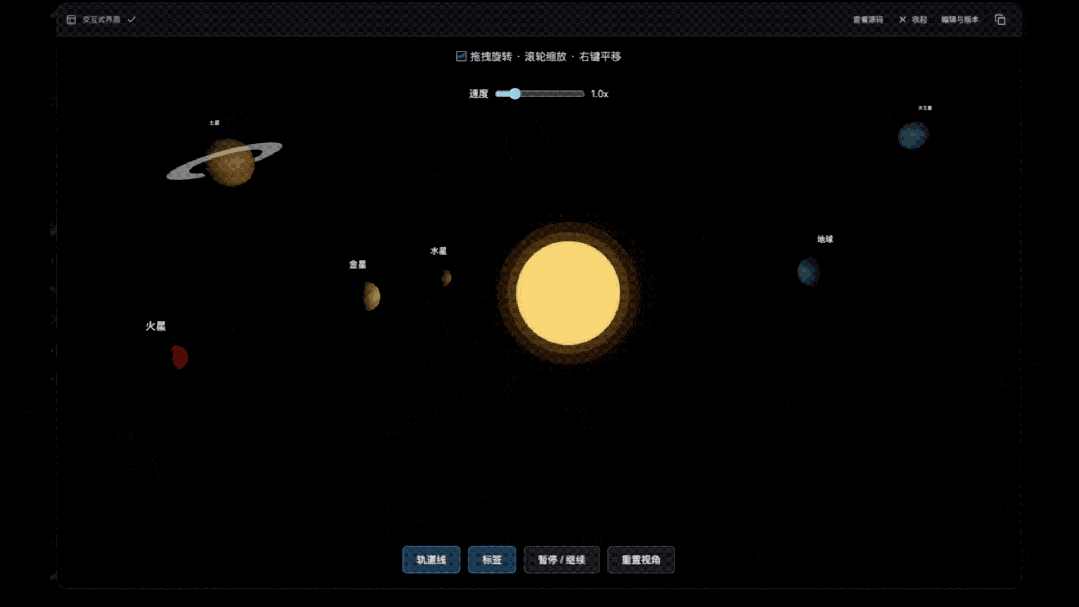
また、非構造化データとして雑多な職務経歴情報を渡し、LaTeX 形式のレジュメコードに整形するよう依頼したところ、わずか十数秒であっさりと仕上げてみせた。
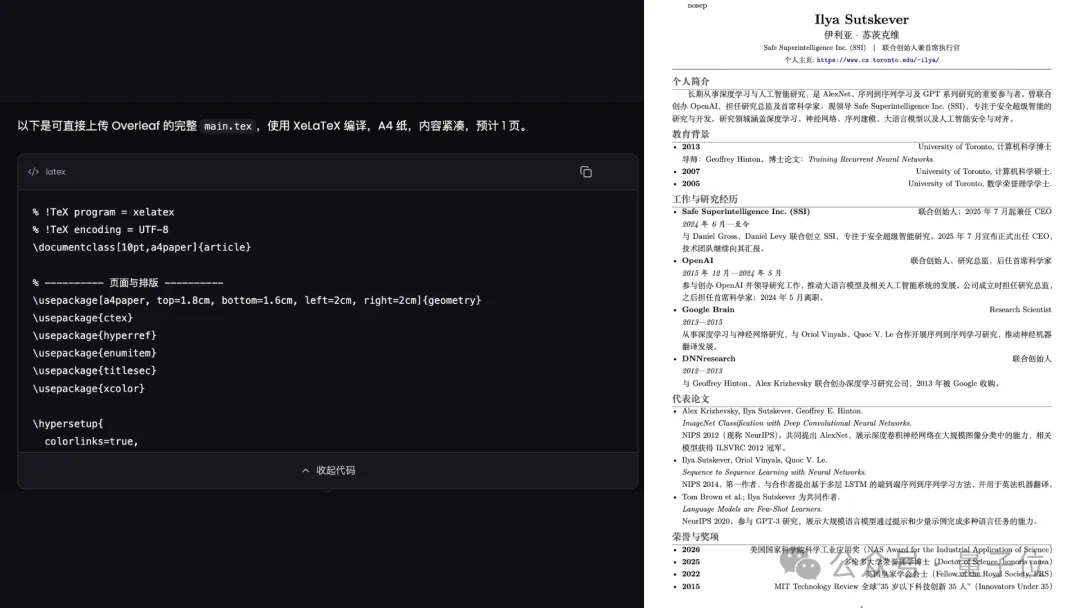
GPT 系のモデルを使ったことがある人なら、「思考中」の画面を見つめながら待たされるもどかしさをよく知っているだろう。近頃、高速な意思決定を売りにした Jev が大きな注目を集めている理由もそこにある。
その Jev に関して言えば、今回の Clover は速度の面で真っ向勝負を挑んでいる。
Web エージェントのベンチマークである WindTunnel の 49 タスク(各タスク 3 回試行)において、Clover の実行時間の中央値はわずか 1.52 秒 だった。これに対し、Jev+Mercury 2.5 の組み合わせは 3.21 秒 を要しており、Clover は半分以下の時間で処理を終えている。
タスクの試行成功率においても、Clover は 98.6% 対 95.9% とわずかに上回った。
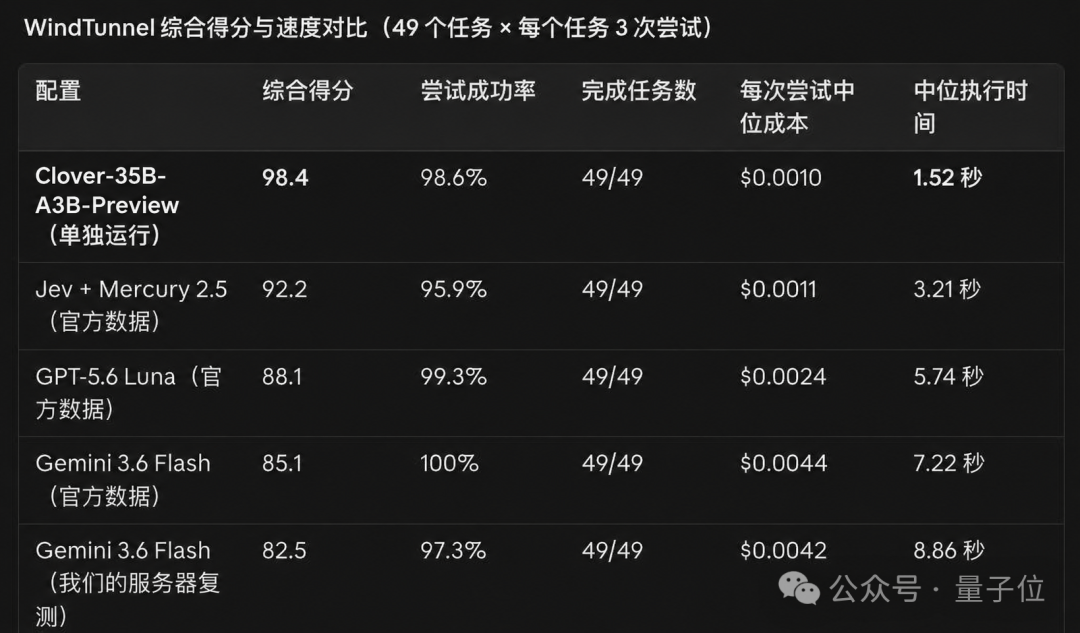
同じ表にある Gemini と比較すると、実行速度は何倍も高速だ。
これには従来の自己回帰型モデルも、いよいよ危機感を覚えるのではないだろうか。
エージェントタスクをこなす拡散モデル
モデル自体の構造に目を向けると、Clover-35B-A3B-Preview は MoE(Mixture of Experts)アーキテクチャを採用しており、総パラメータ数は 350 億(35B)、トークンごとのアクティブパラメータ数は約 30 億(3B)で、思考モード(Thinking Mode)にもネイティブ対応している。
これにより、開発チームの拡散言語モデルは、前作の Dream 7B(70 億パラメータ)から一気に 350 億パラメータ という新たなスケールへと進化した。
さらに重要なのは、パラメータ規模が大幅に拡大したにもかかわらず Clover の推論速度は落ちず、同等サイズの自己回帰モデルを全面的に凌駕している点だ。
公式デモでは、インタラクティブなページや基本コードの生成だけでなく、複雑なタスクの処理や Web UI の生成など、多彩なエージェント能力が披露された。
WebMCP を介して、Clover は請求書の発行、講座の申し込み、金額の集計、イベントのステータス照会、顧客および請求書情報の取得といった 6 つのタスクを連続して処理した。
デモの比較において、Clover はタスクをスムーズに完遂しただけでなく、実行速度でも Gemini 3.6 Flash を大きく引き離した。
オンラインショッピングのシナリオでは、指定されたデザイン、黒色、L サイズの T シャツを指示通りに的確に見つけ出し、カートに追加してゲスト情報を自動入力し、テスト決済プロセスまで淀みなく完了させた。
こうした一連のタスクを連続して実行できる安定性こそ、今回のデモにおける最大の技術的ブレイクスルーと言える。
従来の拡散言語モデルは、並列生成による高速性という強みを持っていたものの、エージェントタスクへの適用においては不安定さが目立っていた。ツール呼び出しのフォーマットエラーを起こしやすいだけでなく、同一ステップで試行のループに陥ったり、環境からのフィードバックに応じて次のアクションを動的に調整できなかったりしたためだ。
Clover の今回のコアとなる進化は、連続したオペレーションにおける高い信頼性にある。安定してツールを呼び出し、フィードバックを正確に解釈し、ゴールに到達するまで粘り強くアクションを推し進めることができる。
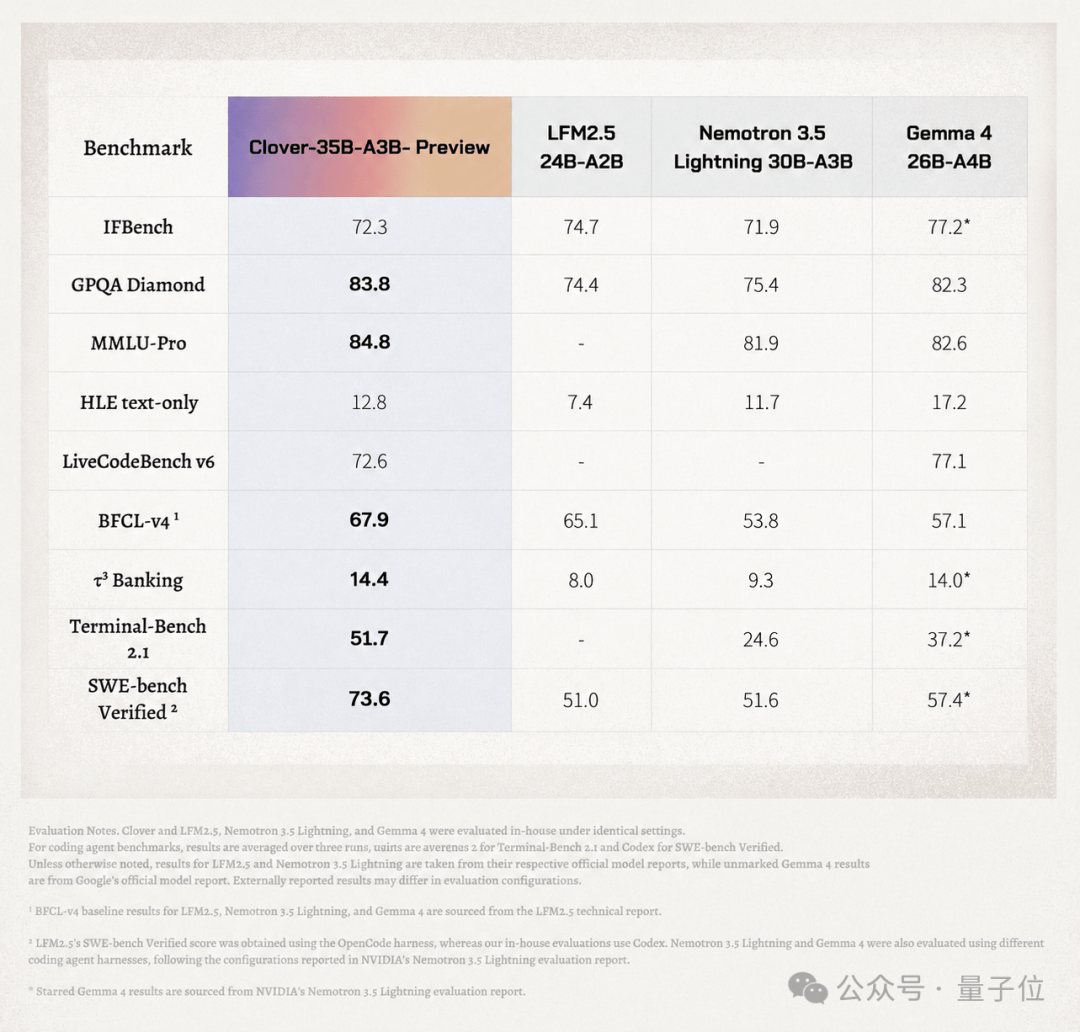
定量的ベンチマークに関しても、公式発表によると、ツール呼び出しに関連する τ³ Overall と BFCL-v4 のテストにおいて、それぞれ 65.3 と 67.9 のハイスコアを記録し、上位にランクインしている。
画像出典:拡散智能
エージェント性能に続いて、コード生成能力も見てみよう。
このテストでも、Clover は十数秒ほどで、構造が整いインタラクティブ性も備えたパーソナルエージェントの Web UI を構築してみせた。
権威あるコードベンチマークにおいても、Clover は際立った結果を残している。
実際のコードリポジトリにおける問題解決能力を測る SWE-bench Verified で 73.6 点を獲得し、ターミナル環境でのタスク実行能力を評価する Terminal-Bench 2.1 でも 51.7 点を記録した。
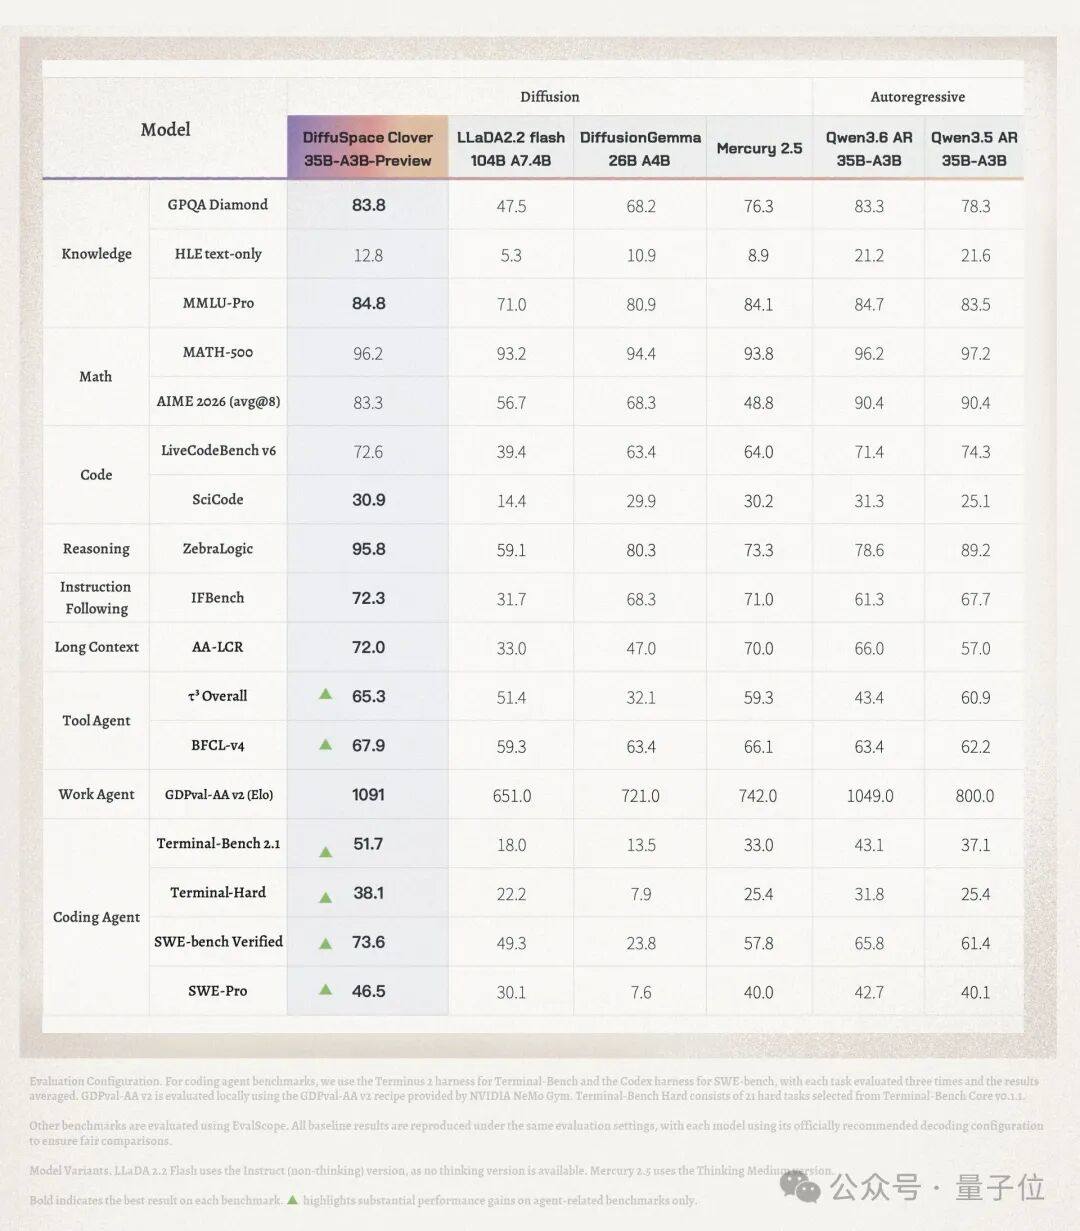
画像出典:拡散智能
UI の生成、ツールチェーンの呼び出し、エンドツーエンドの業務フローの遂行、そしてコアなコードベンチマークに至るまで、拡散言語モデルである Clover は、従来主流のエージェントが担ってきたタスクの大半をすでに実用レベルでこなせるようになっている。
そこで当然生じるのが、「ノイズ除去や画像生成に特化しているはずの拡散メカニズムが、言語モデルへと応用された際、一体どのようにテキストを生成し、コードを記述しているのか?」という疑問だ。
拡散言語モデルとは何者なのか?
普段私たちがよく目にする自己回帰型(Autoregressive、AR)の大規模モデルは、直前の文脈に基づいて次のトークンを1つずつ順番に予測していく、いわば「言葉のしりとり」のような方式で生成を進める。
ここでのトークンとは、モデルが言語テキストを処理する際の最小単位のことだ。
逐次的に単語を繋げていく自己回帰モデルとは異なり、拡散言語モデルはまったく異なるアプローチをとる。複数の位置を同時に更新し、複数回のデノイズ(ノイズ除去)を繰り返しながら段階的に最終的なテキストを作り上げていくのだ。
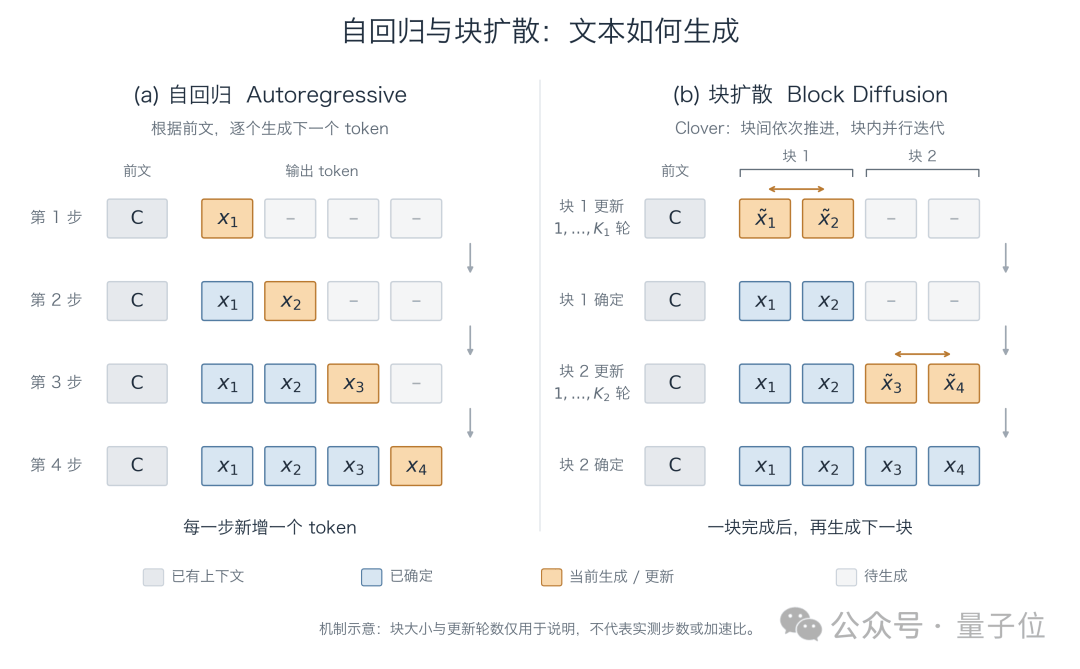
画像出典:AI 生成
言語タスクにおける拡散デノイズとは、マスクされた状態やランダムなノイズが乗った状態のコンテンツを、文脈に即した意味のある単語や文章へと段階的に復元・調整していくプロセスと捉えることができる。
Clover が採用した具体的な手法は**「ブロック拡散(Block Diffusion)」**だ。生成対象のコンテンツをいくつかのデータブロックに分割し、ブロック間は順番に進めつつ、ブロック内の複数のトークン位置は双方向に参照し合って並列計算する。
この設計により、1 回の推論計算で複数の位置の生成を同時に推し進めることが可能となり、従来の逐次生成に伴うレイテンシを効果的に解消している。
しかし、「同時に生成できる」からといって「1 回のステップで理想的な出力が得られる」わけではない。
拡散モデルが出力を収束させるには、通常、複数回のデノイズステップが必要となる。ステップ数が少なすぎると生成内容の調整が不十分になり、逆に多すぎると計算コストが跳ね上がってしまう。
さらに、複雑なコード生成やエージェントの実行シナリオでは、インタラクションを重ねるにつれてコンテキスト長が急速に増大する。ユーザーの事前要求、実行済みのアクション、ツールからの返り値のすべてが次の意思決定に直結するため、これらの履歴情報をいかに効率よく保持・抽出できるかが性能のボトルネックとなる。
この課題に対し、Clover は「履歴メモリの読み取り」と「カレントコンテンツの生成」の役割を明確に分担させるアプローチをとった。
同モデルはブロック拡散技術をベースにゲーテッド Delta ネットワーク(GDN: Gated Delta Network)を再構築した。生成済みの長いコンテキストを常に更新される隠れ状態へと動的に圧縮して後続処理で高速に取り出せるようにする一方で、現在生成中のブロックに対しては双方向アテンション機構を用いて、ブロック内のトークン同士が相互に参照・調整できるようにしている。
同時に Clover は、履歴メモリの検索を独立した特徴ユニットとしてカレントトークンのアテンション計算に直接組み込むことで、モデル自身が履歴コンテキストと現在の生成重みのバランスを自律的に学習できるようにした。また、学習可能なブロックサイズ調整機構を導入し、データブロックが過大になった際に過去の情報が希釈されてしまう問題も回避している。
これら一連のアーキテクチャ調整は、並列生成速度、過去のコンテキスト保持、計算リソース効率の最適なバランスを実現するために施されたものであり、Clover が拡散言語モデルを高度なコーディングやエージェントタスクへ拡張できた技術的コアとなっている。
Clover に限らず、ここ 2 年ほど拡散言語モデルが学術界や産業界で大きな注目を集めているのは、従来の自己回帰モデルに対して以下の 2 つの明確なアドバンテージを持っているからだ。
- 並列生成の効率性:複数の位置を同時に協調生成できるため、トークンを 1 つずつ生成する際のレイテンシの壁を打破できる。頻繁なコード生成や多段階のツール呼び出しを要するエージェント環境において、極めて高いスループットのポテンシャルを秘めている。
- グローバルコンテキストの双方向協調:生成プロセスにおいて、前後の文脈を双方向に参照し合える。双方向モデリングに基づき、複数箇所をデノイズの反復の中で同期的に微調整できるため、深いセマンティックな依存関係を捉えて解きほぐす新たな道を切り拓いた。
現在、この技術領域では学術界・産業界を問わず多角的な模索が進められている。
今年、何愷明(Kaiming He)氏らが発表した ELF では、連続埋め込み空間における言語生成が探求された。Google は DiffusionGemma を発表して並列テキスト生成の実用性を検証しており、中国国内のテクノロジー企業複数社もコード生成タスクに向けた拡散言語モデルの開発を積極的に推進している。
アプローチの違いこそあれ、各社の核心的な狙いは「新たな生成パラダイムを、現場で役立つ性能上のアドバンテージへと変換すること」にある。今回の Clover の発表が持つ意義は、この技術をコード生成、ツール呼び出し、連続タスクという実践的な現場に持ち出し、その真価を直接証明してみせた点にある。
DiffuSeq から Clover へ、拡散智能のネクストステップ
Clover の開発元である**拡散智能(Diffusion Intelligence)**に話を戻そう。
拡散智能は、香港大学の孔令鵬(Lingpeng Kong)教授と博士課程の龔珊三(Shansan Gong)氏、葉佳成(Jiacheng Ye)氏らによって共同創業された。同チームの拡散言語モデル分野における研究の布石は、2022 年にまで遡る。
当時、彼らは Seq2Seq タスクを拡散メカニズムによって解決する先駆的な試みとして DiffuSeq を提案した。与えられた条件テキストに基づき、ターゲットシーケンスをエンドツーエンドで生成する手法だ。
当時ブレイクスルーとなった最大の課題は、画像などの連続データを扱う拡散アルゴリズムを、いかにして離散的な性質を持つ自然言語タスクに適応させるかという点にあった。
2025 年 4 月には、チームの中心メンバーが Dream 7B を共同発表し、拡散言語モデルの研究開発を 70 億パラメータ規模へと押し上げた。
実験データによれば、Dream 7B は汎用タスク、数学的推論、コード生成において同規模の自己回帰モデルに匹敵するベンチマークスコアを記録しただけでなく、優れたマクロプランニング能力と柔軟な非因果的生成順序の適応力を発揮した。
そして今回の Clover において、モデル規模を飛躍的に拡大させただけでなく、コーディング、API ツール呼び出し、長大なワークフローのタスク実行へとフォーカスを全面的にシフトさせた。
技術の進化パスも、初期の「いかに拡散モデルで自然なテキストを書くか」から、「いかに複雑で複合的なタスクを、速く、かつ安定してこなすか」へと進化を遂げている。
チームは現在、このアーキテクチャをマルチモーダルやエッジコンピューティングの領域へと拡張しつつある。
公式のアナウンスによると、Clover は今後マルチモーダル版をリリースし、拡散言語モデルと視覚理解、物理アクション生成との深層統合を進めるとともに、オンデバイス環境への適用検証も並行して進める予定だという。また、Acrab との緊密な連携を通じて、エッジ環境に向けたハードウェア・ソフトウェアの協調設計と低レイヤーのシステム最適化を推進している。
今後に向けて、チームは超大規模パラメータの拡散モデルの探求をさらに深め、長期的なプランニングタスクにおける安定性の向上を図るとともに、推論オペレータの最適化、量子化圧縮、デプロイの最適化を通じて、オンデバイスでの実用化を加速させていく計画だ。
Clover がもたらした新たなパラダイムを目の当たりにすると、私たちは人間の認知メカニズムそのものを改めて見つめ直したくなる。
私たちが思考するとき、それは自己回帰モデルのように一語一語を直線的に紡ぎ出しているのだろうか。それとも、まず頭の中に粗い全体のアウトラインを描き、それを段階的に研ぎ澄ませて具体化しているのだろうか——。
人間の脳のメカニズムは、果たして自己回帰と拡散、どちらに近いのだろうか。
体験リンク:
[1] https://diffuspace.ai/register