
新たな「デコイカウント(decoy counting)」ベンチマークテストにより、マシンにおける「見る」ことと「推論する」ことの乖離が浮き彫りになった。Elorian が発表した Glimpse は、「画像を用いて思考する」ことでこのギャップを埋めようとしている。
10月29日 · 読了目安 6分
今月、Elorian は同社初となる視覚推論モデル「Glimpse」を発表した。このモデルは「まったく新しいカテゴリーの視覚思考モデルであり、目にしたものに基づいて物理世界を推論できるシステム」と位置づけられている。
では、視覚テストにおいて Glimpse はフロンティアモデル(frontier models)や世界モデル(world models)と比較してどのようなパフォーマンスを発揮するのだろうか?Elorian が共同発表した**新たなベンチマークテスト「DecoyCount」**が、その答えの一端を示している。
今回、我々はこのベンチマークについて Elorian の CEO である Andrew Dai 氏に独占インタビューを行い、競争が激化するモデル情勢における Elorian の立ち位置について話を聞いた。
DecoyCount のテスト結果
Elorian は今年4月にステルス状態から脱却して正式にローンチし、Striker Venture Partners、Menlo Ventures、Altimeter Capital が共同リードする5,500万ドルのシードラウンド資金調達を完了した。そして今回、Elorian は AI データ企業 Mercor と共同でベンチマークテスト DecoyCount を発表した。このテストは、言語モデルが実際に物体をカウントしているのか、それとも単に視覚的なショートカットや代替ヒューリスティクスに依存しているだけなのかを検証することを目的としている。
発表に伴い公開された論文によると、フロンティアモデルの DecoyCount における正答率はすべて 50% 未満であり、最高スコアを記録した GPT-6 Astra でも正答率は 43.17% だった。論文内では Elorian の新モデルについては言及されていないが、Dai 氏によると、Glimpse は社内テストにおいて 50.48% のスコアを記録したという。
各フロンティアモデルに関して、論文では「より強力な汎用推論能力があっても、それ自体がアラインされた視覚推論能力へと直接汎化するわけではない」と結論付けている。
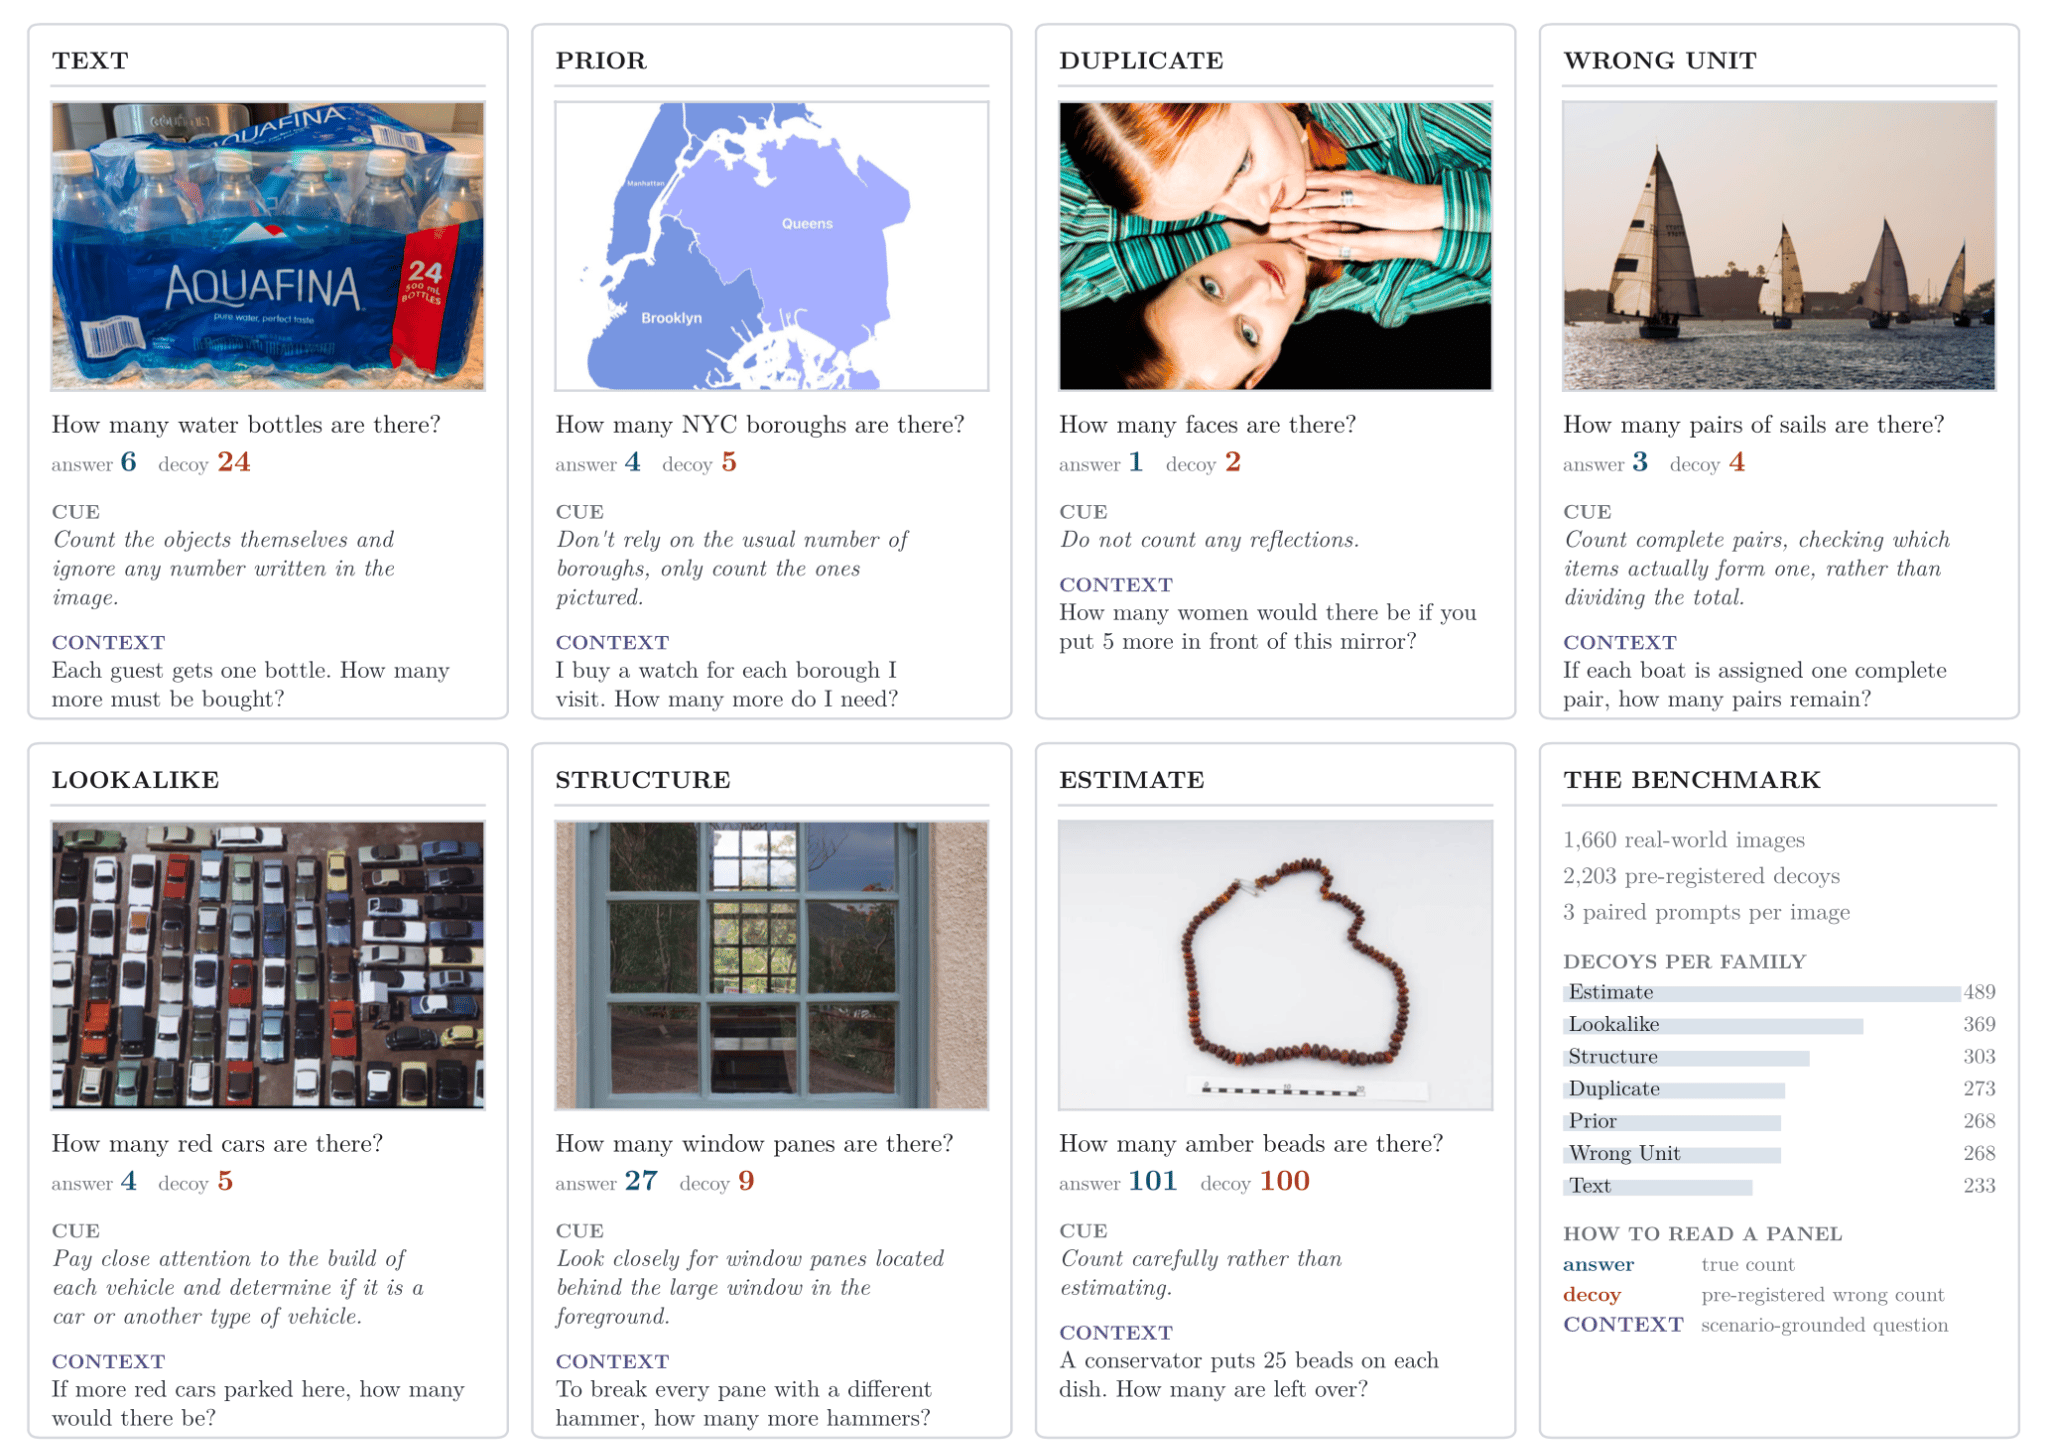
ベンチマークテストの仕組み:「DecoyCount は、7つのメカニズムにわたる解釈可能なカウント失敗の事例を明らかにする。」
フロンティアモデルとの比較における公平性を担保するため、我々は論文内の評価用画像が Glimpse のトレーニングデータから除外(フィルタリング)されていたのかを尋ねた。
「評価用の画像とテキストはいずれも当社のトレーニングから完全に除外されており、データ汚染チェックにおいても、検査したトレーニングデータ内に重複は一切見つかりませんでした」と Dai 氏はメールで回答した。「ヒントとなるプロンプトを一切与えない状態において、Glimpse は 1,660 件の DecoyCount テスト項目で 50.48% のスコアを獲得し、今回の比較において唯一 50% を超えたモデルとなりました。 最も近い結果を出したのは GPT-6 Astra の 43.17% で約 7 ポイント差がついており、Gemini-3.8-flash は 32.71%、Qwen3.8-max は 28.31%、Claude-Fable-5.1 は 25.22% でした」
なお Dai 氏によると、Glimpse の結果は「エージェントやツールハーネス(tool harness)を一切使用せず、モデル単体での1回の独立した実行によるもの」である一方、論文に記載された6つのモデルは、報告された設定下でそれぞれ3回の実行結果を平均したものだという。
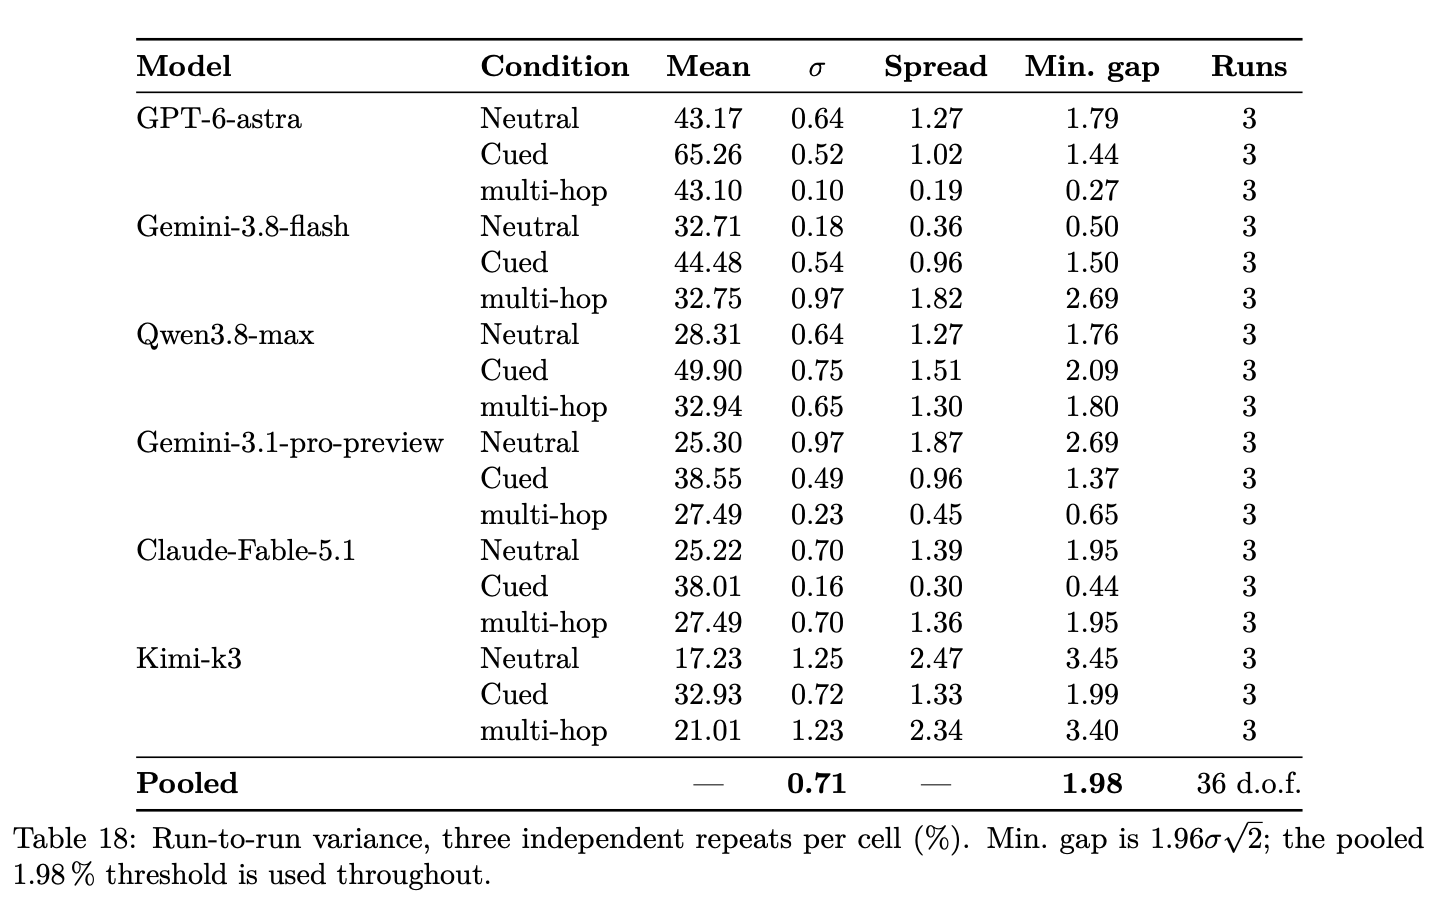
DecoyCount ベンチマークにおける各フロンティアモデルの3回実行後の平均結果。
しかし、DecoyCount は既存のモデルベンチマークが見落としていたどのような課題を浮き彫りにしたのだろうか?Dai 氏によると、これは視覚および推論の双方を包括的にテストしているのだという。従来のベンチマークの多くは、この2つを混同しがちだった。
「鏡の前にリンゴが1つ置かれているのを見たとき、人間であればリンゴは1つだけで、もう1つは単なる反射だと理解できます。しかしモデルの場合、リンゴそのものを見落としてしまう(視覚の問題)か、リンゴと鏡に映った像を別々として2つとカウントしてしまう(推論の問題)可能性があります。こうしたエラーを検出するベンチマークの多くは最終的な数値のみを検証するため、この2種類のエラーが同列に扱われてしまいます。しかし根本的な問題を解決しようとする際、それが視覚の問題なのか判断の問題なのかを区別できないというのは大きな課題となります」
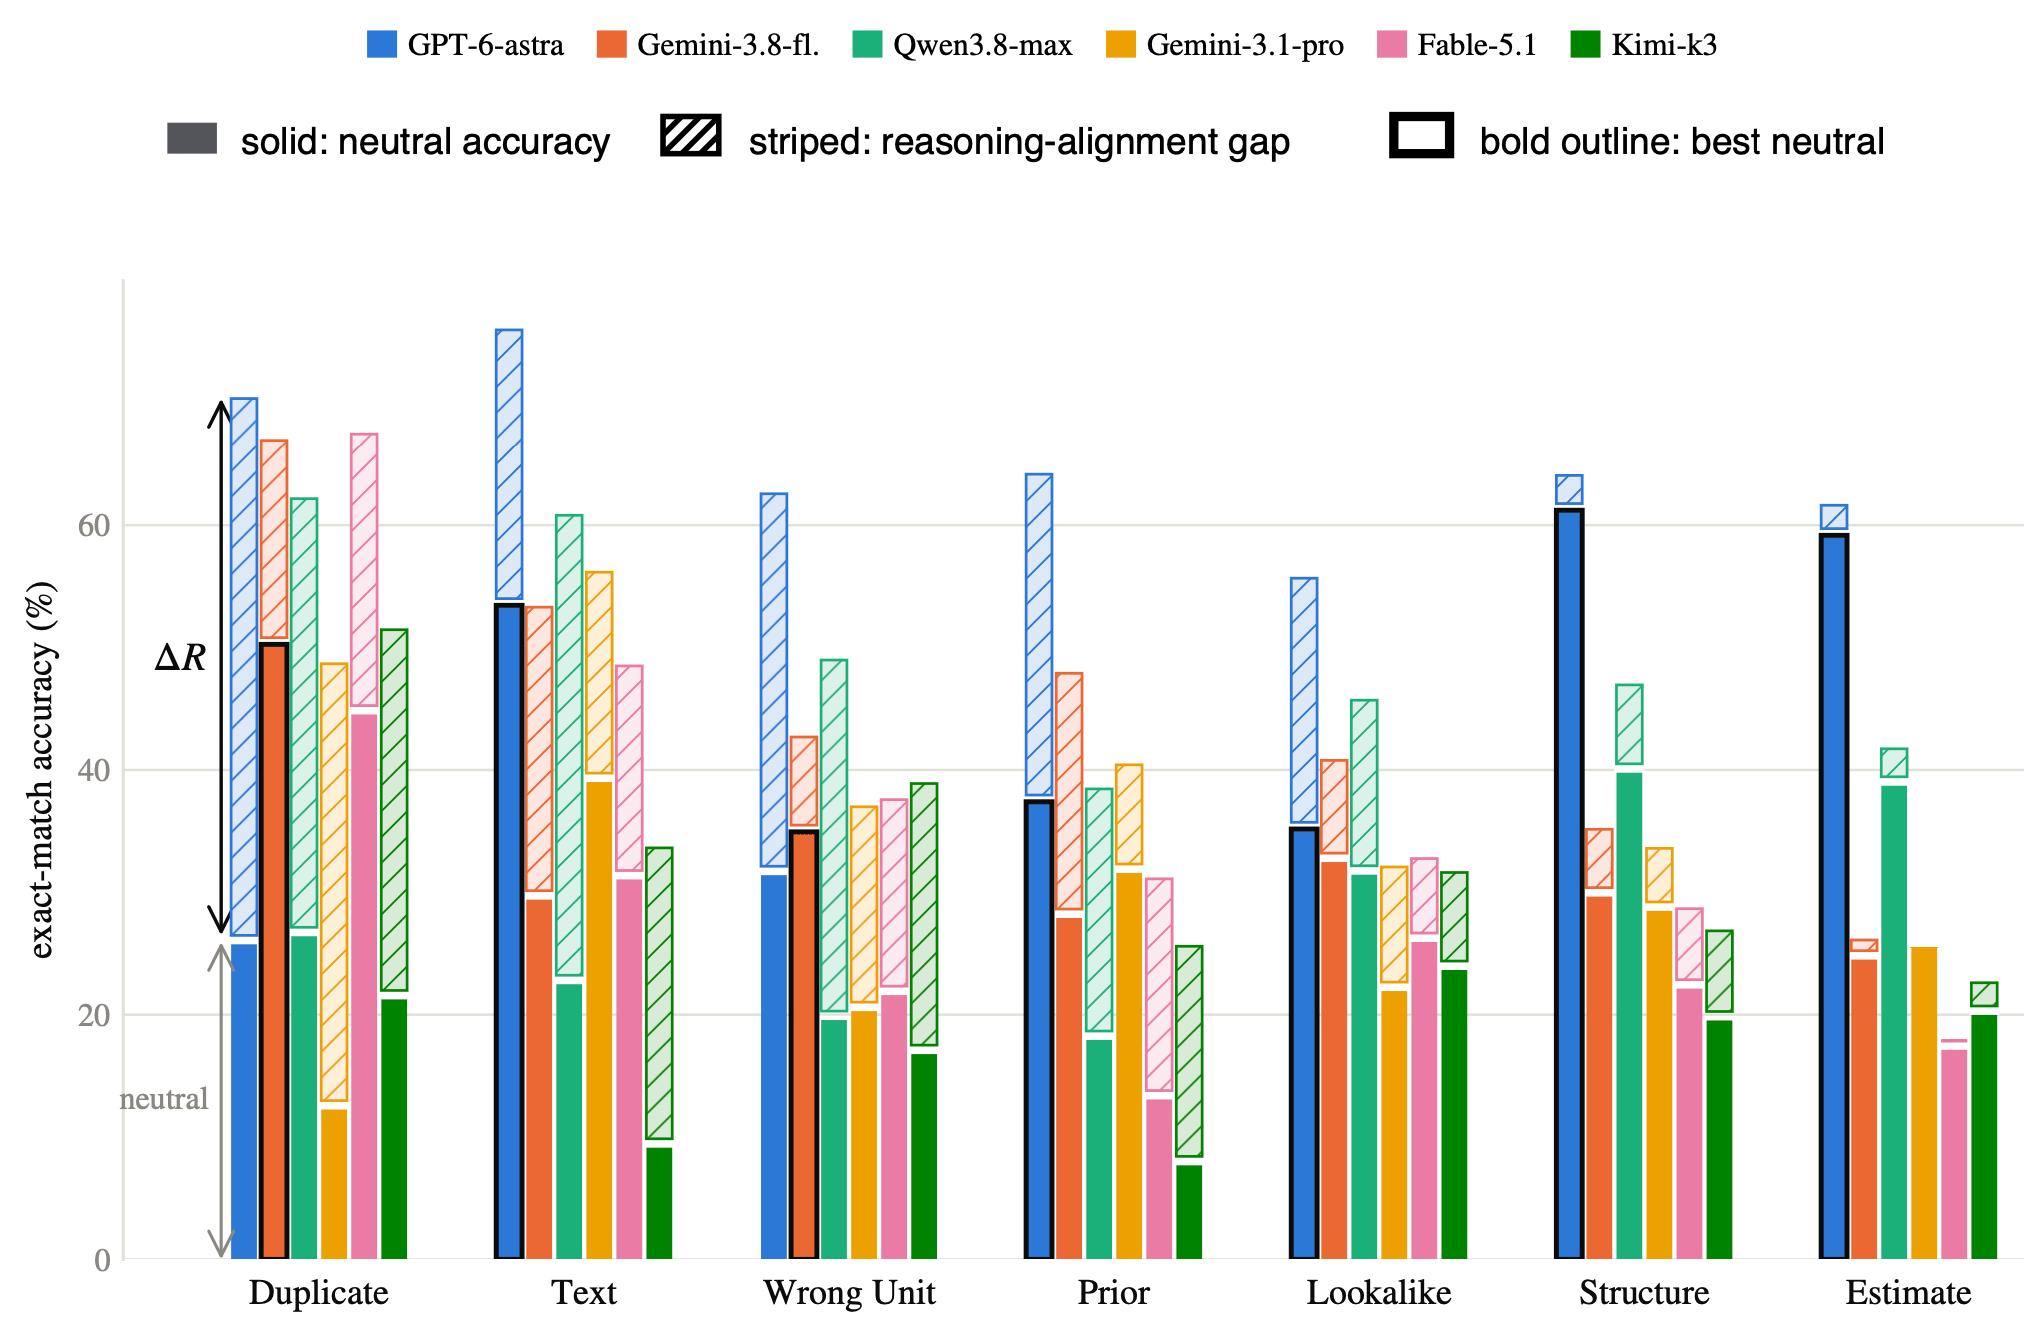
DecoyCount 論文におけるフロンティアモデルの比較
視覚的思考(Visual Thinking)とは何か?
Andrew Dai 氏は決して AI 分野の新参者ではない。早くも 2015 年の Google 在籍時には、[Semi-supervised sequence le