
H200とThor T5000に真っ向勝負
金磊 上海発
中国製チップ界における「真の勇者」と呼びたい。
事の顛末はこうだ。
ある中国製チップ企業が、自社イベントの現場で自社製GPUをNVIDIA H200と直接対決させ、正真正銘のガチンコ実測対決を繰り広げたのだ。
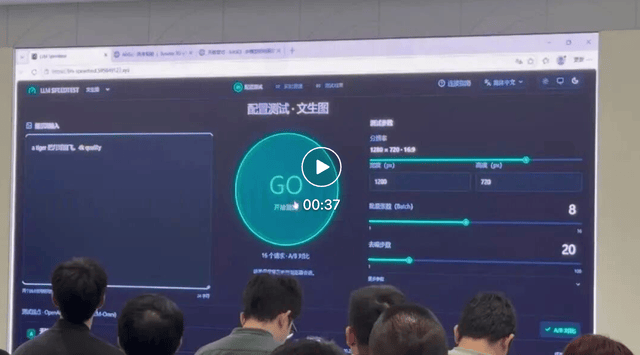
さらに筋金入りだったのは、テストのお題があらかじめ用意されたものではなく、会場の来場者をランダムに選んでその場で出題してもらった点だ。
例えば**画像生成(Text-to-Image)**テストでは、来場者から「トラが月を蹴り飛ばす」というプロンプトが出された。
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
結果、この中国製GPUは見事に勝利を収めた。生成にかかった時間はわずか95.6秒で、NVIDIA H200の112秒を上回ったのだ。
それだけでは終わらない。
上記のテストはクラウド環境で実施されたものだが、同社は続けて手のひらサイズのシルバーのデバイスを取り出し、エッジ側で完全にネットワークを切断したオフライン状態で、NVIDIAのロボティクス向けコンピューティングプラットフォーム「Jetson Thor T5000」との直接対決に挑んだ。
このテストも同様に来場者からランダムに出題され、今回のお題は「ライオンとトラが一騎打ちしたら、どちらが勝つか?」というものだった。
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
一目瞭然で、この中国製デバイスの推論応答速度はThor T5000よりも明らかに速かった。
この中国製チップ企業こそ、**天数智芯(Iluvatar CoreX)**である。
クラウド側でH200を打ち破ったのは主力製品の「天垓(Tiangai)300」、エッジ側でThorを破ったのはエッジコンピューティング製品「彤央(Tongyang)TY1200」だ。
さらに天数智芯は同イベント内で、「AIでAIを開発する」を掲げるソフトウェアスタック「天数智算ソフトウェアスタック」も発表した。
同社に注目している業界人なら覚えているかもしれないが、今年1月、同社が上場を果たしてわずか半月のタイミングで、彤央シリーズのエッジ向け製品4機種を一挙に発表していた。当時すでにTY1000の実測性能はNVIDIA AGX Orinを超えていた。
同日、天数智芯は4世代にわたる製品アーキテクチャのロードマップも公開していた。第1弾としてHopper超えを目指す「天枢(Tianshu)アーキテクチャ」を掲げ、その後はBlackwellやRubinアーキテクチャに対抗していく計画だ。
それから9か月余り、天数智芯は約束通りに答えを出してみせた。
天垓 300はまさにこの天枢アーキテクチャをベースに構築されたもので、今回のターゲットはHopperファミリーのフラッグシップであるH200だ。エッジ側のターゲットも、Orinからさらに高性能なThorへと引き上げられている。
クラウド、ソフトウェアスタック、エッジという「3つの軸」を同時に推進する理由について、天数智芯のコアロジックは以下の通りだ。
クラウドがインテリジェンスを生み出し、ソフトウェアスタックが適合の加速と性能の最適化を担い、エッジがそのインテリジェンスを工場、研究室、病院といったリアルの物理空間へ落とし込む。
天数智芯はこの3つが密接に噛み合ってこそ、同社が定義する「高品質な計算能力(高品質算力)」――すなわち高効率、予測可能性、そして持続可能性を備えたコンピューティングパワーが成立すると考えている。
以下、今回の実測対決の詳細を解説する。
天垓 300:H200をターゲットに実測結果で証明
まずはクラウド向けフラッグシップの「天垓 300」から見ていこう。
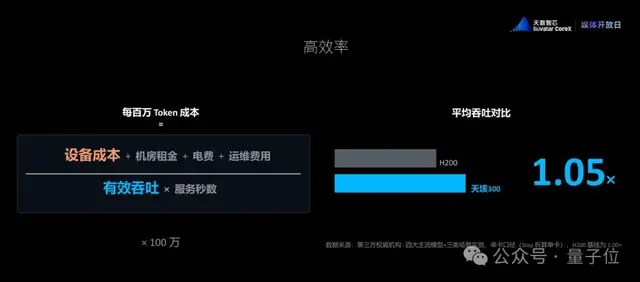
このチップの公開は今回が初めてではない。早くも今年7月、権威ある第三者評価機関が4大主流LLMと3つの代表的なユースケースを対象に、天垓 300の包括的なテストを実施していた。
LLMの定番構成であるPrefill-Decoding(PD)分離デプロイ環境において、天垓 300の1基あたりの実効エンドツーエンドスループットはH200の1.05倍に達した。
注目すべきは、このテストが理論上のピーク計算性能を比較したものではなく、入力から出力まで推論パイプライン全体で実際に吐き出されたTokenのレートを測定した点だ。
天数智芯によると、天垓 300は実測性能でH200の水準に達した中国初の汎用GPUとなったという。
汎用GPUとして、天垓 300はトレーニングと推論の両面で強力な実力を備えている。
まずは推論性能から見ていこう。
現在のLLMにとって、長いコンテキストの処理は越えなければならない壁だ。天数智芯のAI・アクセラレーテッドコンピューティング担当責任者である単天逸氏は、会場でわかりやすい例えを挙げた。
付き合って10周年の記念日に、女性が男性へ『この10年間で一番忘れられない瞬間は何?』と聞いたとき、男性が3650日の記憶を最初から最後まで全部思い出すことはあり得ません。脳裏に浮かぶのは、いくつかの決定的な瞬間だけのはずです。
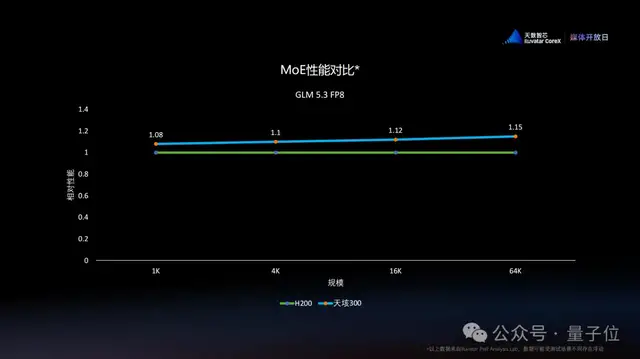
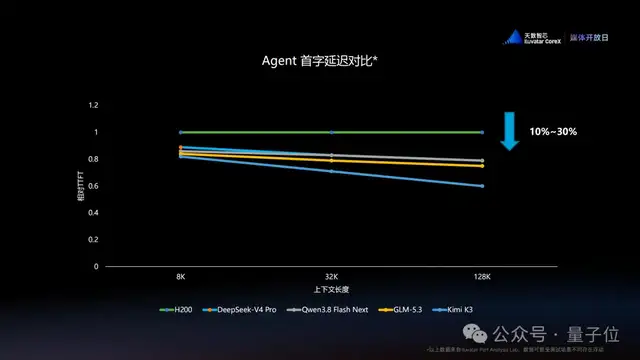
これこそがAttention(注意機構)の核心的な役割であり、天垓 300もこの処理に特化した最適化を行っている。実測データによると、64Kのコンテキスト長でGLM-5.3を実行した際、そのMoEスループットはH200の1.15倍に達した。また、8K〜128Kのロングコンテキスト環境では、AIエージェントのファーストトークンレイテンシ(TTFT)がH200比で**10%〜30%**短縮された。
次にトレーニング性能だ。
Qwen3-32Bをベースとした8基構成のFP8トレーニングタスクにおいて、天垓 300の1基あたり実効スループットはH100の1.33倍を記録した。会場で披露された100倍速のコマンドライン画面の録画では、天垓 300が先に所定のステップ数を完了する一方、H100はまだ実行中という様子が映し出された。
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
通常の事前学習だけでなく、天垓 300は強化学習タスクもしっかりとこなせる。これは現在の主要LLMにおいて中核となっているポストトレーニングの手法だ。
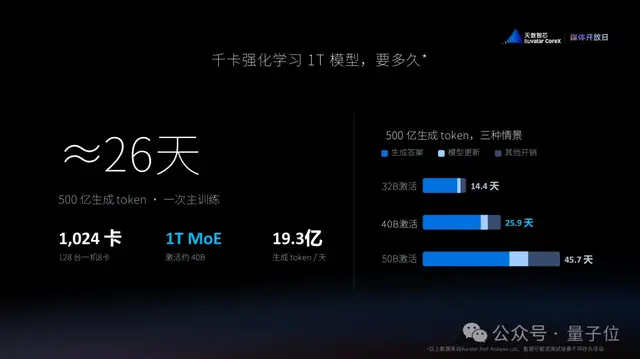
天数智芯のエンジニアリング試算によると、天垓 300を1024基配備すれば、総パラメータ1T・アクティブパラメータ40BのMoEモデルに対し、約26日で1サイクルの完全な強化学習トレーニングを完了できるという。これはLLM開発企業が約1か月に1度アップデートを行う開発ペースに過不足なく合致する。
推論やトレーニングだけでなく、現在大きな注目を集めている「Tokenファクトリー」の構築に対しても、天垓 300はソリューションを提示している。
Tokenファクトリーを建設する際、ハードウェア設備への支出は総投資額の約75%〜80%を占める。ハードウェアの初期投資を削減するのが難しい以上、1基あたりのアウトプットが高く、稼働が安定しているほど、1Tokenあたりの限界コストを抑えることができる。
アウトプットの効率については、前述の1.05倍というスループットの優位性ですでに証明されている。一方、稼働の安定性において鍵を握るのが「ステップ時間の変動率」だ。
フル負荷稼働時、天垓 300のステップ時間変動率はわずか**0.43%**であり、対照群となったHopper構成の0.76%を下回った。これは、長時間の超高負荷環境に直面しても、天垓 300がきわめて安定した性能出力を維持できることを意味している。
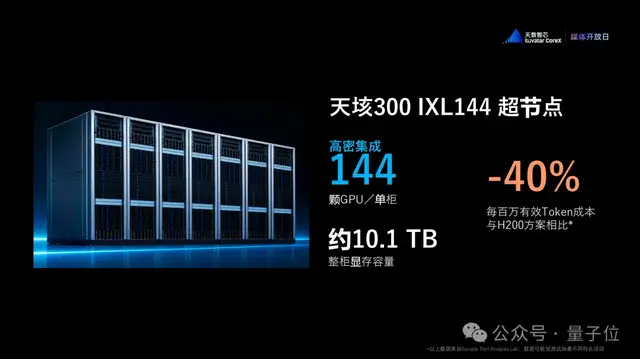
超大規模クラスタの配備に向けて、天数智芯は「IXL144 スーパーノード」を投入した。
このソリューションは、単一の標準ラック内に144基のGPUを統合し、総VRAM容量は約10.1TBに達する。現時点で業界最高クラスの計算密度を誇るシングルラックGPUスーパーノードだ。公式の試算によれば、同等規模のH200構成と比較して、有効Token100万個あたりのコストを約40%削減できるという。
単体性能に加え、天垓 300のエコシステムのオープンさにも注目したい。
天垓 300は、NVIDIA H100やH200とのハイブリッドな異種混合トレーニングをサポートするだけでなく、他社製チップとの連携動作も可能だ。
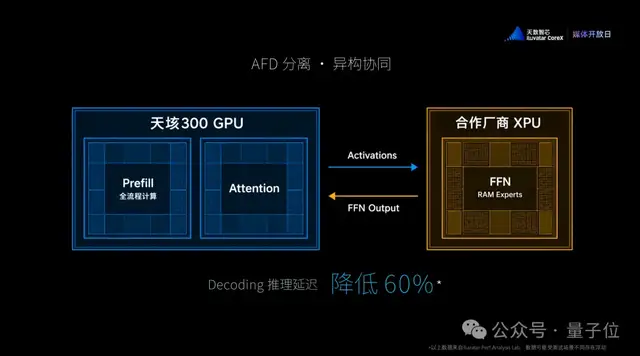
デモでは、中国国内初となる「GPU + XPU」異種AFD分離デプロイソリューションの実演に成功した。天垓 300がPrefillとAttention計算を担い、パートナー企業のXPUがFFN計算を担当することで、Decodingフェーズの推論レイテンシを実測で60%削減した。
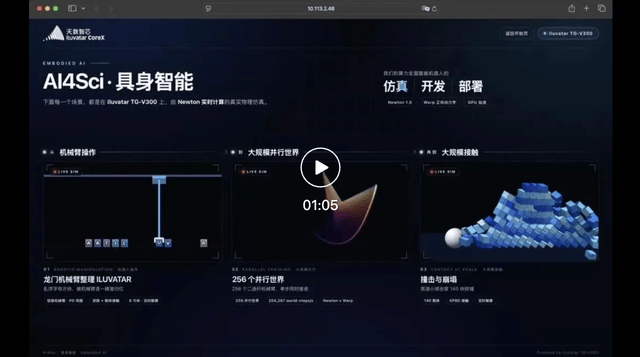
LLMのベンチマークテストにとどまらず、会場ではさらにハードな物理シミュレーション能力も披露された。単天逸氏の考えでは、AI技術はTransformerにとどまるものではなく、計算用チップが低レイヤーアルゴリズムの探求を制限してはならないという。そのため、会場では3つのシミュレーション事例が実演された。
1つ目は、1基の天垓 300による門型クレーン稼働のリアルタイムシミュレーションだ。スライダーの摩擦力、巻き上げ速度、応力ダイナミクスがすべてチップ上でリアルタイムに計算された。
2つ目は、256組の2リンク機構を同一モデルに接続して実施した強化学習だ。これは256個の並行した仮想環境を構築して同時に試行錯誤を行うことに相当し、GPUの並列計算能力に極めて高い要求が課される。
3つ目は、高密度なスライダー衝突実験だ。140個のスライダーが衝突し合って力を伝達し合う状況で、衝突が起きるたびに全スライダーの力学計算を同時に完了させなければならない。
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
一見すると基礎的な物理アニメーションのシミュレーションに見えるが、これらは実際には具現化AI(Embodied AI)ロボットが現実世界へと足を踏み入れる前に必ず経なければならないシミュレーショントレーニングの基盤なのだ。
彤央 TY1200:300Tの高密度計算力でThor T5000を逆転
視点をエッジ側に移そう。
前述の通り、彤央 TY1200の直接のターゲットはNVIDIA Jetson Thor T5000だ。
天数智芯の彤央製品マーケティング責任者である宋遠盈氏は、Thor T5000はエッジ分野におけるNVIDIAの非常に競争力の高いフラッグシップであり、公称演算性能は2070 TFLOPS(FP4 スパース)だと述べる。対するTY1200の公称演算性能は300 TOPSであり、こちらはデンス(密)な計算性能となっている。
机上のカタログスペックだけを比較するとTY1200が優勢とは言えず、宋遠盈氏も換算後のTY1200の公称スペックは確かにThorより低いと率直に認めている。
しかし、実際のワークロードテストでは逆転現象が起きた。LLM「Qwen3.8-27B」を実行した際、TY1200の性能はThor T5000の**138%に達した。また、MoEアーキテクチャの「Qwen3.6-35B-A3B」のテストでも110%**を記録した。
さらに注目を集めたのは、NVIDIAがオープンソース化した世界モデル「Cosmos」での結果だ。「Cosmos-R2-2B」において、TY1200の動作パフォーマンスはThorの**158%をマーク。「Cosmos-R2-8B」では、そのリードが180%**にまで広がった。
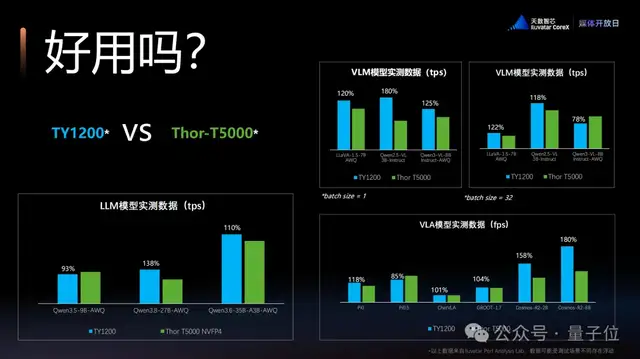
これは、NVIDIAが注力するエッジ向け世界モデルの領域において、TY1200がリードを奪ったことを意味する。
ベンチマークスコアだけでなく、会場ではTY1200の単一マシンで動作する3つの実践的なタスクも披露された。
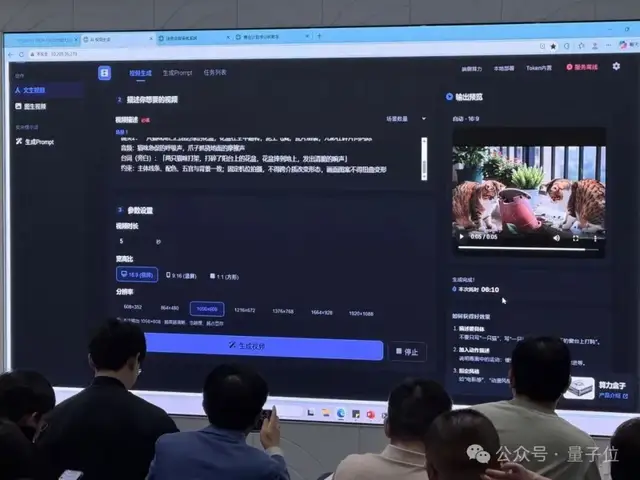
第1のタスクはローカルエッジでの動画生成だ。来場者からのランダムなお題に基づき、オープンソースの動画生成モデル「MiniMax H3」を用いて、完全にオフラインのネットワーク未接続環境下でTY1200単体で動画を生成した。
処理開始から約6分で、解像度1056×608、長さ5秒のHD動画クリップが出力された。
6分という所要時間はクラウドクラスタには及ばないものの、エッジ配備であればクラウドのキュー待ちレイテンシや予測不能なAPI利用コストを回避でき、完全なオフラインかつ追加コストなしでの推論が実現する。
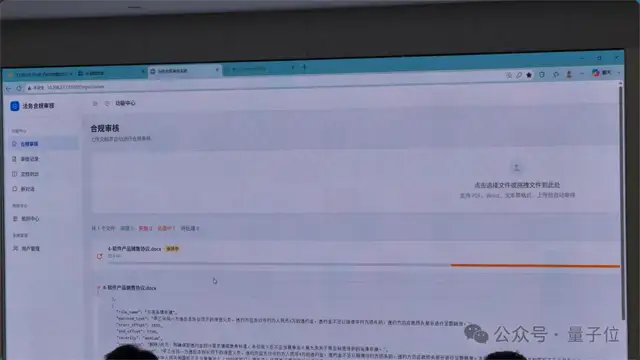
第2のタスクは契約書のインテリジェントレビューだ。
1万文字におよぶソフトウェア調達契約書を読み込ませると、TY1200はわずか2分以内に高・中・低の各種法的・コンプライアンスリスクを正確に洗い出し、詳細な法令や社内規程の根拠まで提示してみせた。
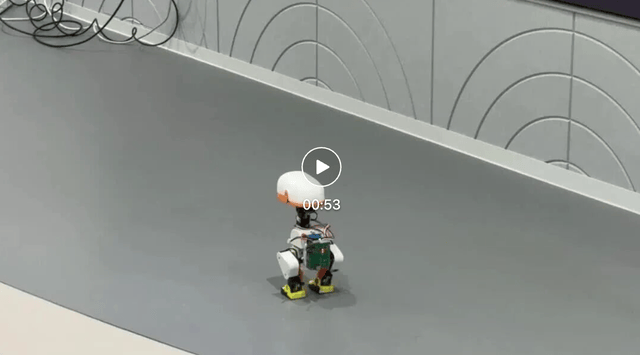
第3のタスクは、具現化AIの実機ロボット「MicroDuck(小型2足歩行ロボットダック)」への適用だ。
宋遠盈氏によると、従来の類似デモではクラウドのスーパーコンピュータを使って事前のトレーニングを行うのが一般的だった。しかし天数智芯は今回、シミュレーショントレーニング、仮想検証から実機制御へのデプロイまでのパイプライン全体を、1台のTY1200デバイス内に完結させて動作させた。
この実現のため、TY1200は中国製のエッジコンピューティングハードウェアとして初めて、MuJoCo-WarpベースのGPUアクセラレーテッド物理シミュレーション環境を稼働させた。
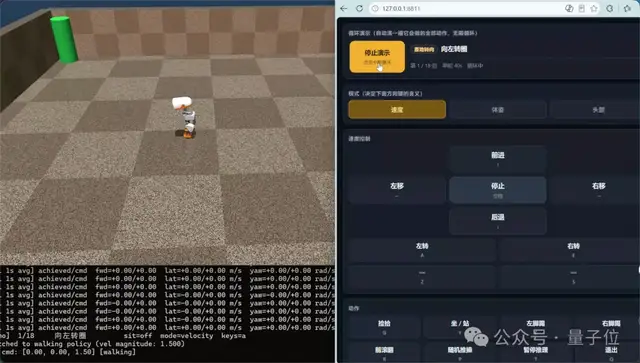
宋遠盈氏が明かしたところによると、チームが実機ハードウェアを手にしてからモデルの適合を完了するまでわずか3〜4日しかなく、事前の社内検証でも完全には動作しきれていなかったという。
しかし本番のデモでは、この2足歩行メカダックは少しふらつき一度転倒したものの、自力で起き上がり安定した歩行を見せ、期待を上回る実測成果を示した。
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
MicroDuckのほかにも、彤央シリーズは具現化AIの分野ですでに多くの実用例を持っている。
2週間前の工博会(中国国際工業博覧会)では、TY1000演算モジュールを搭載した4足歩行ロボットドッグが公開展示された。人間の遠隔操作を一切必要とせず、完全にエッジ側の計算力だけでリアルタイムな顔認識と追従を行い、すべての処理においてクラウドへのデータ送信を一切行わなかった。
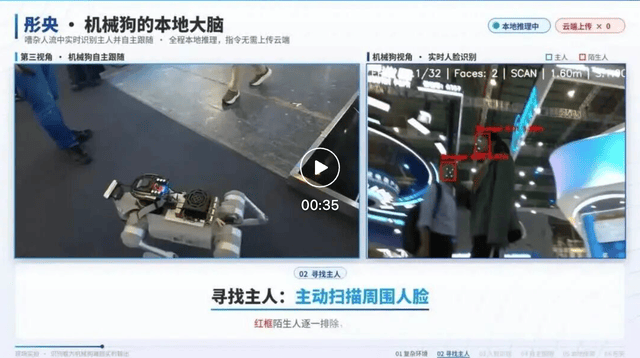
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
TY1200を搭載した医療付き添いロボットは、すでに上海市養志リハビリテーション病院(上海市陽光リハビリテーションセンター)で実地導入されている。視覚障がいを持つ患者が音声で受付の要望を伝えるだけで、ロボットが自律的に案内し、リアルタイムに障害物を検知して回避する。
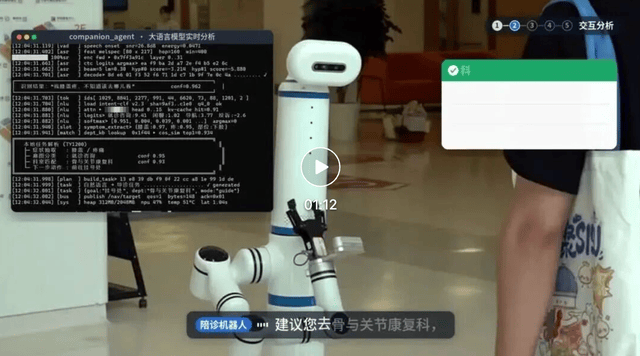
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
イベントの最後に宋遠盈氏は、次世代エッジフラッグシップ製品「TY2000」の開発計画も公表した。公称演算性能はさらに引き上げられ、600 TOPSに達する見込みだ。同氏は次のように締めくくった。
クラウドGPUメーカーがエッジ領域へ進出する本質は、チップを単に小さくすることではなく、コンピューティング能力を全面的に現場へと行き渡らせることにある。
ベテランエンジニアのノウハウを、すべての開発者へ
ハードウェアスペックの向上は続いているものの、エコシステム内の開発者にとって最大のボトルネックは、開発体験と使いやすさにある。
天数智芯のバイスプレジデント兼ソフトウェア開発責任者の石加聖氏は、壇上で分かりやすい対比を語った。
昔、DOS環境で『仙剣奇侠伝』や『大富翁3』を動かそうとしたとき、ユーザーは複雑なハードウェア割り込みやメモリ設定を何度も調整しなければ、ゲームを起動することすらままなりませんでした。
同氏の見解では、現在のAIクラウドシステムはある意味でかつてのDOSのジレンマを再現しているという。異種混合のCPU、多様なインターコネクトトポロジー、そして煩雑なOS環境が、開発者にとって大きな障壁となっているのだ。
そこで天数智芯は、AIをソフトウェアインフラ層へ全面的に導入するという道を選んだ。
新世代の天数智算ソフトウェアスタックは「Agentic AI(エージェント型アーキテクチャ)」を深く取り入れ、これまで数百社の企業顧客を支援する中で蓄積してきたエンジニアリングチューニング手法を、モジュール化された一連の「Skills」として抽象化した。開発者はビジネスゴールを明確にし、制約条件を設定するだけで、その後の環境構築はすべてAIエージェントが自律的に実行する。開発者は要所での最終確認を行うだけで済む。
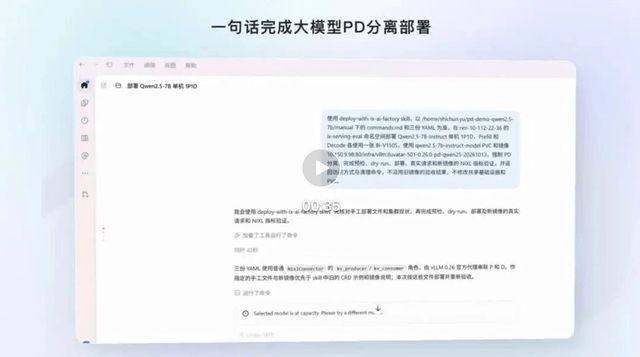
動画URL:
https://mp.weixin.qq.com/s/Non20tfUB860KjNQkW3LZQ
例えば、環境構築とPD分離クラスタの立ち上げを例に挙げると、従来の手作業による設定では通常1時間以上かかっていたものが、エージェントの協調動作によって全プロセスが10分以内に自動完了し、手動のやり取りも数十ステップからワンステップの承認作業へと簡素化された。
コンピューティング性能のチューニングも同様にインテリジェントなフルマネージド化を実現した。
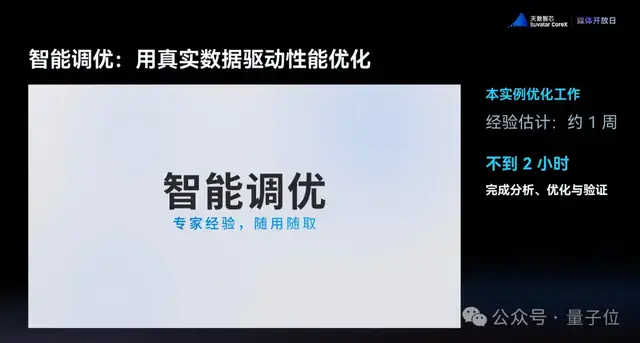
エージェントは天数智芯の内蔵プロファイリングツールを自律的に呼び出し、計算のボトルネックを自動特定して最適化戦略を生成し、クローズドループ検証を開始する。あるLLMのチューニング実例では、通常1週間を要していたエンジニアリング作業が、わずか2時間で「分析・最適化・検証」の全工程を完了し、モデルの実行パフォーマンスをほぼ倍増させた。
カスタムオペレータ(Operator)開発の分野においても、天数智芯は「FlyDSL」コンパイラフレームワークを深く統合した中国初のGPGPUメーカーとなり、AIモデルを活用した低レイヤーのオペレータコードの自律生成、コンパイル、検証、チューニングを実現した。
ある主流ディープラーニングモデルへの適合チューニングでは、本来なら10人日かかると見積もられていた作業量が、エージェントの支援により2時間足らずで完了した。計算精度とスループット性能はいずれも納品基準を満たし、コンパイルの待機時間は90%以上も大幅に短縮された。
