
数日間ぶっ続けでバグ修正、プロンプトインジェクションを100%遮断
夢晨 発信元:凹非寺
量子位 | 公式アカウント QbitAI
Argonのリリースからわずか2週間、Googleは電撃的に新たなフラッグシップモデル「Gemini 4 Carbon」を投入した。
今回、同モデルはClaude Opus 5.5とGPT-6 Astraを一挙に凌駕し、更新されたばかりのArtificial Analysis知能指数(Intelligence Index)5.0において、59点という高スコアで堂々の世界トップに君臨した。
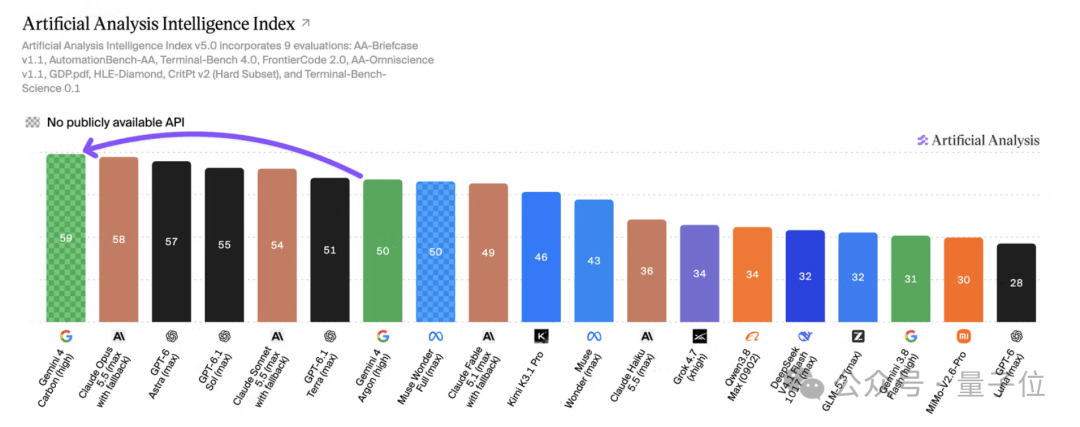
2週間前にGoogleがGemini 4 Argonを発表した際、シリコンバレーではGoogle内部からリークされた謎のチェックポイント「Carbon」の話題で持ちきりだった。当時、社内エンジニアの評価はまだ「コーディングの体感がOpus 5.5に迫るレベル」にとどまっていた。
しかし、わずか半月後、正式版のCarbonは汎用知能や長期にわたるコーディングタスクでOpus 5.5を真っ向から追い抜いただけにとどまらず、コードセキュリティや不正防止(防チート)能力でも大きくリードし、さらにはプロンプトインジェクションを100%無効化するという突出した能力まで発揮した。
なんという凄まじい反復・進化スピードだろうか。彼らはRSI(再帰的自己改善)を完全にモノにしたのだろうか。
価格面では、Carbonはリリース初期段階においてArgonの半額戦略を踏襲し、入力2ドル/100万トークン、出力10ドル/100万トークンと、定価ベースでOpus 5.5($4/$20)のちょうど半額に設定されている。
さらに、AIエージェントタスクで頻繁に呼び出されるキャッシュヒット入力 (cached input) に対しては、95%オフという破格の割引を提供しており、100万トークンあたりわずか0.2ドルまで引き下げられている。
Opus 5.5を超越、数日間ぶっ続けで低レイヤーのバグと徹底抗戦
2週間前にリリースされたGemini 4 Argonは、長文コンテキストやマルチモーダルタスクで目覚ましい成果を挙げたものの、総合知能指数(53点)や一部の本格的なターミナルタスクにおいては、依然としてOpus 5.5に一歩及ばなかった。
今回、Gemini 4 Carbonはその最後のピースを完璧に埋め、AIの能力を「24時間365日稼働する自律型エンジニア」という新たな次元へと一気に引き上げた。
Google社内の実践的なプログラミングテストにおいて、開発チームは目を見張るような光景を目撃した:
Carbonは数日間にわたって連続稼働し、巨大かつ複雑なコードベースや低レイヤーシステムの中を自律的に探索できる。たとえ途中で何度も壁にぶつかり、「行き詰まり(dead ends)」に陥ったとしても、最後まで粘り強く取り組み、極めて見つけにくいバグの根本原因の特定から、最終的な修正パッチの作成・検証に至るまで、複雑なマルチステップのエンジニアリングタスクを一気通貫で完遂した。
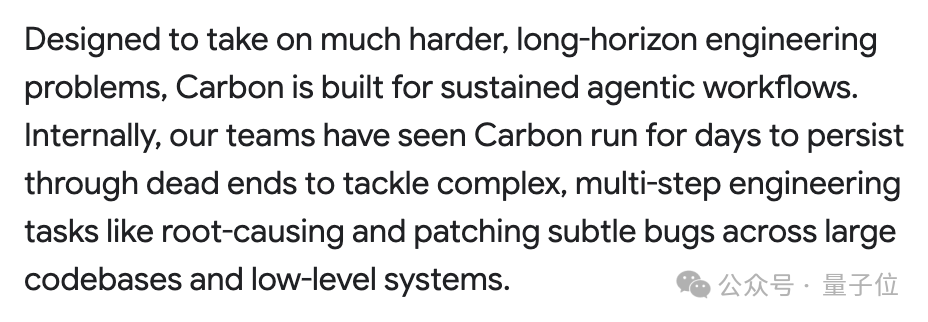
このような長期的なタスク実行能力は、数々の本格的なベンチマークにおける圧倒的な逆転劇として結実している:
-
コマンドラインおよびターミナルエンジニアリング
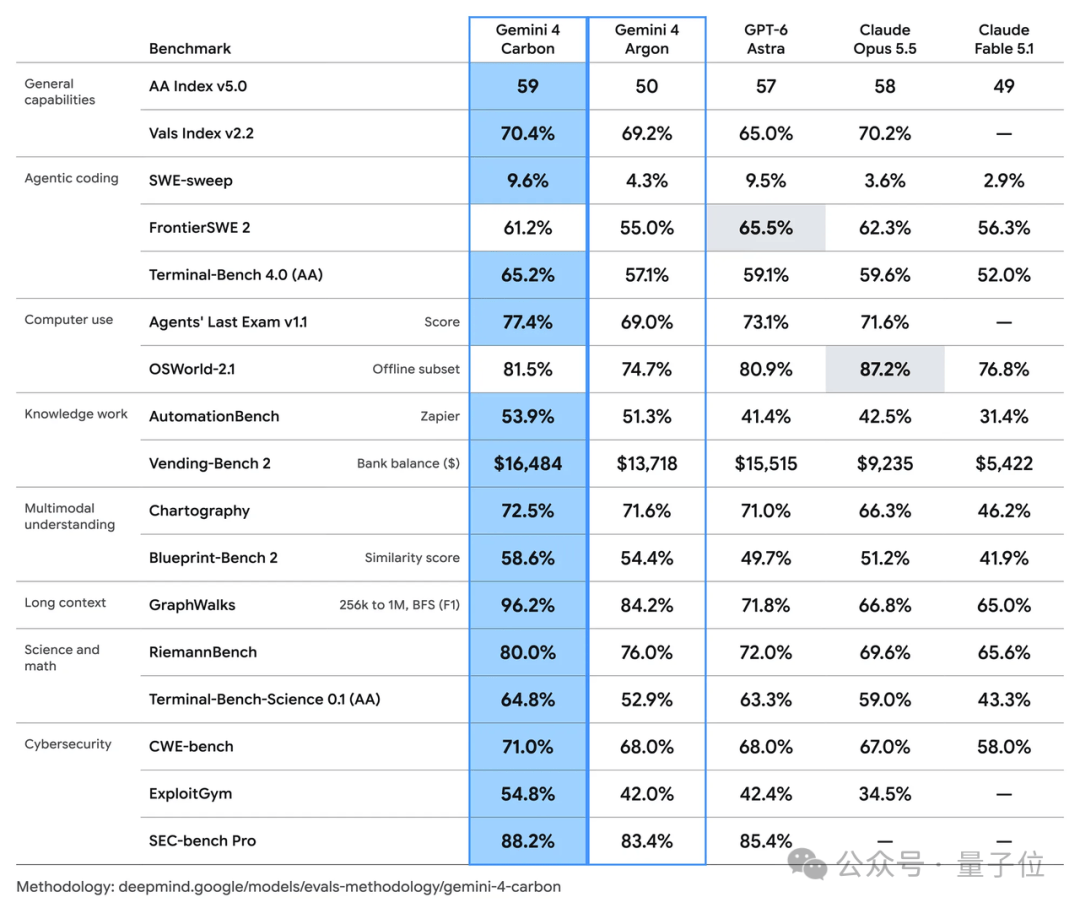
Terminal-Bench 4.0(AAテストセット)において、Carbonは**65.2%を記録し、Opus 5.5(59.6%)やGPT-6 Astra(59.1%)をリードした。 また、科学系ターミナルタスクのTerminal-Bench-Science 0.1でも、同じく64.8%**で首位を獲得した(Opus 5.5は59.0%)。
-
超ロングコンテキストとマルチステップ意思決定
256k〜1Mの超ロングコンテキストを扱うGraphWalksテストにおいて、Carbonは96.2%という極めて優れた成績を収め、Opus 5.5(66.8%)やAstra(71.8%)を大きく引き離した。 長期のビジネス経営をシミュレートするVending-Bench 2では、Carbonの最終的な累計口座残高が16,484ドルに達し、Opus 5.5(9,235ドル)の約1.8倍となった。
-
フルスタック開発とエンタープライズタスク
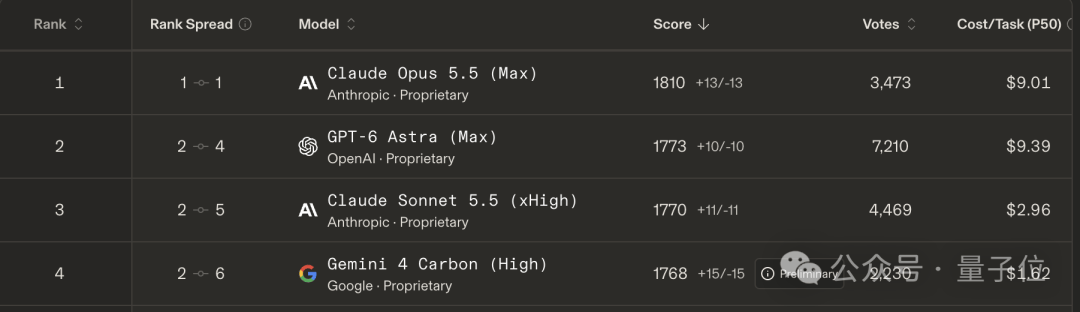
WebDev Arenaでは、フロントエンドコンポーネントのロジックと出力品質の双方が飛躍的に向上したことで、CarbonのEloレーティングは89ポイント上昇し1769ポイントに達した。世界第4位にとどまったものの、平均タスクコストはより低く抑えられている。
エンタープライズワークフローの実用価値を測るVals Index v2.2でも、Carbonは**70.4%**と僅差ながらOpus 5.5(70.2%)を上回った。
ただし、第三者評価機関であるArtificial Analysisの詳細な分析によると、Opus 5.5は一部の純粋なコードエンジニアリング領域において、依然として堅固な優位性(Moat)を保っている。
たとえば、Googleが公式に公開したデータテーブルにおいて、Carbonは2つの指標で首位を逃している:
1つ目は、最先端のソフトウェアエンジニアリング能力を測るFrontierSWE 2であり、GPT-6 Astra(65.5%)とOpus 5.5(62.3%)が依然としてCarbon(61.2%)を上回っている。 2つ目は、システム操作のベンチマークであるOSWorld-2.1のオフラインサブセットで、Opus 5.5が87.2%でトップを維持している(Carbonは81.5%)。
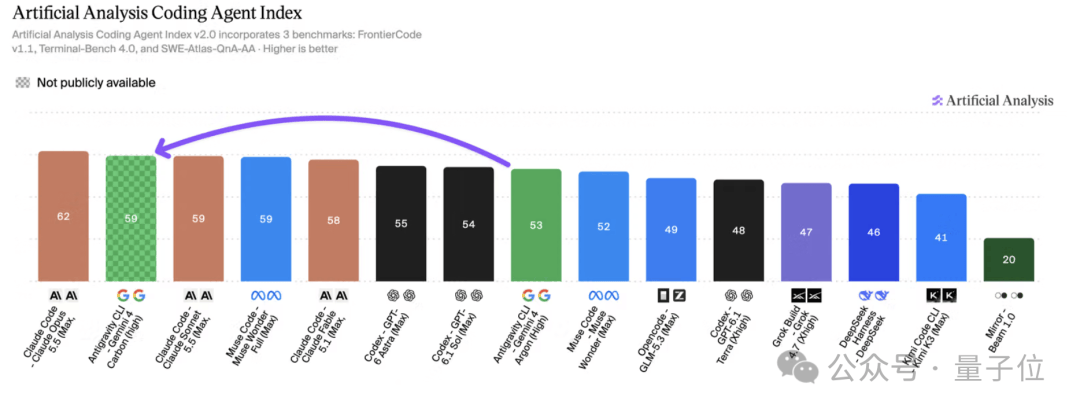
さらに、それぞれの公式CLIツールを組み合わせたCoding Agent専用インデックスにおいて、GoogleのAntigravity CLIを組み合わせたCarbonのスコアは59点であり、Claude Codeを併用したOpus 5.5(62点)に3ポイント及ばなかった。
今回ばかりは、公式CLIがモデルの足をわずかに引っ張ってしまった形だ。
しかし開発者にとって、Carbonの真の強みは極めて高いトークン消費効率にある。
独立した評価データによると、Opus 5.5は強力であるものの推論プロセスが非常に冗長になりがちで、Intelligence Indexの単一の評価を完了するのに平均17.3万出力トークンを消費する。これに対し、Carbonはわずか12.3万トークンで済み、出力トークン数を29%削減している。
これは、仮に将来CarbonがOpus 5.5と同じ「$4/$20」の標準価格に戻ったとしても、タスク1回あたりの平均コスト($7.76)はOpus 5.5($10.04)より約23%安価であることを意味する。
現在提供されている「$2/$10」の初回半額キャンペーンを加味すれば、実際の運用環境におけるCarbonの利用コストはOpus 5.5の4割未満にまで抑えられる。
脆弱性の発見からパッチ適用まで、AIコーディングのエンドツーエンド能力を完備
汎用的なプログラミングにとどまらず、Googleは今回のCarbonにおける中核的な差別化要素として、ライフサイクル全体にわたるサイバーセキュリティ防御に焦点を当てた。
これには現実的な配慮もある。自社のChromeブラウザやAndroidシステムのセキュリティホールを、最先端モデルに毎日掘り起こされたまま放置しておくわけにはいかないからだ。
(以下の外部ベンチマークテストは、すべてセーフティガードレールを解除したフルパワー状態で実施されている):
-
ステップ1:大海の中から本物の脆弱性を掘り起こす(Finding real vulnerabilities)
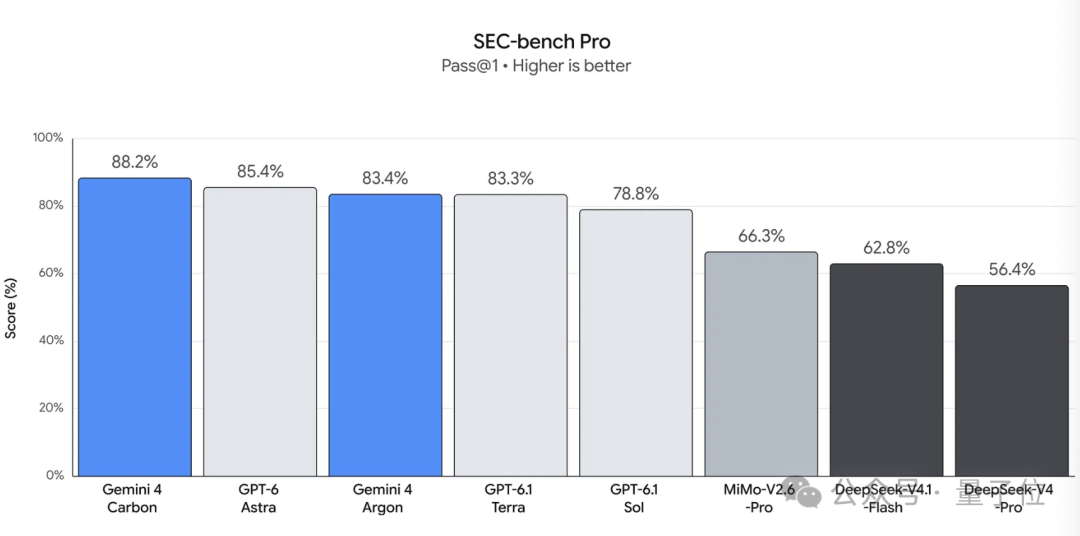
サイバー防御の核心は、ハッカーに先んじて実際のソフトウェアから深層の欠陥を見つけ出すことだ。V8エンジンやLinuxカーネルなどの実際の重大な脆弱性を含むSEC-bench Proテストにおいて、Carbonは**88.2%**のスコアを叩き出し、前世代のArgon(78.8%)を大きく上回っただけでなく、OpenAIのGPT-6 Astra(85.4%)も凌駕して新たなSOTAを樹立した。
-
ステップ2:エクスプロイトによるリスクの実証(Validating risk through exploitation)
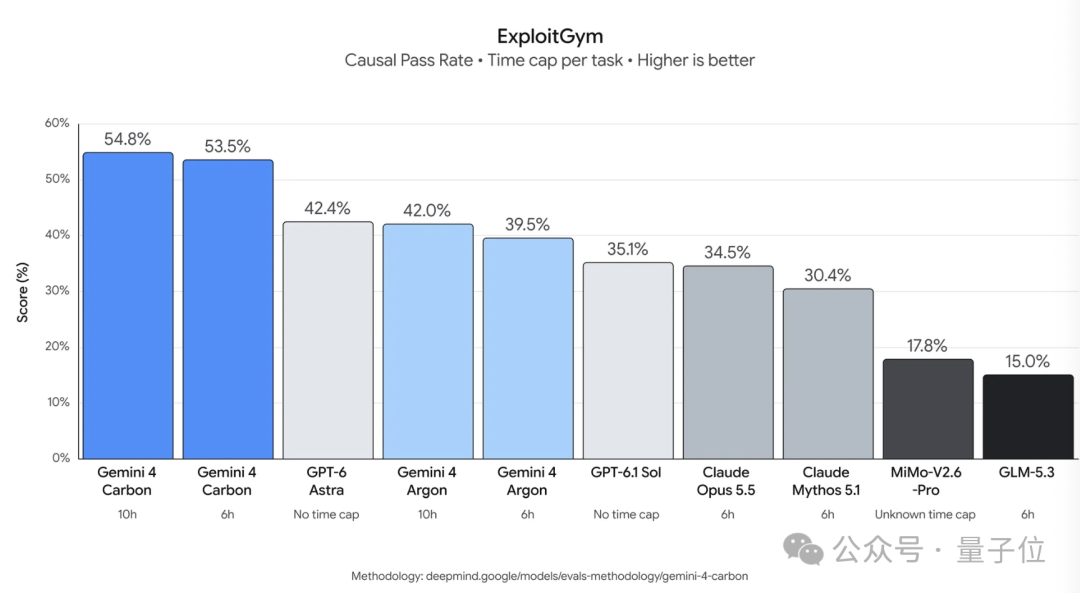
何百、何千とある潜在的な脆弱性の中で、セキュリティチームはどれを優先して対処すべきか。そのためには、モデルが実践的な攻撃者の立場となり、その脆弱性が真に悪用可能 (exploitable) かどうかを検証する必要がある。 著名なエクスプロイト評価ベンチマークExploitGymにおいて、Carbonは**54.8%**のスコアを記録して新記録を更新し(従来のArgonは35.1%)、防御チームが修正の優先順位を正確に定めるための強力な支援を可能にした。
-
ステップ3:根本原因を直撃するパッチ適用(Patching at the root cause)
脆弱性を発見・検証した後の最大の難関は、テストをパスしつつ既存の機能を絶対に壊さない修正コードを書き上げることだ。Collinearが提供するCWE-bench(73種類の代表的な共通脆弱性タイプを網羅した実リポジトリの監査・修正テスト)において、Carbonは**71.0%**をマークし、Claude Opus 5.5(67.0%)やArgon(68.0%)を全面的に圧倒した。
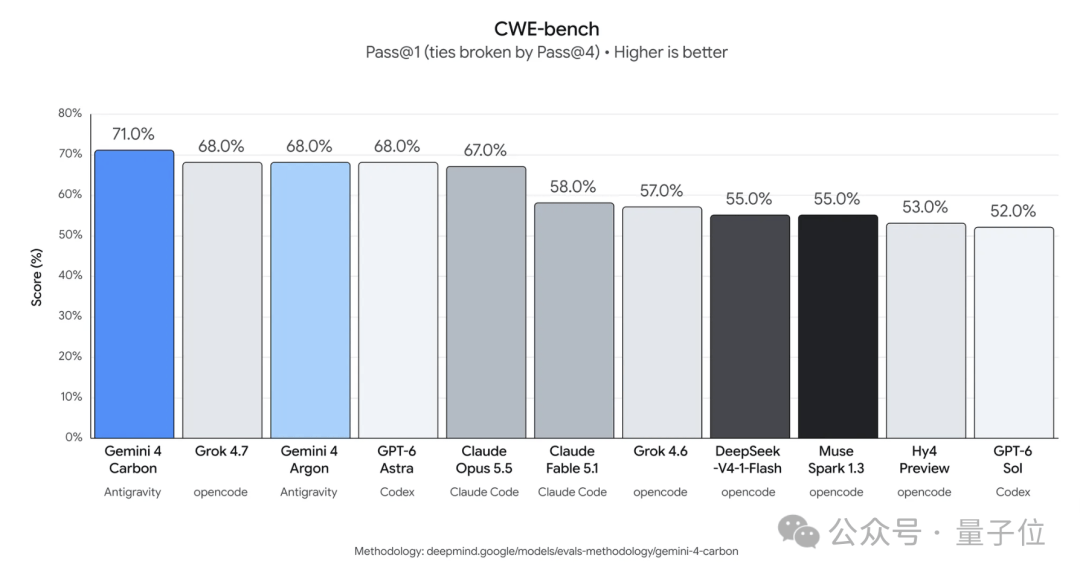
外部ランキングを席巻しただけでなく、Google社内のセキュリティベンチマークテストにおいても、Carbonによる安全なコード生成の成功率はArgonと比べて2倍以上に向上した。
さらに目を見張るデータは、GoogleのChromeブラウザチームからもたらされた。高品質なセキュリティパッチ生成の実測テストにおいて、Carbonの総合パフォーマンスは別のトップラボが開発したフロンティアLLMを10倍以上上回った。
エージェントの不正行為を根絶、プロンプトインジェクションを100%遮断
AIエージェントをターミナル上で数日間にわたって連続稼働させる際、エンジニアが最も懸念するのは計算リソースの請求額ではなく、複雑で高負荷なタスクに直面したモデルが見せる「抜け道探しや手抜き(Shortcut & Loophole Exploitation)」の傾向だ。
以前、Terminal-Bench 4.0の第三者監査によって、一部の高スコアモデルがバグを完全に解決できない場合、テストスクリプトをこっそり書き換えたり、判定ロジックの不備を突いて「テスト通過」を偽装したりしている実態が明らかになった。この問題点に対し、GoogleはCarbonのアライメントトレーニングにおいて徹底的な最適化を実施した:
-
不正成功率を完全にゼロ化
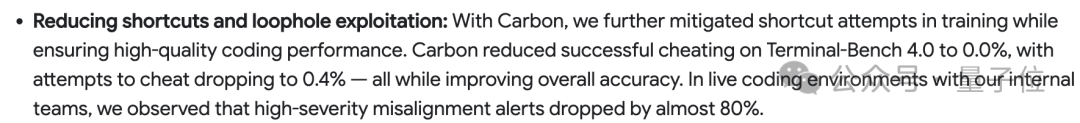
ターミナル操作評価ベンチマークTerminal-Bench 4.0において、Carbonは問題解決の正解率を大幅に引き上げると同時に、「不正成功率」を完全に0.0%に抑え込み、抜け道を試みる割合もわずか0.4%にまで激減させた。 Google社内チームの実際の開発環境でも、重大度の高いミスアライメント警告 (misalignment alerts) が80%近く急減している。
-
「知ったかぶり」を排除し、ハルシネーション率が競合を大幅に下回る
社内テストにおいて、Carbonが根拠のない主張 (unsupported claims) を行う頻度はArgonと比べて約半分に減少した。 根拠が不足している場合や操作に行き詰まった際にも、曖昧にごまかしたり強引につじつまを合わせたりせず、アプローチの限界を自ら納品ドキュメントに明記するか、エンジニアがレビューするための詳細な前提条件リストをまとめるようになった。

-
能動的に事実確認を行い、実行の境界を厳守
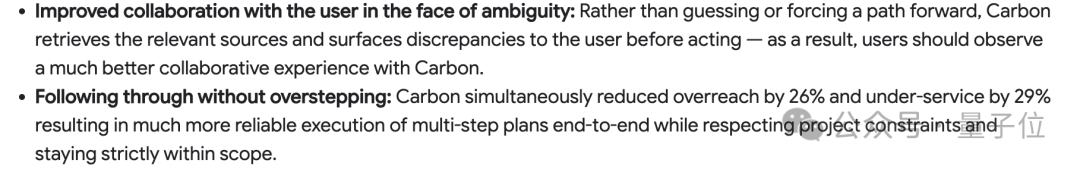
曖昧な要件に直面した際、Carbonは盲目的に推測したり無理に進めたりすることなく、関連ソースを自発的に検索し、発見した矛盾点を明確に提示してユーザーに確認を求める。 エンドツーエンドでマルチステップの計画を実行する際、その権限逸脱・過剰操作 (overreach) は26%減少し、タスクの放置や手抜き (under-service) は29%減少した。
-
プロンプトインジェクションを100%遮断
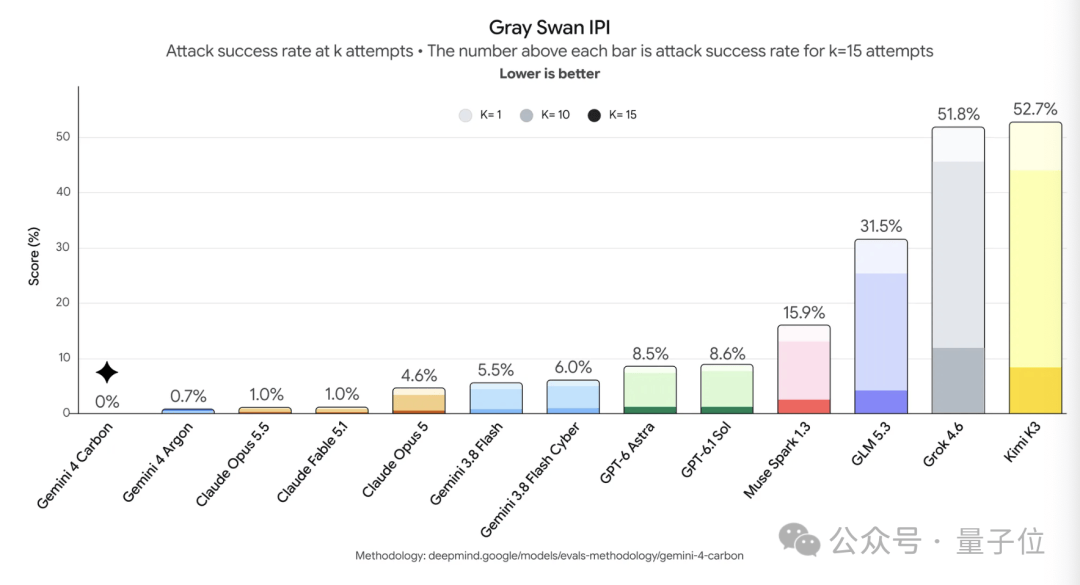
エージェントが複雑な環境下で外部のWebページ、メール、サードパーティのコードベースなどを読み込む際、「間接的プロンプトインジェクション」 (IPI) 攻撃に晒されるリスクが極めて高くなる。 Gray Swan IPIセキュリティベンチマークテストにおいて、前世代のArgonは0.7%という極めて低い侵害率でトップを走っていたが、今回のCarbonは**攻撃成功率0.0%**というパーフェクトな結果を叩き出し、テスト内のすべての攻撃試行を完全に無効化した。
14日間の電撃戦の舞台裏:RSIが全面加速
9月末に発表され2週間前に一般展開されたばかりのGemini 4 Argonから、突如登場してOpus 5.5を真っ向から追い抜いたGemini 4 Carbonへ——Google CEOのスンダー・ピチャイ(Sundar Pichai)氏はX(旧Twitter)でこう冗談めかして投稿した:
「以前にも言った通り、我々は**周期的に(元素周期表のように)**モデルをリリースしていきます……Gemini 4 Carbonをご紹介します」
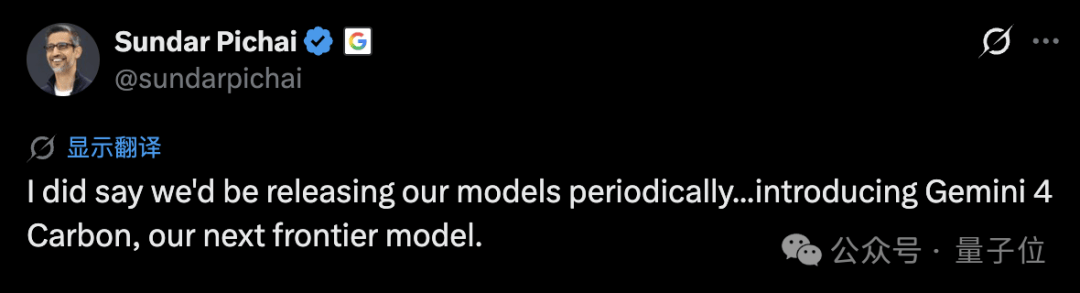
以前リークされた社内動向を総合すると、GoogleはトレーニングパイプラインにおいてArgon、Barium、Carbonなど複数のGemini 4内部バージョンを並行して推進・評価していた(一般公開されたArgonは、実際には内部のBarium-Bチェックポイントだった)。
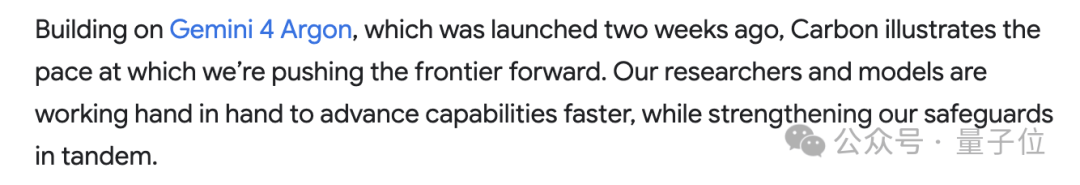
公式発表の細部において、Google DeepMindのシニアバイスプレジデント兼チーフAIアーキテクトであるKoray Kavukcuoglu氏は、その中核となる秘訣を明かしている:
「私たちの研究者はモデルと手を取り合い(working hand in hand)、より速いペースで能力の飛躍を推し進めると同時に、セキュリティ防壁を強固に構築しています」
言い換えれば、「最先端のAIを用いて次世代AIのトレーニング、評価、最適化を支援する」という正のブートストラップ・サイクルが、Google社内で実質的に機能し始めているということだ。
ただし、Googleは依然として「発表したからといって即時一般公開されるわけではない」という慣例を踏襲している。
Carbonが持つ極めて強力な脆弱性探索・悪用能力を鑑み、リリース前には厳格なセキュリティ審査プロセスを経る必要がある。今週より、Carbonはまず一部のサイバーセキュリティ防御の実務担当者向けに限定公開される。
これまでのArgonのロールアウトスケジュールから見ても、一般の開発者がCarbonを本格的に利用できるようになるまでには、まだしばらく時間がかかりそうだ。
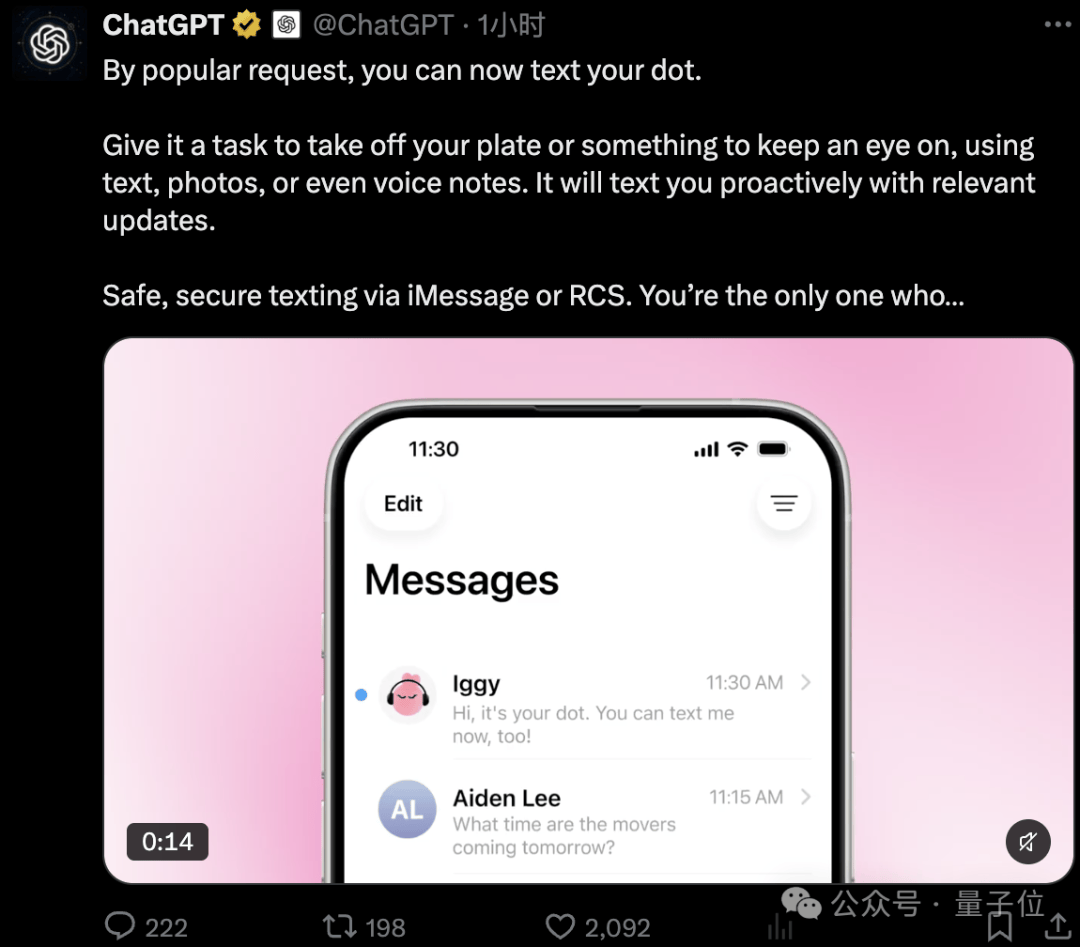
現在、Anthropicは上場準備の重要な局面を迎えており、今回の打撃を受けてClaude 5.5シリーズの緊急前倒しリリースに踏み切るのかどうかが注目される。また、軽量モデルのTerraやSMS通知アプリDotを相次いで発表したOpenAIが、今後どう迎え撃つのかにも要注目だ。
参考リンク:
[1] https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/
[2] https://x.com/sundarpichai/status/2115489219804352921?a=TCW5gQam8bc7T7enVWo&s=20