
インフラ基盤を「常駐バフ」にする
衡宇 凹非寺(北京)より
量子位(QbitAI)レポート
エンボディドAI(Embodied AI)にとっての「ChatGPTモーメント」は、一体いつ訪れるのだろうか。
おそらくそれは、GPT-6 Astra がわずか1行のAPIで領域の壁を越え、ロボットに指令を下す姿を誰もが目にした、あの瞬間だろう。
OpenAI は依然として圧倒的な実力を誇り、AIの汎用的な能力が極めて驚異的であるだけでなく、まだまだ限界には程遠いことをいち早く世界に証明してみせた。
良いニュースは、アルゴリズムという「エンジン」の性能が万人の想像を超えて進化し、AIモデルが今なお猛スピードのスーパーカーに乗っていることだ。
一方で悪いニュースは、その指令を物理的な動作へと変換するエンジニアリング基盤(Infra)が、依然として凹凸だらけの泥道であることだ……。
モデルの能力が高まれば高まるほど、先端アルゴリズムの飛躍をしっかりと受け止める、使いやすく完成されたエンボディドAIインフラが切実に求められるようになる。
先日、LimX Dynamics(逐際動力)はオープンソースのエンジニアリング基盤 FluxVLA Engine の第2版となるテクニカルレポートを公開した。
9月に発表された初版と比較して、V2ではオンライン強化学習(Online RL)によるポストトレーニング実験が新たに追加されたほか、シミュレーション評価および実機デプロイのカバー範囲が大幅に拡張されている。
レポートによると:
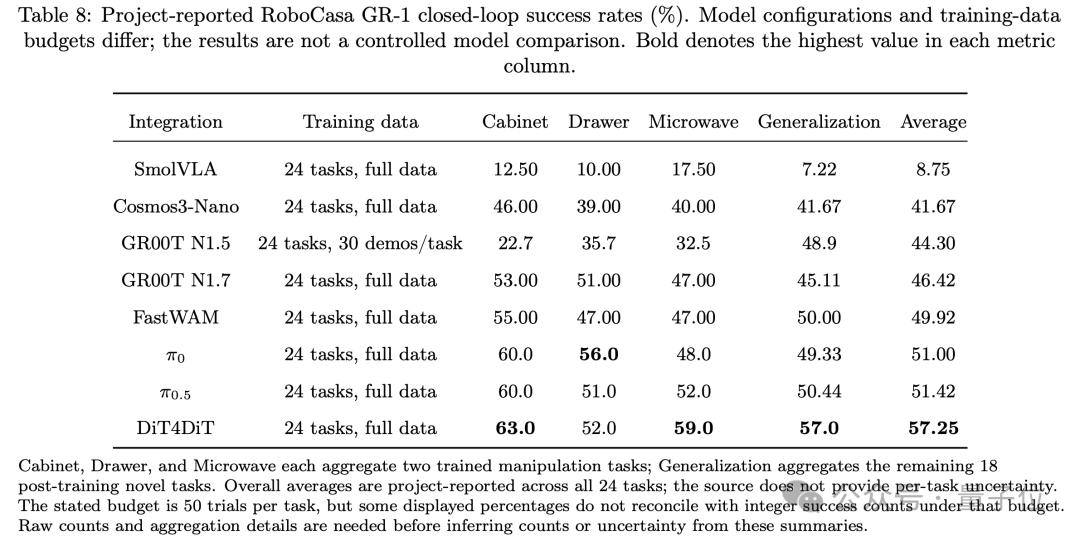
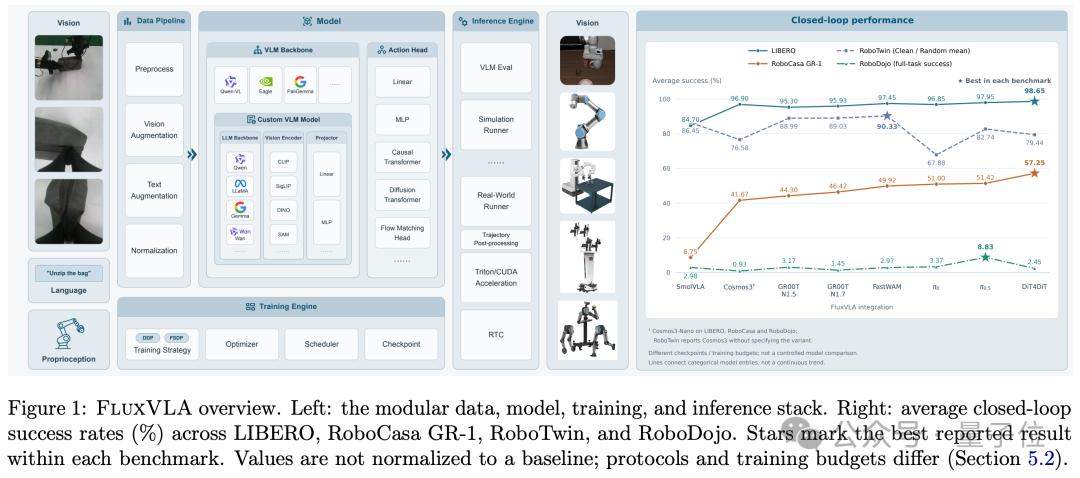
- シミュレーション側では、14種類のポリシーが同一の LIBERO クローズドループ評価に接続された。RoboCasa GR-1、RoboTwin、RoboDojo においても、それぞれ8種類のポリシーの接続および評価結果が示されている。
- 推論側では、8組のモデルとハードウェアの組み合わせによる実測において、最適化後のモデル推論周波数が 2.31〜9.64 倍に向上した。
- ハードウェア適合側では、ALOHA、Rebot、Franka 双腕、そして LimX Dynamics 自社開発の等身大ヒューマノイドロボット「LimX Oli」など、複数の実ハードウェアプラットフォームに対応。モデルのチェックポイントから実機でのクローズドループ実行に至るデプロイのフルパイプラインが完全に検証された。
オンライン強化学習も、今回のアップデートにおける最重要トピックの一つだ。
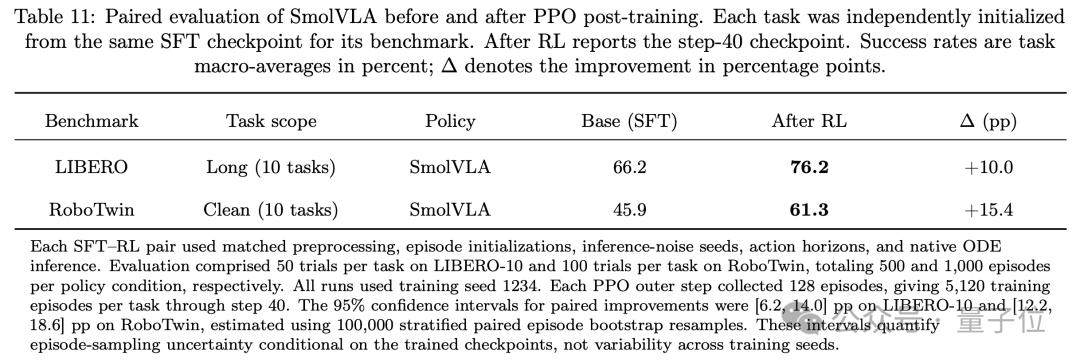
SmolVLA を例にとると、2組のペア実験において、オンライン強化学習を経たことで、LIBERO-10 および RoboTwin Clean の10タスクにおける成功率がそれぞれ 10.0 ポイント、15.4 ポイント向上した。
今年4月8日のオープンソース化以来、FluxVLA Engine はモデル対応、評価レシピ、実機デプロイ能力を着実に拡張し続けている。
LimX Dynamics 自身の言葉を借りれば、FluxVLA Engine のコアバリューは次の点にある。**「低レイヤーのエンジニアリング能力を真に再利用可能にし、貴重な研究開発リソースを果てしない『環境構築とインターフェース修正』から解放して、最先端のモデルが真に走り、着地できる道を整えること」**である。
「職人芸的」な車輪の再発明に別れを告げ、開発の「標準ライン」を構築する
エンボディドAIの研究開発は、なぜこれほどまでに資金と人員を消費するのだろうか。
最大の原因の一つは、業界全体で統一された標準パーツが著しく不足していることだ。大半の研究開発チームにとって、ほぼすべての新しい実験が一回限りの「サイロ型開発(煙突型開発)」になってしまっている。
FluxVLA Engine の第一の目標は、こうした町工場の手作業のような重複構築を、標準化された工業的生産ラインへとアップグレードすることにある——LimX Dynamics の創業者兼 CEO である張巍(Wei Zhang)は、FluxVLA Engine を「エンボディドモデルの生産ライン」に例えている。
この生産ラインを強固かつ実用的なものにするため、チームは4つのコアエンジニアリング原則に基づいて基底アーキテクチャを設計した:
- 統一設定(All-in-one):雑多で冗長な起動スクリプトを廃止し、統一された設定リストによってデータ、モデル、トレーニング、評価、デプロイの重要パラメータを一元管理する。
- モジュールの疎結合化:レジストリ機構と標準化インターフェースを通じて、VLMバックボーン、アクションヘッド、データセット、トレーニング戦略を標準的なブロックとしてモジュール化。柔軟な組み合わせに対応しつつ、ネイティブなポリシー実装も維持できる。
- デプロイ志向のシステム最適化:研究室の理想環境にとどまらず、システム設計の初期段階から推論高速化、RTC(リアルタイム・アクションチャンキング協調)、軌道後処理を実行プロセス全体へシームレスに統合する。
- 実験全体の再現性保証:各実験の設定、モデル状態、実行軌道を完全に保存し、成功の道筋を辿れるだけでなく、失敗の原因も確実に追究できるようにする。
特筆すべきは、今年4月のオープンソース化以来、FluxVLA Engine が常にハイペースな進化と継続的な運用を維持している点だ。
過去半年のスピーディーな反復プロセスの軌跡を振り返ると、そのエンジニアリングの生命力がよく分かる:
- 4月8日:FluxVLA Engine を正式にオープンソース化
- 6月22日:ヒューマノイドロボット「LimX Oli」の全身モバイルマニピュレーションにおける最小推論パイプラインを開通
- 6月30日:Franka 単腕・双腕の実機推論をサポート
- 9月9日:GR00T N1.7 を統合
- 9月16日:初版のテクニカルレポートを arXiv に公開
- 10月15日:RoboDojo 評価サポートを拡張
- 10月22日:V2 テクニカルレポートを公開。オンラインRLによるポストトレーニング、シミュレーションおよび実機評価の拡張を追加
テクニカルレポート:
https://arxiv.org/abs/2609.17210
GitHub リポジトリ:
https://github.com/FluxVLA/FluxVLA
Hugging Face:
https://huggingface.co/limxdynamics/FluxVLAEngine
こうした着実な反復の足跡に支えられ、この基盤の能力の境界は、当初の「学習できる、評価できる」から、現在の「実機で動く、データをフィードバックできる」へと着実に拡大してきた。
研究開発チームにとって、FluxVLA Engine の導入は、背後にインフラのアップデートを続け、限界を押し広げ続けるエンジニアリング部隊を従えているようなものだ。
ひとつの基盤で学習・評価・デプロイの全パイプラインを貫通させる方法
現在、エンボディドAIの技術ロードマップは、急速な収束を前にした激しい揺らぎの時期にある。
今日は拡散ポリシー(Diffusion Policy)が主流でも、明日はフローマッチングや世界アクションモデル(World Action Model: WAM)へと移り変わるかもしれない。技術ロードマップを切り替えるたびに既存のエンジニアリング資産をゼロから作り直していては、業界の巨人であっても大きな痛手を負うことは避けられない。
「モデルを変えるたびに最初からやり直し」というジレンマを避ける唯一の道は、低レイヤーのエンジニアリングインフラと高レイヤーのアルゴリズムを完全に切り離すことだ。
言い換えれば、業界には「あらゆる変化に柔軟に対応できる不変のエンジニアリング基盤」が切実に求められている。
FluxVLA Engine は、まさにそうしたオープンソース基盤である。「学習・評価・デプロイ」の全パイプラインを一貫して通すことで、チームが積み重ねてきたエンジニアリング資産が無に帰さないよう保証している。
その具体的な実装アプローチは、以下の3つのコア要素から紐解くことができる:
1. データとモデルレベルの標準化
特性やアーキテクチャが異なるモデルを同一ライン上で稼働させるには、まず低レイヤーのデータフォーマットとインターフェースプロトコルを統一することが先決だ。
データレベルでは、異なるロボットハードウェアや異なるシミュレーション環境から得られる生の軌道データが、明示的な変換と標準化クリーニングを経て、LeRobot 仕様に準拠した統一構造(Parquet ファイル、動画シーケンス、対応するメタデータを含む)へと整理される。
同時に、カメラ視点の順序、アクションの表現形式、正規化の統計基準といった技術的取り決めも厳密にアライメントされる。
これらのデータは処理が完了すれば、同一パイプライン内で混合学習させることも、グループごとに独立した前処理・正規化ルールを保持することも可能だ。学習であれ推論であれ、システムは独立したデータエントリを経由して統一されたモデル入力とアクションセマンティクスに従う。
エンボディドAIの研究開発において、データは最もコストのかかるコアアセットである。データの価値低下リスクを抑え、再利用効率を高めること自体が、極めて価値の高い業界レベルのコスト削減策となる。
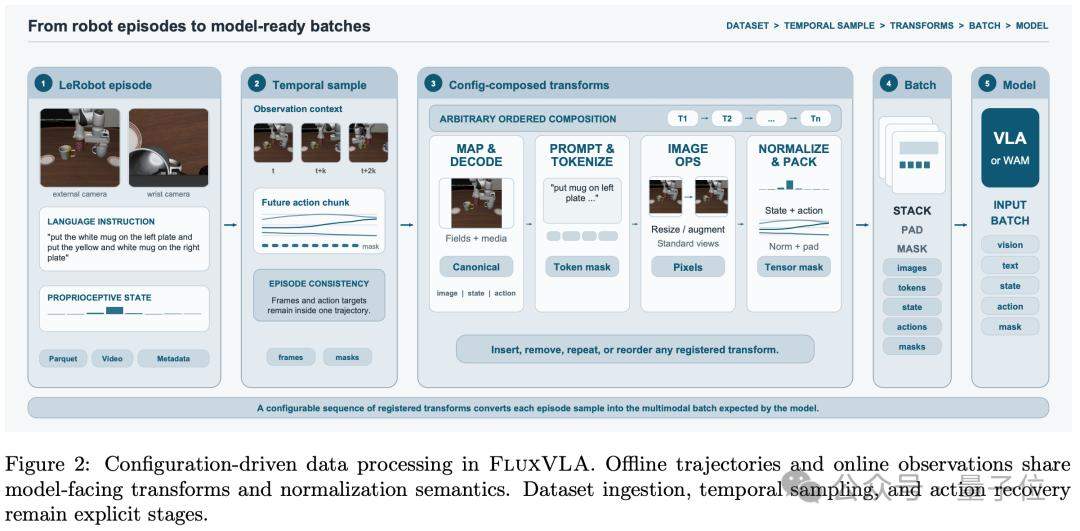
同様の思想はモデルレベルにも貫かれている。
プラットフォームは現在、Qwen-VL、GR00T、πシリーズ、DreamZero など、主要な VLM、VLA、WAM アーキテクチャを深く統合している。
各種モデルはネイティブなネットワークバックボーンを保持できるだけでなく、統一インターフェースを通じて学習、評価、実機デプロイの各プロセスへシームレスに接続できる。
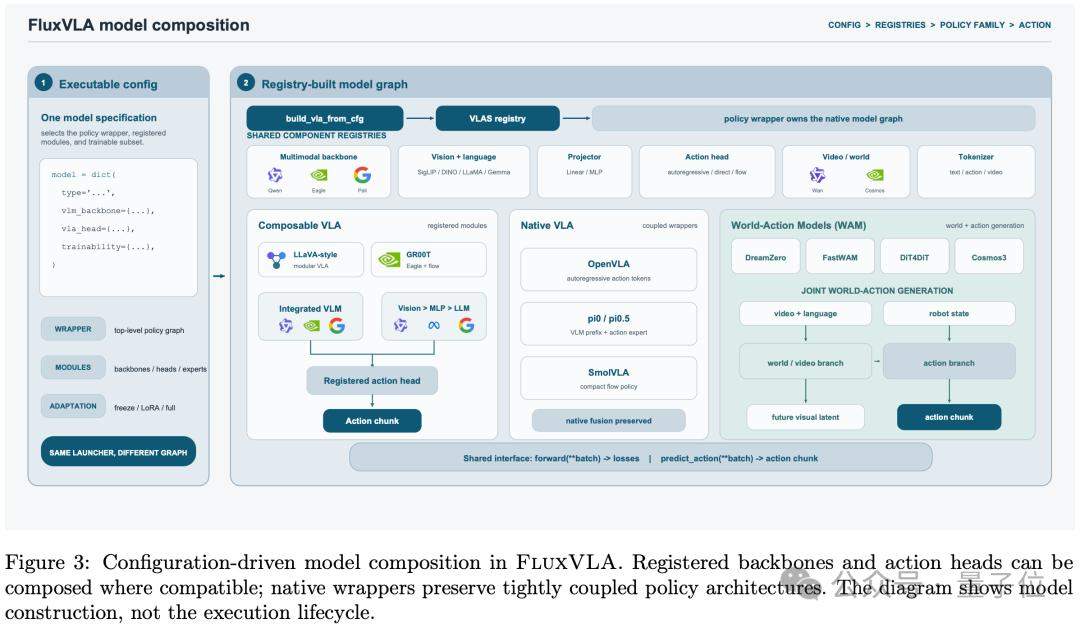
レポートで示された14種類のポリシーが同じ舞台で競い合う様子は、この汎用的な疎結合化能力の最も直感的な証明だ。
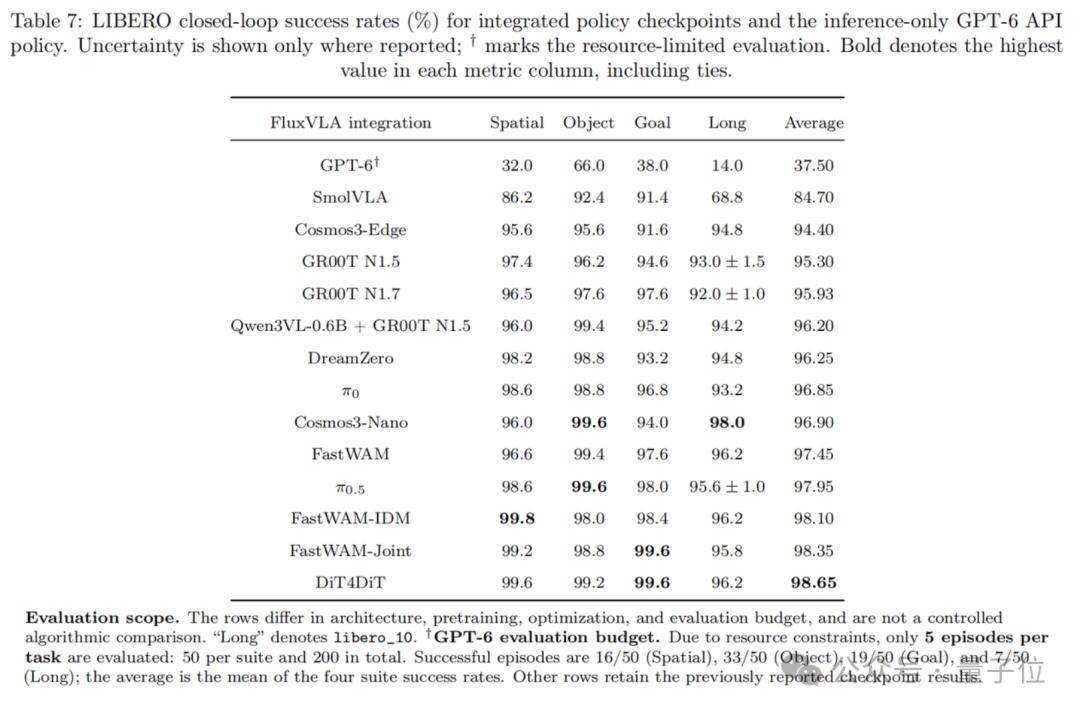
これら14種類のポリシーは、コンパクト型VLA、フローマッチングポリシー、モジュール型VLM+アクションヘッド、世界アクションモデル、さらにはローカルウェイトを持たずにクラウドAPI経由で直接呼び出される GPT-6 Astra、そして新たに対応が追加された MiniMax-M3.1-Flash に至るまで、現在のほぼすべての主要パラダイムを網羅している。
レポートに示されたベースライン設定では、13個のローカルチェックポイントポリシーのうち11個が、LIBERO 上で平均成功率 95% 超を記録した(例えば DiT4DiT は 98.65%、π0.5 は 97.95% に達した)。
これは、業界で新しいモデルが発表された際、他のチームが徹夜で環境を調整しデータフォーマットを変換している間に、標準基盤を採用しているチームはすでに次の研究開発フェーズへ迅速に進めることを意味している。
2. オンライン強化学習(Online RL)の統合
模倣学習による教師ありファインチューニング(SFT)のみで訓練されたモデルは、問題集を丸暗記しただけの学生に似ており、未見の極端な外乱や突発的な状況に直面すると極めて破綻しやすい。
モデルに真のロバスト性と汎化能力を持たせるには、環境に入り込ませてクローズドループで試行錯誤させる、すなわちオンライン強化学習の導入が不可欠となる。
しかし、オンラインRLは環境とのインタラクションサンプリング、ポリシーパラメータの更新、分散クラスタ学習を緊密に協調させる必要があり、エンジニアリングの複雑性が指数関数的に跳ね上がるため、多くのチームにとって乗り越えがたい壁となっていた。
これに対し、FluxVLA Engine は効率的なエンジニアリングソリューションを提供している。RLinf を深く統合することで、互換性のあるフローマッチングポリシーが余計な手間をかけずにそのままオンライン対話トレーニングパイプラインへと接続できるようになり、モデルやデータパイプラインを繰り返し調整する膨大なオーバーヘッドを解消した。
シミュレーションのペア実験では、各ベンチマークの全タスクが同一の SmolVLA SFT チェックポイントからスタートし、それぞれタスク専用の PPO ポストトレーニングを実施した。
40回のアウターイテレーション(外層反復)を経て、LIBERO-10 のタスク平均成功率は 66.2% から 76.2% へと急伸し、RoboTwin Clean の10タスクでは 45.9% から 61.3% へと向上。それぞれ 10.0 ポイントと 15.4 ポイントという顕著な伸びを記録した。
これは、本プラットフォームが「模倣学習の出発点」から「オンライン対話によるスコア向上」へと至るエンジニアリングの近道を確立したことを示している——軽量な小パラメータモデルであっても、高品質なクローズドループの試行錯誤を通じて驚くべき行動のポテンシャルを引き出せるのだ。
3. 顕微鏡レベルの超詳細な評価
従来の評価メカニズムは透明性に欠けることが多く、研究開発者はモデルが実行中にどこでボトルネックに直面しているのかを観察できず、システムは最終的に無機質な成功率の数値だけを返すことが常だった。
V2 レポートでは、シミュレーション評価の広がりと深さが大幅に拡張された:
- RoboTwin では新たに8種類のポリシー対応が追加され、Clean(標準環境)と Random(ランダム外乱環境)の2つの環境下における評価データが同時に提供される。
- RoboDojo では、8種類のポリシーに対して42タスク、単一モデルあたり最大2100回に及ぶ試行という「全身健康診断」が実施された。
前者は2つのシナリオにおけるパフォーマンスを比較することで、環境変化に対するモデルの適応力を明確に示す。後者はタスクの最終的な成否を記録するだけでなく、フェーズごとのプログレスバーを全工程でトラッキングし、汎化性、記憶、精度、長期計画、オープンインストラクションの5つの次元から多面的な能力レーダーチャートを描き出す。
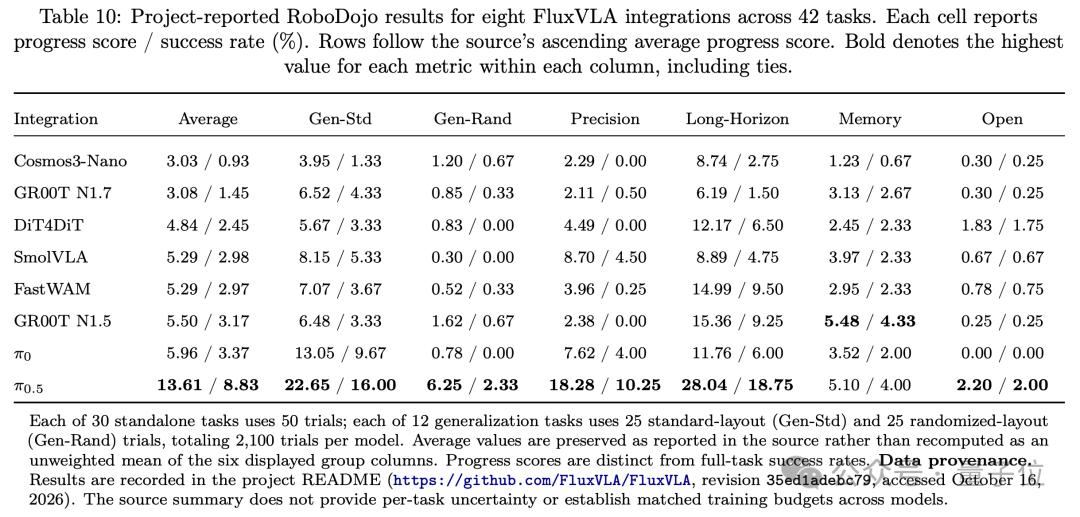
このような粒度の細かい評価は、問題特定の効率を劇的に向上させる。
例えば服を畳むタスクやブロックを掴むタスクにおいて失敗した場合、モデルは最初の3ステップを完璧にこなしており、最後の「箱に収める」段階で動作のブレ(ジッター)が発生しただけかもしれない。
このとき、「各段階の進捗」と「最終的な成功率」を組み合わせて分析すれば、感知レイヤーの画像認識の誤りなのか、計画レイヤーの長期推論の破綻なのか、それとも実行レイヤーの微細な制御不足なのか、問題の核心を迅速に特定できる。
因果関係の帰属なき評価は、「中身の見えないガチャ」を回してモデルを錬成するのと変わらない。この追跡可能で特定可能な評価メカニズムにより、開発チームは適切な対策をピンポイントで打つことができ、盲目的にデータを積み上げたり計算資源を無駄に浪費したりする無意味な手戻りを効果的に回避できる。
「シミュレーションの高スコア」から「実機での実作業」への死線を越える
シミュレーション環境と物理世界との間のギャップ(Sim-to-Real ギャップ)は、エンボディドAIの実用化における最大のボトルネックであり続けてきた。
エンボディドモデルは通常、チャンキング予測メカニズム(時系列のアクションシーケンスをまとめて一度に予測する)を採用し、それをロボットが順次実行していく。このプロセスにおいて、モデルのニューラルネットワーク推論には一定の遅延が生じる一方で、低レイヤーのロボットのハードウェア制御ループは常に高周波数でリアルタイム稼働し続けなければならない。
前の動作シーケンスの実行が完了していないうちに次の予測動作が生成されてしまうと、2つのシーケンス間で位相のズレや途切れが発生しやすくなる。また、モデルが出力した動作が数値空間上で完全に妥当であったとしても、関節速度、加速度、軌道の滑らかさといったハードウェア本体の物理的制約を厳密に満たさなければならない。
実機デプロイにおける「カクつき」や「振動(ジッター)」を根本から解消するため、FluxVLA Engine は高信頼なシステムエンジニアリングソリューションを構築した:
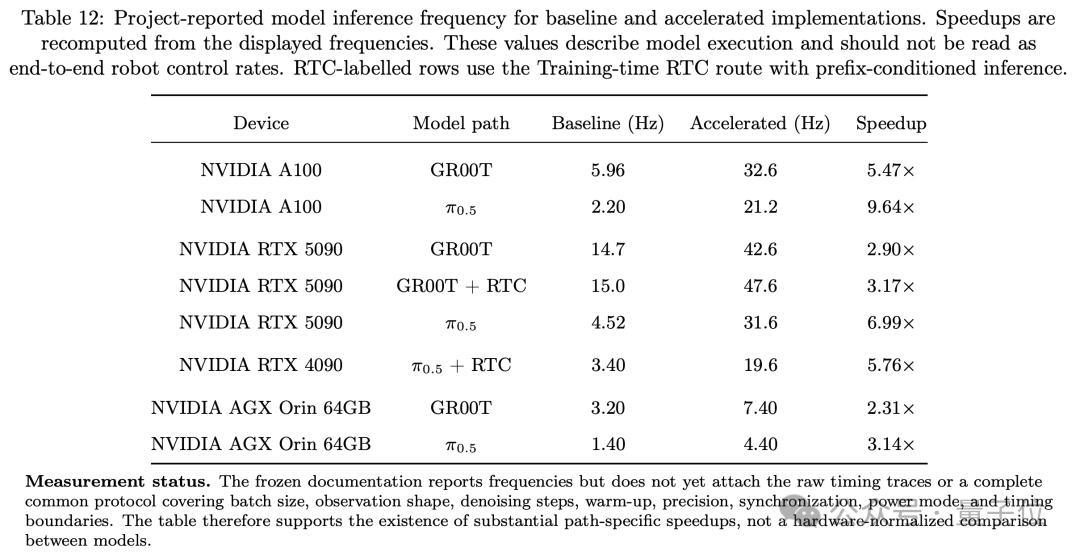
第1の手:ディープカーネルの高速化により推論スループットが最大9.64倍に向上
モデルの重みを一切変更しない前提のもと、FluxVLA Engine は GR00T や π0.5 などのモデルに対して低レイヤーの推論パイプラインを深く再構築し、冗長な VRAM 転送とオペレータディスパッチのオーバーヘッドを極限まで削減した。
テスト対象となった8組のモデルとハードウェアの組み合わせにおいて、システム最適化後の推論周波数は軒並み 2.31〜9.64 倍に向上した:
- NVIDIA A100 上:π0.5 の推論周波数は 2.20Hz から 21.2Hz へと向上し、9.64倍の加速を達成。
- エッジコンピューティングプラットフォーム AGX Orin(64GB)上:GR00T は 3.20Hz から 7.40Hz へ、π0.5 は 1.40Hz から 4.40Hz へと向上した。
さらに重要なのは、この高速化プロセスが極めて高い忠実度(フィデリティ)を保っていることだ:
GR00T のアクションヘッドに対する数値アライメント検証によると、高速化後のアクション出力とオリジナルの浮動小数点結果とのコサイン類似度は 0.99999 を超え、最大絶対誤差はわずか約 0.02 に抑えられている。
純粋なシステムエンジニアリング最適化によってコンピュートの潜在能力を絞り出すことで、追加のハードウェアを購入することなくモデルの精度をロスレスに維持した。
第2の手:アクションバッファの「ショックアブソーバー」で指令を滑らかに噛み合わせる
コンピュート面での推論効率に加え、実行面における時系列の連続性も同様に極めて重要だ。
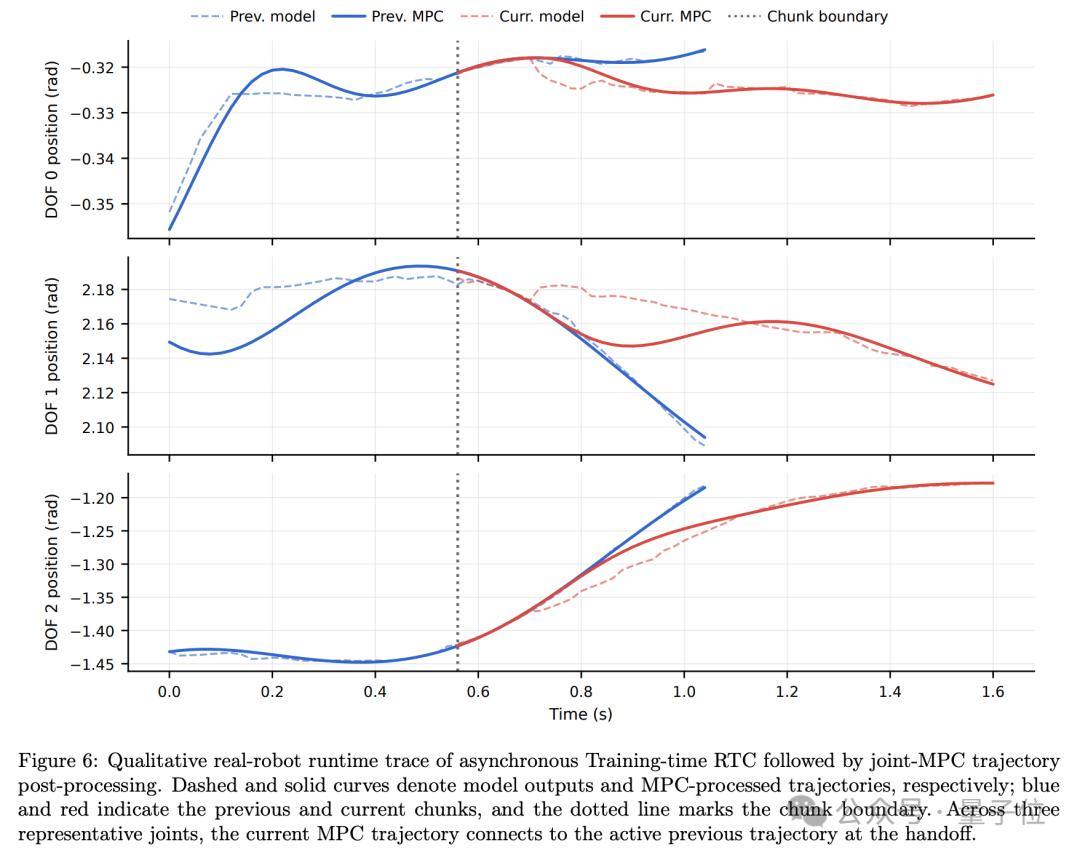
FluxVLA Engine は、リアルタイム・アクションチャンキング協調(RTC)機構を導入した。そのコアロジックは、まだ実行が終わっていない直前の動作の終端状態を利用して、新たに予測された次の軌道の開始部分を動的に制約することにある。これにより、あたかもジッパーのように異なる推論サイクルの動作セグメントを滑らかに噛み合わせ、急変によるハードウェアへの衝撃を解消する。
その後、軌道後処理モジュールがキネマティクスフィルタリングと平滑化制約を実行し、サーボモーターへ送信されるすべての指令が物理的限界の境界内に収まり、かつ滑らかに出力されるよう保証する。
推論の高速化が動作の生成レイテンシを解消し、RTC と後処理モジュールが予測と実行の時空間のズレを解消する。この両者が協調することで、アルゴリズムをハードウェアへ適合させるエンジニアリングのハードルを大幅に下げ、高価なロボット本体を保護するだけでなく、ロボットの物理的な動作に人間のような滑らかさと協調性をもたらしている。
第3の手:「ユニバーサルソケット」による異なる本体間での移行と、実戦データループの開通
実機デプロイプロセスにおいて、FluxVLA Engine は明確な2層の疎結合アーキテクチャを採用している。高レイヤーのポリシーディスパッチを担当する Runner と、低レイヤーのドライバ接続を担当する Operator だ。
具体的には、Runner はモデルの推論管理、アクションスケジューリングキュー、および全プロセスのステートマシンの運用に特化する。一方、Operator は低レイヤーのセンサデータ収集、産業用バス通信プロトコルのパース、および下位制御コマンドの配信・発行に専念する。両者がそれぞれの職責を果たし、疎結合で協調することにより、その後の異なる形態の本体間におけるポリシーの移植や、実戦データのフィードバックループに向けた標準化されたエンジニアリングパスが確立されている。