
インフラを「常駐バフ」にする
エンボディドAIにとっての「ChatGPTモーメント」は、一体いつ訪れるのだろうか。
おそらくそれは、GPT-6 Astraのようなモデルがたった1行のAPIコールだけで、ロボットに実世界の操作タスクを指示できるようになった瞬間だろう。
最先端の大規模言語モデル(LLM)開発チームは圧倒的な実力を示し続け、AIの汎用力がいかに驚異的であり、まだ天井に達していないかを世界に証明し続けている。
良いニュースは、モデルというエンジンの性能が予想をはるかに超えており、AIアルゴリズムがいまだ「スーパーカー用のサーキット」を猛スピードで疾走していることだ。
一方で悪いニュースは、その指示を物理的な動作へと変換するエンジニアリング基盤(Infra)が、いまだに凸凹だらけの「未舗装の悪路」であるという点だ……
モデルの能力が高まれば高まるほど、最先端アルゴリズムの飛躍をしっかり受け止めるための、使いやすく完成されたエンボディドInfraが不可欠になる。
先日、LimX Dynamics(逐際動力)はオープンソースのエンジニアリング基盤 FluxVLA Engine のテクニカルレポート第2版(V2)を公開した。
9月に公開された初版と比較して、V2ではオンライン強化学習(Online RL)のポストトレーニング実験が新たに追加され、シミュレーション評価や実機デプロイのカバー範囲も大幅に拡大されている。
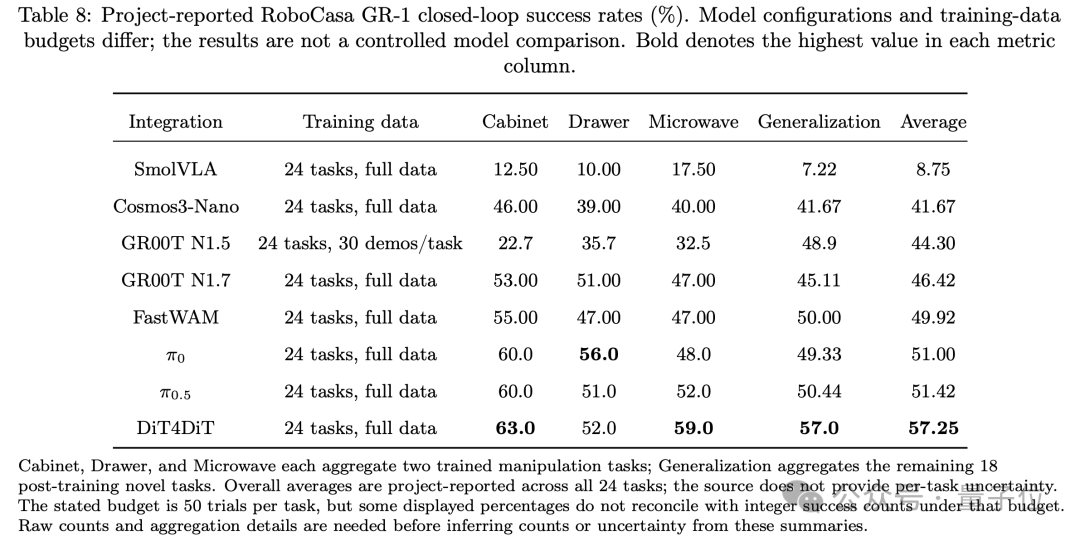
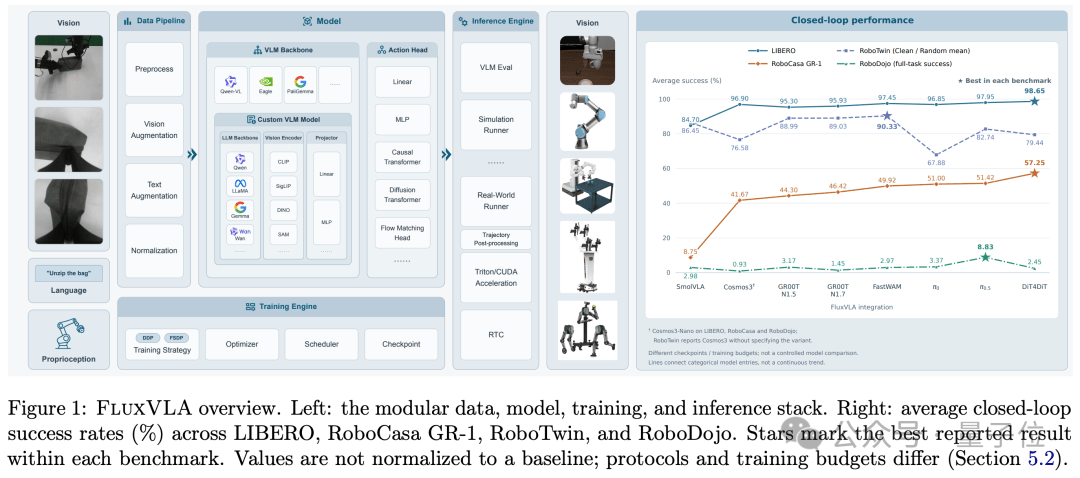
レポートによると、シミュレーション評価においては、すでに14種類のポリシーが同一のLIBERO閉ループ評価システムに接続されている。また、RoboCasa GR-1、RoboTwin、RoboDojoの各プラットフォームでも、それぞれ8種類のポリシーの接続・評価が完了している。
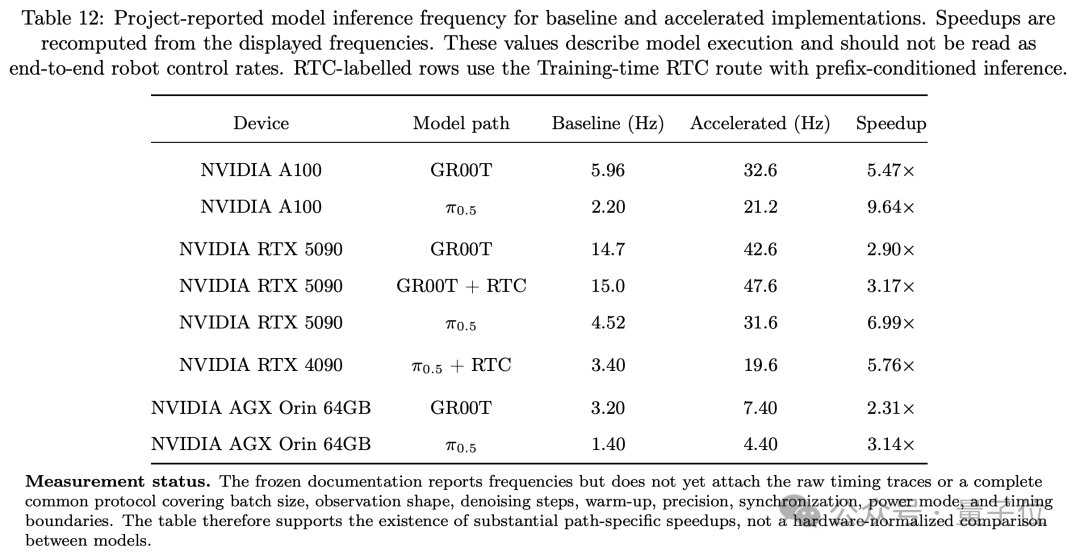
推論側では、モデルとハードウェアの組み合わせ8パターンを対象とした実測において、低レイヤーの最適化によりモデルの推論周波数が従来の2.31〜9.64倍に向上した。
さらに、ALOHA、Rebot、双腕Franka、そしてLimX Dynamics独自開発の等身大ヒューマノイドロボット「LimX Oli」など、複数の実機ハードウェアプラットフォームにおいて、モデルの重みチェックポイント(Checkpoint)から実機での閉ループ実行に至るエンドツーエンドのデプロイメントパイプラインが完全に検証された。
オンライン強化学習も今回のアップデートにおける重要なハイライトだ。
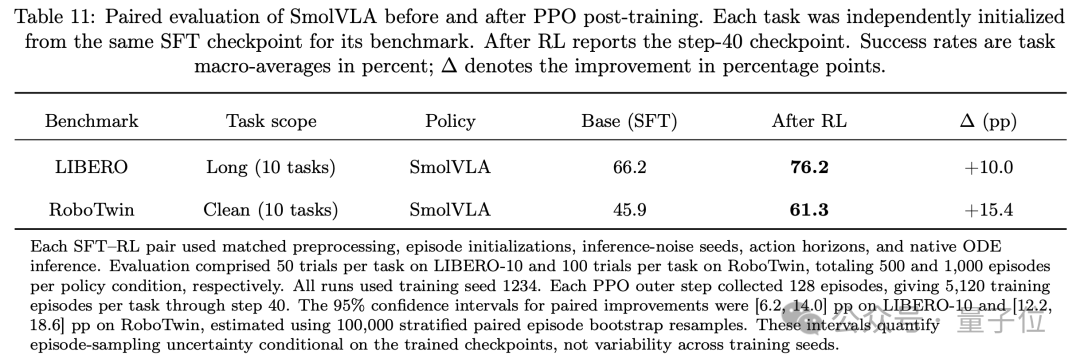
SmolVLAを例に挙げると、2つの対照実験において、オンライン強化学習によるポストトレーニングを経た結果、LIBERO-10およびRoboTwin Cleanの10タスクにおける成功率がそれぞれ10.0ポイント、15.4ポイント向上した。
今年4月8日のオープンソース化以来、FluxVLA Engineはサポート対象モデル、ベンチマーク、実機デプロイ機能を拡張し続けている。
LimX Dynamicsチームの言葉を借りれば、FluxVLA Engineのコアバリューは、**「基底のエンジニアリング能力の高度な再利用を実現し、果てしない『環境構築やインターフェース修正』から貴重な研究開発リソースを解放して、最先端アルゴリズムを確実に着地・実践させる道を作ること」**にあるという。
「町工場的」な車輪の再発明と決別し、エンボディドAI開発に「標準化ライン」を築く
なぜエンボディドAIの研究開発はコストが高く、多大な労力を要するのか?
最大のボトルの1つは、業界に標準化されたコンポーネントが長年不足していた点にある。多くのチームにとって、新しい実験を行うたびに、それはほぼ使い捨てのスクラッチ開発になっていた。
FluxVLA Engineの第一の目標は、こうした「町工場的」な手作業の構築を、標準化された工業用ラインへと進化させることだ。LimX Dynamicsの創業者兼CEOである張巍氏は、FluxVLA Engineをエンボディドモデルの「生産ライン」に例えている。
このラインの安定性と高可用性を担保するため、システムは4つのエンジニアリング原則に基づいてアーキテクチャが設計されている:
- 一元管理(All-in-one):散らばったスクラッチのスクリプトと決別し、グローバル設定マニフェストによってデータ、モデル、トレーニング、評価、デプロイなどのコアステップを統合管理する。
- モジュールの疎結合化:レジストリ機構と標準化インターフェースに基づき、ビジョン・ランゲージ・バックボーン、アクション予測ヘッド、データセット、トレーニング戦略をモジュール化。自由な差し替えを可能にしつつ、ネイティブなポリシー実装の保持も許容する。
- デプロイを見据えたシステム最適化:研究室の理想環境という前提を脱し、アーキテクチャの初期段階から推論加速、リアルタイムアクションチャンキング協調(RTC)、軌道平滑化の後処理を実行フローに深く組み込む。
- 厳密で再現可能な実験:各実験のハイパーパラメータ設定、モデルの重み、動作軌道を完全に固定・追跡可能にし、成功の要因も失敗の原因も確実にトレースできるようにする。
特筆すべきは、今年4月のオープンソース化以来、FluxVLA Engineが一貫して高頻度なイテレーションと継続的なアップデートを維持している点だ。
過去半年のロードマップを振り返ると、インフラ基盤の拡張ペースの速さが浮き彫りになる:
-
4月8日:FluxVLA Engineを正式にオープンソース化
-
6月22日:ヒューマノイドロボットLimX Oliの全身モバイルマニピュレーションにおける最小推論パイプラインを開通
-
6月30日:単腕/双腕Frankaロボットアームの実機推論に対応
-
9月9日:GR00T N1.7に対応
-
9月16日:テクニカルレポートをarXivで公開
-
10月15日:RoboDojoベンチマーク評価のサポートを追加
-
10月22日:テクニカルレポートV2を公開(オンラインRLポストトレーニング、シミュレーションおよび実機評価の拡張を追加)
-
テクニカルレポート:https://arxiv.org/abs/2609.17210
-
Hugging Face:https://huggingface.co/limxdynamics/FluxVLAEngine
継続的なイテレーションにより、この基盤の対応領域は初期の「トレーニング・評価のサポート」から、「実機での閉ループ運用とデータフィードバック」へと着実に拡大している。
研究開発チームにとって、FluxVLA Engineを導入することは、インフラのアップグレードに専念し、技術フロンティアを拡張し続けてくれる専属のバックエンドエンジニアリングチームを抱えるようなものだ。
単一基盤で「学習・評価・デプロイ」の全工程をどう貫通させるか?
現在のエンボディドAIの技術路線は、収束前の急速な探索フェーズにある。
拡散ポリシー(Diffusion Policy)、フローマッチング(Flow Matching)、世界アクションモデル(WAM)など、アルゴリズムの路線を変更するたびにこれまでのエンジニアリング資産がゼロクリアされるようでは、開発コストが持たない。
「モデルを変えるたびにやり直し」を避ける唯一の道は、基盤となるエンジニアリングインフラと上層の先端アルゴリズムを徹底的に疎結合化することだ。
端的に言えば、業界には高い汎用性を持ち、「変化に柔軟に適応できる」エンジニアリング基盤が切実に求められている。
FluxVLA Engineはまさに「学習、評価、デプロイ」の全工程を貫通させ、エンジニアリング資産の蓄積を守るために構築された。その中核となる技術実装は、次の3つの側面に集約される:
1. データとモデルのインポート
特性の異なる多様なモデルを同一のエンジニアリングパイプラインにシームレスに接続するには、基底のデータ規格とインターフェースフォーマットの標準化が不可欠となる。
データ層: 異なるロボット本体やシミュレーション環境から得られる生の軌道データは、明示的なフォーマット変換とクレンジング検証を経て、LeRobot仕様と互換性のある標準構造(Parquetメタデータインデックス、マルチアングルビデオストリームなどを含む)に統一される。同時に、カメラの画角順序、アクション空間の定義、正規化の統計値などの仕様も緻密に整合される。
標準化されたデータは同一パイプラインでの混合学習を可能にするだけでなく、特定のサブセットに対して個別の前処理や正規化ルールを保持することもできる。オフライン学習時もオンライン推論時も、システムは独立したデータエントリを介して統一された入出力エンコード/デコードセマンティクスを実行する。
エンボディドAI開発において最もコストがかかるコア資産として、マルチソースデータの効率的な再利用と標準化された蓄積を推進すること自体が、開発の限界費用を大幅に引き下げる鍵となる。
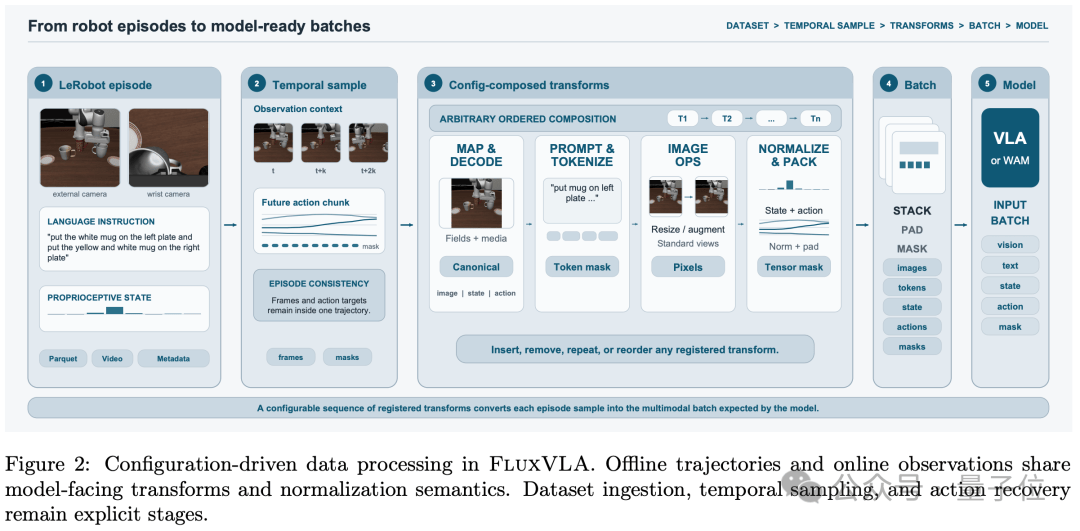
モデル層: フレームワークには、Qwen-VL、GR00T、πシリーズ、DreamZeroなどの主要なVLM、VLA、WAMアーキテクチャがすでに統合されている。各モデルは本来の構造特性を完全に維持したまま、標準化インターフェースを介して学習、評価、デプロイのパイプラインに接続できる。
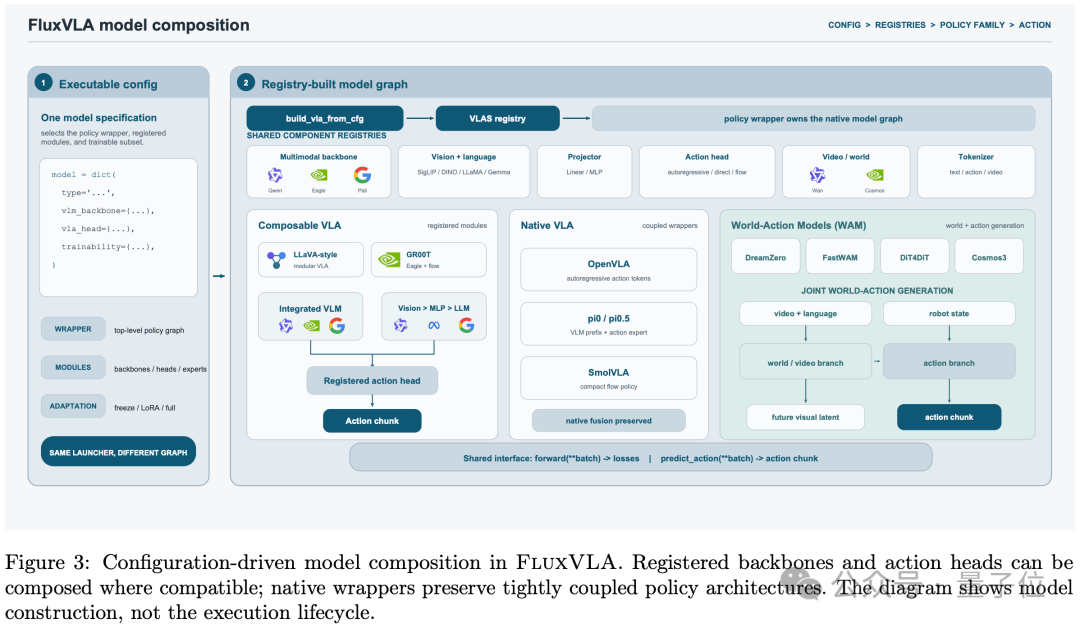
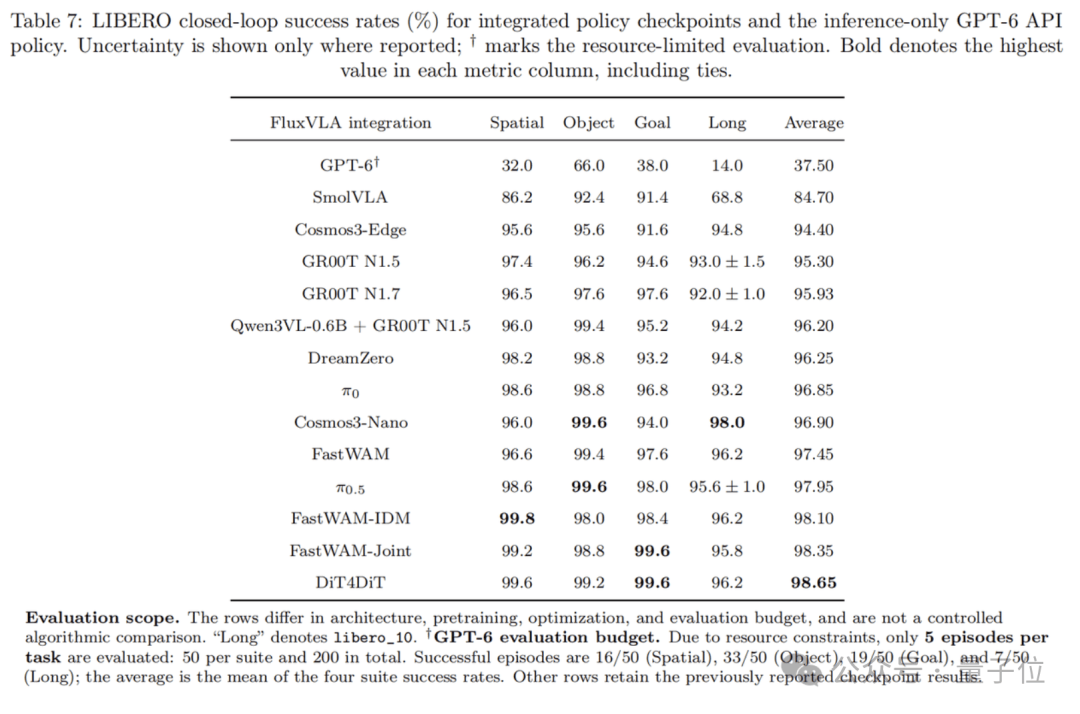
レポートで示された14種類のポリシーによる同一ベンチマーク評価は、この設計の高い拡張性を実証している。評価対象には現在の主要な技術領域が網羅されている:
コンパクトなVLA、フローマッチングポリシー、モジュール型VLM+アクションヘッド構造、世界アクションモデル、さらにはローカルデプロイを必要とせずクラウドAPIを直接呼び出すGPT-6 Astraや、最近追加されたMiniMax-M3.1-Flashまで含まれる。
所定のベンチマークにおいて、13種類のローカルポリシーのうち11種類がLIBEROベンチマークで平均成功率95%を突破した(例:DiT4DiTは98.65%、π 0.5は97.95%を達成)。
モジュール型アーキテクチャによる効率向上は極めて大きい。業界に新しいモデルアーキテクチャが登場しても、開発者は環境やデータパイプラインを再構築することなく、迅速に評価と適合を進めることができる。
2. オンライン強化学習(Online RL)のサポート
教師あり微調整(SFT)のみで学習されたモデルは、学習データの分布に強く依存しがちであり、未知の外乱に対する汎化堅牢性には限界がある。
複雑で動的な環境におけるモデルの意思決定境界を広げるには、環境との相互作用による探索とオンライン強化学習(Online RL)の導入が重要なアプローチとなる。
しかし、オンライン強化学習には、環境との並行インタラクション、ポリシーの効率的な更新、大規模な分散スケジューリングを同時に両立させる必要があり、エンジニアリングのハードルが極めて高い。
そこでFluxVLA Engineは基底部分で集中的な最適化を実施した。RLinfを統合することで、フローマッチング互換のポリシーモデルが、新たなタスク用のインターフェースやデータ配信パイプラインを書き直すことなく、オンライン相互作用によるポストトレーニングフローに直接接続できるようにした。
シミュレーション対照評価では、LIBEROおよびRoboTwinベンチマークを対象に、SmolVLA SFTチェックポイントをコールドスタート用の重みとして統一採用し、タスク特化型のPPOポストトレーニングを実施した。
40エポックの外層イテレーションを経て、SmolVLAのLIBERO-10タスクにおける平均成功率は66.2%から76.2%へと急伸した。RoboTwin Cleanの10タスクにおける成功率も45.9%から61.3%へと向上し、それぞれ10.0ポイント、15.4ポイントの性能改善を達成した。
この評価は、本基盤が「模倣学習によるコールドスタート」から「オンライン相互作用による性能向上」へと至る実践的なパイプラインを確立し、中・小規模なパラメータのモデルであっても閉ループのインタラクションを通じて意思決定の潜在能力を十分に引き出せることを証明している。
3. 多次元かつ高粒度で追跡可能な評価システム
従来の評価手法は単一の最終成功率メトリクスを出力するにとどまることが多く、モデルの中間的な推論プロセスや失敗原因の詳細な分析を行うことが困難だった。
V2レポートでは、シミュレーション評価体系の粒度とカバレッジが大幅に拡充されている:
- RoboTwin:新たに8つのポリシーに対応し、Clean(クリーンな基準環境)とRandom(ランダムな外乱環境)の双方の評価メトリクスを同時に出力。外乱下でのノイズ耐性と安定性を評価しやすくした。
- RoboDojo:8つのポリシーに対し42の個別タスクを網羅し、単一モデルあたりの評価回数は2,100回に達し、網羅的な総合評価レポートを生成。
システムは最終的なタスク成功状態を追跡するだけでなく、フェーズごとの進捗バーをリアルタイムで記録し、汎化性、記憶容量、制御精度、長期計画、オープンエンドな指示追従の5つの次元から能力レーダーチャートを生成できる。
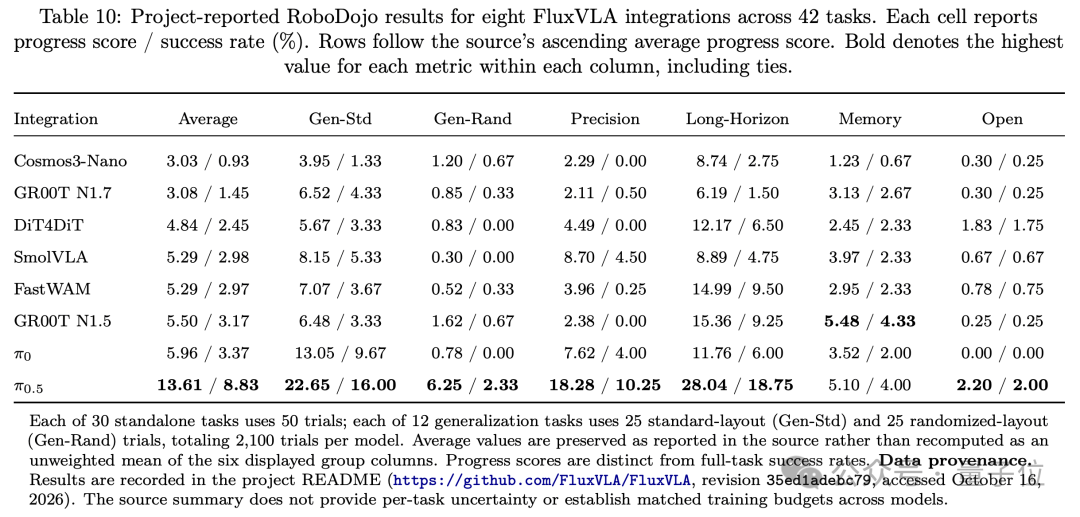
高粒度なプロセス指標は、アルゴリズムのイテレーションに精密なフィードバックを与える。例えば、衣服の折りたたみやブロックの仕分けタスクにおいて、モデルが事前の計画や接近段階では安定しているものの、最後の配置時にのみズレが生じる場合、システムは「フェーズ完了度」と「エンドツーエンド成功率」を組み合わせてボトルネックを素早く特定できる。問題が視覚表現にあるのか、長期的な動作計画にあるのか、あるいは末端の高周波制御にあるのかを明確化できるのだ。
失敗原因が明確になれば、データや計算リソースを盲目的に追加する試行錯誤の無駄を大幅に削減し、最適化の効率を確実に高めることができる。
「シミュレーションの高スコア」から「実機での実動作」へ:エンジニアリングの溝を越える
エンボディドAIの分野では、シミュレーション環境と物理的な現実世界との間に常に大きな「Sim2Real」ギャップが存在する。
現在の主流なエンボディドモデルの多くは、「将来の一連のアクションチャンク(Action Chunking)を予測し、低レイヤーのコントローラーがそれを逐次実行する」という時系列出力メカニズムを採用している。このフローでは、ディープニューラルネットワークの順伝播による計算コストが大きくなりがちである一方、ロボットの低レイヤーサーボ制御ループは高周波で駆動し続ける必要がある。
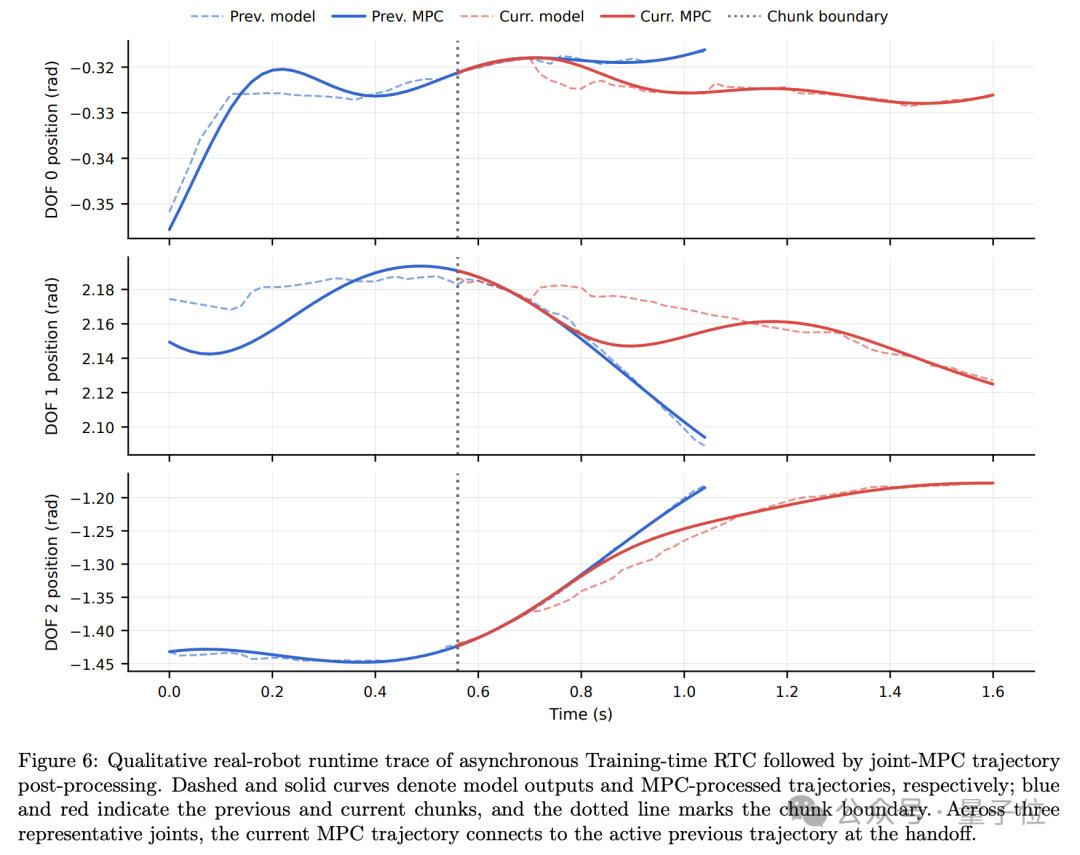
前の軌道が完全に実行し切れていない段階で新しく予測された次の軌道が送られてくると、時系列の継ぎ目で不連続な姿勢の跳躍(ジャンプ)が極めて発生しやすくなる。さらに、モデルが出力する理論上のアクションシーケンスは、実際のハードウェアに投入される際、モーター出力、速度限界、加速度の平滑性といった制約を厳密に満たさなければならない。
実機デプロイで頻発する遅延のカクつきや動作のブレ(ジッター)に対処するため、FluxVLA Engineは実運用を見据えた包括的なシステムエンジニアリングソリューションを構築した:
ソリューション1:基底の計算リソース最適化により、最大9.64倍の推論加速を実現
モデルの重みやネットワークトポロジーを一切変更することなく、GR00Tやπ 0.5などの主要モデルに対して基底カーネル演算子の再構成と計算グラフトポロジーの最適化を行い、不要なGPUメモリ転送やスケジューリング遅延を極小化した。
レポートに記録された8組の「モデル×ハードウェア」のテスト構成において、最適化後の推論スループット周波数はベースラインと比較して2.31〜9.64倍に向上した:
- NVIDIA A100環境において、π 0.5の推論周波数は2.20Hzから21.2Hzへと急伸し、9.64倍の高速化を達成。
- エッジコンピューティングデバイスであるAGX Orin (64GB)において、GR00Tの実行フレームレートは3.20Hzから7.40Hzへ、π 0.5は1.40Hzから4.40Hzへと向上。
加速処理中も高い数値精度が維持されている。GR00Tのアクション出力ヘッドに対する数値整合性の検証では、高速化後の出力テンソルと元のモデルとのコサイン類似度が0.99999以上を維持し、最大絶対誤差は約0.02以内に抑えられた。精度の損失をほぼゼロに抑えながら、エッジハードウェアの計算能力を引き出すことに成功している。
ソリューション2:RTC協調機構とスムージングフィルタの導入による実行の連続性担保
アクションの時系列ジャンプ問題に対し、FluxVLA Engineはリアルタイムアクションチャンキング協調(RTC: Real-time Chunking Coordination)機構を内蔵している。
この機構は、現在実行中の動作軌道終端におけるダイナミクス状態を利用し、新しく予測された軌道の開始部分に動的な平滑接続制約を適用して、アクションチャンク間のスムーズな遷移を実現する。さらに、軌道後処理モジュールにおけるキネマティクス境界制約とローパスフィルタを組み合わせることで、アクチュエータに送られるトルクおよび速度指令が厳密に物理的許容範囲内に収まるように制御する。
推論最適化によって生成遅延の問題を解消し、RTCと後処理のスムージングによって制御ループの安定性を担保することで、実機の動作における異常なブレを効果的に排除し、実行の安全性とロボットアームの耐久性を向上させた。
ソリューション3:汎用的なロボット抽象インターフェースとHuman-in-the-Loop(HITL)閉ループ
ロボット本体への適合面において、FluxVLA Engineは高度に疎結合化された二層通信フレームワークを設計した。ポリシー計算と状態オーケストレーションを担当する Runner と、ハードウェアとの対話を担当する Operator だ。
Runnerはモデルの推論スケジューリング、アクションチャンク計画、フェーズ状態遷移を統括する。一方、Operatorは基底の各種センサードライバー、リアルタイムバス通信、低レイヤー制御コマンドの発行を担当する。
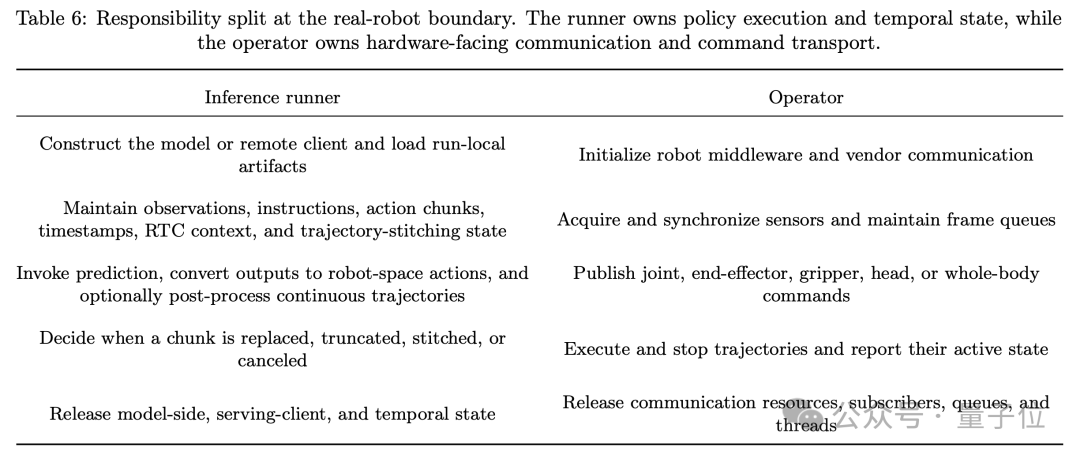
この階層型設計により、異なる形態のロボットであっても、標準のOperatorインターフェースに合わせてハードウェアドライバーをラッピングするだけで、上位のRunnerが持つアルゴリズムパイプラインを再利用でき、マルチハードウェアへの移植コストを大幅に削減できる。
テクニカルレポートでは、多様なハードウェアプラットフォームにおけるフレームワークの汎用性が検証されている:
- ALOHAプラットフォーム(6タスク):π 0.5で72.22%のエンドツーエンド総合成功率を達成。
- 双腕Frankaプラットフォーム(5タスク):GR00T N1.7で総合成功率88.00%、π 0.5で79.00%を達成。
- Rebotプラットフォーム(4タスク):π 0.5で総合成功率77.50%を達成。
- LimX Oli等身大ヒューマノイドロボット:全身協調による長距離の重量物運搬タスクにおいて、π 0.5は最初の3フェーズを完了した割合が61.67%、4フェーズすべてのタスクを完遂した割合が33.33%に達し、全身モバイルマニピュレーション(Mobile Manipulation)のエンドツーエンド制御パイプラインの実現可能性を実証した。
(注:上記のデータはすべてレポート内の特定の実験設定下での実測値であり、ハードウェア間の互換性検証を目的としたもので、アルゴリズムの横断的な優劣比較を意図したものではありません)
エンボディドAIの実装において、単に実機で動作させるだけでは初期段階に過ぎない。ロボットが軌道を逸脱した際の人間による介入データが効率的にフィードバックされ、モデルの再学習に活かされなければ、持続可能なデータフライホイールは構築できない。
そのため、FluxVLA EngineはHuman-in-the-Loop(HITL)介入およびアクティブラーニングモジュールを標準で統合している。
ロボットの自律実行が目標から逸脱した際、オペレーターが低遅延でシームレスにコントロールを引き継ぐことが可能で、介入コンテキスト、テレオペレーションによる修正軌道、報酬ラベルを自動的に記録する。
ARM技術を組み合わせた実測では、この閉ループ機構の有効性が示されている:
ALOHAでの8フェーズにわたる長時間のタオル折りタスクにおいて、行動クローニング(BC)のみのベースライン成功率は62.1%だったが、SARM報酬モデリングを導入したことで78.5%へと向上。さらにARMアドバンテージ重み付け行動クローニングアルゴリズムを組み合わせることで、エンドツーエンドの実行成功率は99.4%に達し、1時間あたりのタスク処理能力も18エピソードから32エピソードへと大幅に向上した。
ここまでくれば、FluxVLA Engineの全体的なアーキテクチャ像は極めて明確だ:
アルゴリズムから実機へのデプロイ経路を提供するだけでなく、「シミュレーション環境でのオンラインRL探索」と「実物理世界でのHITLによる経験フィードバック」という2つのエンジンを並行稼働させることで、モデルの学習から実機実行、さらにはデータの自己反復に至る完全な閉ループの貫通を後押しし、先端エンボディドAIアルゴリズムの社会実装への道を切り拓いている。
おわりに
データクレンジング、モデル学習、詳細な評価から、推論加速、マルチロボット対応のデプロイ、そしてHuman-in-the-Loopによるデータ閉ループに至るまで、エンボディドAIは「町工場的な開発」の時代を脱し、標準化され拡張可能なエンジニアリングインフラの時代へと着実に足を踏み入れている。