ヒューマン・アウト・オブ・ザ・ループで実店舗テストへ:ロングテールな現場課題を自律克服
衡宇 発凹非寺
量子位 | 公式アカウント QbitAI
商品棚の小さなフックがプライスカードに一部遮られていたため、コンビニに「アルバイト」として入ったロボットは、最初の品出しのフック掛けで見事に空振りを喫しました。
従来であれば、このような事象には必ずエンジニアの介入が必要でした。原因を突き止め、プログラムを修正し、デモ教示データを追加した上で、ロボットを再学習させるという手順です。
しかし、このロボットは違いました。自力で新たな解決策を編み出したのです。
過去の実行ログを振り返ることで、ロボットは頭部カメラの解像度に限界があること、そしてプライスカードの遮蔽が原因で小さなフックの正確な位置を特定できていないことを突き止めました。
そこで、Agent は即座に実行戦略を切り替えました。まず左手をターゲットに近づけて手首のカメラを起動し、至近距離から視野を補正。正確な位置を確認した上で、右手を使ってスムーズにフック掛けを完了させたのです。

さらに重要なのは、ロボットが単独で問題を特定し、解法を見出しただけでなく、その有効な経験をナレッジとして蓄積し、今後の活用に備えたという点です。
ロボットが実作業の中で自ら課題を発見し、戦略を動的に調整しながら経験を蓄積していく仕組み。その背景にあるのが、**智元(Agibot)が新たに発表したエンボディド(具身)Agent フレームワーク「Genie Master」**です。
これは智元が最近展開している技術発表「AI WAVE」シリーズの第4弾にあたります。今回、智元は業界に先駆けて Physical RSI(フィジカル再帰的自己進化)を実際のコンビニ業務フローへ投入しました。
Genie Master を搭載した智元のロボット「精灵 G2(Genie G2)」は、実際のコンビニ環境で稼働する際、人間の教示やデバッグに依存することなく、失敗原因の自律分析、動作戦略の調整、タスク経験の蓄積を行い、全工程で「ヒューマン・アウト・オブ・ザ・ループ(無人介入)」による継続的な自己進化を実現しています。
シミュレーション環境や実験室の限定的な設定(Toy Setting)を飛び出し、実際の商用環境で Physical RSI を走らせ、検証に成功したのは業界初となります。
Genie Master の自律進化ループは一体どのように稼働しているのでしょうか? そして、人型ロボットの大規模な商業的実用化にどのような変革をもたらすのでしょうか?
Genie Master とは?
ロボットがいかにして「自律的に会得」したのかを紐解くには、まずそのバックボーンとなる核、Genie Master を理解する必要があります。
端的に言えば、Genie Master はエンボディド Agent フレームワークであり、そのコアミッションは上位 Agent の認知・推論能力と、下位ロボットの物理的な動作実行能力をシームレスに統合することにあります。
Agent がロボット本体の各機能をスムーズに呼び出し、物理世界の実行フィードバックを理解できるようにするだけでなく、タスクの進捗に応じてその後の行動やピンポイントのトレーニングを自律的に組み立てることも可能にします。
ロボットが実際の作業中に能力不足を露呈すると、その課題は即座に自律改善ワークフローへと組み込まれます。

明らかなように、Genie Master が重点を置いているのはロボット配備後の継続的な自己進化メカニズムの構築です。これには実行時の環境認識や動的調整だけでなく、タスク完了後の経験蓄積や下位動作ポリシーのアップデートまでが含まれます。
智元が本フレームワークを開発した本来の目的は、業界が長年抱えてきた現場導入における真のペインポイントを解消することにありました。
ロボットが実際の商用環境へ投入されると、学習フェーズではカバーしきれなかったロングテールなエッジケース(Corner Cases)に必ず直面します。
動作の失敗、姿勢の乱れ、特定タスクの遅延など、従来のソリューションではアルゴリズムエンジニアが現場へ駆けつけて調査し、ロジックの修正、教示データの追加、あるいはモデルの再学習によって改善を図る必要がありました。
シーンが多様化し、タスクが複雑化するほど、導入後の研究開発や保守運用の限界コストは跳ね上がります。
あらゆる新しい要件に対して人間がゼロから調査やデバッグを行っていては、技術の進化スピードは頭打ちになり、マルチシーンでの大規模な横展開など到底望めません。
要するに、エンボディドAIが大規模な商用化へと進むには、人間の教示に頼る「受動的なファインチューニング」から、ロボットが自ら課題を診断して解決する「自己進化モデル」へと舵を切る必要があるのです。
Genie Master は、まさにこのプロセスを Agent 主導へと転換させます。
問題の診断、シミュレーション練習、効果検証の全権を Agent に委ねることで、Genie Master はロボットが自律的に新スキルを習得することを支援し、「顧客からの新たな要件提示」から「ロボットの新スキル習得」に至るデリバリーサイクルを大幅に短縮します。
前述のフックへの品出し作業にとどまらず、実際のコンビニでのフィールドテストにおいて、Genie Master 搭載ロボットは多様で複雑な環境に対応する総合的な能力を発揮しました。
智元の説明によると、Genie Master の研究開発チームは、ピッキング、品出し・陳列、清掃、異常復帰、複数ロボットによる協調作業をすでに標準業務フローに統合しており、実際の商用現場におけるロボットの自律改善ループの探求を継続しています。
アイドル時の自律「自主トレ」:エンボディド Agent フレームワークが「大脳」と「小脳」を直結
ロボットが業務中に自己進化を遂げる——ロジック自体は明快に見えます。
しかし、なぜこれまでこの構想の多くが研究室の実証段階にとどまり、実業務の中で成立させたチームがほとんど存在しなかったのでしょうか?
その最大のボトルネックは、上位の経験蓄積であれ、下位のポリシー内面化であれ、極めてシビアな技術基盤に依存している点にありました。
上位の推論を司る「大脳」の抽象的なプランニングが、正確に物理動作へマッピングされなければならず、同時に下位の実行を司る「小脳」の状態や物理フィードバックも、リアルタイムに大脳へ逆伝播されなければならないのです。
この「大脳」と「小脳」の神経回路を直結させるため、Genie Master は極めて重要な設計を打ち出しました。
それが、**エンボディド実行プロトコル「EEP(Embodied Execution Protocol)」**です。
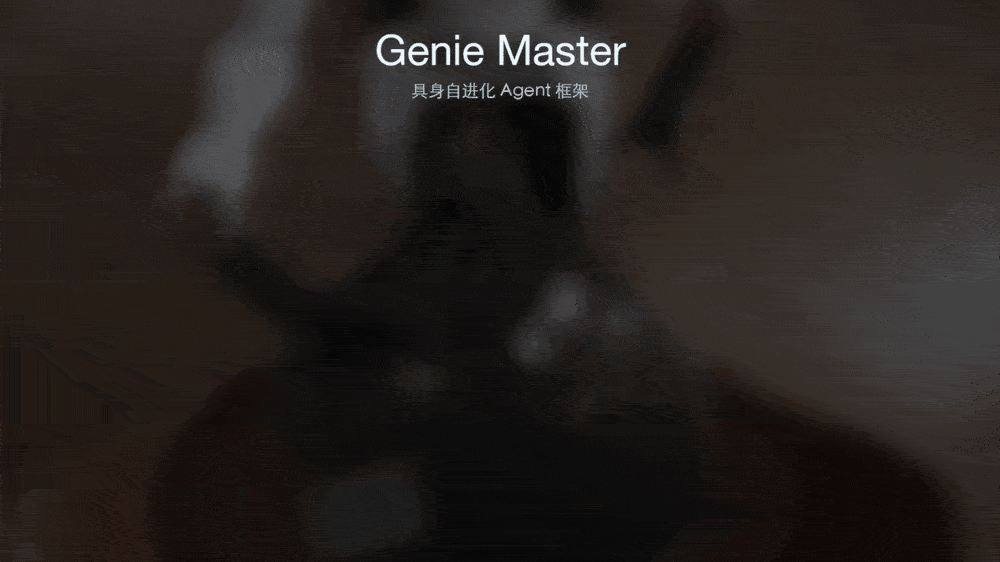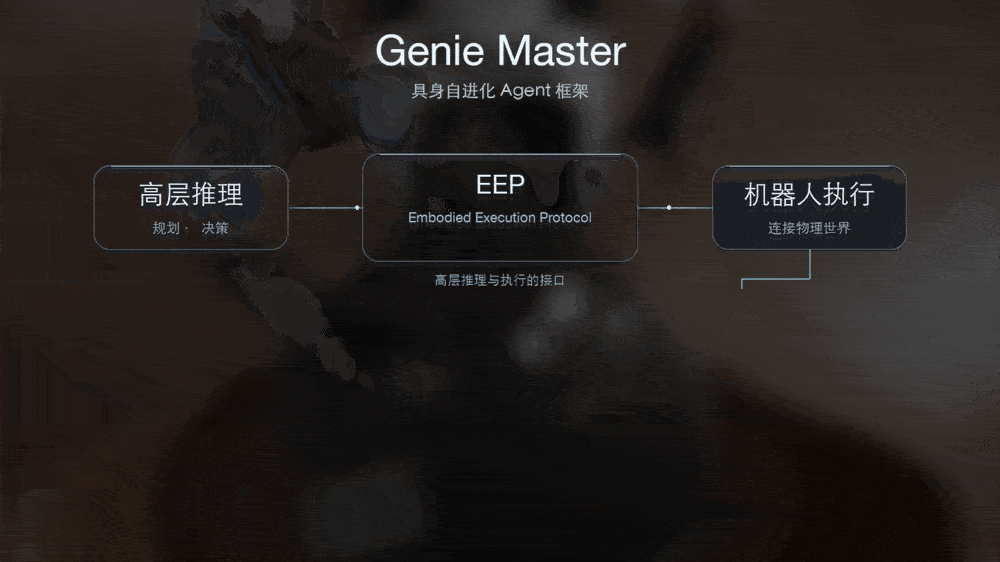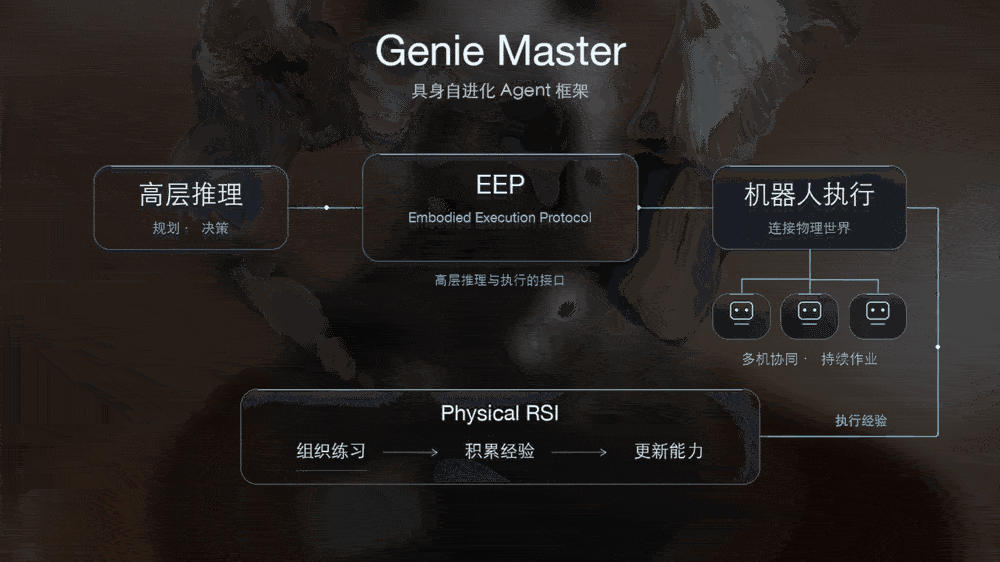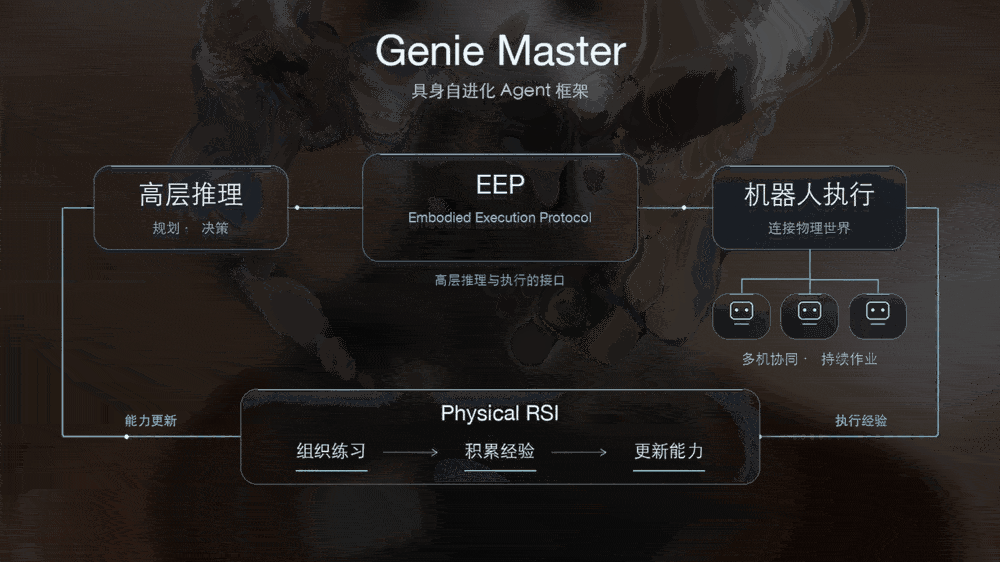
EEP は Agent と物理エンティティの間に標準化された通信インターフェースを構築し、主に以下の4つのコア次元をカバーしています。
- 機能インターフェース:Agent が、ロボットが現在呼び出し可能なアクションプリミティブとスキルの境界をリアルタイムかつ明確に把握できるようにする。
- ガイダンスインターフェース:Agent から下位の動作実行モジュールに対し、きめ細かな空間プロンプト、オブジェクト参照、マルチモーダルな言語制約を発行できるようにする。
- フィードバックインターフェース:ロボットが動作を実行した後のリアルな物理インタラクション状態を、ミリ秒単位で Agent に同期する。
- コンティニュイティ(連続性)インターフェース:複数ロボットのフリートにまたがるタスク進捗の追跡と依存関係の協調をサポートし、動的なタスクスケジューリングと中断後のシームレスな状態再開を提供する。
EEP プロトコルをベースに、時間同期(Temporal Alignment)などの協調メカニズムを組み合わせることで、上位 Agent は環境のフィードバックに応じてガイダンス指示を動的にリフレッシュできます。一方、下位のベースアクションポリシー(Action Policy)は、リアルタイムの認識観測と Agent の意味論的制約を組み合わせて精密な操作を実行し、環境観測とサブタスクの達成度を継続的にフィードバックします。
エンボディドAIシステムにおいて、推論・計画、運動制御、物理フィードバックが密接に結合して初めて、自己進化は工学的な実現性を持ちます。
EEP はまさにこの中枢をつなぐ架け橋の役割を果たしており、後続の経験の自己蓄積とポリシーの自己更新に向けた統一された基盤仕様を提供しています。
この強固な土台が完成したことで、ロボットの実稼働環境における「自律自主トレ」が機能し始めます。
コンビニの日常運用において、特定のタスクで失敗が頻発したり、制御が不安定になったり、タイムアウトが発生したり(いわゆる「能力のギャップ」が露呈)した際、Agent は単にエラーを出して停止することはありません。店舗の閑散時間帯や閉店後のアイドルタイムを活用し、これら弱点に対するピンポイントの強化トレーニングを自発的に立ち上げます。
何をどう練習するのか、評価基準をどう設定するのか、干渉や転倒が発生した際にいかに自律的にリトライ・復旧するのかに至るまで、すべて Agent が自律的にオーケストレーションと閉ループ検証を行います。これにより、実際の商用導入現場そのものが、システムへ絶え間なく改善サンプルを供給する実践の訓練場へと変貌するのです。
デュアルトラック進化:意思決定の経験蓄積と、動作ポリシーの反復更新
現場において「課題発見」と「自律自主トレ」のループを構築したあと、ロボットはどのようにして練習の成果を本体の恒久的なスキルへと昇華させているのでしょうか?
このプロセスにおいて、Genie Master はデュアルトラック(二軌道)進化戦略を採用しています。
ひとつのルートは、上位の意思決定とルール化された経験の効率的な蓄積に特化した Harness RSI。もうひとつのルートは、下位のエンドツーエンド動作ポリシーモデルの深層パラメータ更新に特化した Policy RSI です。
まずは Harness RSI を見ていきましょう。
そのコアメカニズムは、モデルの下位の重みと既存のハードウェアインターフェースを固定(フリーズ)した状態のまま、プロンプト(Prompt)、記憶メカニズム(Memory)、タスクオーケストレーションロジックを最適化することで、以降のタスク実行品質を迅速に修正・向上させる点にあります。
日常的な推論作業において、システムは成功および失敗した事例をライフサイクル全体にわたって記録します。その後、オフラインの非同期内省とメモリグラフの統合を通じて、実行軌跡をピンポイントな事前ガイダンス、終了条件の判定、例外復帰ブランチ、複数ロボット協調仕様へと変換します。これらは動的に更新される「間違い直しノート」のように長期記憶ストレージへと格納され、以降の該当シーンに応じて動的に読み込まれます。
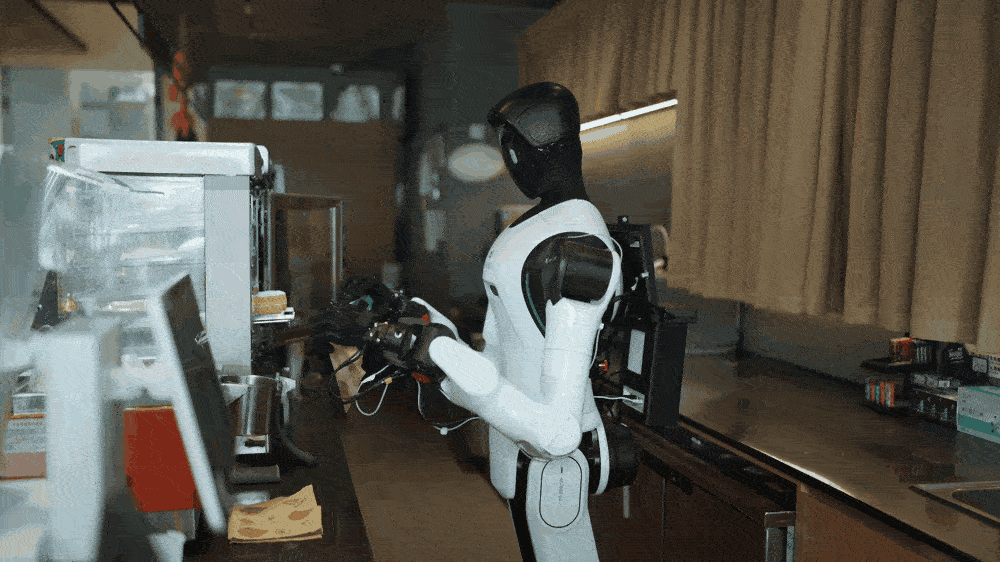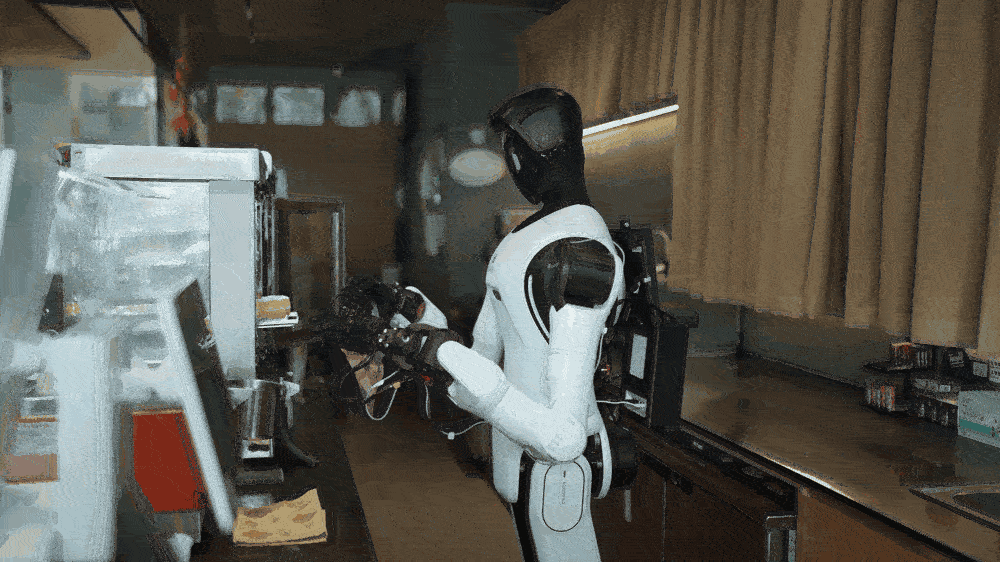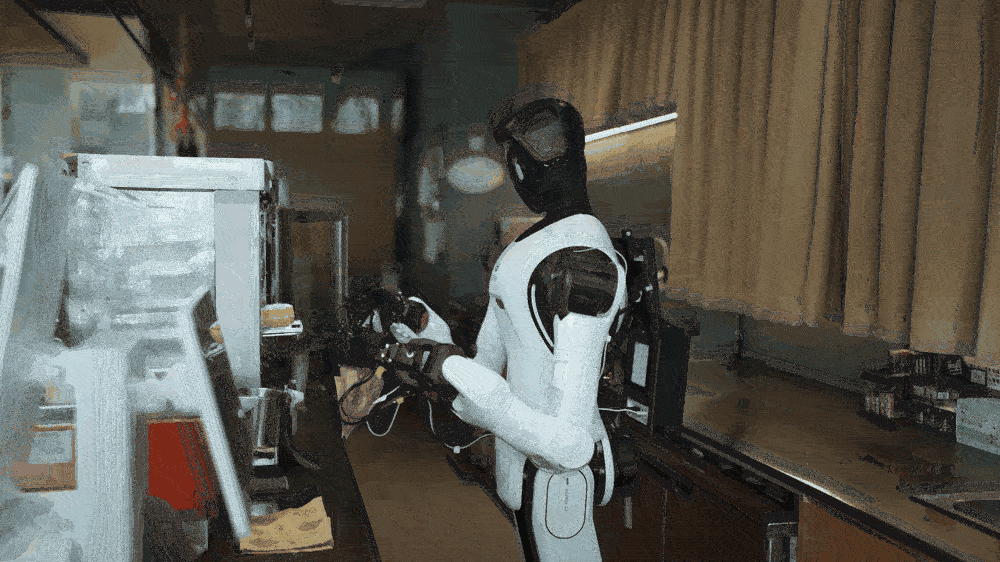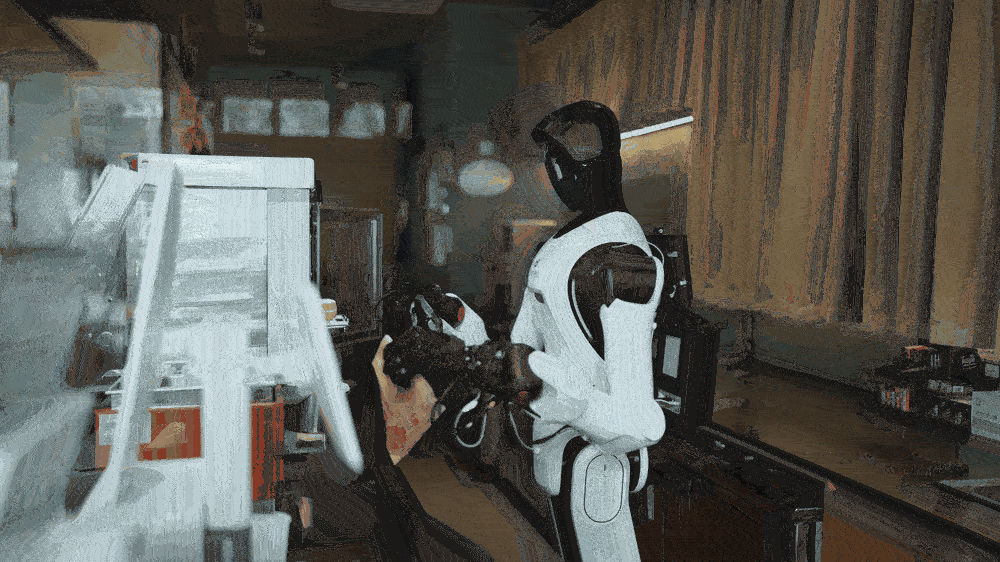
冒頭で触れたコンビニのフック掛けの事例は、まさに Harness RSI メカニズムの典型的な適用例です。
当初、小型フックのタスクは初回成功率が極めて低い状態でした。Agent は失敗軌跡を精査した結果、「頭部カメラのグローバル視野における解像度不足とラベルによる遮蔽が重なり、エンドエフェクタがフックの空間座標を正確に特定できなかった」という根本原因を突き止めました。
その後、Agent は「まず左手首のカメラで至近距離からリサンプリングして検証し、次に右手に引き継いで正確にフックへ掛ける」という複合動作シーケンスを自律的に構築し、標準的な意思決定フローとして定着させました。これにより、次回以降に同様の物理的遮蔽に直面した際にも、この経験を直接適用してスムーズに作業を完遂できるようになりました。
しかし、「間違い直しノート」が主に解決するのは上位の意思決定レイヤーの課題です。実機制御が求めるミリ秒レベルの低遅延かつ高精度な安定性に対しては、重要な操作をロボットの「筋肉の記憶」として定着させる必要があります。
そこで真価を発揮するのが Policy RSI です。
Policy RSI は、ロボットの自律作業、人間による遠隔オーバーライド(介入教示)、異常復旧の全プロセスから発生する高価値なインタラクション軌跡を網羅的に収集します。データフィルタリング、サンプルの重み付け、目標の再ラベリング(Hindsight Relabeling)といったデータエンジニアリング手法を通じてデータの密度を高め、教師ありファインチューニング、模倣学習、あるいは強化学習に基づいて下位のベースアクションポリシー(Action Policy)を直接更新し、最適化の成果をニューラルネットワークのパラメータ層に定着させます。
店舗内の「デリバリー商品の袋詰め時の持ち手絡まり防止」タスクを例にとると、ロボットがレジ袋の持ち手の絡まりを解く際や、軌跡の引き戻し、姿勢修正を行った際に生成されるインタラクションデータは、選別とクリーニングを経て、そのまま下位ポリシーモデルの増分トレーニングに活用されます。これにより、将来的に柔軟物による干渉へ対処する際のロバスト性が大幅に向上します。
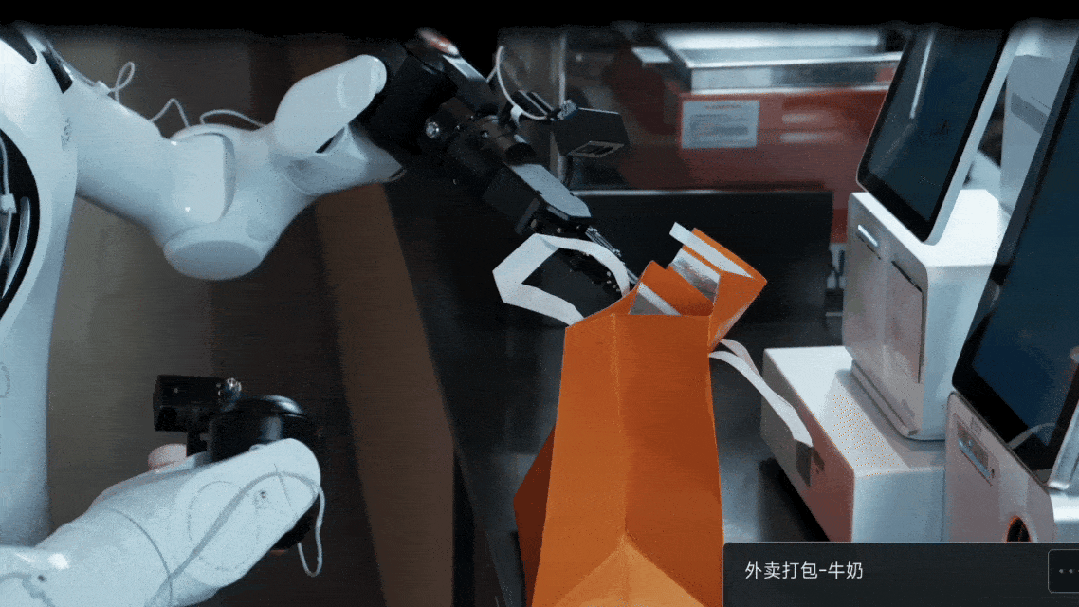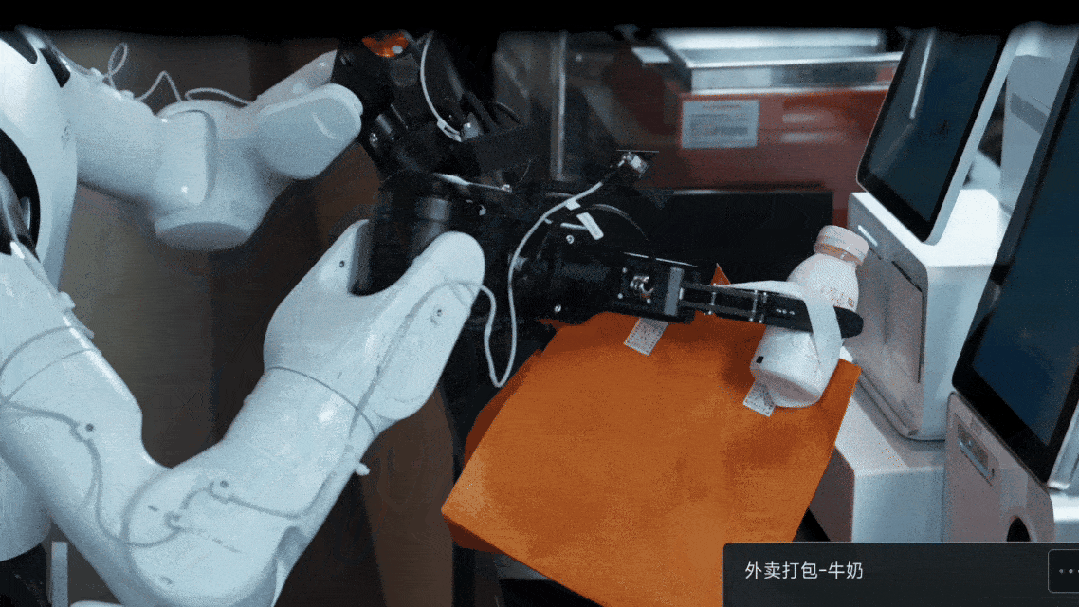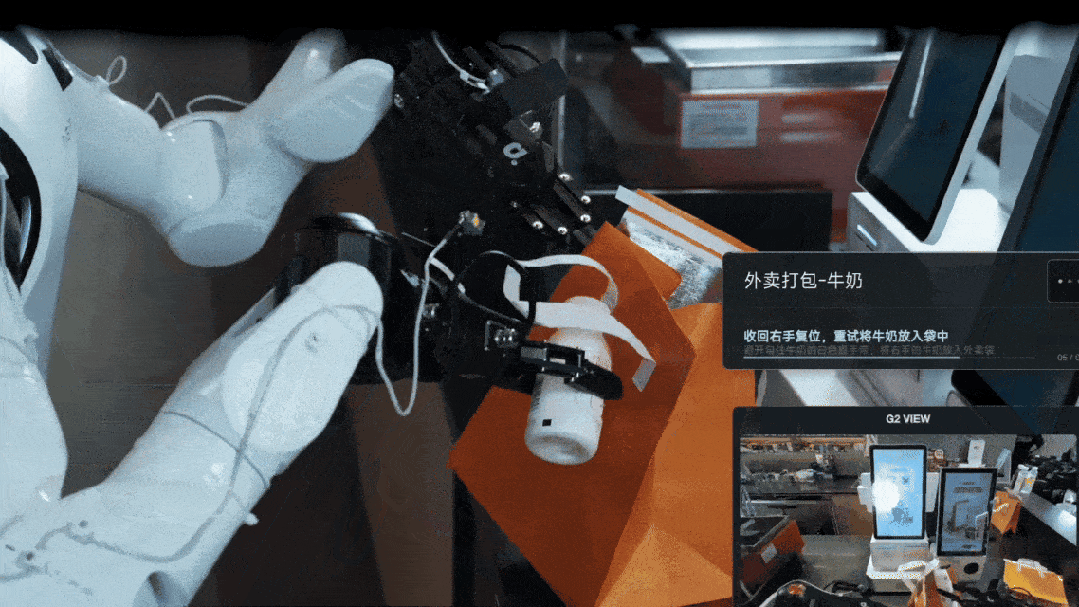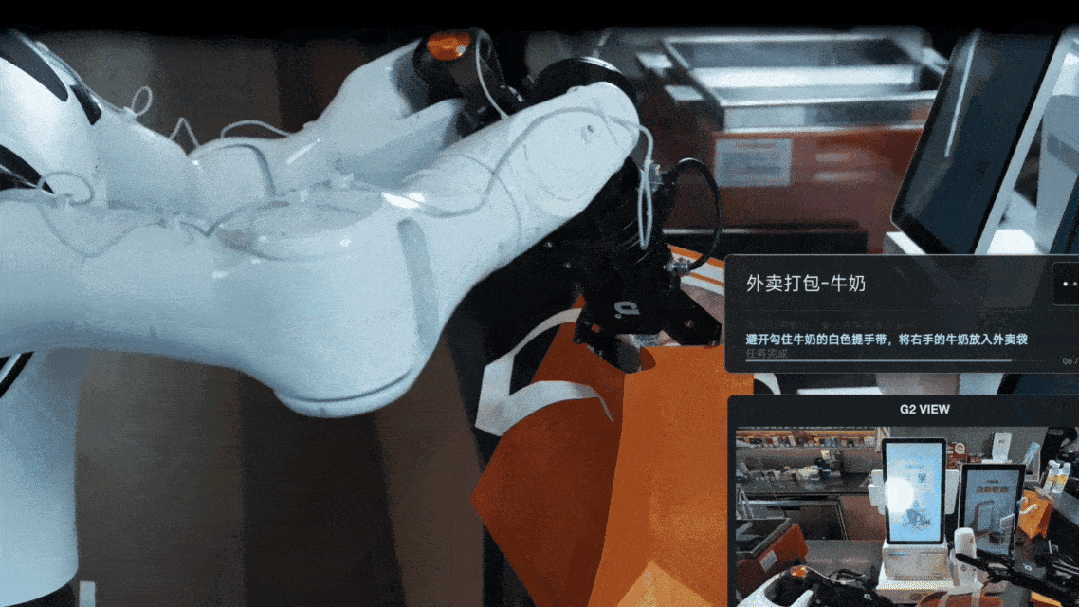
Policy RSI を通じて、システムは物理的な相互作用の経験から継続的に知見を吸収し、より滑らかな運動制御精度と、より厳密な指示への追従(アライメント)能力を実現します。
なお、このシステムは人間の介入を完全に排除しているわけではありません。難易度の高いシーンにおける人間によるオーバーライド教示データの取り込みにも対応しており、ポリシーモデルの最終的なデプロイにあたっては、整備されたデータパイプラインによるクリーニングと収束性の検証プロセスを経る設計となっています。
さらに重要なのは、これら2つの進化パスは個別に分断されているのではなく、互いに噛み合って加速し合うフライホイール構造を成している点です。
- Harness RSI は上位の経験蓄積と構造化を担い、システムの失敗要因の特定、トレーニングケースの設計を支援し、即座のタスクパフォーマンスを迅速に向上させます。
- Policy RSI は高価値な実戦サンプルに基づいて下位の動作ポリシーを学習させ、頻出する高難度操作を下位の確定的な動作能力として定着させます。
この双方向の相互作用によって、実業務でのテスト、欠陥特定、自律集中トレーニングから、経験の集約とモデルの内面化に至る、完全な好循環フライホイールがつながるのです。智元はこのアーキテクチャを通じて、システムが実戦経験を1サイクル積むごとに、自己診断、サンプル選別、能力進化の効率がワンランクずつ引き上がる構造の確立を目指しています。
モデルが自らの能力を高める能力そのものを再帰的(Recursive)に飛躍させ、同じハードウェア・ソフトウェアの投資から指数関数的な汎化の伸び代を引き出す——これこそが「再帰的自己進化(RSI)」のコアとなる技術価値です。
「出荷時固定」から「現場での自己進化」へ
単一のコンビニ業務という断面を離れ、エンボディドAI業界全体の進化の文脈から俯瞰すると、智元の Genie Master は現場実装の新たなパラダイムを切り拓こうとしています。
研究開発パラダイムの観点では、従来のエンボディドシステムが抱えていた「能力は出荷時点で固定され、アップデートには工場への送り返しが必要」という閉塞感を打ち破り、業界を「現場配備後の継続的な成長」という動的進化パラダイムへと押し上げます。
現場のシステムが新スキルの解法を自律探索できるようになれば、顧客のカスタム要件提示から現場での大規模要件達成に至る納期は大幅に圧縮されます。
ビジネス化の観点でも、最もハードルの高かったコスト計算の構図が整理されます。
実際の稼働環境でロボットが「動けば動くほど熟練していく」のに伴い、ハードウェア本体と知能システムの総合的な能力獲得コストは、運用を通じて希釈され、高いリターンをもたらします。
将来的に多店舗展開や異業種シーンへ横展開する際にも、二次開発やエンジニアリング導入にかかる限界コストは確実に低下していきます。
そして、この右肩下がりに低下し続ける限界コスト曲線こそが、エンボディドAIが兆元規模の産業およびコンシューマー市場へ浸透するための、決定的な基底ロジックとなるのです。
智元が10月22日から開始した技術発表シリーズ「AI WAVE」を振り返ると、第4弾となる Genie Master は、同社のフルスタックエンボディド技術マトリクスにおいて極めて重要なハブの役割を果たしています。上位の基盤大規模モデルとフルスタック AI 機能を、実際の商業業務パイプラインへシームレスにつなぎ止めることに成功したからです。
もちろん、ペーパー上の精妙なシステムアーキテクチャ設計も、最終的には最も過酷な物理世界での検証を通過しなければなりません。
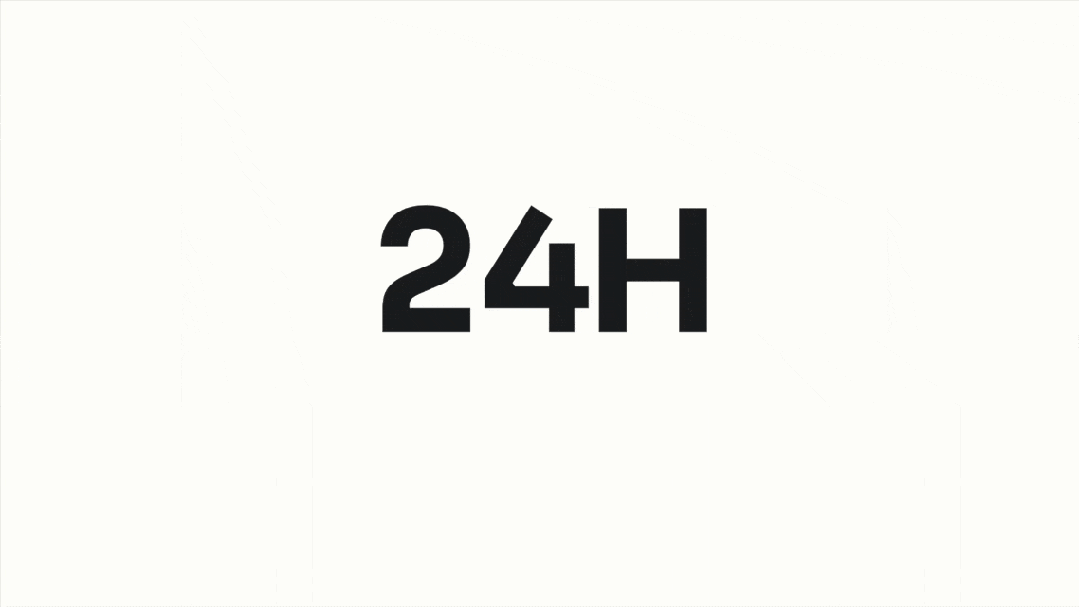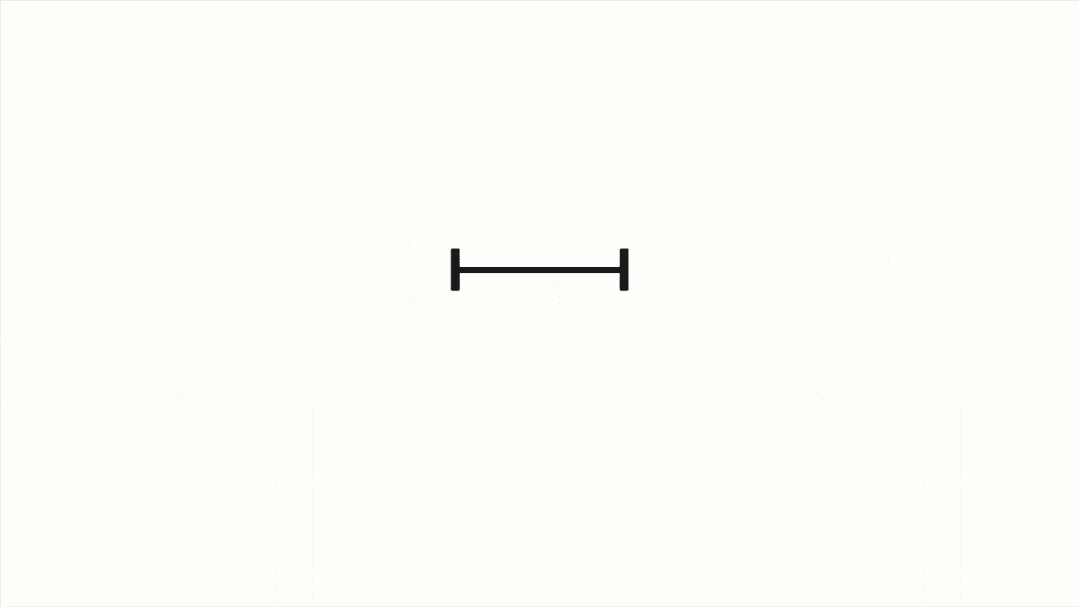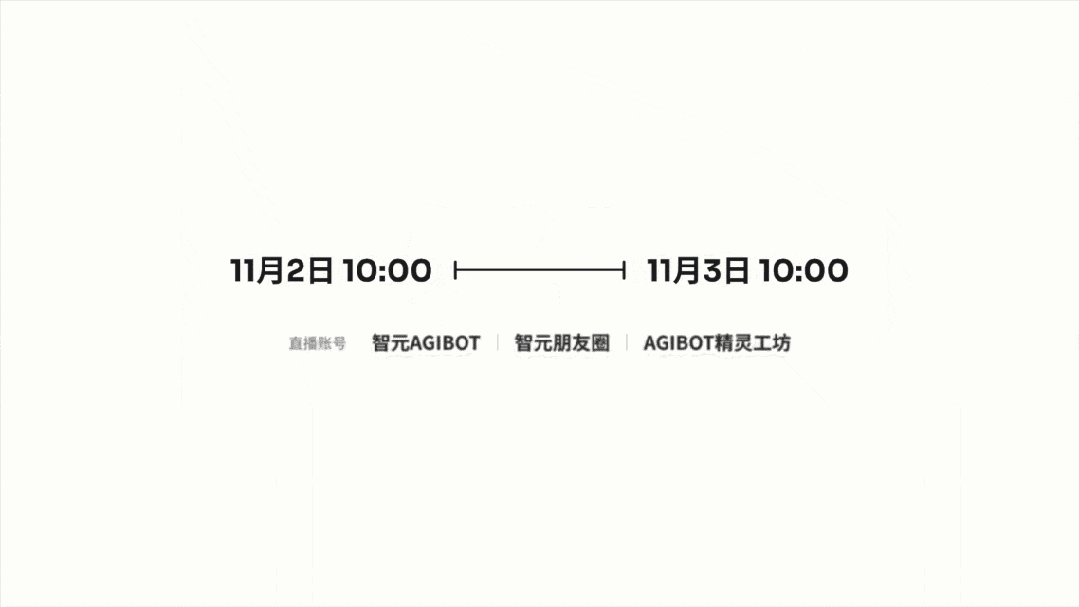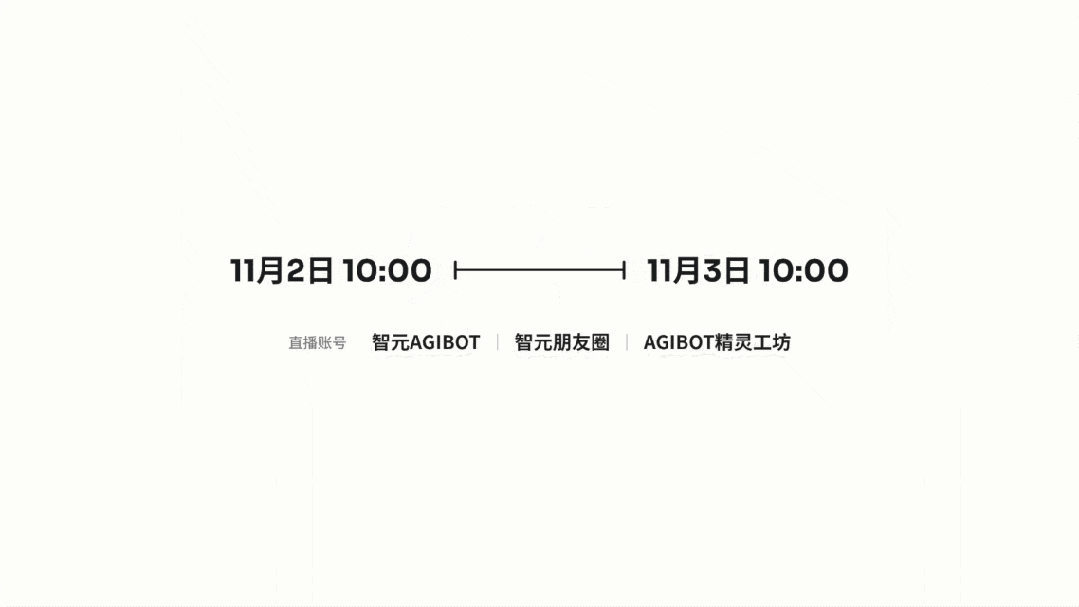
11月2日、智元は全編ライブ配信による「リアルコンビニ 24時間連続稼働実測テスト」を実施します。
当日は6台の「精灵 G2」ロボットが協調クラスタを形成して連続シフトに入り、台本のない実際の店舗運営環境の中で、ロングテールな物理的課題という究極の試練に挑みます。