
オープンソース化からわずか1週間で、GitHub のスター数は 1,000 を突破、X でのインプレッションは 100 万を超え、Today’s News のおすすめにも選出されました。
ドキュメント解析の領域に、極めて強力な新星が登場しました。
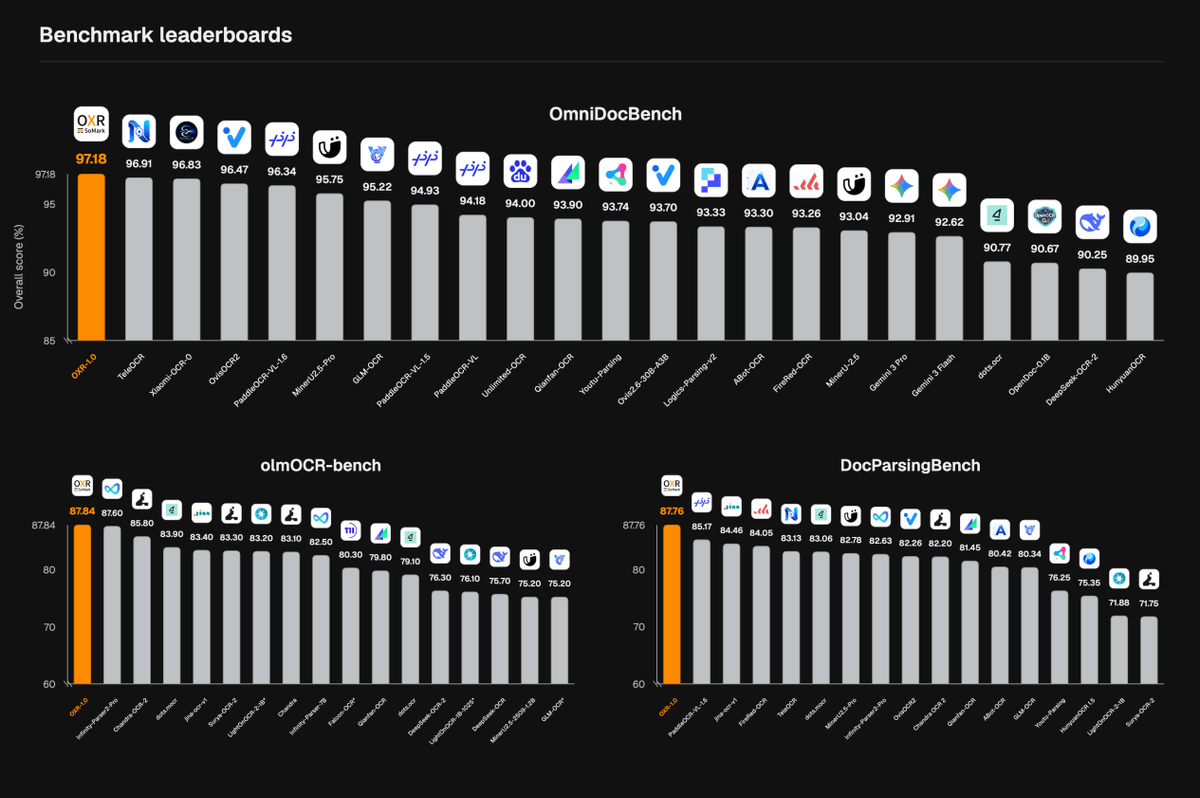
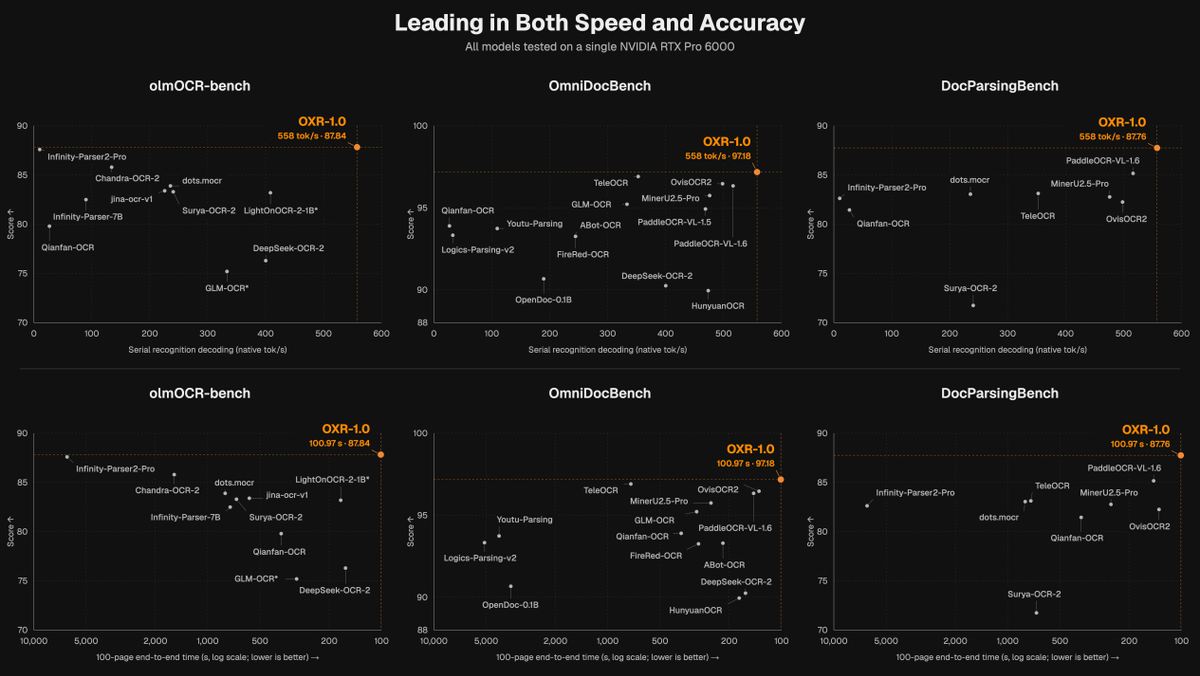
OXR が正式にオープンソース化されました。メインモデルはわずか 1.3B パラメータでありながら、OmniDocBench、olmOCR-Bench、DocParsingBench の主要ベンチマーク 3 つすべてで首位を獲得。完全な解析速度においても、比較対象となった PaddleOCR-VL-1.6 や MinerU2.5-Pro を凌駕し、軽量モデルとしての精度と効率の両面でトップに立ちました。
このモデルを開発した SoMark チームは、ドキュメントインテリジェンス分野を深く追求してきた中国国内のスタートアップ企業です。これまで主力製品である SoMark を軸に解析技術を磨き続けてきましたが、今回、オープンソースモデルとして OXR を正式にリリースしました。
OXR の正式名称は Optical Everything Recognition です。従来の OCR から OXR への進化により、処理できる対象は単なるテキストに留まりません。OXR は表、数式、化学式など 13 種類に及ぶ複雑なドキュメント要素を解析できるだけでなく、段組みレイアウトの読み順を正確に復元し、Markdown や JSON 形式で出力します。さらに完全なレイアウト座標情報も保持するため、非構造化な複雑ドキュメントを Agent が直接活用できる高品質なデータへと変換できます。
1 高精度な解析で世界3大ベンチマークを制覇
チームが公開した評価結果によると、OXR は OmniDocBench、olmOCR-Bench、DocParsingBench の各テストセットでそれぞれ 97.18、87.84、87.76 という優れたスコアを記録し、すべて世界第 1 位を獲得しました。
優れたベンチマークスコア以上に説得力を持つのが、複雑なドキュメントに対する OXR の実際の処理性能です。
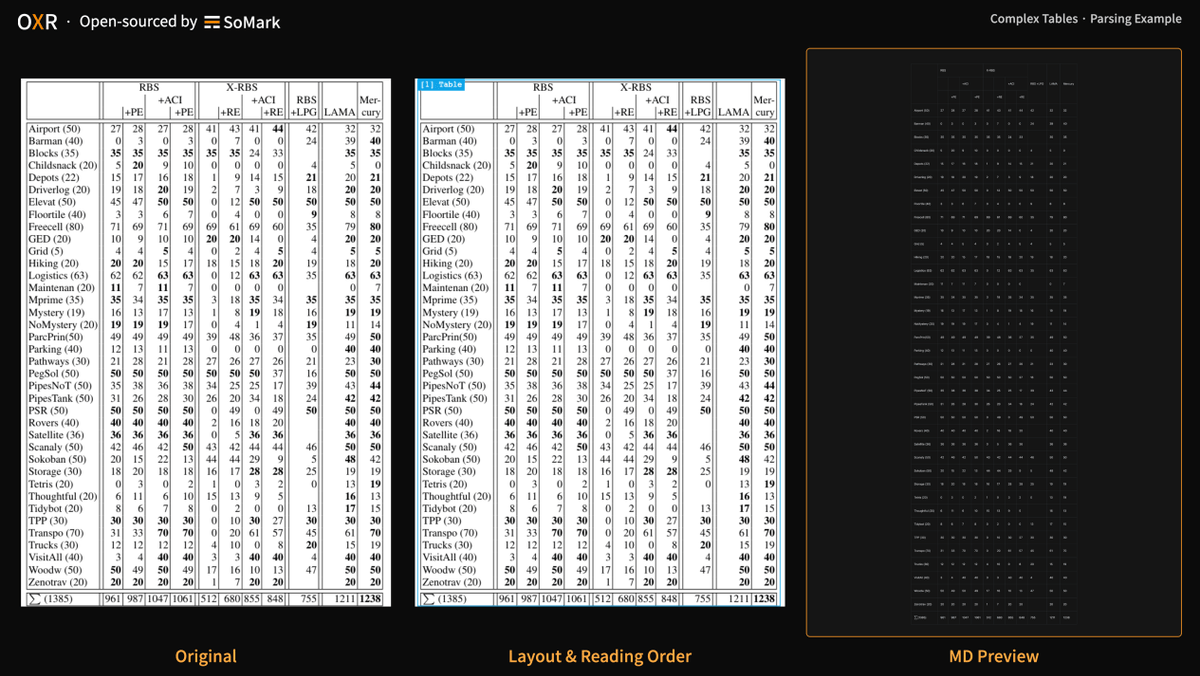
行や列をまたぐ複雑な表において、テキストを正しく認識することは最初のステップにすぎません。行や列の対応関係やセルの結合が崩れると、データは本来のセマンティクス(意味的な関連性)を失ってしまいます。OXR は表の構造を完全に維持したまま HTML 形式へと変換して出力できるため、後続のデータ表示や処理が大幅に容易になります。
研究・論文系のドキュメントは、さらに解析の難易度が高くなります。数式には複雑な上下の添字や多重ネスト構造が含まれ、化学文献には複雑な反応式や分子構造式が存在します。OXR は数学の公式を標準的な LaTeX 形式で出力し、化学反応式を mhchem 形式へ、化学構造式を SMILES 文字列へと変換できます。これにより、ページ上の静止画像が検索・計算可能な構造化表現へと生まれ変わります。
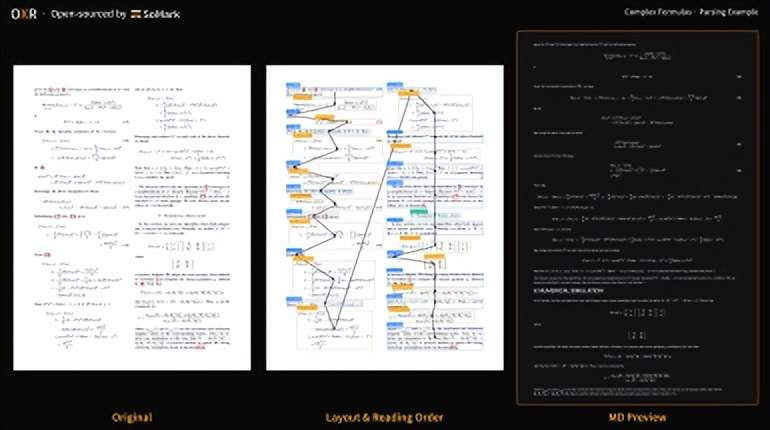
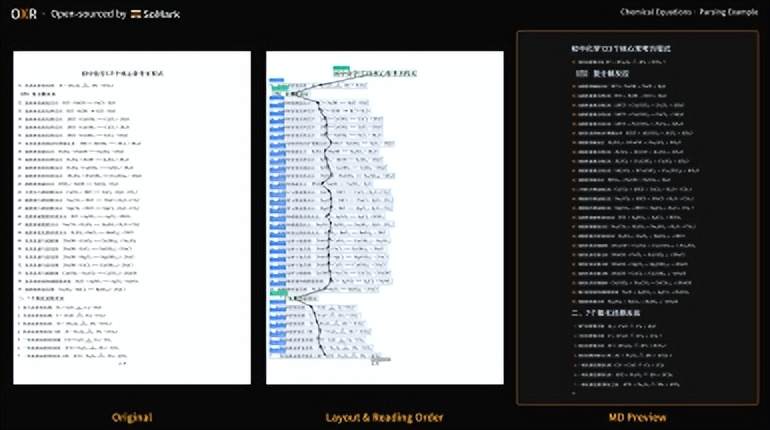
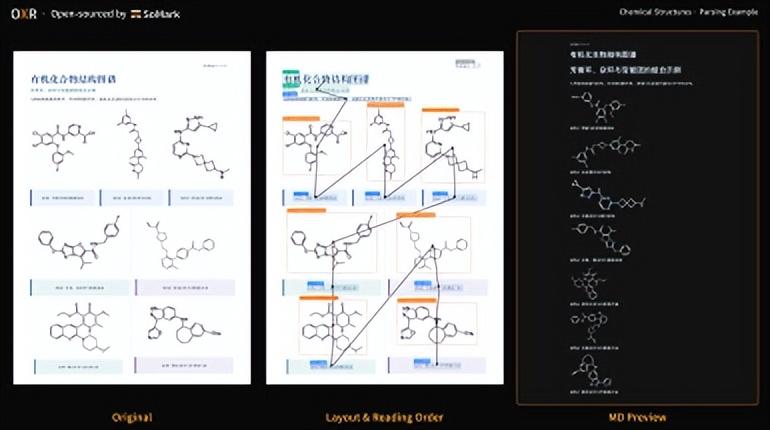
複数カラム(段組み)でレイアウトされた学術論文、新聞、試験問題などでは、「読み順」も極めて大きな課題となります。たとえモデルが各領域のテキストを正確に認識できたとしても、段組みをまたいで読み飛ばしたり、本文と注記が混ざったりしてしまえば、元の文章の意味は完全に損なわれてしまいます。OXR は内容の認識と同時に読み順を正確に判定し、精密なレイアウト座標を提供することで、元のページにおけるコンテンツの位置情報を余すところなく保持します。
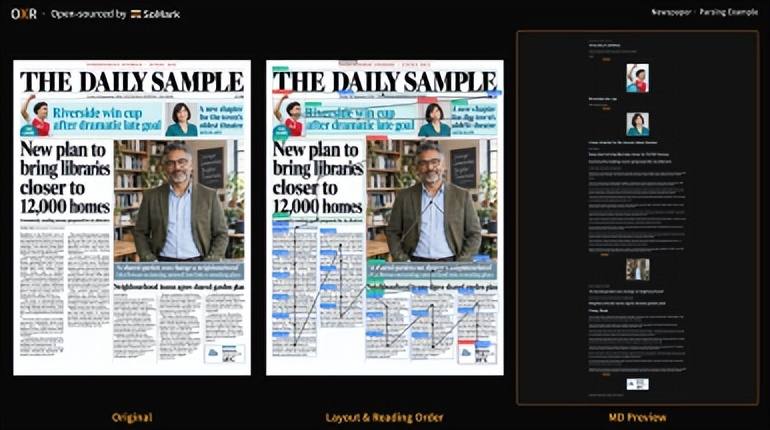
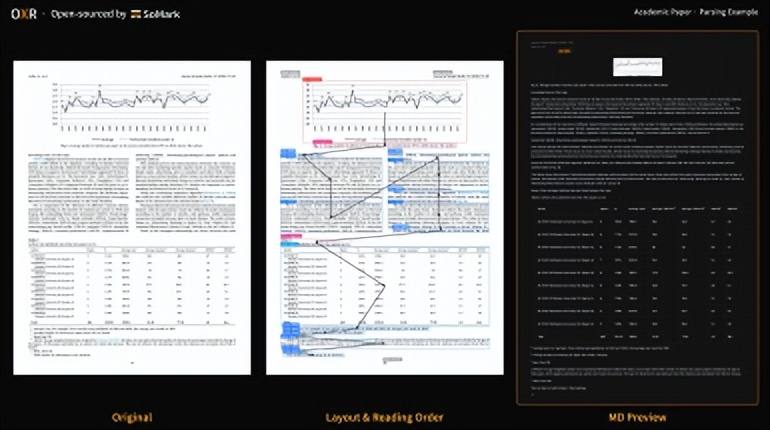
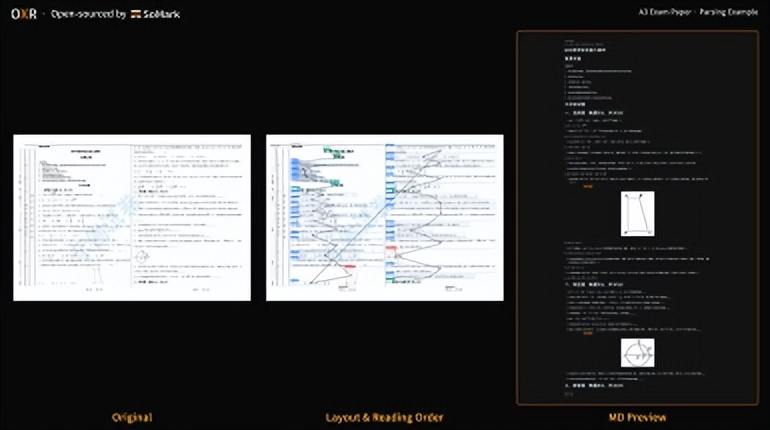
これらの能力が組み合わさることで、OXR が掲げる「Everything」が実現されています。テキスト、表、数式、化学構造式、コードブロックなど 13 種類のドキュメント要素を網羅し、PDF や各種ドキュメント画像を Markdown や JSON へと極めて高い忠実度で解析。後続の AI Agent や RAG(検索拡張生成)パイプラインへとシームレスに連携できます。
2 精度と速度を両立:正確なだけでなく、圧倒的に高速
1 ページのドキュメントを処理する際、数秒の差は気にならないかもしれません。しかし、膨大な論文の取り込み、過去のアーカイブ整理、金融リサーチレポートの一括解析などの場面では、処理効率の差がレイテンシや計算コストに直結します。
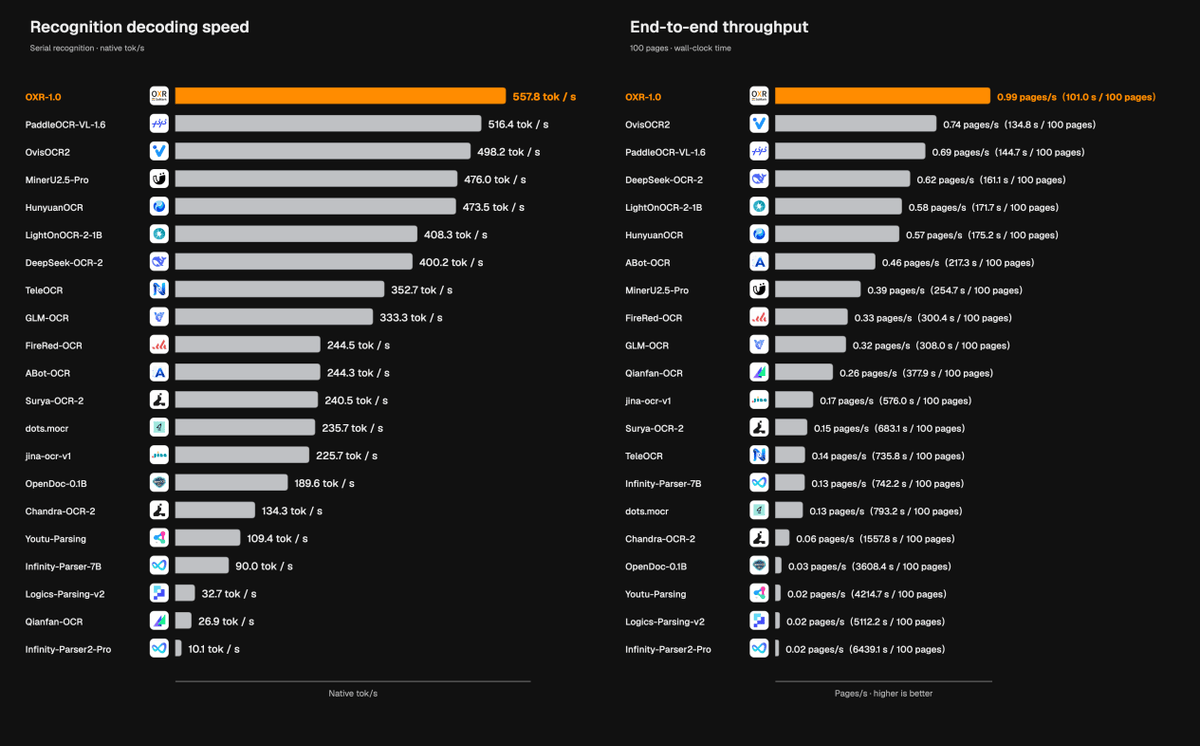
チームが公開した同一条件下でのフル解析ベンチマークテストによると、RTX PRO 6000 Blackwell(96GB)1 枚の環境下で OmniDocBench からランダムに抽出した 100 ページのドキュメントを解析したところ、OXR の平均所要時間はわずか約 101 秒でした。一方、PaddleOCR-VL-1.6 は約 145 秒、MinerU2.5-Pro は約 255 秒を要しました。
より少ないパラメータ数、より高い解析精度、そしてより高速な推論速度が、初めて 1 つのモデルで同時に実現されました。
これは主に、OXR の巧妙なタスク分割アーキテクチャによるものです。まず軽量なレイアウト解析モデルでコンテンツ領域を素早く特定し、その後にメインモデルがコンテンツの認識と読み順の推論を集中的に実行します。
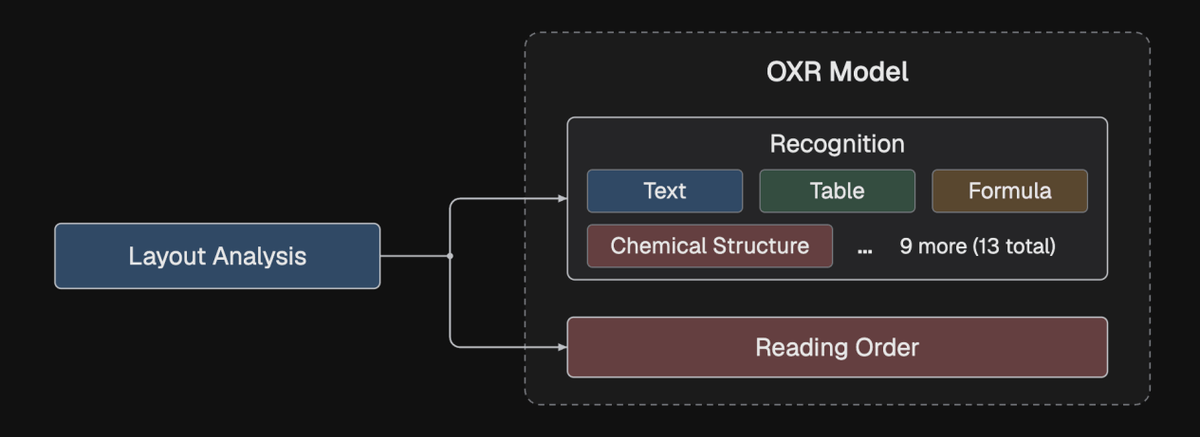
読み順の再構成をコンテンツ認識フェーズに統合することで、レイアウトのトポロジー順序を個別に処理する余分な計算コストを排除できるだけでなく、モデルが文脈のセマンティクスを加味して前後の順序を正確に推論できるようになりました。これこそが、OXR が品質と効率の両立を果たした重要な技術的アプローチです。
3 RSI 学習パラダイム:ロングテールおよび弱点サンプルに基づく再帰的自己改善
優れたパフォーマンスの背景には、OXR の学習アプローチにおける革新性があります。従来のドキュメント解析では、固定規模のデータセットだけであらゆるイレギュラーケースをカバーすることは困難でした。刻々と変化するレイアウト、文体、利用シーンに対し、未知のドキュメントに対しても安定して動作させるにはどうすべきでしょうか。
OXR はポストトレーニング段階において、**ドキュメント解析向けとしては初となる「再帰的自己改善(Recursive Self-Improvement: RSI)」**という学習パラダイムを導入しました。これにより、推論時に生じるエラーや弱点サンプルを、次回以降のモデル改善のためのデータとして効率的に転換しています。
このプロセス全体は、複数のモデルが協調して動作する「弱点克服ループ」と捉えることができます。
- まず OXR がアノテーションのない未ラベルドキュメントを解析し、初期の予測結果を生成します。
- 外部モデルが認識精度を評価してサンプルごとに原因を特定し、独立したクラスタリングモデルが問題のタイプ別に自動分類します。
- 判別モデルがその弱点に特化した高品質な拡張学習データを生成し、次サイクルのファインチューニングのために OXR へとフィードバックします。
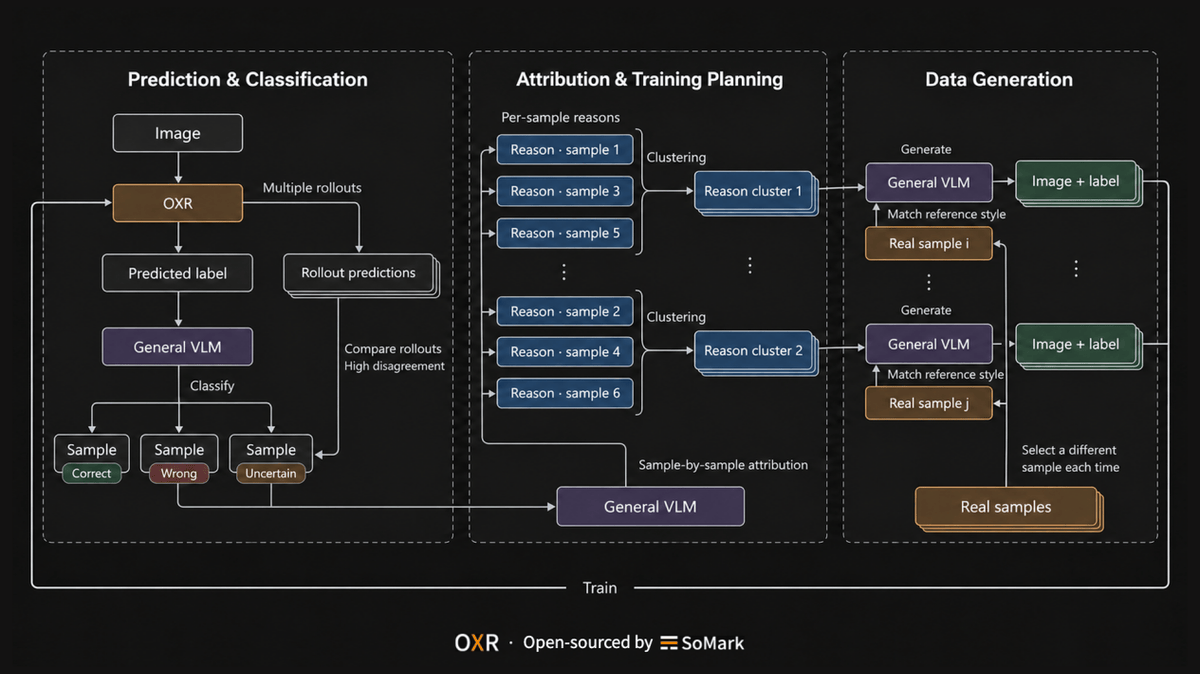
この仕組みにより、学習データは極めて明確な問題意識を持つようになり、弱点へのピンポイントな対処によってモデルの収束とイテレーションのサイクルが大幅に加速しました。また、ループ内で新たに追加される学習データは人間のアノテーションにまったく依存しないため、人手作業に伴う効率とコストのボトルネックを根本から解消しています。
4 プラガブルなモジュール式レイアウト解析で、多彩な業務要件に柔軟対応
認識精度の向上は継続的なモデル改善が必要ですが、実際のビジネス現場では、ユースケースごとに「ドキュメント構造」自体の定義が異なります。
たとえば同一の挿絵セットに対して、アーカイブ保存の場面では画像全体をまとめて保存したいことが多い一方、画像検索の場面では画像ごとに個別スライスへ分割することが求められます。また、タイトル、テキスト、外枠を含む図表テキスト混在領域について、リッチテキストとして分解したいシステムもあれば、単一の表構造として抽出したい業務システムもあります。これらはいずれも、それぞれの業務要件において合理的なものです。
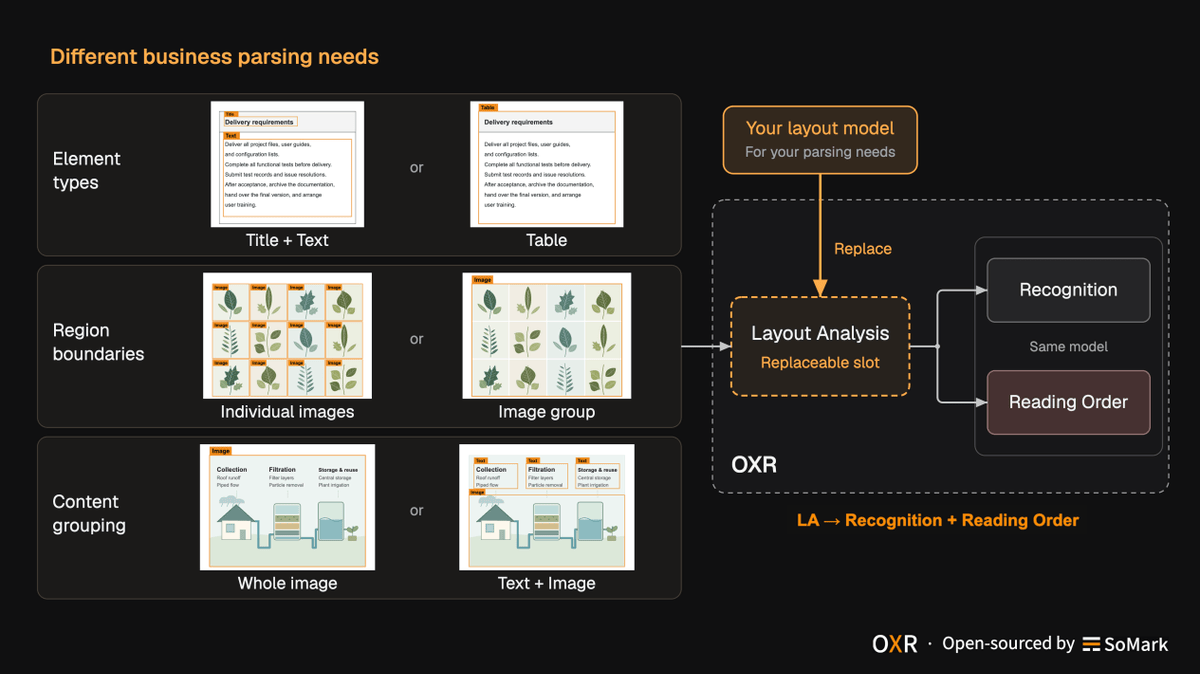
そこで OXR は、レイアウト解析を独立した疎結合かつプラガブルなモジュールとして設計しました。
開発者は、組み込みの高性能レイアウト解析モデルをそのまま利用することも、自社の業務ルールに沿った外部のレイアウト解析アルゴリズムをシームレスに組み込むことも可能です。要素のカテゴリ、ブロックの境界線、コンテンツのグループ化を自由に定義したうえで、OXR の強力なコンテンツ認識と読み順推論能力をそのまま活用できます。
RAG ナレッジベース、自律型 Agent、ドキュメントワークフローを構築している開発者にとって、OXR は極めて高い解析精度、高速な推論スループット、優れたレイアウト適応性を兼ね備えた、オープンソースの有力なファーストチョイスとなります。
現在、OXR はコードとモデルの重みを全面的にオープンソース化しており、開発者が実際のドキュメントで検証できるよう、オンラインデモおよび無料 API も公開されています。
- GitHub リポジトリ:https://github.com/SoMarkAI/OXR
- Hugging Face モデルウェイト:https://huggingface.co/SoMarkAI/OXR-1.0
- オンライン Demo:https://free-oxr.somark.cn/
- 無料 API:https://free-oxr.somark.cn/api/v1
より高度なエンタープライズ本番環境のドキュメント解析ニーズに向けて、同チームは独立した独自専有モデルをベースにした商用グレードのドキュメント解析エンジン「SoMark」も並行して提供しています。
- SoMark 公式サイト:https://somark.cn/
SoMark からオープンソースの OXR に至るまで、チームは長年培ってきた技術的蓄積を開放し、開発者にその価値を届けています。これはまさに同チームが掲げる「ドキュメントに眠る知識を AI が直接利活用できる高品質なデータへと変換し、あらゆる業界のリアルなビジネスシナリオをエンパワーする」というビジョンの具現化と言えます。