
OCR 3.0時代の到来
BaiduのOCR技術が再び大幅な進化を遂げました。「Wenxin Unlimited OCR 2」が正式にリリースされ、オープンソースとして公開されました!
今バージョンのターゲットは、長編小説を最初から最後まで「一気に読み通す」ことです。
『賢者の石』から『死の秘宝』まで、全7巻に及ぶ『ハリー・ポッター』シリーズの連続認識・テキスト化を行い、3,600ページ以上におよぶ長大なコンテンツを最後まで一切つまずくことなく読み切りました。
1,200ページ超・数十万字に及ぶ『三体』全巻であっても同様に、途中で途切れたり詰まったりすることなく、一気通貫で処理できます。
しかし、これほど膨大なページ数を連続して読み込むには、モデルにとって極めて高いハードルを越える必要がありました。それが**「VRAM(GPUメモリ)」の壁**です。
ドキュメントが長くなるほど、推論時に保持しなければならない中間情報(KVキャッシュ)が膨らみます。これは言わば、モデルが読みながら書き留める「メモ」のようなものです。ページ数が増えれば増えるほど、メモ帳は分厚くなります。このメモは膨大なVRAMを圧迫するだけでなく、過去のメモをめくって探すのにも莫大な時間がかかってしまいます。
公式技術レポートにおける100ページ規模の単一シーケンス検証において、Wenxin Unlimited OCR 2は驚異的な数値を叩き出しました。
全ページのビジュアルキャッシュを常にVRAM上に保持する従来の標準的なデコード手法と比較して、ピーク時のKVキャッシュ消費量は47GBから1.77GBへと急減し、約96%もの削減を達成しました。
47GBという数字は、多くの一般的なノートPCの総メインメモリ容量を上回る規模です。さらに重要なのは、これが単なるKVキャッシュのみの消費量であり、モデルの重み(ウェイト)などの固定メモリ消費はまだ含まれていないという点です。
前世代の「Unlimited OCR」も、優れた複数ページ連続解析能力によってオープンソースコミュニティで絶大な支持を集めていました。累計ダウンロード数は1,000万回を突破し、GitHubのスター数は2.86万件を超えています。コミュニティ有志によるWebデモの制作から、高速推論フレームワーク「SGLang」への対応まで、そのエコシステムは着実に進化を続けてきました。
そして第2世代となる本作の開発において、最大の焦点となったのが**「さらに長大なドキュメントの連続処理を実現しつつ、計算負荷とVRAM消費を大幅に削減すること」**でした。
この課題を解決するため、Wenxin Unlimited OCR 2は**「スパース参照スライディングウィンドウアテンション(SR-SWA: Sparse-Ref Sliding Window Attention)」**を導入しました。これにより、モデルは関連するページや局所的な視覚情報のみをオンデマンドで高精度に選択・参照できるようになり、無駄な重複計算を排除することに成功しました。
さらに連続デコード機構を組み合わせることで、超長文ドキュメントもスムーズに処理でき、ステップごとのデコード負荷がドキュメントの長さに比例して膨らむことがなくなりました。
Wenxin Unlimited OCR 2は現在、Hugging FaceおよびGitHubにて正式にオープンソース公開されています。
公開リポジトリ:
- GitHub: https://github.com/baidu/Unlimited-OCR
- Hugging Face: https://huggingface.co/baidu/Unlimited-OCR-2
コア技術の解剖:SR-SWAで「計算を減らし」、チャンクデコードで「メモリを抑える」
数百万字・3,600ページを超える『ハリー・ポッター』全巻を一気に読み通す離れ業を、Wenxin Unlimited OCR 2はどのように実現したのでしょうか。
その根本にあるロジックは、人間が本を書き写す(書写・筆写する)際の思考プロセスに着想を得ています。
人間が本を書き写すときは通常、「一段落見ては、一段落書く」という動作を繰り返し、視線は基本的に今書いているそのページに集中しています。前後の文脈を確認する必要が生じたときにだけ、関連する特定のページをめくって見返すはずです。
『論語』を書き写している最中に、全ページのイメージを脳内に一斉に広げて見比べる人など絶対にいません。
しかし、前世代のUnlimited OCRはそのようなアプローチを取っていませんでした。R-SWAによって推論時のKVキャッシュを大幅に削減したものの、過去のページを振り返る際には、入力された全ページの視覚特徴量をアテンション計算に含める必要がありました。
そのため、ドキュメントが長くなるほど計算に含まれる余分な情報が増加し、現在認識している文字とは何の関係もない情報にまで無駄な計算リソースを費やしていたのです。
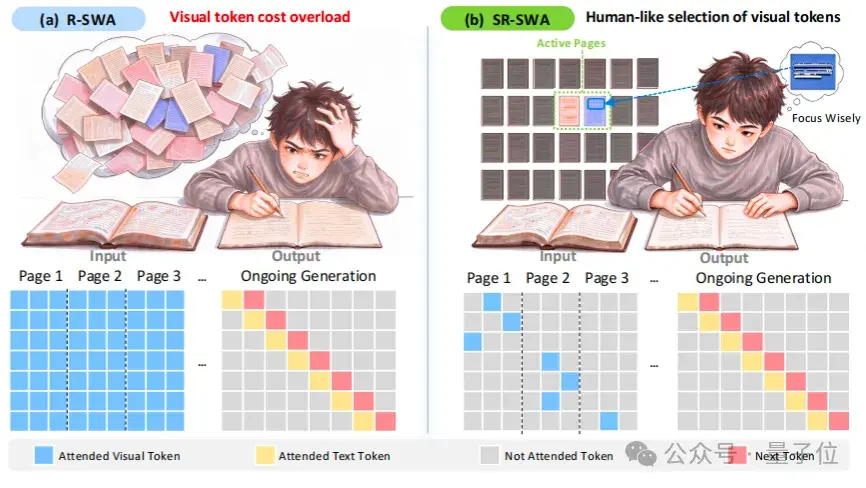
△ 人間の読書・書写時の局所集中アプローチを取り入れたSR-SWA
この課題を克服するため、Wenxin Unlimited OCR 2では**スパース参照スライディングウィンドウアテンション(SR-SWA)**が導入されました。
その核となるのは「2段階のフィルタリング」です。まず参照すべきページを絞り込み、次にそのページ内から真に関連する局所情報だけを抽出することで、無関係な計算を完全にシャットアウトします。
全体アーキテクチャの観点では、Wenxin Unlimited OCR 2は前世代の基本設計を踏襲しています。
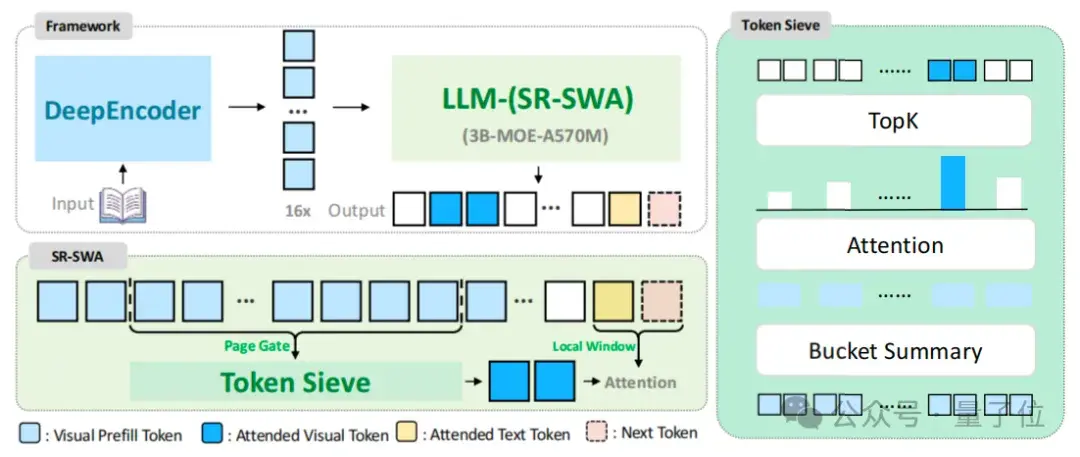
△ Wenxin Unlimited OCR 2の全体アーキテクチャ
入力されたページ画像はまず「DeepEncoder」に送られ、モデルが処理可能な視覚トークン(Visual Token)へとエンコード・変換されます。これは、画像内のテキスト内容やレイアウト情報を記録した「データカード」を生成するようなものです。その後、言語モデルがこれらのカードをもとに、順次テキスト認識結果を生成していきます。
今回の革新的なブレイクスルーは、言語モデルの内部で起きています。従来の**参照スライディングウィンドウアテンション(R-SWA)**が、SR-SWAへと全面的に進化を遂げたのです。
アーキテクチャ図の左下には、SR-SWAの2段階の選定ロジックが示されています。
-
第1層:Page Gate(「どのページを見るべきか」を制御)
現在の解析進捗に基づき、候補となる視覚特徴量を関連性の高いページのみに限定し、無関係なページのノイズを排除します。書写に例えるなら、特定のページを開いたとき、関連する数ページだけを取り出し、本全体をむやみに探し回らないようにする仕組みです。 -
第2層:Token Sieve(「ページ内のどの行を見るべきか」を識別)
ページを絞り込むだけでは不十分です。関連ページ内であっても、すべての視覚トークンを計算に参加させる必要はありません。Token Sieveが2度目の精密な選別を行い、現在の内容に最も合致する視覚情報ブロックを抽出して、長距離の視覚的依存関係を正確に捉えます。
アーキテクチャ図の右側には、このプロセスの詳細が描かれています。モデルはまず各情報ブロックのコンパクトな表現から関連度のスコアを算出し、Top-K戦略によって高スコアのブロックを一定数選び出します。選ばれたブロックに対しては、大まかな要約にとどまらず、微細な視覚的ディテールまで踏み込んで詳細に解析します。
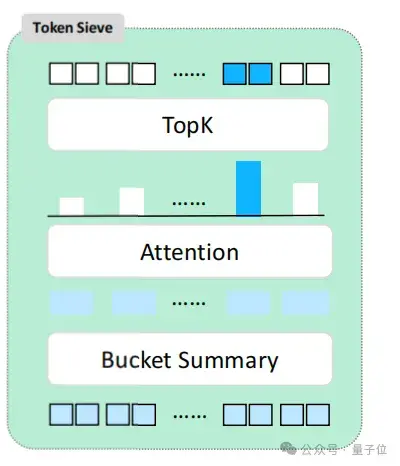
△ Token Sieveの詳細
これら2つの選別機構が連携することで、長大なドキュメントの中からキーとなるページを瞬時に特定できると同時に、各ステップで処理すべき視覚情報量を劇的に削減し、ドキュメント解析の効率を大幅に引き上げることに成功しました。
厳選された視覚情報は、アーキテクチャ図に示されている**Local Window(局所スライディングウィンドウ)**と協調してテキスト生成に活用されます。このウィンドウは固定サイズで常に最新のコンテキスト情報を保持し、生成プロセスに合わせてスムーズにスライドしていくため、出力テキストの自然なつながりを担保します。
情報ブロックの数と局所ウィンドウのサイズがどちらも厳格に制限されているため、モデルが1ステップの推論で参照する情報負荷は常に安定した範囲内に収まります。これにより、「ドキュメントが厚くなるほど、1文字ごとの生成が遅くなる」という従来のボトルネックを根本から解消しました。
SR-SWAが各ステップにおける「計算量の削減」を担うとすれば、VRAM上に「どれだけ保持するか」という問題もまた極めてクリティカルな課題です。
ドキュメントの各ページは、エンコードされると一連の視覚トークンへと変換されます。モデルは解析結果を生成する際にこれらの特徴量を参照する必要があるため、後から再利用できるようにKVキャッシュとしてVRAMに保存します。
もしドキュメント全体を一括で読み込み、全ページのビジュアルキャッシュを常にVRAMに常駐させてしまうと、VRAM使用量はページ数に応じて線形に跳ね上がります。さらに厄介なのは、初期のページが以降の計算で二度と使われなくなったとしても、明示的に解放されない限り領域を占有し続ける点です。これは、本を書き写す際に書き終わった下書きをすべて机の上に積み上げてしまい、どんなに広い机でもいずれ埋もれてしまう状況に似ています。
したがって、計算面での「計算削減」と同時に、ストレージ面での「省メモリ化」が不可欠となります。
Wenxin Unlimited OCR 2では、この課題に対して**「無限デコード機構(Unlimited-Horizon Decoding Paradigm)」**を設計し、チャンクごとのストリーミング処理によってキャッシュ占有量を完全に制御可能にしました。
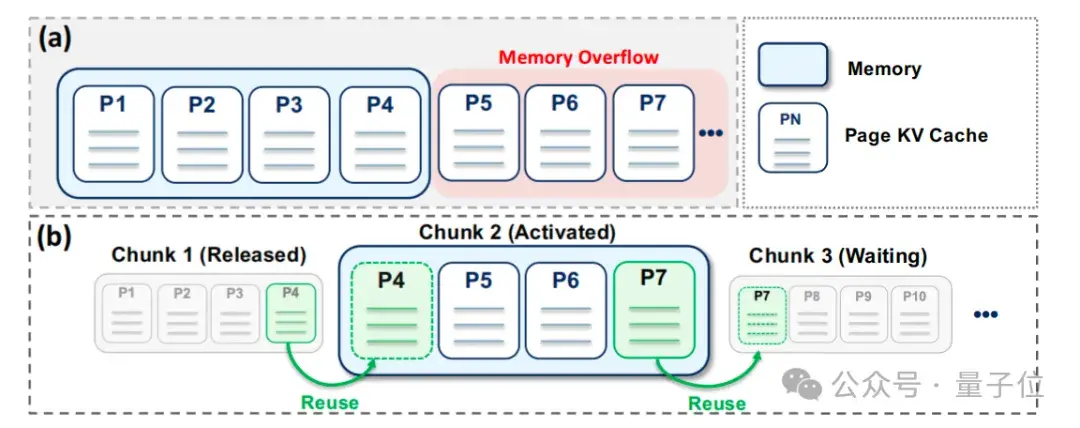
△ チャンクデコードの模式図
この機構では、長大なドキュメントを扱いやすいサイズのページチャンクに分割し、順番に解析していきます。隣り合う2つのチャンクの間には1ページのオーバーラップ(重複領域)が設けられており、前のチャンクの最終ページが次のチャンクの開始ページとなることで、自然な「しおり(ブックマーク)」の役割を果たします。
次のチャンクへ移行する際、モデルはこの重複ページの視覚KVキャッシュをそのまま再利用し、前チャンクの出力末尾のテキストキャッシュを引き継ぐことで、文脈の論理的な連続性を途切れさせません。一方で、過去のチャンクで二度と使われない視覚キャッシュは即座に解放され、VRAMを効率的に明け渡します。
これにより、VRAMに常駐する視覚キャッシュのサイズは、常に単一のチャンク分だけに抑え込まれます。現在のチャンクの処理が終われば、必要な接続情報だけを残して次のチャンクへと引き継がれるため、本全体のキャッシュを最後まで抱え込み続けるという重荷から完全に解放されました。
SR-SWAが1ステップごとの計算コストを大幅に削り、無限デコード機構がVRAMのピーク値を厳格にコントロールする。この2つの技術が組み合わさることで、モデルは膨大な長文ドキュメントの連続解析タスクを見事にこなせるようになったのです。
884ページの『指輪物語』を42分で読了、キャッシュ消費を1.77GBまで圧縮
アーキテクチャの解説はここまでにして、実際のパフォーマンスを見てみましょう。Wenxin Unlimited OCR 2に、全**884ページにおよぶ英語版の原著『ロード・オブ・ザ・リング(指輪物語)』**を入力してみました。
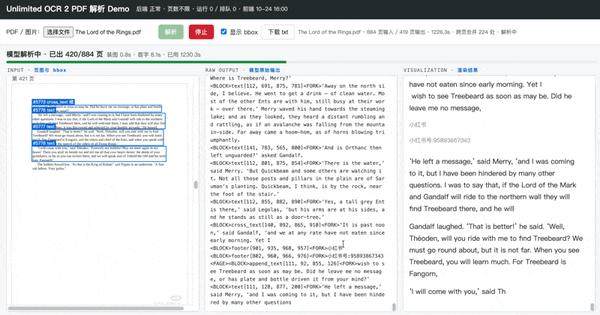
所要時間は約42分56秒。大長編が丸ごと解析完了しました。884ページの入力に対し、正確に884ページ分の出力が得られ、1ページあたりの平均処理時間はわずか約2.9秒でした。コーヒーを1杯飲むか、ドラマを1話見ている間に、「中つ国(ミドルアース)」の壮大な物語がすべてデジタルテキストへと変換されたことになります。
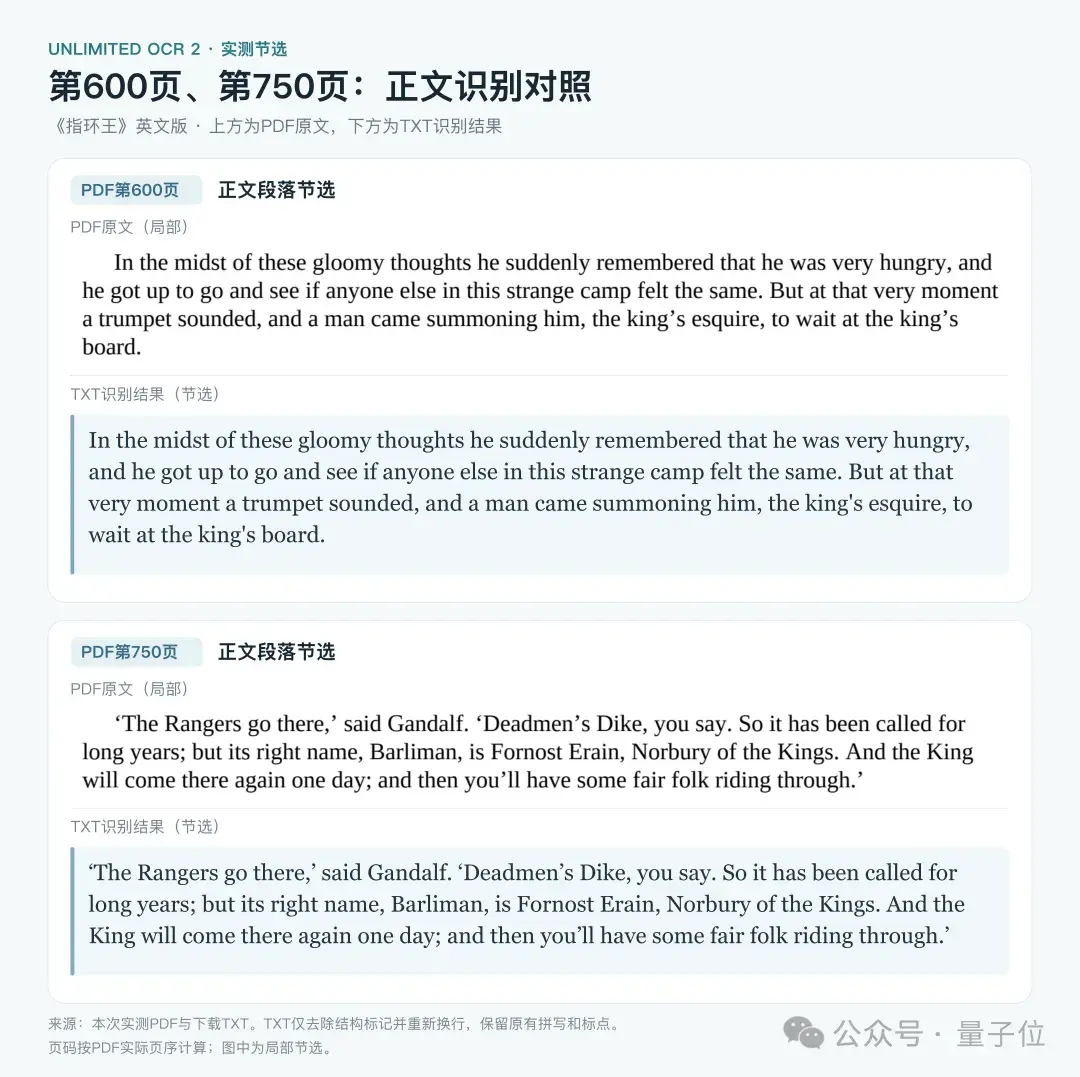
これほどの大規模なテキストを処理する場合、後半に進むにつれて認識精度が低下しないかが懸念されます。
開発チームが無作為抽出によって600ページ目と750ページ目の本文を確認したところ、出力結果は元の画像テキストと完全に一致していました。750ページ目という終盤に至っても一字一句違わぬ正確さを維持しており、超長距離の推論チェーンにおいてもモデルが安定して制御され、ハルシネーション(幻覚)や出力の破綻が生じていないことが証明されました。
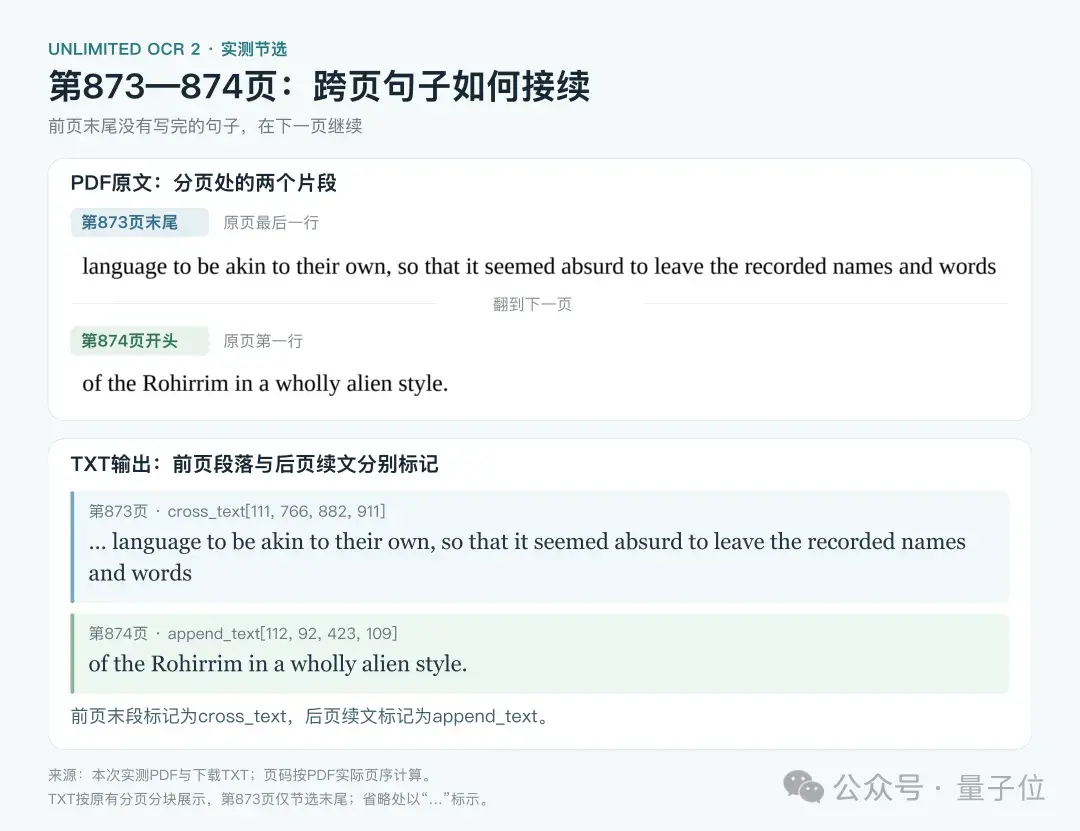
また、今回のテストタスク全体において、システムは**466箇所におよぶ「改ページを跨ぐ文の結合(クロス・ページ・マージ)」**を正確に認識・処理しました。たとえば本の終盤にある873ページと874ページの境目において、物理的なレイアウトの都合で強制的に途切れていた長い文章が、最終的な出力テキストでは綺麗にひとつの文として復元・結合されていました。
実測テストによって書籍全体の連続解析が実用レベルであることが実証されましたが、技術レポートでは解析効率、キャッシュ管理、認識精度の主要指標がさらに定量化されています。
100ページ規模の評価ベンチマーク「MarathonDocBench」において、チームは従来の標準フルデコードと「Unlimited-Horizon Decoding」の実測性能を比較しました。単一シーケンス推論テストにおいて、チャンク処理と境界キャッシュの再利用を導入した結果、ピーク時のKVキャッシュ消費量は47GBから1.77GBへと急減し、約96%の削減を達成しました(※1.77GBはKVキャッシュのみの計測値であり、モデルの重み等による固定VRAMは別途必要です)。
単一ストリームの最適化だけでなく、マルチタスク並行処理のパフォーマンスも目を見張るものがあります。16並列のコンカレントテストにおいて、新アーキテクチャ採用後のシステムのエンドツーエンドスループットは360 Token/sから1,315 Token/sへと跳ね上がり、標準デコードモードの3.65倍に達しました。
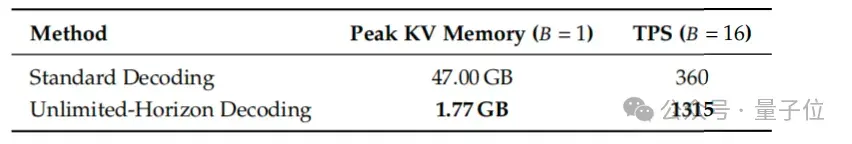
△ デコード方式の比較:単一シーケンスのピークKVキャッシュと16並列スループット
この結果は、企業の財務諸表やエンジニアリングマニュアルなどを大量にバッチ処理する必要があるエンタープライズ用途において極めて大きな価値を持ちます。VRAMの敷居が下がることで、同じスペックのハードウェアでより多くの並列処理をさばけるようになり、単位時間あたりの処理能力が数倍に向上します。
エンドユーザーにとっても、使い勝手は大幅にシンプルになります。数百ページあるドキュメントをそのままアップロードするだけで、チャンクの分割やページ間のシームレスな結合はすべてモデルの低レイヤーが自律的にスケジューリングしてくれます。面倒な手動でのPDF分割や、後処理でのテキスト連結作業はもう不要です。
圧倒的な処理速度とメモリ効率の最適化を追求する一方で、認識のクオリティも極めて高い水準を維持しています。
複数ページの複雑なドキュメント解析能力を測る「MPDocBench」評価において、Wenxin Unlimited OCR 2は総合スコア84.59を獲得しました。
また、100ページ規模の超長文ドキュメントを評価するため、開発チームは新たに過酷なベンチマーク**「MarathonDocBench」**を策定しました。このテストセットには、103〜300ページにおよぶ長文ドキュメントが100件収録されており、複数ページをまたぐ複雑な段落や巨大な表(テーブル)が大量に含まれているため、長い文脈における論理の一貫性を保つモデルの能力が極限まで試されます。
この高難度のベンチマークテストにおいても、Wenxin Unlimited OCR 2は総合スコア77.06を記録しました。いずれの権威あるベンチマークにおいても、レポート内で比較対象となったモデルの中でトップの座を獲得しています。
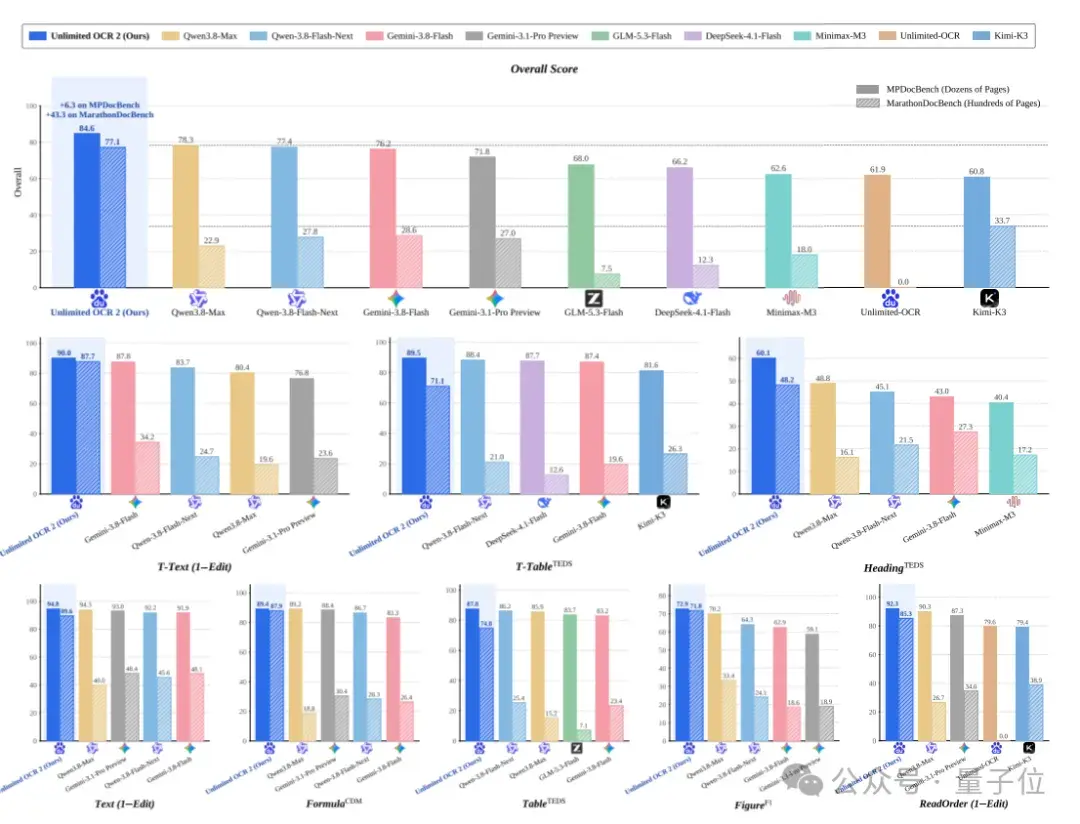
△ 技術レポートより:複数ページドキュメント解析の評価結果
デコード速度の観点では、SR-SWAの1ステップあたりのデコード速度は、フルアテンション(Full Attention)の7.0倍、前世代のR-SWAの5.6倍に達しています。
性能カーブを見れば一目瞭然です。従来の手法ではドキュメントが長くなるにつれてステップごとのデコード遅延が目に見えて増大していきますが、SR-SWAのレイテンシ曲線はほぼフラットな水平線を維持しています。
これは、本がどれほど厚くなろうとも、モデルが1トークンを出力するのにかかる時間がほぼ一定であることを意味します。「どれほど長大になっても、処理が重くならない」という理想を現実のものにしました。
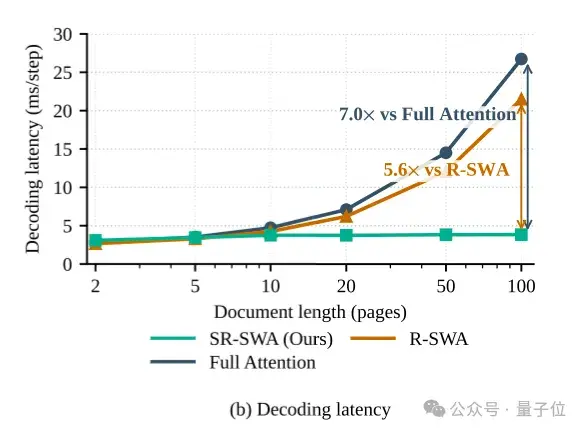
△ ドキュメントの長さによる1ステップデコード遅延の推移
前世代モデルと比較して、Wenxin Unlimited OCR 2は一般的な単一ページの解析精度でも高い水準を維持していますが、真の圧倒的な実力差(次元の違い)を見せつけるのは、ドキュメントのページ数が長大になったときです。連続処理可能なページ数は文字通り桁違いに跳ね上がり、改ページをまたぐ論理認識の精度はさらに研ぎ澄まされ、超長文推論におけるトータルコストは数分の一に圧縮されました。
数百ページにおよぶ企業の年次監査報告書でも、専門的で分厚い産業規格マニュアルでも、長大なスキャン資料でも、ユーザーは事前のファイル分割や事後の整合性チェックに煩わされることなく、モデルに丸ごと任せることができます。
OCR 3.0時代の到来
1枚のレシートや紙の伝票を読み取っていた黎明期から、1冊の本を丸ごと連続して読み通す現在に至るまで、ドキュメント解析の技術パラダイムは根本的な再構築の真っ只中にあります。
技術レポートの中で、チームはOCRの進化プロセスを**「OCR 1.0」「2.0」「3.0」**の3つの時代に定義づけています。
- OCR 1.0時代:モジュール型のパイプライン構造を採用し、文字検出、文字認識、レイアウト解析、レイアウト復元といった工程を順を追って実行するアプローチ。各機能が独立している一方、処理ステップを経るごとに誤差が増幅しやすいという欠点がありました。
- OCR 2.0時代:マルチモーダルな視覚言語モデル(VLM)が登場し、エンドツーエンドの構造によって入力画像を直接解析することで、従来のようなモジュール間の情報損失を克服しました。初代Unlimited OCRはこの時代の代表例であり、解析可能な規模を数十ページ単位へと拡張しました。
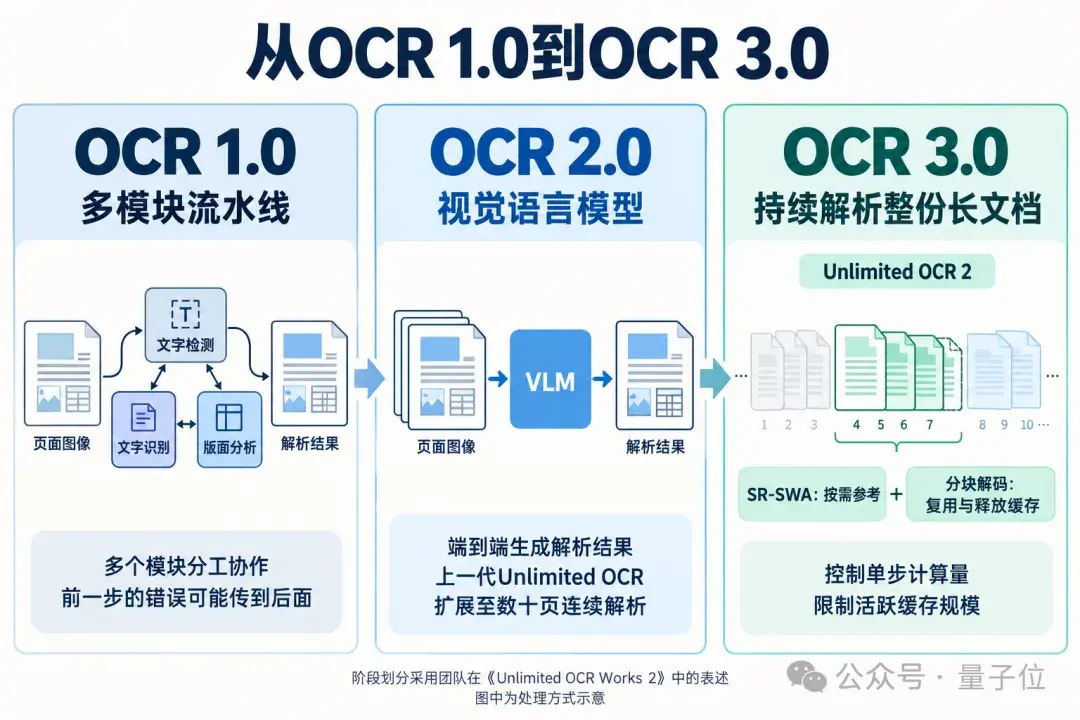
△ AI生成イメージ
- OCR 3.0時代:数百〜数千ページにおよぶ超長大ドキュメントの解析へとステージが移行し、改ページを越えた文脈の高度な一貫性を保ちながら、長さによる計算量の爆発とVRAMの枯渇という技術的障壁を打破することが求められる時代です。
Wenxin Unlimited OCR 2は、「オンデマンド局所アテンション(SR-SWA)」と「無限デコード機構」によって、ページ数が増えても計算量が膨張せず、分量が増えてもVRAMが圧迫されない環境を実現しました。
開発チームはこれを、**「ページ分割不要、上限なし、1冊まるごとの連続解析を新たな標準とする『OCR 3.0』」**と正式に定義しています。
興味深いことに、この技術プロジェクトの命名には、サブカルチャーへのオマージュという一面も込められています。
「Unlimited OCR Works」というネーミングは、人気作品『Fate/stay night』に登場する「無限の剣製(Unlimited Blade Works)」へのリスペクトから名付けられたものです。
△ 『Fate/stay night』アニメ公式サイト
原作の設定において「無限の剣製」とは、無数の剣が広がる心象風景を具現化する固有結界です。前世代モデルのリリース後、Hugging FaceコミュニティのエンジニアであるSnarcy氏がこれに触発され、ギークなロマンに満ちた「OCR版」の詠唱フレーズを創作しました。
そして今回のWenxin Unlimited OCR 2の技術レポートにおいて、開発チームはこのコミュニティ発のオマージュを公式にイントロダクションへと収録し、クレジットを明記して謝意を表しました。
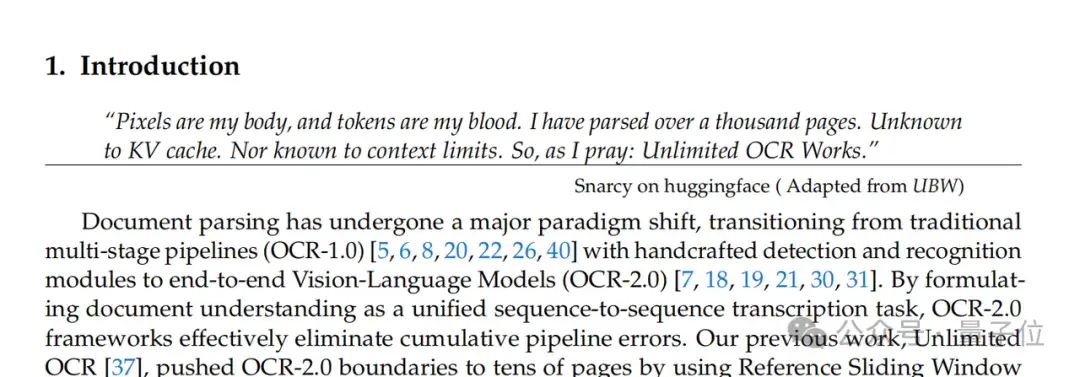
最先端のアテンション機構とVRAMフットプリントを論じる技術レポートの扉絵に、読者はこのような重厚でロマンにあふれた宣言を目にすることになります。
Pixels are my body, and tokens are my blood.
(体はピクセルで出来ている。血潮はトークンで。)