
QRコードをスキャンして量子位をフォロー
< img id=“wx_img” src=“https://www.qbitai.com/wp-content/uploads/imgs/qbitai-logo-1.png” width=“400” height=“400”>

1枚のGPUで、512並列の長文推論を同時実行
允中 凹非寺より
量子位 | 公式アカウント QbitAI
Googleが今年発表した1本の論文が、メモリチップ大手の株価を揺るがす事態となりました。
その論文では、KV Cacheを少なくとも6分の1に圧縮できると述べられていました。
ご存知のように、大規模言語モデルの推論はメモリ消費が激しくなる一方であり、KV Cacheはその中でも決して小さくないオーバーヘッドとなっています。
Googleが突如として大幅な圧縮を実現したことで、Micronをはじめとするメモリチップ大手の株価が下落しました。
ところがそれからわずか数ヶ月、KV Cacheに対してさらに大胆なメスを入れる者が現れました。
今回は圧縮にとどまりません。
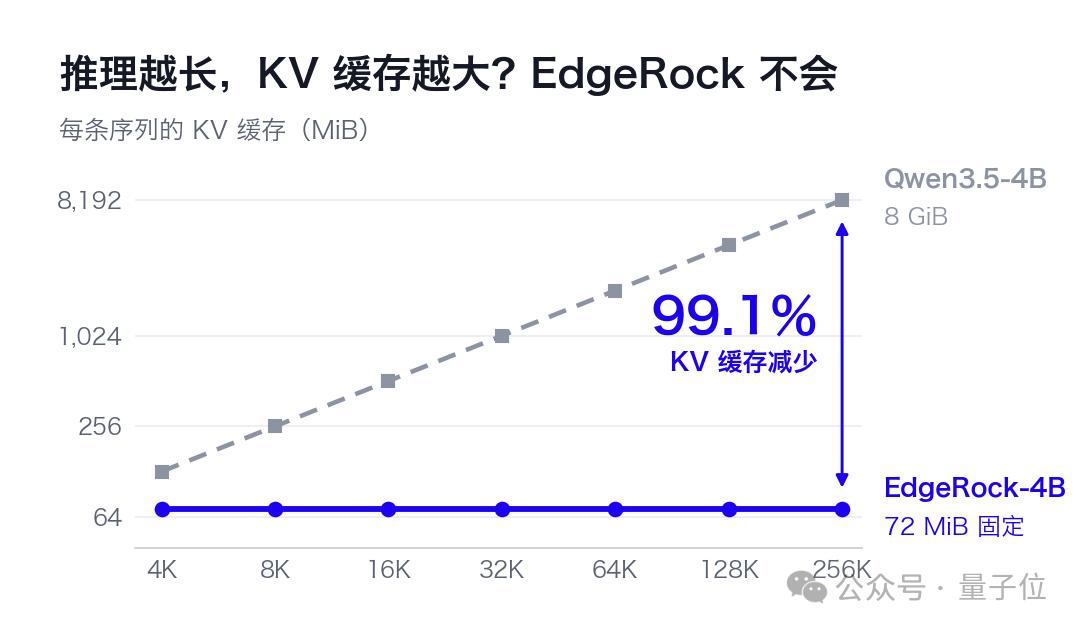
コンテキスト長が4Kから256Kまで跳ね上がっても、KV Cacheのメモリ占有量がまったく変わらないのです。
256Kコンテキスト下でも、常に72MiBに固定。ベースモデルと比較して、KV Cacheは一挙に99.1%削減されました。
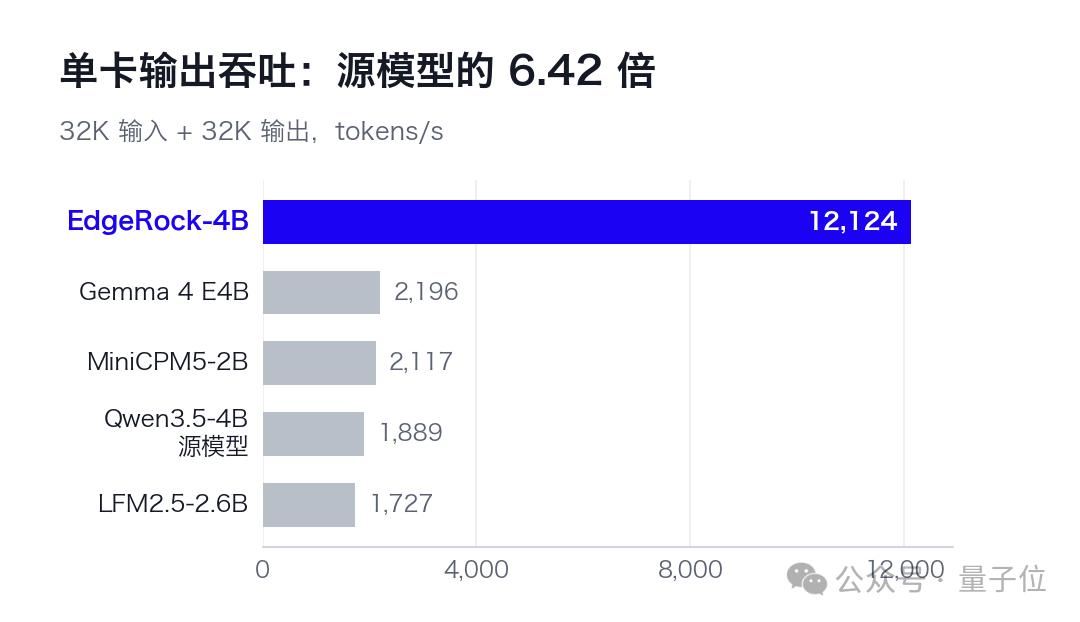
さらに驚くべきことに、わずか1枚の80GB GPUで512並列の長文推論を同時実行し、出力スループットはベースモデルの6.42倍となる12,124 tokens/sに達しています。
その上、推論能力もほぼ維持されており、AIME 2024–2026の平均pass@1率は82.9%を達成。一方、評価対象となった有界状態モデルは14B規模であっても、最高で18.8%にとどまっていました。
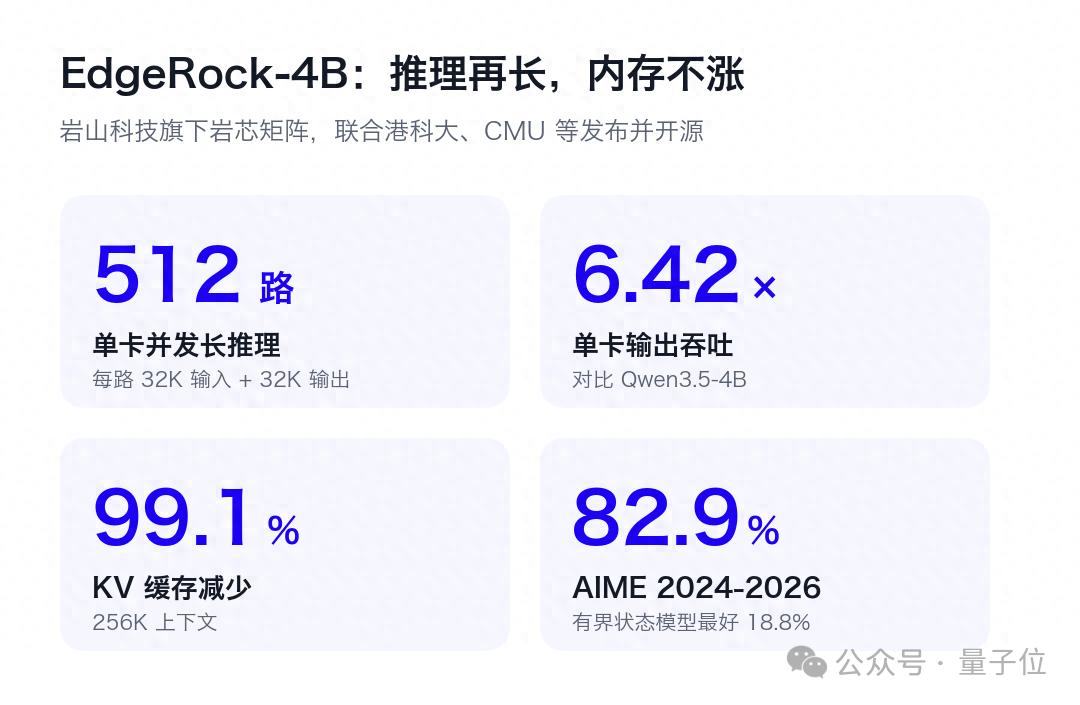
これを実現したのが、岩山科技(Rockchip/Rocksun)傘下のRockMatrix(岩芯矩阵)が、香港科技大学(HKUST)やカーネギーメロン大学(CMU)などの大学と共同で発表・オープンソース化したEdgeRock-4Bです。
同モデルが長文推論にもたらした最大の変革は:
どれほど推論が長くなっても、メモリが増加しない。
モデルの重みと推論コードは現在すべてオープンソース化されており、テキストおよび画像推論の両方をサポートしています。
推論が長くなるほど、なぜコストが高くなるのか?
近年のモデルは、平気で数万トークンもの「思考」を行うようになり、Agentに至っては数十ターン連続で動作し、検索結果、コード、ツールの呼び出し履歴をコンテキストへと次々に詰め込みます。
モデルが精力的に動けば動くほど、先に悲鳴を上げるのがVRAMです。
その元凶こそが、KV Cacheにあります。
現在の大半のモデルは、推論履歴をKV Cacheに保存し、トークンを1つ生成するたびにキャッシュを追加していきます。
例えばQwen3.5-4Bの場合、1トークン生成するごとに32 KiBのKV Cacheが追加されます。推論が64Kに達すると、1シーケンスだけで2 GiB、256Kに達すれば8 GiBにも膨らみます。
これは推論モデル時代において特に致命的です。
モデルはますます「深い思考」を好むようになり、平然と数万トークンを出力します。Agentがひとたび動けば数十回のツール呼び出しが発生し、コンテキストは雪だるま式に長くなっていきます。
推論が長くなるほどVRAMを消費し、1枚のGPUで同時に処理できるリクエスト数は少なくなってしまいます。
さらにエッジデバイスでは、KV Cacheは限られたメモリを認識モジュールや制御モジュールと奪い合わなければなりません。
これに対する業界のアプローチは、大まかに2つに分かれます。
1つは、各トークンを「軽量化」する方法です:
マルチヘッド潜在アテンション(MLA)によるKVの圧縮や、KIVIなどの量子化手法による精度の削減、GoogleのTurboQuantもこの系統に属します。
しかし、これらは単一トークンあたりのコストを下げただけであり、推論が進むにつれてキャッシュが増加し続ける構造は変わりません。
もう1つは、有界状態モデル(Bounded-State Models)です:
リカレントモデル、状態空間モデル(SSM)、スライディングウィンドウモデルなどは、本質的にメモリ使用量が固定されています。
しかし問題は、その後の推論に必要な遠くの文脈の詳細を保持できず、結果として推論能力が大幅に低下してしまう点です。
したがって、真の難問は次の点に集約されます:
固定されたメモリサイズの中で、推論に必要な重要ディテールを保持し続けられるのか?
EdgeRockが出した答えは、**「可能である」**でした。
1枚のGPUで、512並列の長文推論を同時実行
まずは、最も分かりやすいスループットから見てみましょう。
テスト環境は入力32K、出力32Kに設定し、すべてのモデルを単一のHopper 80GB GPU上で実行、それぞれ実測で最速となるバッチサイズを採用しました。
その結果、EdgeRock-4Bは一気に512並列まで展開し、出力スループットは12,124 tokens/sに達しました。
ベースモデルであるQwen3.5-4Bの最速構成はバッチサイズ64で、わずか1,889 tokens/sでした。Gemma 4 E4B、MiniCPM5-2B、LFM2.5-2.6Bも軒並み1,700〜2,200 tokens/sの間に留まっています。
なぜこれほど大きな差がついたのでしょうか?計算してみれば明白です。
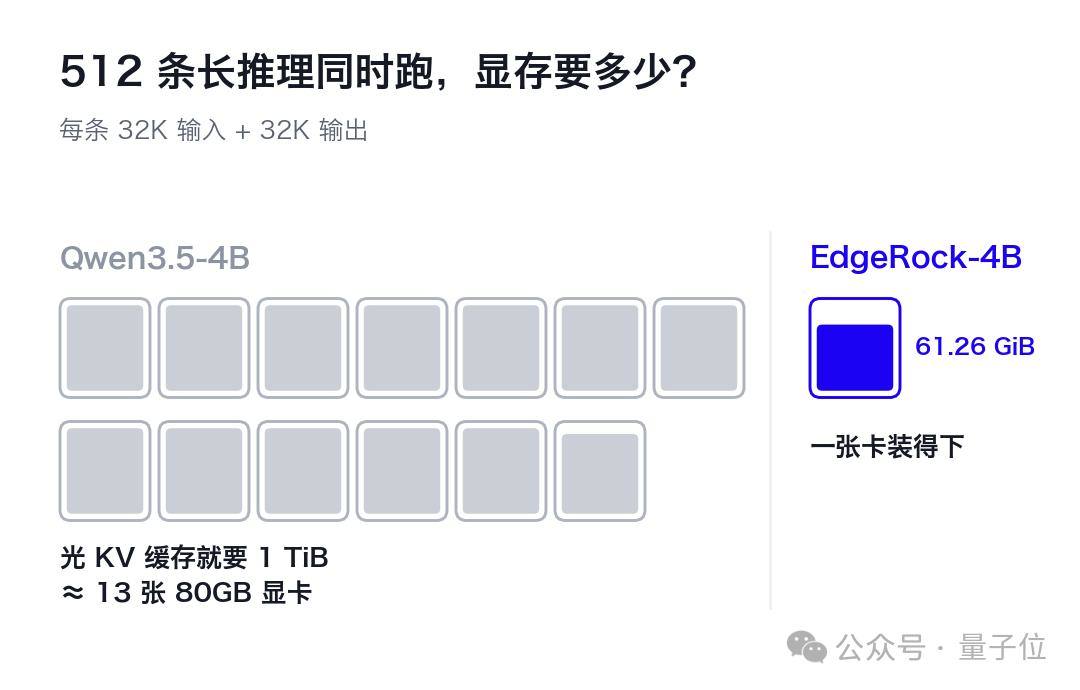
入力32K+出力32Kの実行完了時、Qwen3.5-4Bの1シーケンスあたりのKV Cacheは2 GiBになります。
80GBのGPU 1枚では数十本並列させただけでメモリが一杯になり、それ以上のリクエストはキューで待たされることになります。
対してEdgeRock-4Bをバッチ実行する場合、各シーケンスで保持すべき全履歴状態は97.76 MiBで固定されており、コンテキスト長によって変動しません。
例えるなら、もしQwen3.5-4Bで同じ512本のシーケンスを同時に走らせた場合、生成終了時のKV Cacheだけで1 TiB、およそ80GB GPU 13枚分のVRAMが必要になります。
EdgeRockならGPU 1枚に収まり、モデルの重みを含めてもピークVRAMは61.26 GiBに過ぎません。
続いてスケーラビリティです。
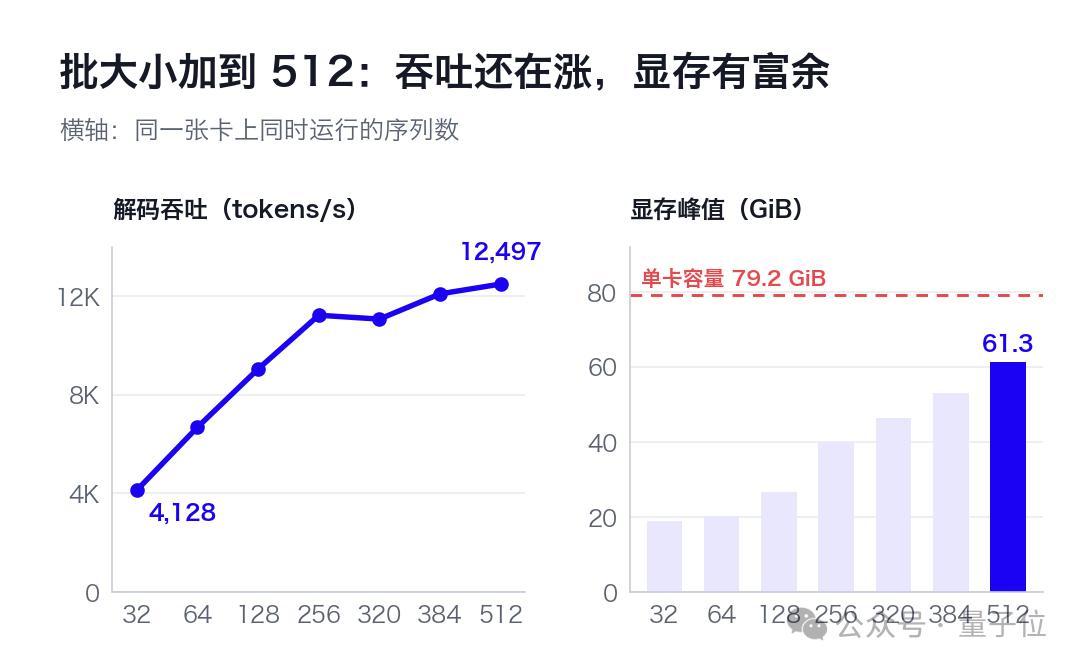
4Kから32Kの入力・出力を組み合わせた16種類のワークロードにおいて、バッチサイズを32から512まで引き上げると、加重デコードスループットは4,128から12,497 tokens/sへと向上し、VRAMのピーク値は一度もGPU単体の容量上限に達することはありませんでした。
単一リクエストの速度も極めて高速です。
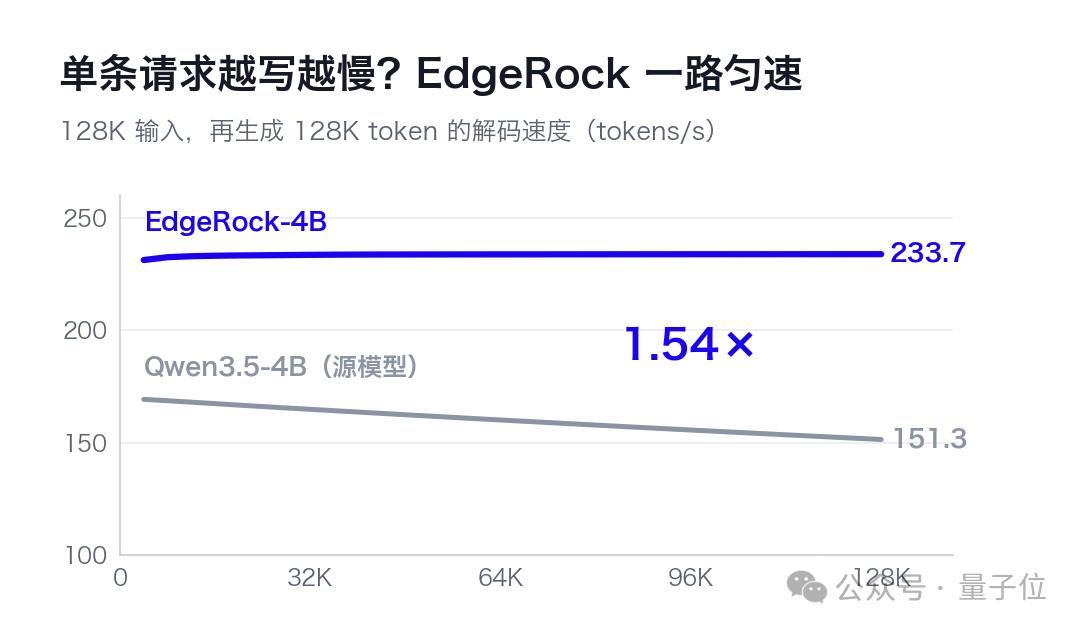
KV Cacheが推論に伴って増加するモデルには共通の弱点があります。「書けば書くほど遅くなる」という点です。
新しいトークンを1つ生成するたびに、蓄積され続ける膨大なKV Cacheをすべて見直さなければならないためです。
EdgeRockでは、トークンごとの計算量がコンテキスト長に応じて増加することはありません。
128Kの入力後にさらに128Kトークンを生成する場合でも、生成速度は最初から最後まで233.7 tokens/sを維持し続けました。
一方、Qwen3.5-4Bは169前後から151.3 tokens/sまで落ち込みました。
コンテキストが長くなるほど、コストは劇的に下がる
スループットが数倍になるということは、見方を変えればコストが数分の一に下がることを意味します。
同じGPU、同じ負荷で、同じ量のトークンを生成した場合:
- 4K入力時、EdgeRockが必要とするGPU時間はQwen3.5-4Bのわずか24.9%
- 32K入力時では、わずか15.6%
GPUの利用時間で課金される場合、トークンごとの計算コストもこの比率に比例して削減されます。
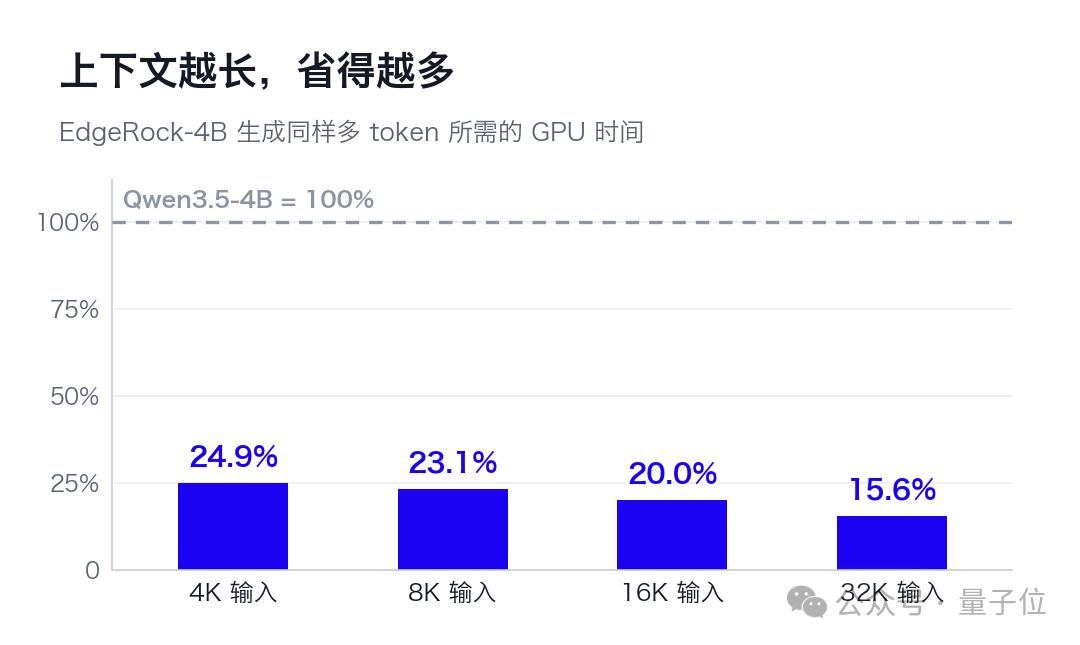
4種類の入力長の平均で見ると、EdgeRockのスループットはQwen3.5-4Bの4.94倍、LFM2.5-2.6Bの7.18倍に達します。
さらに重要なのはその傾向です。コンテキストが長くなればなるほど、その差は大きく開いていきます。
Qwen3.5-4BのKV Cacheは長さとともに指数関数的に増大しますが、EdgeRockは一切増加しません。
「コスト削減」に加え、メモリ固定化には見過ごされがちながら重要な利点があります。それが「確定性」です。
各リクエストがどれだけのメモリを必要とするかが、推論開始前に正確に計算できます。
- 推論サービスは、各リクエストが最終的にどれだけの長さになるかを予測せずとも、リクエスト数に基づいてキャパシティプランニングを行える
- エッジデバイスは一度割り当てを行うだけで済み、どれだけ推論が長くなってもメモリ不足(OOM)で落ちることがない
- AI Agentの履歴メモリが、ツール呼び出し回数に応じて増加し続けることがなくなる
- 専用チップ(ASIC)であれば、全履歴状態をオンチップメモリに収めることも可能になる
メモリがますます高価で貴重になっている現代において、このメリットは計り知れません。
メモリを削っても、知能は劣化しない
ここまで読んだ専門家の方なら、こう疑問に思うかもしれません。「固定メモリなんてRNNやMambaがとっくに実現している。何がそんなに珍しいのか?」と。
画期的なのは、メモリを大幅に削減しながらも、推論能力が全く落ちていない点です。
研究チームはEdgeRock-4Bと、GDN、RWKV、Mambaなどのアプローチを含む16の有界状態モデル(うち3つは14Bクラス)を比較しました。
AIME 2024–2026において、EdgeRock-4Bの平均pass@1率は82.9%に達しました。対照群で最強だったRWKV-7 G1j 13.3Bは18.8%、AHN-GDN Qwen2.5 14Bは11.4%にとどまりました。
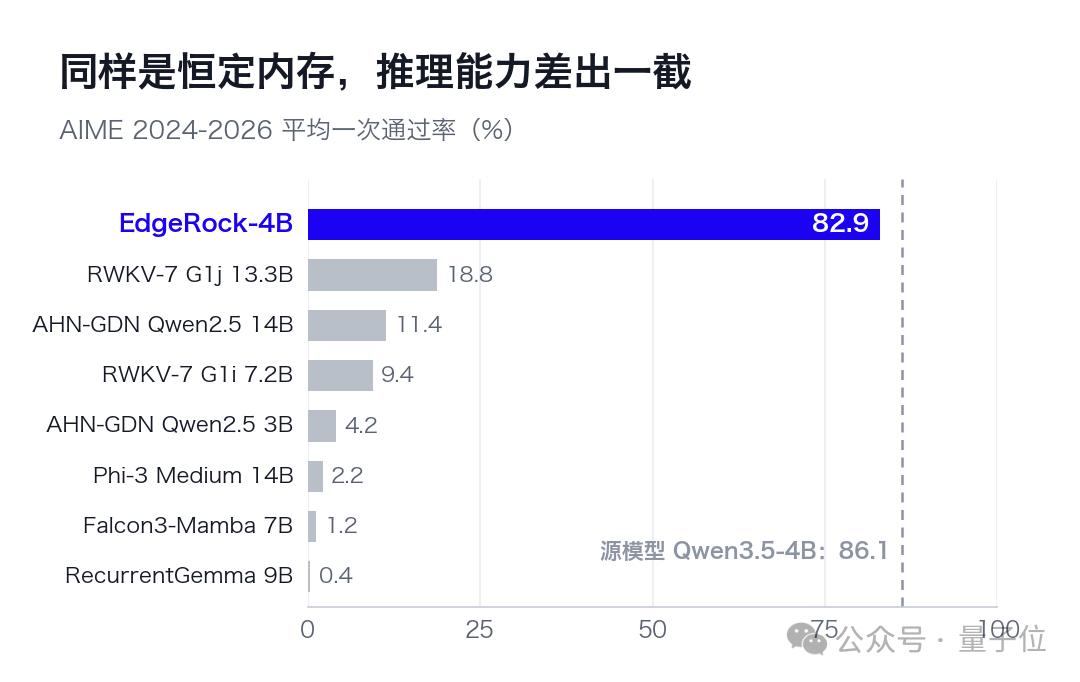
29のテキストベンチマーク中、EdgeRock-4Bは24項目で有界状態モデルのトップを獲得しました。29項目の等加重平均では、同指標で最強のベースラインであるAHN-GDN Qwen2.5 14Bを23.8ポイント上回りました。
ベースモデルと比較しても、その性能はしっかりと維持されています:
- AIMEの平均pass@1率はQwen3.5-4Bの96.3%を維持、MATH-500では97.5%に到達
- 29のテキストベンチマーク中、MMLU-Pro、SuperGPQA、HumanEval、MBPPを含む8項目でQwen3.5-4Bを逆転
- 6つのビジョンベンチマークにおける平均スコアは84.9%で、Qwen3.5-4Bの95.3%の性能を保持
この結果は、推論に応じてメモリが増加する一般的な最先端小型モデルと同等の水準です。
秘訣:記憶に打ち込む「ロックアンカー」
では、EdgeRockはどのようにしてこれを実現したのでしょうか?
その核心は、新しく考案されたメモリ機構「ロック・メモリ・アンカー(Rock Memory Anchors、RMA)」にあります。
その設計はロッククライミングの「岩錨(ロックアンカー)」から着想を得ており、推論に必要な重要情報をしっかりと固定します。
クライマーが岩壁にアンカーを打ち込むことで次のステップへの確実な支点を確保するように、RMAは推論過程で真に重要な詳細を固定容量の「アンカーバンク」に固定し、必要な際に直接読み出します。
具体的には、EdgeRockは各シーケンスの履歴を3つの部分に分けて保持し、それぞれが異なる役割を担います:
- リカレント状態:絶えず変化するコンテキストの概要を把握し、大まかな文脈を保持
- ローカルウィンドウ:直近の1024トークンをカバーし、目の前の情報を管理
- アンカーバンク:それ以前の履歴から最も価値の高い詳細を保持し、重要なポイントを記憶
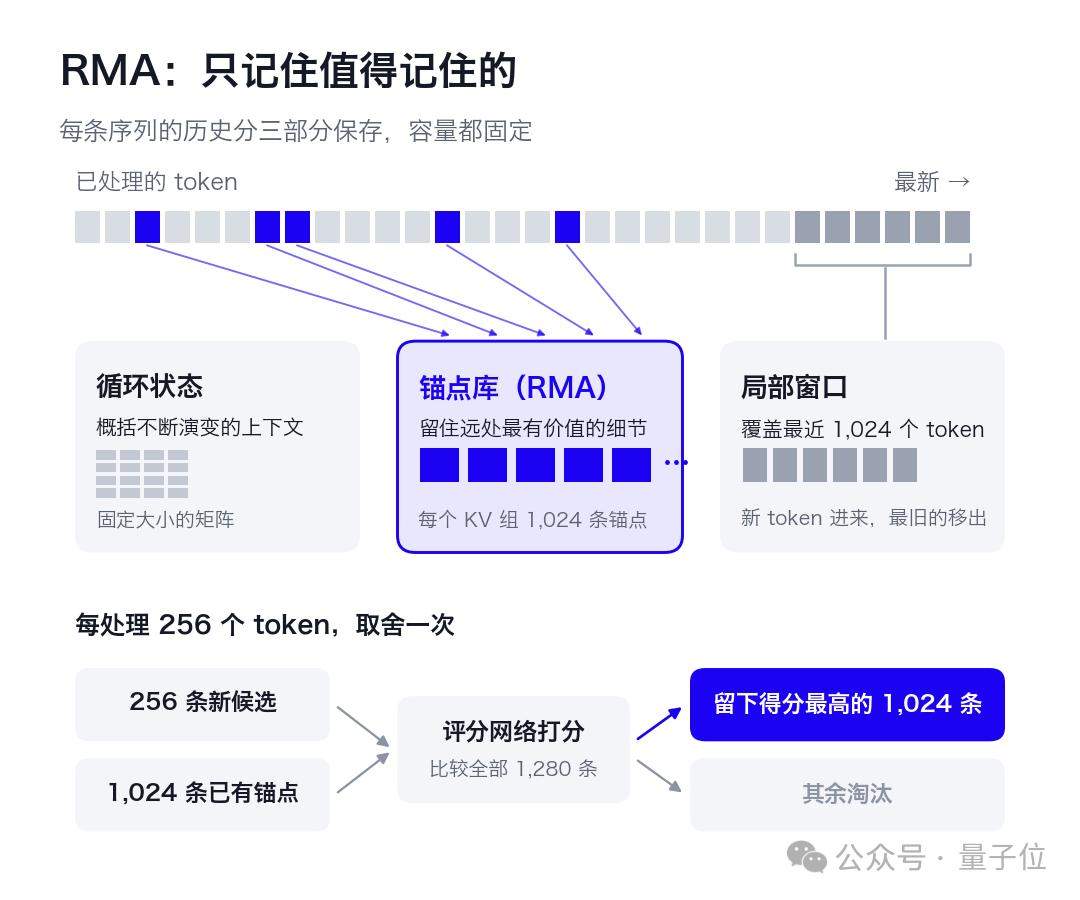
アンカーを選別するプロセスは以下の通りです:
ライター(Writer)が各トークンに対して候補レコードを生成し、スコアリングネットワークがそれを採点します。
候補が256件蓄積されるたびに、アンカーバンク内の既存レコードと比較され、スコア上位1024件のみが残り、それ以外は破棄されます。
4つのKVグループがそれぞれ独立してこの処理を行います。
保持されたアンカーは互いに独立しており、内容は不変です。そのため、そのアンカーの発生源がローカルウィンドウから疾うに外れていても、後続の推論において直接参照することが可能です。
平たく言えば、モデルが学習したのは「すべてを記憶すること」ではなく、「記憶する価値のあるものだけを記憶すること」です。
ローカルウィンドウとアンカーバンクの組み合わせにより、各シーケンスのアテンションKVは72 MiBに固定されます。これが、メモリが増加しない理由です。
アーキテクチャ面では、EdgeRock-4BはQwen3.5-4Bをベースに改造されています。24層のGated DeltaNet層を維持しつつ、8層のフルアテンション層を1024ウィンドウのスライディングウィンドウアテンションに置き換え、さらに独立したRMAモジュールを追加しています。
モデル全体はQwen3.5-4Bから段階的な変換によって構築されており、ゼロから事前学習を行う必要はありません。
では、アンカーは本当に機能しているのでしょうか?
研究チームは検証実験を行いました。推論時に8つのRMAモジュールをすべて無効化し、リカレント層とローカルアテンションのみを通常通り動作させたのです。
16Kから130Kトークンの長文コンテキスト256件に対し、情報検索、状態更新、複数ドキュメント間の情報統合、変数バインディングを網羅する質問をそれぞれ4問出題しました:
- RMAを有効にした場合、1024問中964問に正解し、正解率は94.1%
- RMAを無効にした場合、わずか4問しか正解できず、正解率は0.4%
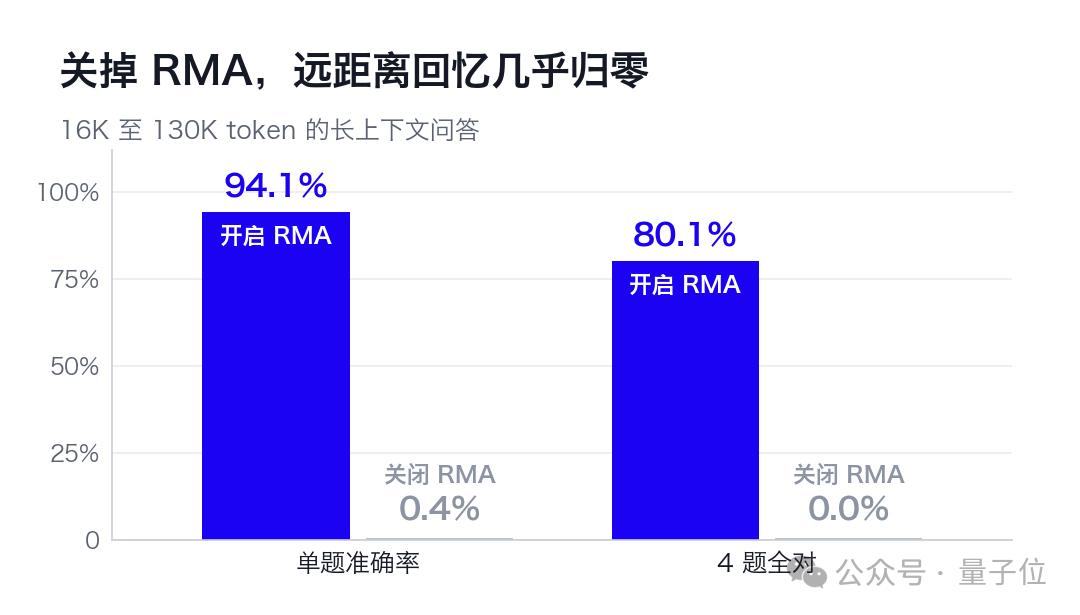
長距離のリコール能力はほぼゼロに落ち込みました。これは、EdgeRockが間違いなくアンカーによって遠くの情報を取得し、回答を導き出していることを証明しています。
さらに、各アンカーには元の位置情報が記録されているため、モデルが何を選択して記憶したのかを直接確認することも可能です。
メモリはさらに不要になるのか?
EdgeRockは、岩山科技傘下のRockMatrix(岩芯矩阵)が、香港科技大学やカーネギーメロン大学などの大学と共同で開発しました。現在、モデルはオープンソース化されており、商用利用も可能です。
開発チームによると、さらに異なるパラメータ規模のEdgeRockも準備中とのことです。
長時間動作が求められるロボットにとっても、この仕組みは非常に大きな可能性を秘めています。
ロボットが環境を認識しながら動作計画を立て、タスクを数時間あるいはそれ以上実行し続ける場合、履歴キャッシュを無限に膨らませ続けるわけにはいきません。
推論プロセスにおけるメモリ消費量を事前に正確に把握できれば、エッジへのデプロイも格段に容易になります。
メモリ需要が今後どう変化するかは市場の判断に委ねるとしても、少なくとも一つの確固たる事実が生まれました。モデルがどれほど長く思考しようとも、記憶がこれ以上膨張することはなくなったのです。
論文URL:
https://rockmatrix.ai/documents/edgerock-report-zh.pdf
GitHub:
https://github.com/rockmatrix-ai/EdgeRock
Hugging Face:
https://huggingface.co/rockmatrix-ai/EdgeRock
著作権所有。無断転載・利用を禁じます。違反時は法的責任を追及します。
](https://www.qbitai.com/2026/10/505407.html#)
- WorkBuddyがWeCom(企業微信)に導入!もうファイル転送アシスタントを自分でやる必要はありません……2026-10-26
- OpenAIとGeminiの双方が選んだリアルタイム音声対話、なぜこの中国企業だったのか?2026-10-26
- 10億トークンを無料進呈!国産コンピュートモデルSpark-X2.6実測、コードのみで3D故宮をレンダリング2026-10-26
- テック企業の海外進出、なぜドバイをおすすめするのか?2026-10-17
QRコードをスキャンしてモーメンツにシェア
人気記事
GoogleがRSIの最新成果をオープンソース化!中国系研究者が大活躍 2026-10-19
人工知能の最新トレンドを追い、テクノロジー業界の新たなブレイクスルーを報じる
量子位 QbitAI 版権所有©北京極客夥伴科技有限公司 京ICP備17005886号-1