
AIによる画像生成能力はますます向上していますが、一方で人々は長らく「AIっぽさ」に頭を悩ませてきたようです。
過剰なまでに整った陰影、不自然につるりとした肌、どこかで見たような構図……多くのAI生成画像は美しいものの、一目でそれと分かってしまう違和感を拭えずにいました。
そんな中、中国発のオープンソース画像生成モデルが、その極めて自然な質感によって海外のAIコミュニティで大きな話題を呼んでいます。
ComfyUIコミュニティの著名開発者であるOstris氏は、興味深い推測を述べています。現在、ますます多くのモデルがAI生成画像を学習データに取り入れるようになっており、その結果としてアウトプットのスタイルが似通った「ChatGPTっぽさ」を帯びるようになってきています。それに対し、このモデルは学習データからAI生成画像を徹底的に排除しており、それこそが独自の自然な視覚表現を生み出している理由ではないか、というのです。
そのモデルこそ、**模思智能(MOSI)とOpenMOSSチームがオープンソースとして公開した「MOSS-Image」**です。
リリースからわずか4日で、MOSS-ImageはHugging FaceのComfy-Orgリポジトリをはじめとする海外コミュニティにおいて、累計ダウンロード数130万回を突破しました。
さらにGitHubでは1.4k Starsを獲得し、Hugging FaceのText-to-Image(文生図)トレンドランキングで首位を獲得。同時に全カテゴリのモデルトレンドでも上位にランクインしました。
さらに盛り上がりを見せているのが開発者コミュニティです。
モデルが公開されるやいなや、開発者やクリエイターたちの手によって様々な派生版が次々と登場しました。8ステップや4ステップの高速化モデル、INT8量子化やGGUF版、実写やアニメ風の多彩なLoRA、そして新しいComfyUIワークフローが続々と生み出されています。
X(旧Twitter)やRedditなどのプラットフォームでは、多くの開発者がFLUX.3-klein、Krea2、Qwen Image 2.1といったモデルと横並びで比較し、画風や人物のディテール、テキストレンダリング、複雑な構図などのパフォーマンスを検証しています。
では、この5BパラメータのDiTバックボーンをベースにした国産画像生成モデルは、なぜわずか数日でこれほど多くの海外開発者を惹きつけることができたのでしょうか?
海外開発者の間で話題沸騰、FLUX.3-kleinやKrea2との比較検証も
MOSS-Imageがオープンソース化されると、海外コミュニティは極めて迅速に反応しました。前述した自然な質感に加え、開発者たちは多角的な視点からこのモデルの生成能力をテストし始めています。
定番の「AI画風」を真に脱却できているかに注目する人もいれば、より複雑なプロンプトを用いて人物のポーズ、ディテール、スタイルの整合性をテストする人もいます。
アニメ調からイラスト、そしてフォトリアリスティックな実写まで、コミュニティの開発者が公開した作品からは、MOSS-Imageの豊かな表現力が存分に示されています。
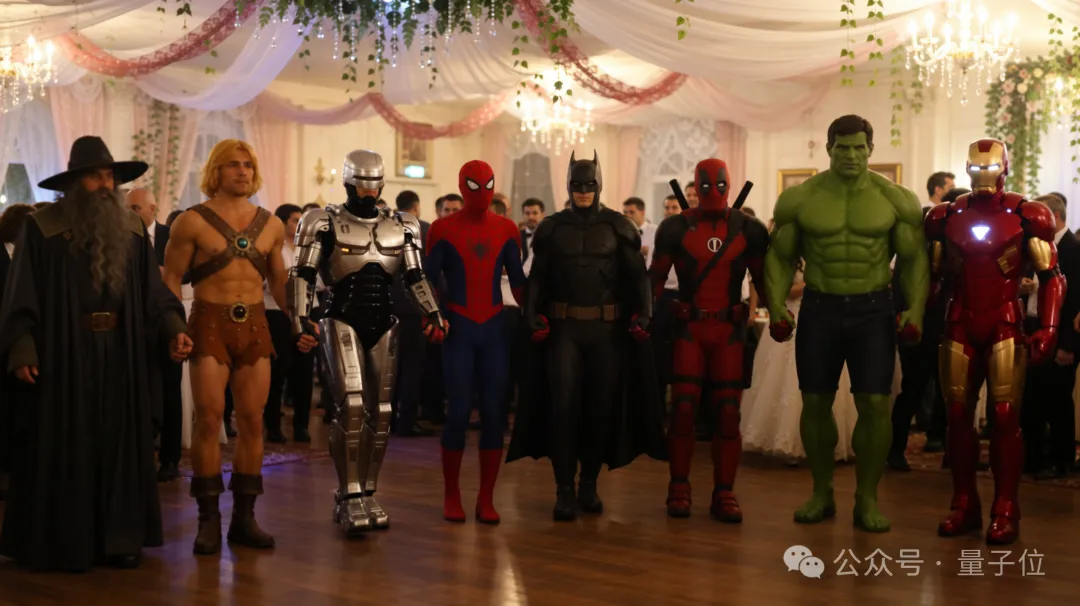 △ 画像提供:Reddit@Ok-Option-6683
また、別の開発者であるWildminder氏は、MOSS-Imageのレイアウト制御能力に注目しました。
JSON LayoutとBounding Boxを活用することで、ユーザーは画像内のテキストやオブジェクトの空間的な位置を厳密に指定できます。この構図制御の仕組みは、ポスターやECサイトの画像などのビジュアルデザイン業務において極めて実用的な価値を持ちます。
さらにコミュニティでは、日本語テキストのレンダリング、複雑な構図、長文プロンプトからの生成、さらには様々なLoRAや推論パラメータ下での生成クオリティについて、精力的なテストが行われています。
共有されたテスト結果を見る限り、MOSS-Imageはこれらのユースケースで高い評価を得ており、特にテキストレンダリングと複雑な指示への追従性において、開発者から絶賛されています。
Redditのr/StableDiffusionコミュニティでは、MOSS-Imageはここ最近で最も注目されるモデルの一つとなりました。
MOSS-Imageのコア開発者によるAMA(Ask Me Anything)スレッドはコミュニティでピン留めされ、コア開発チームがメンバーと直接対話し、モデル設計や実運用の詳細について質問に答えています。
スレッド内では「最近の中で極めて傑出したBaseモデル」と評する声や、かつてのSDXL(2023年にStability AIがリリースしたオープンウェイトの画像生成基底モデル、Stable Diffusion XL)の登場時を思い起こす開発者も見られました。
さらに興味深いのは、MOSS-Imageと他モデルとの比較検証が急速に広がっている点です。FLUX.3-kleinやKrea2などのモデルが相次いで比較対象として挙げられています。
ある開発者は同一のプロンプトで構図や細部の描写を比較し、別の開発者は複雑な人物ポーズの再現性に焦点を当て、さらにフォトリアルの質感、色彩コントロール、スタイルの再現度を集中的に検証する開発者もいます。
これらのテストは多角的な視点を提供しています。画像の自然さやディテールを肯定的に捉える意見もあれば、特定の画風における安定性にはまだ改善の余地があるとする意見もあります。
こうした自発的なテストによって、実際の制作現場におけるMOSS-Imageの実力を包括的に理解するための豊富な知見が得られています。
コミュニティの議論の中心を見ると、とりわけテキストレンダリングとレイアウト制御に大きな注目が集まっていることがわかります。
テキスト、レイアウト、長文プロンプト——MOSS-Imageが解決した最大の課題とは?
画像生成モデルの進化に伴い、生成画質は飛躍的に向上しました。しかし、AIにテキストが密集し複雑なレイアウトが求められるポスターやEC用画像を直接生成させようとすると、依然として多くの課題に直面します。
文字のスペルミスや脱字、タイトルの位置ズレ、複数要素の乱雑な配置などは、実際の制作現場で頻出する課題でした。
MOSS-Imageが今回重点的に最適化したのは、まさにこうしたプロフェッショナルなデザイン業務に直結する能力です。
1つ目は中英テキストのレンダリングです。
MOSS-Imageは高密度なテキスト生成に対して徹底的な最適化を行っており、比較的長文の中国語・英語コンテンツのレイアウトに対応し、改行などの版面構造もしっかりと保持します。Long Long Text Benchmark(LLTB)ベンチマークにおいて、MOSS-ImageのMean-6テキストカバレッジ率は**96.3%**に達し、参加したオープンウェイトモデルの中で第1位を獲得しました。
ここでのカバレッジ率指標は主に目標テキストの再現完全性を評価するものであり、完全な1文字ごとの正解率とは異なりますが、複雑なテキスト生成タスクにおける本モデルの卓越した実力を十分に裏付けています。
2つ目は、デザイン分野で特に注目される空間レイアウト(Layout)の制御です。
従来のText-to-Imageでは、「タイトルを左上に配置し、人物を右側に、メイン製品を中央に置き、周囲に背景要素と説明文を散りばめる」といった構図の要望を自然言語で記述するのが一般的でした。しかし、制約条件が増えるほど、モデルが意図通りのレイアウトを正確に再現することは困難になります。
そこでMOSS-Imageは、構造化されたJSON Layoutの入力方式を採用しました。
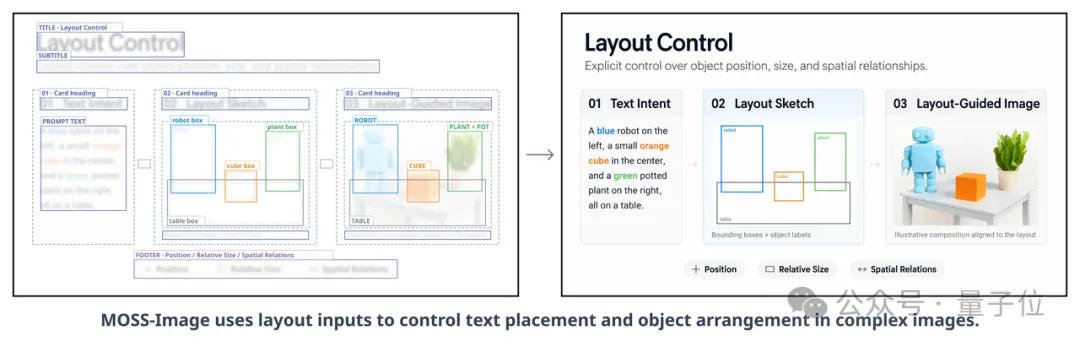
開発者はsummaryフィールドでシーン全体を描写し、items内でテキストやオブジェクトとその視覚属性を定義した上で、Bounding Boxを用いて各要素の位置と領域を正確に指定できます。これにより、抽象的なデザインの意図を明確な空間の幾何学的制約へと落とし込むことが可能になりました。
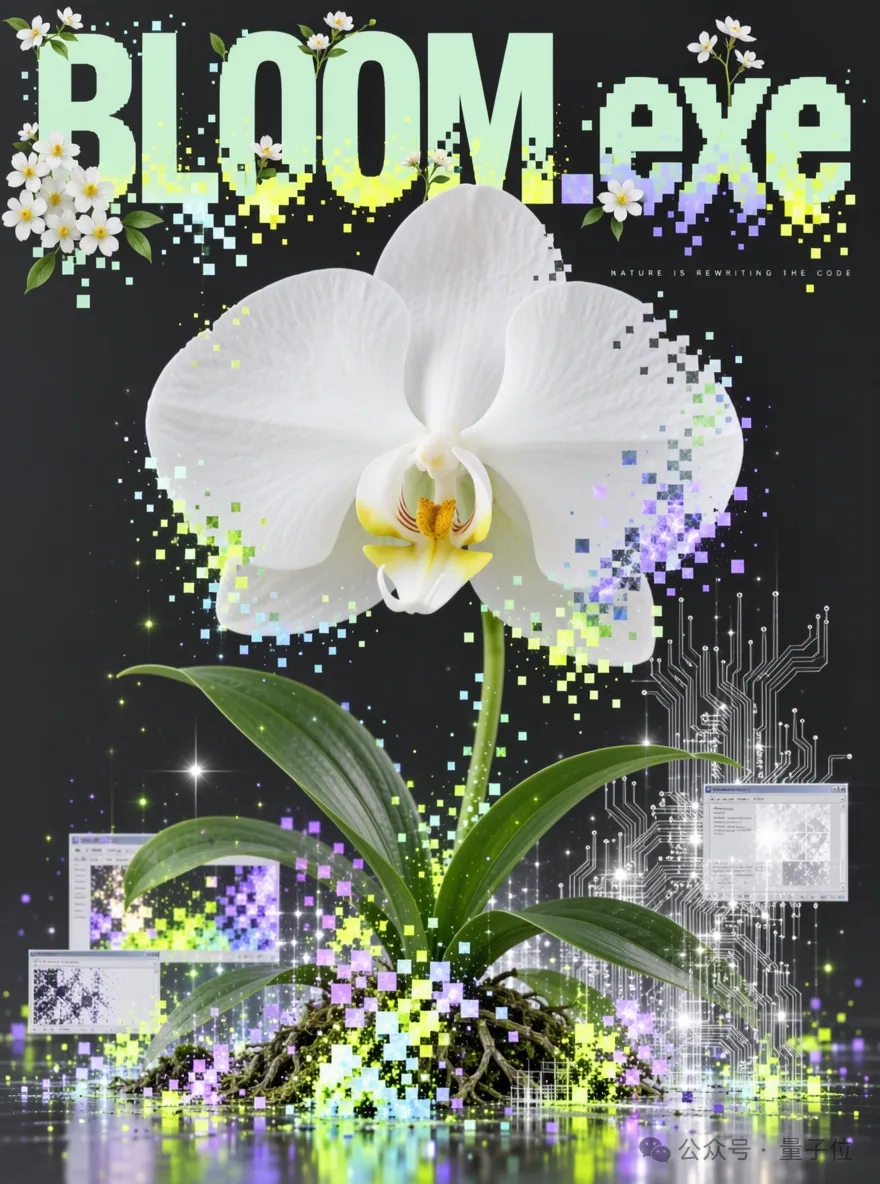 △ 画像提供:Reddit@Nid_All
7Benchのレイアウト制御ベンチマークにおいて、MOSS-Imageはオブジェクト検出mIoUで0.88、レイアウトAUCで0.70を記録しました。
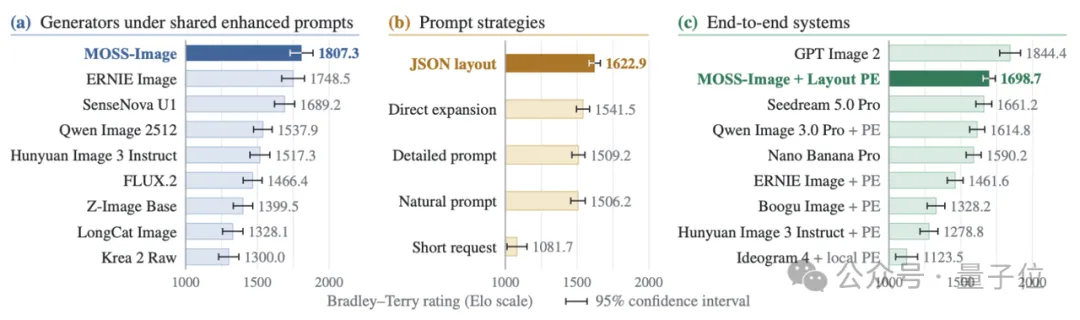
複雑なビジュアルデザインタスクにおいても、MOSS-Imageは確かな実力を発揮しています。
RLAによる実際のデザインブラインドテストでは、簡潔な要件のみを与えた条件で、MOSS-ImageのElo点推定(Point Estimate)は1698.70に達し、評価モデル中GPT Image 2に次ぐ第2位となりました。
また、統一された拡張プロンプトを用いた別の対照実験では、MOSS-ImageのElo点推定は1807.34まで伸び、ERNIE ImageやSenseNova U1を上回って首位に輝きました。
3つ目の強みは、超長文かつ複雑なプロンプトへの対応です。 MOSS-Imageは、最大4096トークンのテキスト条件入力をサポートしています。
一般的なText-to-Imageでは短い記述でも十分対応できますが、複数の主体が重なり合う構図、複雑な空間関係、長文のテキスト、多彩なカメラワーク、綿密なビジュアルスタイルが求められるプロ向けデザイン業務では、超長文プロンプトによって初めて精緻で繊細な制作要件を伝えきることができます。構造化されたLayoutと組み合わせることで、画像の内容と空間トポロジーを同時に定義でき、生成結果のコントロール性が大幅に向上します。
長文プロンプトの作成ハードルを下げるため、OpenMOSSチームは「MOSS-Image Prompt Enhancer Skill」ツールも同時に公開しました。シンプルなアイデアのメモから、ワンクリックで詳細なキャプションや構造化レイアウトのプロンプトへと拡張することができます。
テキストレンダリング、高精度なレイアウト、そして超長文プロンプトという3つの特徴は、MOSS-Imageの目指す技術方針を明確に示しています。それは、画像生成をコンセプトレベルの自由制作から、高要求かつ精密なコントロールが求められる商業ビジュアルデザインへと昇華させることです。
基盤アーキテクチャとして、MOSS-Imageはゼロから事前学習されたシングルストリームDiffusion Transformer(DiT)を採用しています。
コアとなるDiTバックボーンは5Bパラメータ規模を誇り、重みを凍結したQwen3.5-9BテキストエンコーダおよびFLUX.2 VAEと組み合わせることで、テキスト条件と画像の潜在変数をエンドツーエンドの生成システムへと統合しています。Qwen3.5-9Bがテキストの意味論を深く抽出し、FLUX.2 VAEが潜在変数のエンコード・デコードを担い、DiTがバックボーンとして拡散生成のモデリングを主導します。
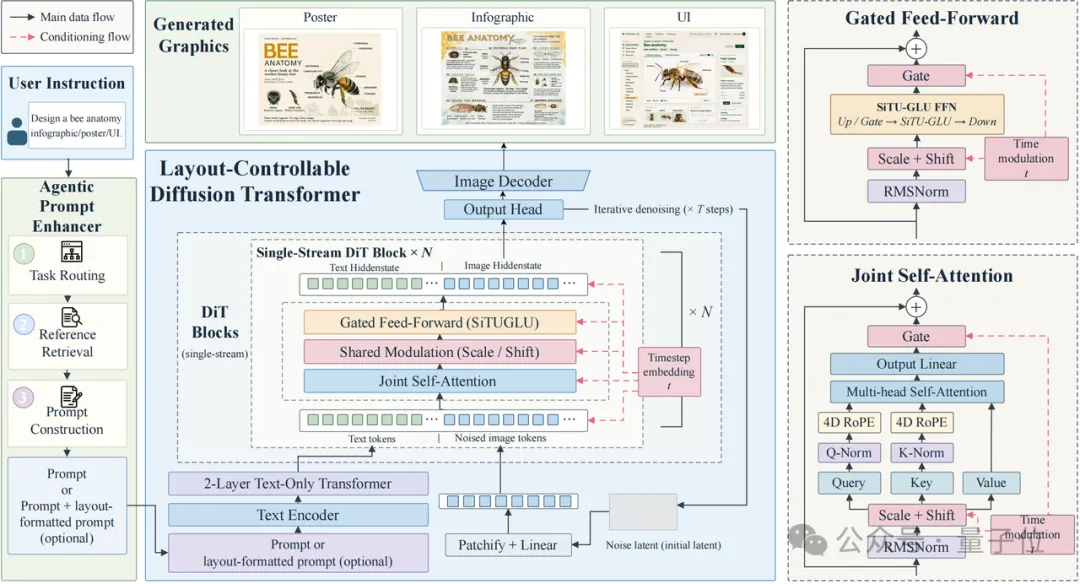
学習データのガバナンスにおいては、チームは綿密な重複排除と品質フィルタリングを実施し、AI生成画像を徹底的に排除しました。実写画像が持つ多様性を最大限に維持しつつ、ウォーターマークやブレといったノイズ特徴に対して細粒度のアノテーションを構築しています。
もう一つ特筆すべきエンジニアリング上のハイライトは、MOSSチームによればMOSS-Imageの学習はすべて国産PPUコンピュートプラットフォーム上で行われたという点です。これは、ヘテロジニアスな計算基盤エコシステムにおける大規模画像生成モデルのエンジニアリング・トレーニングとフルパイプライン適合において、貴重な知見をもたらしました。
公開からわずか数日、高速化版・量子化版・多様なLoRAが続々登場
リリースされたばかりのオープンソースモデルであるにもかかわらず、MOSS-Imageがコミュニティによる二次エコシステムの構築を促したスピードには目を見張るものがあります。
開発者がまず着手したのは推論効率の最適化でした。
MOSS-Imageの公式推奨ベースラインは50ステップのサンプリングですが、コミュニティではすでに超低ステップ生成の探求が急速に進んでいます。Lodestoneなどの開発者がDMDベースの8ステップ高速化アプローチを公開したほか、Rapid-MOSSはこれをさらに4ステップまで圧縮して画像生成を可能にしました。
これらのソリューションは、大量の画像生成や高頻度の試行錯誤に対して軽量なサポートを提供します。
また、別の開発者グループはエッジ展開と推論アクセラレーションに注力しています。
INT8量子化、GGUFフォーマット、MLXによる重み変換手法が次々と登場し、各実行環境に特化した推論最適化が活発に行われています。これらの取り組みにより、VRAM消費量が大幅に削減されて推論スループットが向上し、ローカルの個人デバイスや軽量開発環境へのモデル導入の現実味が広がりました。
同時に、専用LoRAのファインチューニング検証も本格化しています。ビンテージなフィルムグレイン、スマートフォンのスナップ写真のような質感から、ガッシュアート、アニメの立ち絵、ピクセルアートに至るまで、多種多様なビジュアルスタイルのLoRA派生モデルが続々と登場し、MOSS-Imageの優れたファインチューニング適応性を証明しています。
エコシステムの互換性に関しては、Diffusers PipelineやComfyUI公式プラグインに加え、SGLangやvLLM-Omniもリリース初日(Day 0)にフル対応を果たしました。Ostris AI Toolkitやsd-scriptsといった人気ツールチェーンも迅速にサポートを追加し、モデルのファインチューニングからプロダクション統合までの全工程を支える開発者向けツールが整っています。
ベース画像の生成、精密なレイアウト設定から、後工程の緻密な編集に至るまで、MOSS-Imageを取り巻くワークフロー体系は急速に完成度を高めています。これらのツールやアプローチはオープンソース初期のテスト・イテレーション段階にあるものの、グローバルコミュニティが示す熱量は驚異的です。
現在、MOSS-Image APIは正式に一般公開されています。開発者はローカルハードウェアの導入コストをかけることなく、画像生成APIを直接呼び出し、既存のビジネスや制作パイプラインに迅速に組み込むことができます。
また、一般ユーザーも模思智能が提供するデスクトップ向け音声アシスタント「MosMos」を通じて、リアルタイムの音声対話によるクリエイティブな画像生成を体験できます。
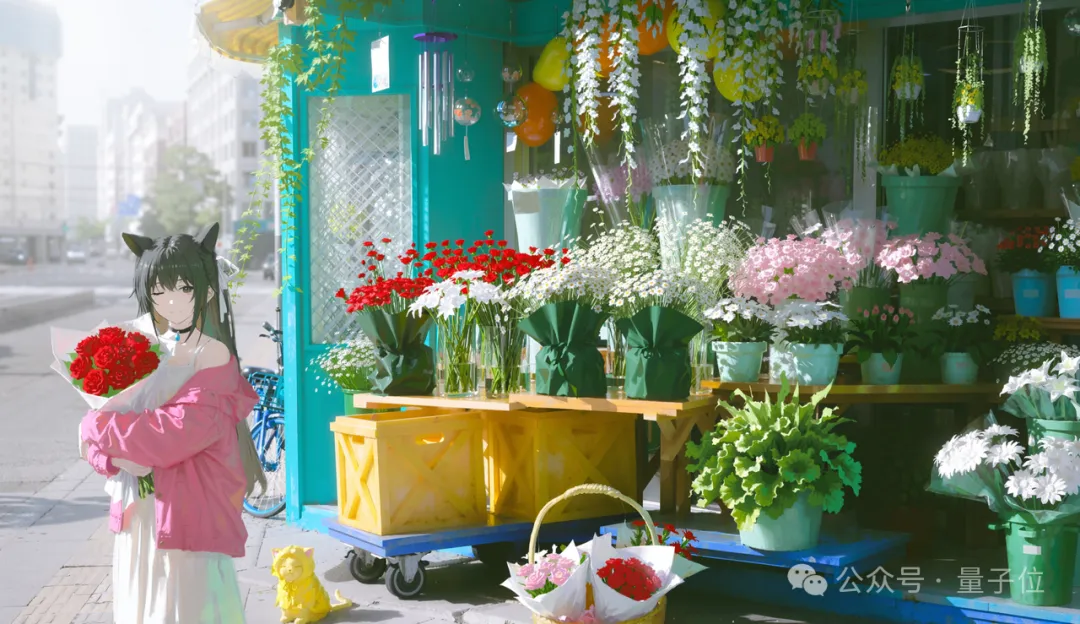
以下は、コミュニティがMOSS-Imageを用いて制作した厳選作品の一部です:
注目すべき点として、MOSS-Imageの正式オープンソース化の4日前、模思智能(MOSS)は10億元(約200億円)を超えるプレAラウンドの資金調達を完了したことを発表しました。
発表によると、本ラウンドは華控基金(Tsinghua Holdings Capital)がリード投資を務め、国開科創、上海科創基金、新微資本、徐匯資本、追光硬科技創投、臨港策源基金などが主な共同出資者として参画しました。元禾控股、上海国投傘下の上海科創集団、星連資本といった既存株主も追加投資を行っています。模思智能は、調達資金を全モダリティにおけるリアルタイムインタラクティブ知能の技術研究開発とグローバルな商用展開、ならびにAI for AI分野の先進的な可能性の探求に重点的に充当するとしています。
今回話題となったビジュアル画像モデルにとどまらず、MOSSチームは2026年上半期だけでも20種類以上のモデル群を精力的にオープンソース化・提供しており、その領域は音声生成や視覚認識・理解など複数の重要分野に及んでいます。
その中でも、MOSS-TTSシリーズの音声モデルは累計グローバルダウンロード数が300万回を突破しました。さらに、エンドツーエンドの動画理解モデル「MOSS-VL」や、複雑な会議シーンに対応した話者分離・文字起こしモデル「MOSS-Transcribe-Diarize」なども相次いでリリースされています。
今後、MOSSチームは**全二重リアルタイムインタラクションシステム「MOSS-Live」や次世代音声合成モデル「MOSS-TTS 2.0」**を順次投入し、全モダリティ環境下でのリアルタイムインタラクション体験をさらに強化・統合していく予定です。
個別の技術指標のブレイクスルーから高忠実度なインタラクションシステムへと進化させ、複雑な現実世界の現場で生産性の価値を解放し続けること——これこそが、模思智能がエンボディドAI(身体性知能)の世界へ踏み出す上での重要な指針となります。
- プロジェクトURL: https://github.com/OpenMOSS/MOSS-Image
- MOSS-Image API: https://platform.mosi.cn/
- モデルウェイト:
- 技術レポート: https://github.com/OpenMOSS/MOSS-Image/blob/main/paper/MOSS_Image_Technical_Report.pdf
- デスクトップ向け音声アシスタント MosMos: mosmos.io