
2026年10月23日 - リンクブログ
Kimi K3.1 Pro が正式リリース(情報元)Kimi K3.1 Pro が本日 Kimi API で利用可能になりました。現時点ではオープンウェイト(open weights)ではありませんが、Moonshot は「2026年11月4日までに完全なモデルウェイトを公開する」と表明しています。
また、速度が2〜3倍向上する「高速(Highspeed)」バージョンも提供されており、価格は2倍となっています(入力トークンのキャッシュヒット時を除く。キャッシュヒット時は同額)。
米ドル価格は、入力100万トークンあたり2.00ドル、出力100万トークンあたり10ドルとなっており、これは GPT-6.1 Sol と同額で、Claude Opus 5.5 の半額です。
Moonshot 自社のベンチマークテストによると、Kimi は Opus 5.5 および GPT-6 Astra とほぼ同等の性能を示しており、一部のベンチマークで上回り、その他のテストでも極めて僅差の結果を残しています。
Artificial Analysis は Kimi に55点のスコアを付けました。これは Claude Fable 5.1、GPT-6 Astra、Gemini 4 Argon(いずれも53点)を上回り、Claude Opus 5.5(58点)に次ぐスコアです。
(まもなく公開されるとはいえ)オープンウェイトモデルが、最前線のフロンティアモデルとの競争でこれほどの高スコアを獲得したのは今回が初めてです。
8月に LLM 0.32 へ追加された llm openai endpoint コマンドを使って、Moonshot API 経由で早速試してみました:
llm openai endpoint \ https://api.moonshot.ai/v1 \ --key kimi \ -m kimi-k3.1-pro \ "Generate an SVG of a pelican riding a bicycle" \ --responses \ -o reasoning_effort low \ > kimi-k3.1-pro-pelican-low.stdout.txt \ 2> kimi-k3.1-pro-pelican-low.stderr.txtllm openai endpoint は、OpenAI 互換のエンドポイントに対してプロンプトを実行できますが、結果はログに記録されません。そのため、標準出力(stdout)と標準エラー出力(stderr、推論トレース: reasoning trace)を保存するための追加引数が必要になります。
こちらが、Kimi K3.1 Pro が対応している3段階の推論レベル(low、medium、max)で生成されたペリカンです。以下は max レベルの結果です:
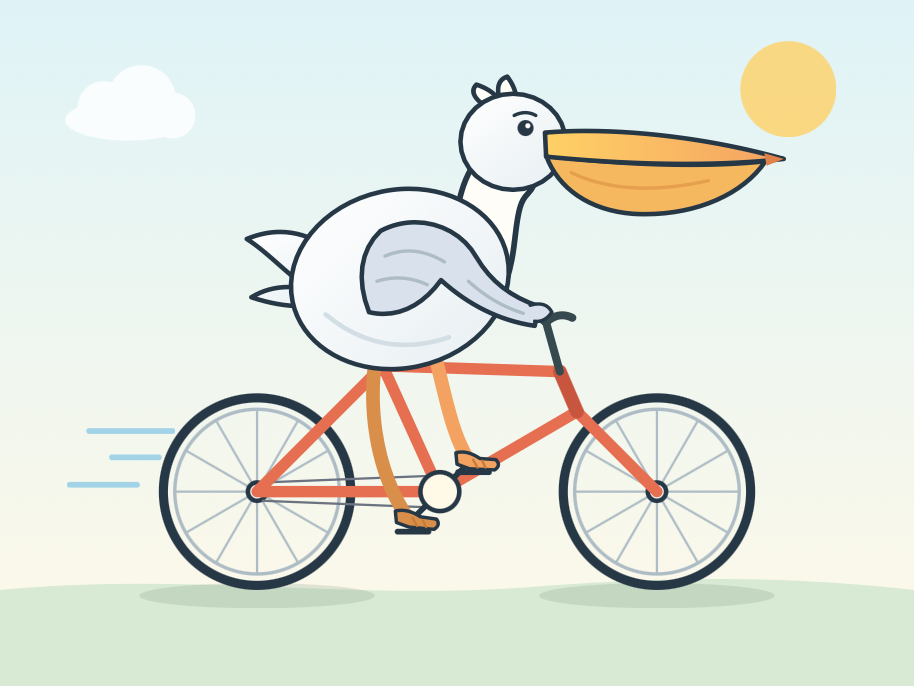
比較として、同じくこれら3つの推論レベルで Kimi K3 にも新しくペリカンを生成させてみました。