
AIモデルは、ますます多くの難解な数学の未解決問題を解決しつつあります。その目覚ましい成功の背後にはあるパターンが浮かび上がりつつあり、それによってAIが次にどのような問題を解決できるのかを予測する手がかりが得られます。
10月23日 · 読了目安 16 分
今年5月、OpenAIの社内モデルがエルデシュの単位距離予想(Erdős’s unit distance conjecture)の反例を発見しました。この予想は1946年の提唱以来、未解決のまま多くの専門家が証明を試みてきましたが、OpenAIは反例を見つけ出すことに成功したのです。その1か月後、OpenAIはサイクル二重被覆(Cycle Double Cover, CDC)問題の証明を発表し、続く7月までにさらに10個の未解決問題の解答を提示しました。9月にはナビエ・ストークス方程式(Navier-Stokes)に関する証明を発表しています。Anthropicもフェルマーの最終定理の形式化に関する成果や、リーマン予想の境界値に関する進展を公開しました。AIモデルは突如として、極めて高度な数学力を発揮するようになったのです。
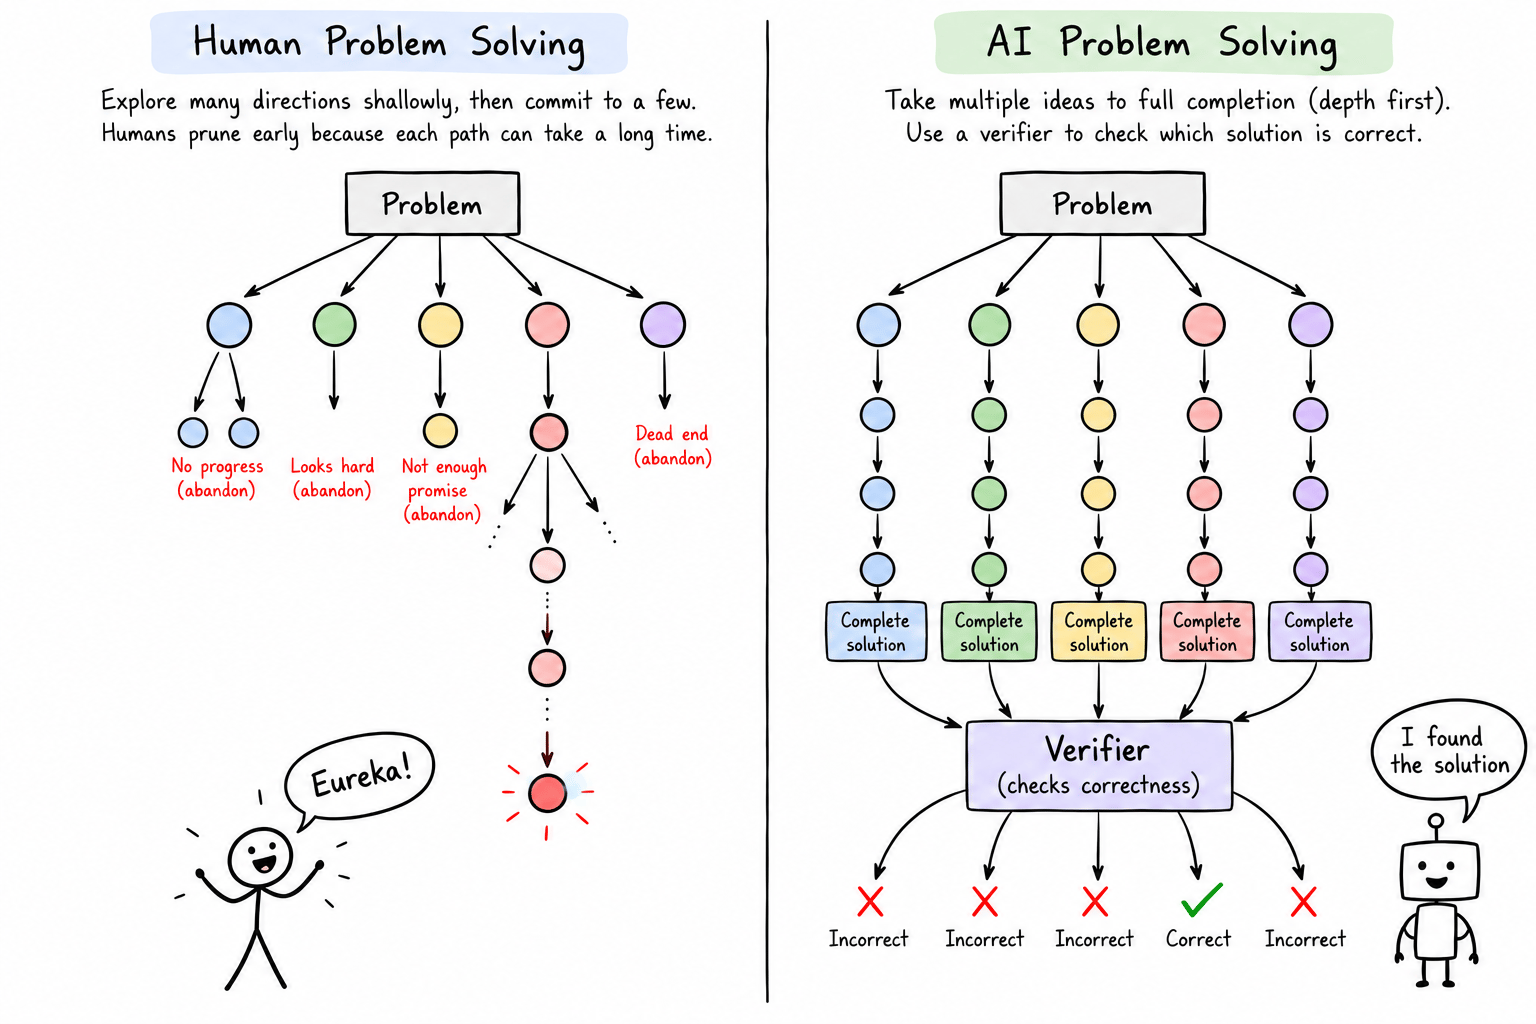
ここで真に興味深い問いが生じます。「これらのモデルが最終的にどの種の問題を解決できるのか、あらかじめ予測することは可能なのだろうか?」という点です。一体何が、ある問題を大規模言語モデル(LLM)によって攻略可能にするのでしょうか。また、それらの解決手法にはどのような共通点があるのでしょうか。 もしAIの問題解決アプローチが人間と異なるのであれば、その違いを明確にすることで、計算資源をどこへ投じるべきかを判断する助けになるはずです。単位距離問題の反例に関する議論が最も充実しているため、まずはここから掘り下げてみましょう。
問題の複雑さ(Complexity)
ここで1つのシンプルなメンタルモデルを提示します。あらゆる問題を解決するには、一連の「ヒント(hints)」や「洞察(insights)」が必要であり、その合間に膨大な作業を積み重ねる必要があります。このパターンは日常の些細な問題だけでなく、一般相対性理論のような壮大な理論の構築プロセスにも驚くほど当てはまります1(文末の補足を参照)。そのプロセスは概ね次のような流れをたどります。
洞察 -> 時間 / 努力 -> 洞察 -> 时间 / 努力 -> 解決策。
専門家は初心者よりも豊富な予備知識を持っているため、必要とするヒントの数は少なくなります。W・T・ガワーズ(WT Gowers)は単位距離問題の証明に関する考察の中で、同様の思考モデルを採用しました。「証明の難しさは、専門家がその証明を再構築するために必要となる最短のヒントの連鎖(シーケンス)に等しい」。彼はこれを「専門家を法とするコルモゴロフ複雑性(Kolmogorov complexity modulo experts)」と呼びました2。単位距離問題において、彼のヒントシーケンスは次の3つのステップに分かれていました。
-
反例を探す。
-
現在知られている最良の配置(configuration)を取り上げ、それを一般化する。
-
次数を増やした数体の系列を試す。ただし、ノルムが有界な素イデアルの下で作業を進める。
ガワーズが提案した複雑さの式は 2^k + t です。ここで k は最短ヒントシーケンスの長さ、t はそれを実際に展開・推論するために必要な作業量を表します。この数式は厳密に見えるものの、具体的な数値を代入しようとすると非常に抽象的であることが分かります。しかし、これこそが本質を突いています。問題の複雑さは、解決に不可欠な洞察の数が増えるにつれて指数関数的に増大するのです。
大半の課題解決のプロセスは、実はこうした洞察と洞察の間で費やされる地道で重労働な作業にあります。「エウレカ(ひらめき)の瞬間」が訪れた後、次の概念的飛躍が可能になるまで、そのヒントを何ヶ月もかけて掘り下げなければなりません。専門家にとって、費やされた時間はその作業量を測る有効な代理指標(プロキシ)となります。これが t です。仮に誰かに単位距離問題の最初のヒントを直接与えたとしても、一般化された配置にたどり着くには、依然として膨大な演繹と計算の作業をこなす必要があります。
このモデルは非常に有用ですが、事後的なもの(post hoc)に過ぎません。問題を見た最初の段階で、「この問題には x 個のヒントが必要だ」と正確に予測することはできないのです。そのため現実には、問題が提示された年数、これまでに挑まれた回数、懸けられた賞金などが、難易度を評価する実践的な代理指標としてしばしば用いられています。