
部屋が一瞬で草原に、手を挙げれば雪が降る
中国国内のバーチャルスタジオ(バーチャルプロダクション)から生まれたリアルタイム・ワールドモデルが、NVIDIA のステージで受賞を果たしました。
10月15日、2026 NVIDIA Inception ベンチャーショーケース(中間選考)が蘇州金鶏湖で開催されました。重慶発のテック企業・達瓦科技(Dawa Technology)は、同社のリアルタイム・ワールドモデル製品 Scenes AI により、**「セミファイナル・エクセレンス・エンタープライズ賞」**を獲得しました。
今大会は全国11カ所で地方予選が開催され、580社以上のスタートアップ企業がエントリー。最終的に NVIDIA Inception プログラムの会員企業わずか30社がこの中間選考へと駒を進めました。
多くの動画生成モデルが「次のフレームが破綻していないか」を競い合う中、Scenes AI はまったく異なるアプローチを採用しています。
次のフレームの映像を直接予測するのではなく、常に稼働し続ける「世界の状態」を維持・管理するという手法です。シーン、人物、カメラ、照明、オブジェクト、そして物理法則が、それぞれ個別に読み書き可能な一連の変数として扱われます。
世界にわずかな変化が生じた際、モデルは画面全体をゼロから描き直す必要がありません。変化した局所的な状態のみを更新して世界に書き戻し、その状態をベースに次の瞬間へと推移させます。
そのため、解くべき問い自体も変化しています。もはや「次のフレームはどう見えるか」ではなく、**「世界の中のある変数を変更した場合、世界は今後どのように展開していくか?」**が問われているのです。
さらに重要なのは、その入力ソースがゲームエンジンの映像やバーチャルエージェントではなく、一般的なカメラで撮影された現実空間である点です。
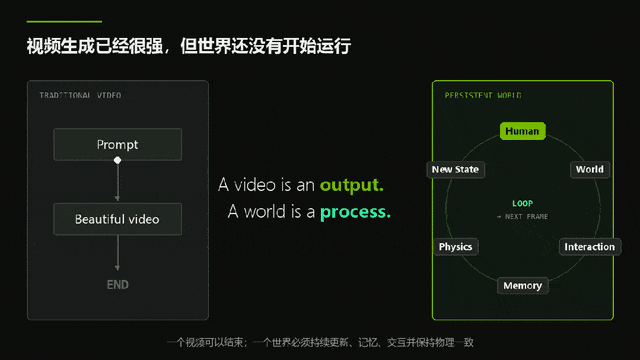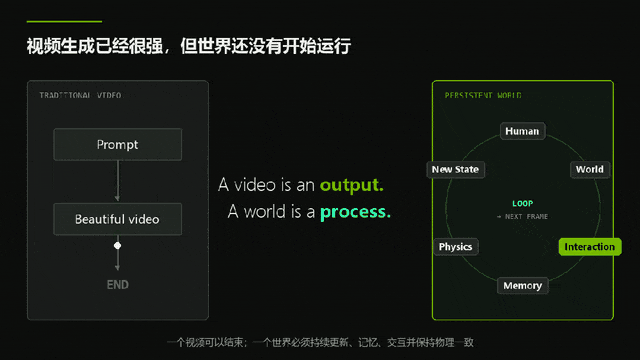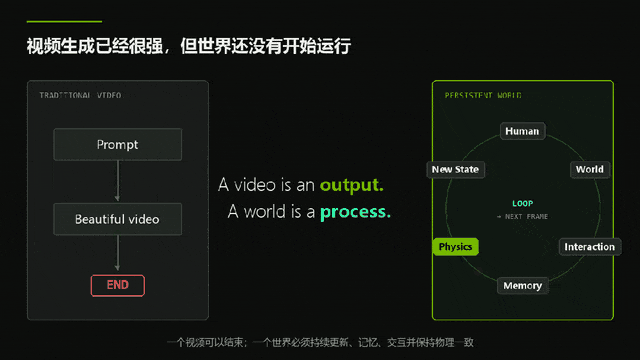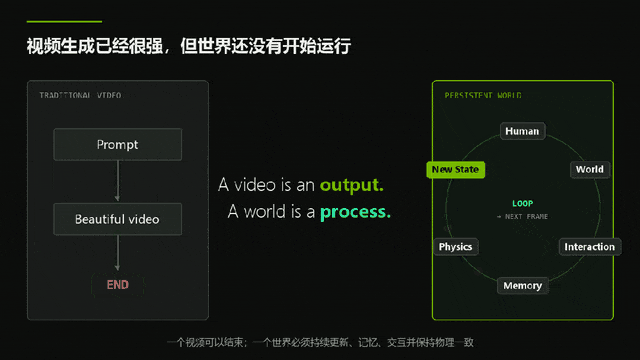
達瓦科技の言葉を借りれば、**「A video is an output. A world is a process.(動画は結果にすぎず、世界こそがプロセスである)」**ということになります。
まずは効果を検証:世界全体の一変も、壁一枚の修正も自由自在
最新のデモ映像を見てみましょう。
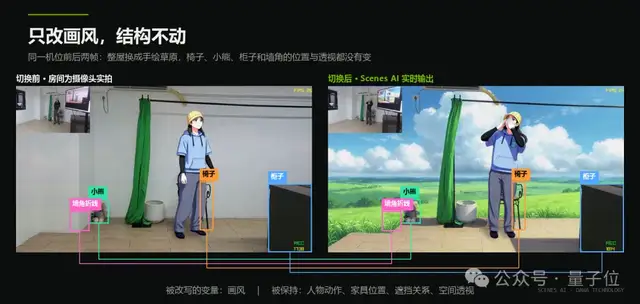
左上はカメラがリアルタイムで捉えている実際の部屋です。白い壁、グリーンバック、アイアンチェア、部屋の隅にあるテディベア、そして中央には帽子のつばに手を添えている生身の人間が立っています。
メイン画面は、同じ瞬間におけるモデルの出力結果です。部屋は手描き風の夏の草原へとレンダリングされ、立っていた人物は黄色いベースボールキャップをかぶったアニメ風の少女へとシンクロして変身し、完全に同じ動作をしています。
よく観察すると、変化しているのは視覚的なスタイルだけであることがわかります。椅子は変わらず少女の背後にあり、クマのぬいぐるみも元の「部屋の隅」に座ったままです。右側にある濃色のキャビネットの空間的位置関係や遠近感(パース)も崩れておらず、草原の上にはかすかに2つの壁が交差する折り目すら確認できます。
検証ポイント1:グローバル再レンダリングでも構造を崩さない
このフレームにおいて、変更された唯一の変数は「画風(スタイル)」です。
人物のアクション、家具の位置、遮蔽関係、空間のパースペクティブは、すべて維持条件としてロックされています。モデルは人物、椅子、ぬいぐるみ、キャビネットといった被写体を正確に認識した上で、空間全体のスタイルを切り替えつつそれらを元の位置に固定し、毎フレームの論理的一貫性を保たなければなりません。
検証ポイント2:部分的な書き換えと、それを「記憶し続ける」能力
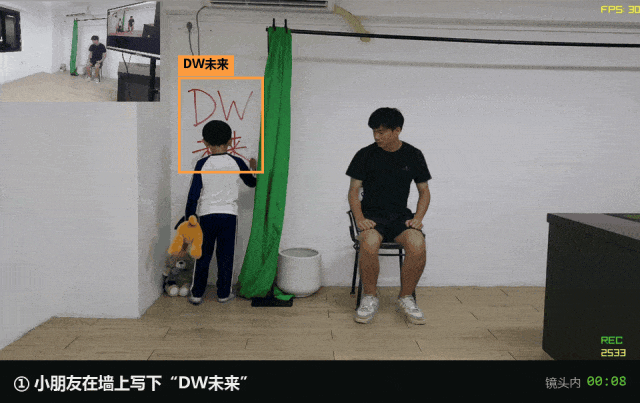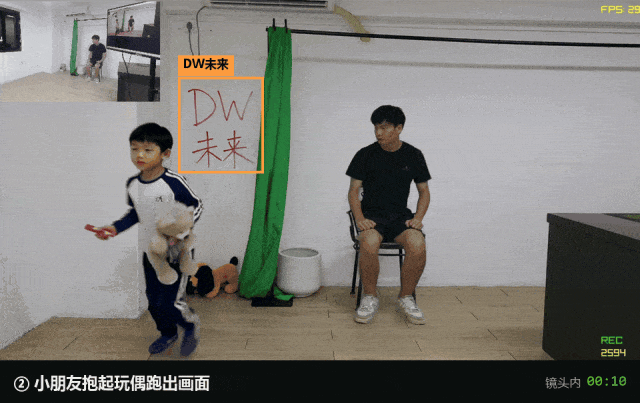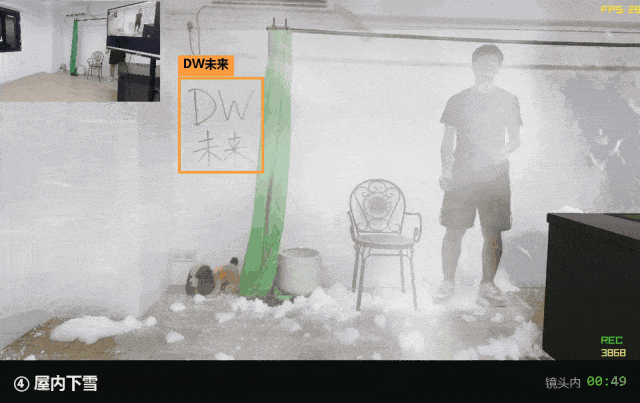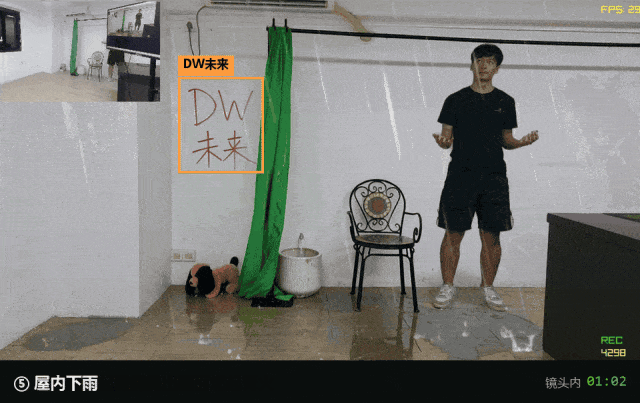
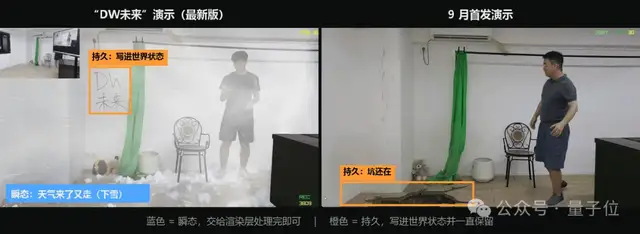
同一シーン内で、一人の子どもが壁に「DW未来」と落書きし、ぬいぐるみを抱きかかえて画面外へ走り去ります。続いて一人の男性が立ち上がると、部屋の中から木々が生え、地面から焚き火が燃え上がります。その後、彼が手を掲げて天候をコントロールすると、室内には雪が舞い始め、やがて激しい雨へと変わります。
人の出入り、新たなオブジェクトの生成、目まぐるしく変化する天候といった一連のイベントを経ても、壁に書かれた4文字は位置も筆跡も寸分違わず鮮明に残り続けています。
これは、モデルが世界の状態を正しく書き戻し、それを長期にわたって維持できるかを試す試金石です。
フレームごとの逐次生成に依存するモデルの場合、画面内の動的な変化が増えるほど以前のディテールは徐々に「洗い流され」やすく、再描画のたびにディテールのドリフト(ズレ)が発生しがちです。しかし Scenes AI では、「壁に文字がある」という事実は書き込みが完了した瞬間に世界状態の一部として定着します。以降、環境がどう変化しようと、その状態を能動的に変更するイベントが発生しない限り、文字は存在し続けます。
9月の初回デモでも、同様の基本ロジックが示されていました。イエティ(雪男)が地面を突き破って去った後も地面の穴はそのまま残り、アイアンチェアが2度にわたって鉄の玉座に変換されても配信者は元の位置に正確に座り直すことができ、カーテンの裾に火がついても隣接するぬいぐるみや植木鉢には一切燃え移りませんでした。
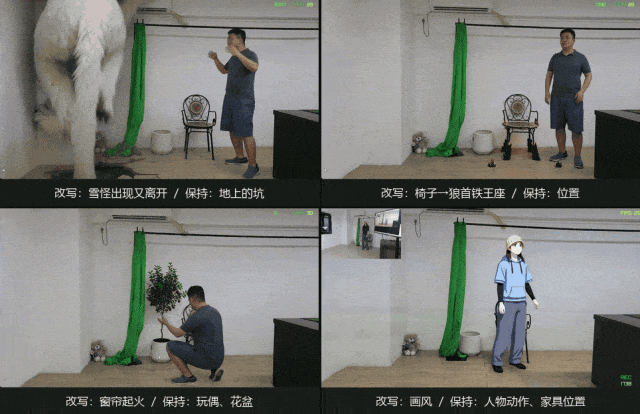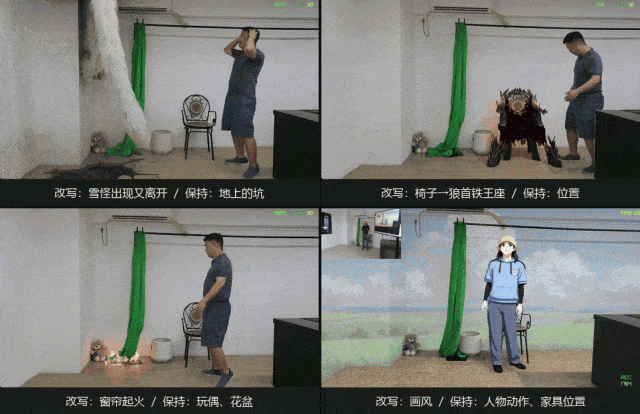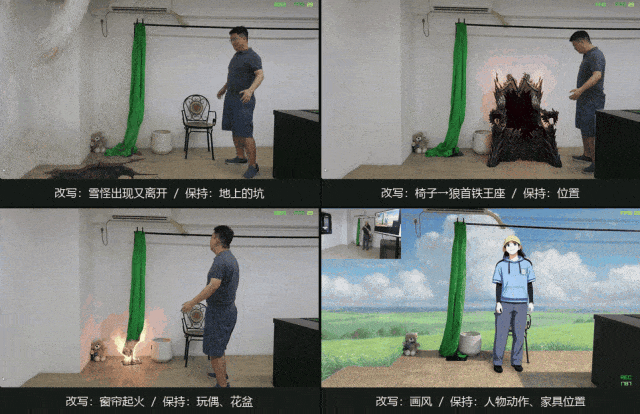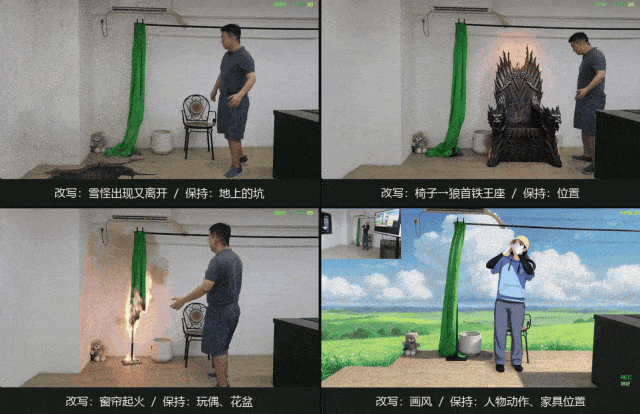
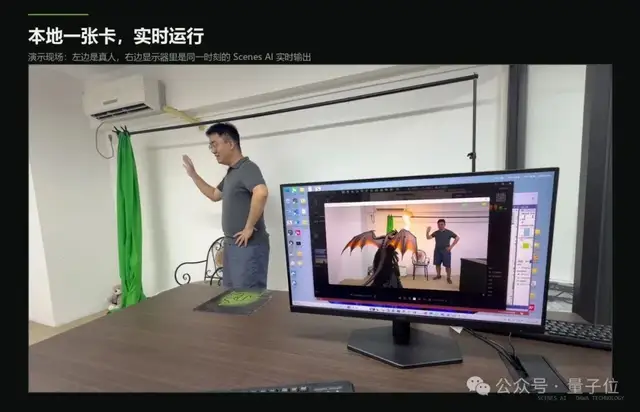
このリアルタイム生成パイプライン全体は、ローカル環境のコンシューマー向け RTX グラフィックスカード1枚で動作しており、画面右上にはレンダリングフレームレートがリアルタイムで表示されています。
差別化の道:「次のフレームを描き直す」から「世界の状態を更新する」へ
デモの背景には、ワールドモデルの発展段階に対する達瓦科技の根本的な現状認識があります。
動画生成技術はすでに十分に強力だが、世界そのものはまだ真の意味で稼働していない。
主流の動画生成モデルの最終成果物は、往々にして「静的な結果」にとどまります。プロンプトを入力し、美しい動画クリップが1本生成されれば推論は終了します。
仮にフレームごとの連続推論を行ったとしても、その関心の中心は依然として「次のフレームがどう見えるか」にあり、結果としてアイデンティティ、ジオメトリ、照明、物理法則の誤差が時間の経過とともに蓄積し続けてしまいます。
達瓦科技によるワールドモデルの定義は異なります。**「1つの状態変数を変えた後、世界はなぜ変わり、どのように推移していくのか」**という点です。
例えば「照明を夕暮れに切り替える」ケースを考えてみましょう。
- 従来の動画モデル:動画全体を再生成するため、シーン、人物、カメラワーク、オブジェクトの形状などにズレが生じる可能性がある。
- Scenes AI:シーン、人物、カメラアングル、オブジェクトを維持条件として固定し、「照明」という変数のみを調整した上で、更新された世界状態に基づいて新たな画面を生成する。
達瓦科技はこの技術パラダイムを、「1つの変数を変更し、世界全体を保持する」と要約しています。
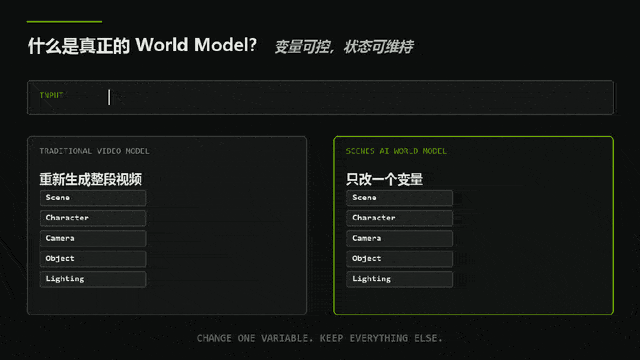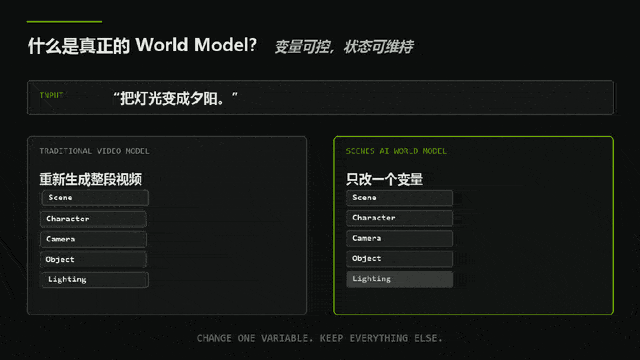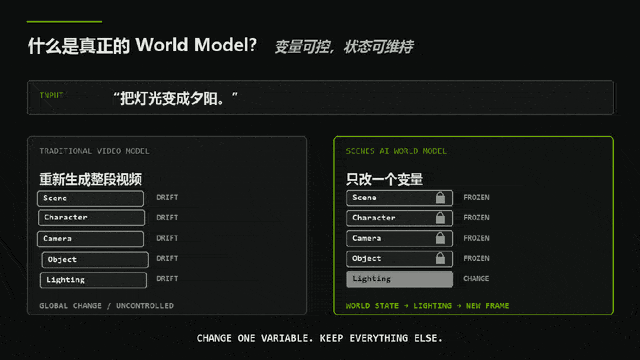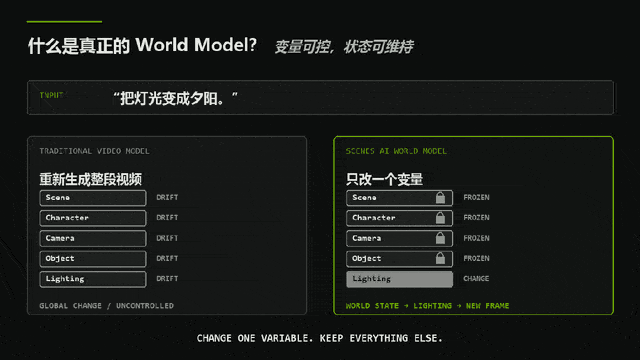
計算レベルに落とし込むと、これは「次のフレームを再描画する」アプローチから、**「状態の増分 ΔS を更新する」**アプローチへの転換を意味します。変化のあった局所領域のみを計算し、残りの世界状態は安定的、クエリ可能、かつ予測可能な状態を保ちます。
この定義のもと、継続稼働する世界は5つの主要モジュールに分解されます。
Persistent World = World Memory + Neural Physics + Sparse Diffusion + Neural Rendering + AI Lighting
すなわち、世界記憶(World Memory)、ニューラル物理(Neural Physics)、スパース拡散(Sparse Diffusion)、ニューラルレンダリング(Neural Rendering)、AIライティング(AI Lighting)です。
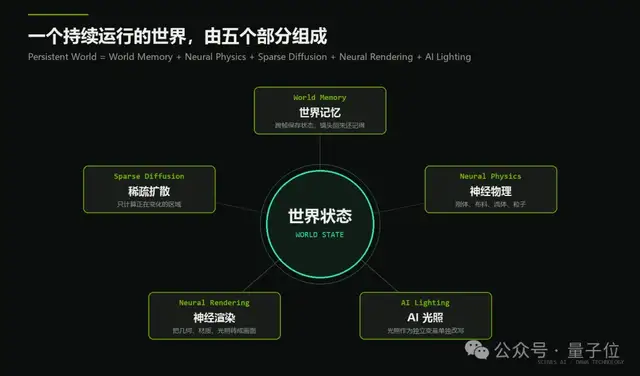
達瓦科技のチームは、「静的な動画の生成」から「インタラクティブに動く世界の実行」へと移行するには、以下の5つの関門を同時に突破する必要があると考えています。
フレームをまたぐ長期記憶、高精度な局所制御、物理法則と因果関係、リアルタイムな計算効率、そして「なぜ世界がそのように変化したのか」を説明できるデータアセット。
彼らは、**「技術的な難所はモデル規模をただ大きくすることではなく、状態、制御、物理法則、計算効率が同時に成立することにある」**と語っています。
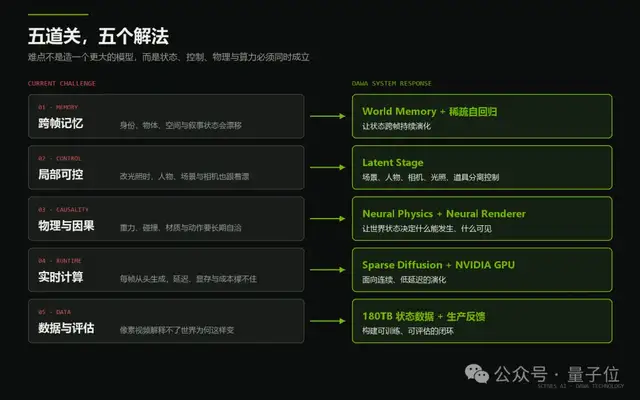
後述する高精度な制御とリアルタイムレンダリング能力こそが、このアーキテクチャが「制御」と「計算資源」という2大課題に対して導き出した解答です。
技術アーキテクチャ:コントロール層を「重く」、生成層を「軽く」
このロジックをエンジニアリングシステムとして実現するため、達瓦科技が採用したコア戦略は、コントロール層を重くし、生成層を軽くすることです。
Scenes AI はすべての推論負荷を単一のモデルに丸投げしてフレームごとに描き直させるのではなく、「創作意図」と「画面生成」の間に世界状態を中核とする制御システムを構築しました。これを**動画生成のコントロール層(制御層)**と呼んでいます。
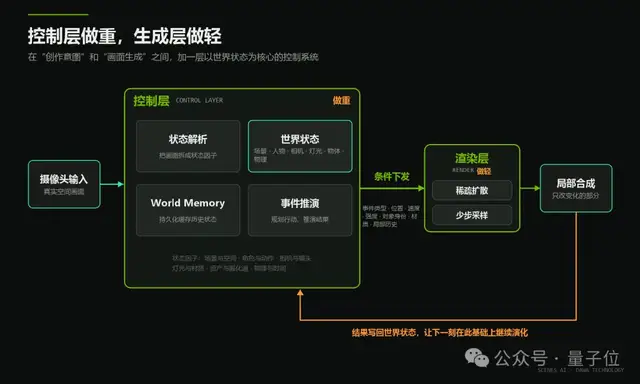
- コントロール層:連続する動画ストリームを、クエリ・更新・制約が可能な状態因子(シーン空間、キャラクターの動作、カメラアングル、照明・マテリアル、アセット・小道具、物理法則、時間の流れなど)へと分解。アクションプランニング、状態維持、因果関係の推論を担います。
- レンダリング層:コントロール層から送出された状態コマンドを受け取り、変更が必要な部分のみを生成してグローバルな画面へと合成します。
その典型的な処理フローは以下の通りです。
世界状態 → アクション/接触イベント → 状態更新 → 局所生成と合成 → 結果の書き戻し
「DW未来」のデモシーンを例に挙げます。
- 子どもが壁に文字を書くと、イベント層が書く動作とその接触点(壁面)を認識します。
- コントロール層が直ちに世界状態を更新し、「壁面に筆跡がある」というプロパティを壁オブジェクトにバインドします。
- その後のシーンで木が生え、火が灯り、雨や雪が降った際も、コントロール層は対応する環境変数と天候変数のみを更新します。レンダリング層は木、炎、雨雪、およびそれらに付随する光影の変化のみを生成し、壁面と筆跡は既存の表現をそのまま流用します。
- 雨雪の天候は一時的な動的変化であるため止み次第消滅しますが、壁面の筆跡は永続的な状態として世界に固定され、後続のアングルやインタラクションから継続して参照されます。
このメカニズムの核心は、**「一時的な変化(トランジェント)」と「永続的な状態(パーシステント)」**の境界を明確に定義することにあります。
前者はレンダリング層がオンザフライで処理すれば十分ですが、後者は必ず世界状態に書き込まれなければなりません。デモで見られた「穴が残り続ける」「筆跡が消えない」といった現象は、すべてこの階層化された状態管理機構によるものです。
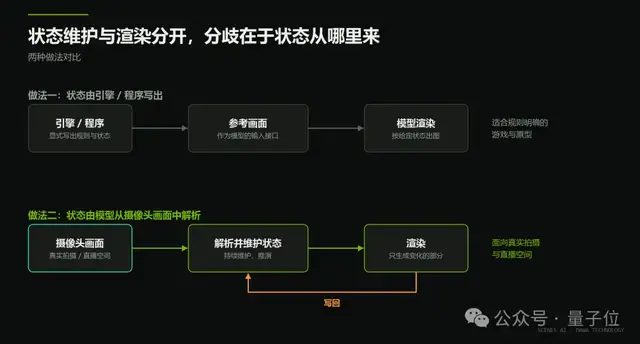
業界全体の視点から見ても、「状態管理と視覚的レンダリングの分離」はリアルタイム・ワールドモデルの共通認識となりつつあります。主な違いは状態の取得元にあります。
ゲームエンジンなどの上流プログラム側でルールや状態を明示的に定義し、モデルはリファレンス画面を頼りにレンダリングのみを行うアプローチは、ルールが明確なゲームやプロトタイプ開発に向いています。
一方、Scenes AI は実際のカメラ撮影やライブ配信シーンを直接対象としており、その世界状態はカメラの動画ストリームからモデル自身がリアルタイムに解析・抽出し、継続的な維持・推論・書き戻しを行う必要があります。
高精度な制御:単一の変数を変更し、他の要素は完全に維持
高精度な制御を実現する要となるのが、コントロール層の Latent Stage モジュールです。
1つ目は、変数のデカップリング(分離)です。
Latent Stage は、潜在空間(Latent Space)内でシーン、人物、カメラ、照明、衣装、小道具、物理法則を複数の独立した「仮想ステージ」へと分解します。各要素は個別に推移することも、協調して制約し合うことも可能です。
編集操作のたびに「変更セット」と「維持セット」が明確に区分されます。照明を調整する際はシーンの幾何構造、人物の形態、カメラパラメータが完全にロックされ、衣装を変更する際は人物のアイデンティティ特徴と身体動作が画面生成を一貫して制約し続けます。
デモにおける「部屋全体の画風が一変しても家具の位置は寸分違わない」挙動は、変更セットと維持セットが徹底して分離されていることの証左です。
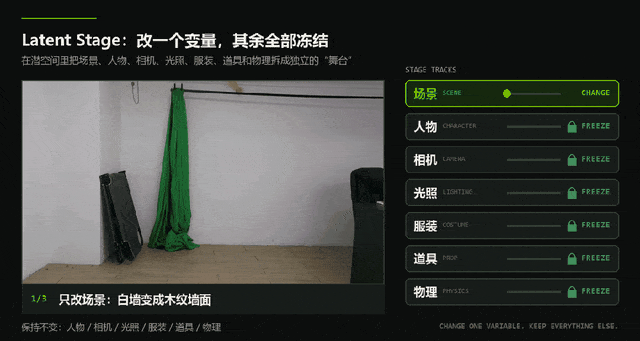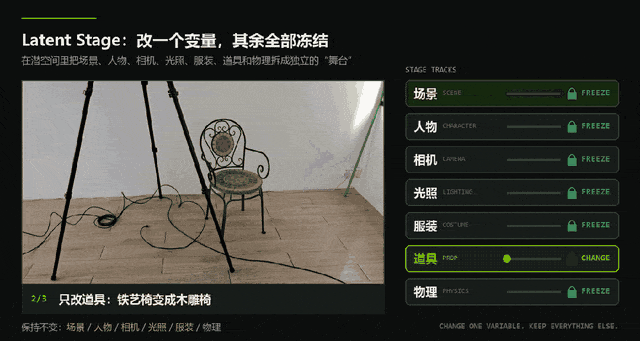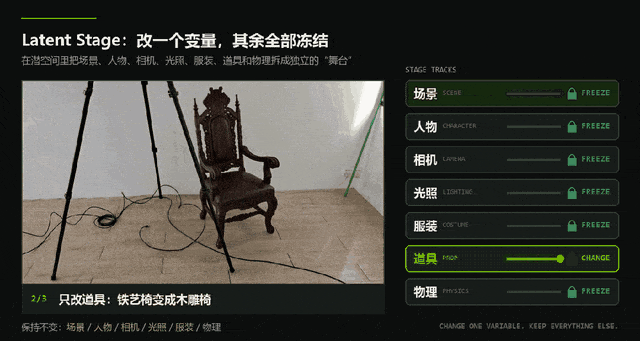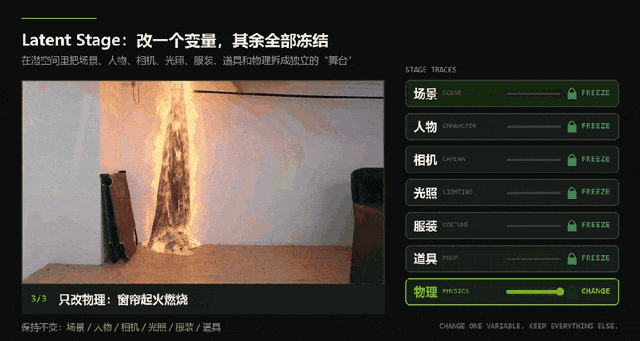
2つ目は、非線形動画マトリクスです。
達瓦科技は非線形視点マトリクス融合手法を提案し、映像を「線形な時間の流れ」から「多次元の編集可能マトリクス」へと変換しました。キャラクター、環境、カメラ、照明、オブジェクト、モーションが再結合可能な視覚要素へと分解されることで、コントロール層はカメラワークを正確に理解し、仮想と現実のシームレスな融合を実現できます。
関連する技術論文『NVD: Non-Linear View Matrix Fusion for 2D Video Using Multimodal Foundation Models』は ACM UbiComp / ISWC 2026 に採択され、10月13日に上海国際会議センターで発表されました。この成果は、達瓦 AIGC 研究院が香港理工大学、イリノイ大学アーバナ・シャンペーン校、ニューカッスル大学と共同で成し遂げたものです。
3つ目は、長期的な世界記憶(World Memory)です。
World Memory モジュールは過去の状態スライスを永続的にキャッシュし、後続の生成に向けていつでも検索・更新可能なコンテキストを提供します。
カメラが別の場所を映した後に再び元のエリアへ戻った際、モデルは何もないところから壁を再生成するのではなく、該当エリアの過去の状態レコードを優先して読み込みます。
達瓦科技は、長期的な時系列メモリを現時点で最も重要な課題と捉えています。人物のアイデンティティ、空間ジオメトリ、物理的因果関係、物語の状態は、時間をまたいでも高度に整合性を保ち続けなければなりません。
同チームは、「因果関係に基づく記憶メカニズムがなければ、コンピュートリソース(計算カード)をいくら積み増しても根本的な解決にはならない」と指摘しています。
4つ目は、物理法則によるハードな制約です。
Neural Physics は剛体、布地、流体、パーティクルシステムをカバーし、衝突と重力をコアとして生成の制約条件を構築します。炎が広がる境界や、布地が力を受けて変形する軌道を厳密に制限します。そして Neural Renderer がジオメトリ形状、マテリアル属性、環境光を最終的な画面へとデコードします。
これにより、物理状態が生成・トレーニング・評価システムの統一基準となり、単に動画のピクセルをフィッティングするだけの限界を克服しました。
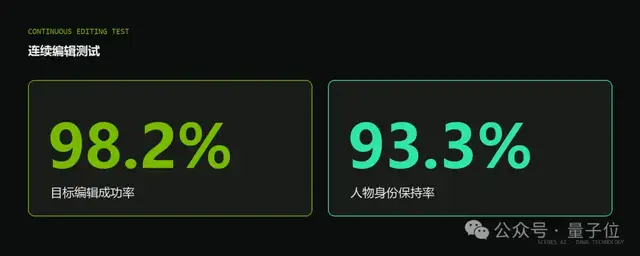
連続編集の評価実験において、Scenes AI は 98.2% のターゲット編集成功率と、93.3% の人物アイデンティティ一貫性維持率を達成しています。
リアルタイムレンダリング:コンピュートリソースを変化領域にピンポイントで集中
レンダリング層は、同社のリアルタイム生成モデル LiveStage が主導しており、その克服すべき目標は極めて明確です。
単一のコンシューマー向けグラフィックスカードの計算性能および VRAM 制約下で、人間の動きに追従した画面を低遅延かつ継続的・安定的にリアルタイム出力することです。
1. スパース拡散自己回帰(Sparse Diffusion Autoregressive)
自己回帰メカニズムによって時間軸に沿った連続的な画面推移を保証し、スパース計算によってステップごとの更新範囲を厳密に制限します。これは、モデルが予測するコアが「ゼロからの新しい画面全体の生成」ではなく、「状態の増分」であることを意味します。
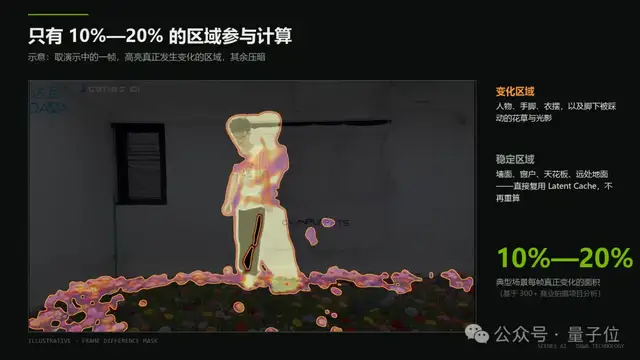
300件以上の商用実写案件の詳細な分析に基づき、達瓦科技は典型的なシーンにおいて各フレームで本質的な変化が起きている領域は画面全体のわずか 10%〜20% にすぎないことを突き止めました。
そのため、壁面や地面といった静止した背景は潜在空間キャッシュ(Latent Cache)を介して直接再利用され、システムの計算リソースを人物の主体、表情、手の動き、衣服の布地、煙の揺らめき、光影のグラデーションといったコアなインタラクション領域に高度に集中させることができます。
2. 因果的スパース・マイクロ拡散(Causal Sparse Micro-Diffusion)
レンダリング層はコントロール層から送られてくる一連の条件パラメータ(イベントタイプ、空間座標、速度、作用強度、対象のアイデンティティ、マテリアル属性、局所的な履歴など)を受け取り、変化した領域に対してのみ少ないステップ数でサンプリング推論を実行します。その後、その局所的な出力をグローバルなワールド画面へと高精度に合成します。
- 因果的(Causal):各ステップの計算が既存の履歴情報のみに厳密に依存するように設計されており、ストリーミング動画出力の要件に自然に合致します。
- マイクロ拡散(Micro-Diffusion):1回のイテレーションで局所的な極小領域のみにフォーカスするため、全画面・全量の拡散プロセスによる膨大なオーバーヘッドを回避できます。
3. 動的スパース活性化(Dynamic Sparse Activation)
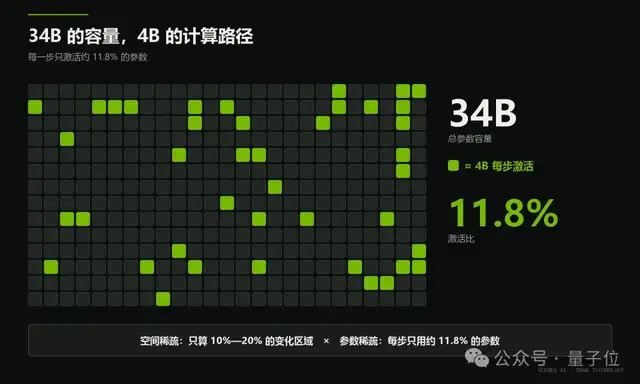
モデルの総パラメータ数は 34B(340億)ですが、実際の推論ステップごとに動的にアクティブ化されるのは約 4B パラメータのみで、活性化率はわずか約 11.8% です。
空間次元の局所更新によって「計算量の上限」を引き下げ、モデル内部のスパース活性化によって「1回の推論における計算負荷」を厳密にコントロールします。この両者が協調することで、**「大規模モデルの表現容量を持ちながら、リアルタイム級の計算パスを両立する」**という技術的優位性を生み出しています。
これら3つの技術の相乗効果により、従来の動画拡散モデルのアプローチと比較して、Scenes AI は GPU リソース消費を 40%〜60% 削減し、推論速度を 3〜5 倍に向上させました。
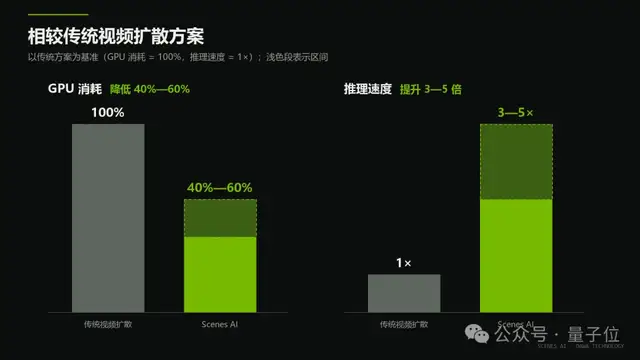
部屋全体が完全に夏の草原へ切り替わるといった、変化面積が20%を大幅に超えるような全画面のトランジションが発生する極端なケースでも、システムは変化の範囲に応じて計算リソースを動的に割り当てることができます。これにより、部分的な精密編集とフルビューの変換を単一のコンピュートパイプライン内でシームレスに両立させています。
結果として、1枚のコンシューマー向け NVIDIA GeForce RTX グラフィックスカード上で、Scenes AI は 720p / 25fps の低遅延リアルタイムレンダリング出力を安定して実現しました。
NVIDIA の低レイヤー技術スタック上にネイティブ構築
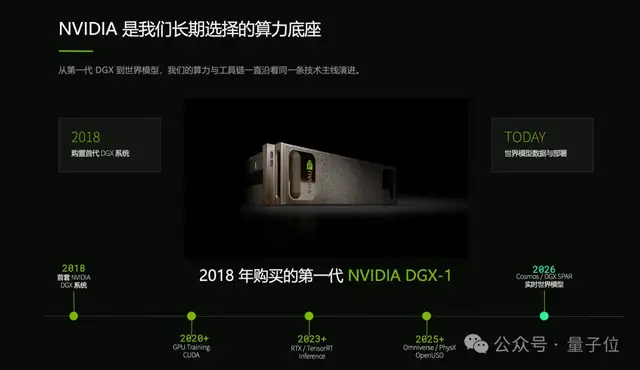
達瓦科技と NVIDIA とのコア技術における協力は、同社が初代 NVIDIA DGX-1 システムを導入した2018年にまで遡ります。
現在、Scenes AI はモデルのトレーニングと推論加速において CUDA を全面的に活用し、TensorRT を用いて極限のオペレーターレベル推論最適化を行い、NVENC ハードウェアモジュールと連携して超低遅延のリアルタイム動画エンコードおよび出力を実現しています。
スパース更新が無駄な計算リソース消費を抑え、Latent Cache が VRAM の再利用率を飛躍的に高め、階層化されたアーキテクチャは異種分散デプロイにも適しています。この技術体系全体が、アーキテクチャの根底から GPU の並列処理とコンピュートの再利用ロジックに完全最適化されています。
コアとなる参入障壁:Video Dataset ではなく State Dataset
アルゴリズムのフレームワークが整理された後、真のエンジニアリング実装のハードルとなるのはトレーニングデータの構築です。この領域における達瓦科技の技術蓄積は、主に3つのレイヤーで構成されています。
第1層:全次元状態データセット
モデルに「世界がどう変化するか」を真に学習させるには、動画のピクセル情報だけに依存していては到底不十分です。
インターネット上を流通する大半の動画は編集・合成済みの完成品であり、カメラの移動軌跡、ライティング設計、小道具とのインタラクションの詳細といった根本的な物理的因果データはすでに切り捨てられています。単一のピクセル情報から物理世界の推移ロジックを完全に説明することはできません。
これに対し、達瓦科技の技術理念は明確です。ワールドモデルの学習に必要なのは、単なる動画データセット(Video Dataset)ではなく、因果属性を備えた状態データセット(State Dataset)であるという考えです。
現在、達瓦科技は重慶市永川区において、敷地面積 8.4 万平方メートルに及ぶフルプロセスのデジタルハイテクスタジオを運営しています。
過去5年間にわたり、チームは300件以上の実際の商用撮影プロジェクトから継続的にデータを収集・アノテーション・体系化し、カメラ軌跡、モーション軌跡、オブジェクト状態、照明状態、物理状態、ナラティブ(物語)状態の6つのコア次元を網羅する、約 180TB の高品質な構造化世界状態データセットを蓄積してきました。
スタジオでの1回の撮影において、システムは300次元以上の精細な構造化アノテーションを実施し、レンズの光学特性、空間ジオメトリ、役者の演技、モーションデータを同一の時間軸上に厳密にアライメント(同期)させます。
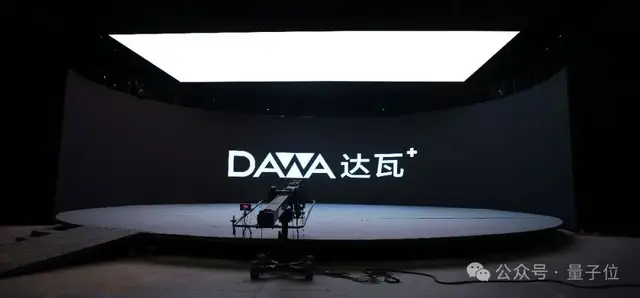
同時に、プロ仕様のスタジオ環境は、幅広の袖や複雑なスカートの裾の物理力学的な追従効果など、リアルタイム生成の領域で最も難易度が高いロングテールなシーンのサンプルを自然と蓄積できる環境となっています。