
本記事は、第1弾のブログ記事『エージェントは完了したと言うが、データベースは同意しない』の続編です。ThinkingBox-Training は GitHub にて現在オープンソースとして公開されています。
私たちは、最終的なデータベースの状態を期待される結果と比較することで、エージェント(Agent)のパフォーマンスを評価する ThinkingBox を構築しました。その後、ThinkingBox-Bench 外のトレーニングタスクにおいて、この実行可能なシグナルを報酬関数として利用しました。Qwen3.8-27B において、50 の GRPO ステップのトレーニングを実施した結果、平均成功率は 51.70% から 60.78% に向上し、全 20 回の試行すべてで正しく完了できたタスク数は 38 件から 107 件へと急増しました。
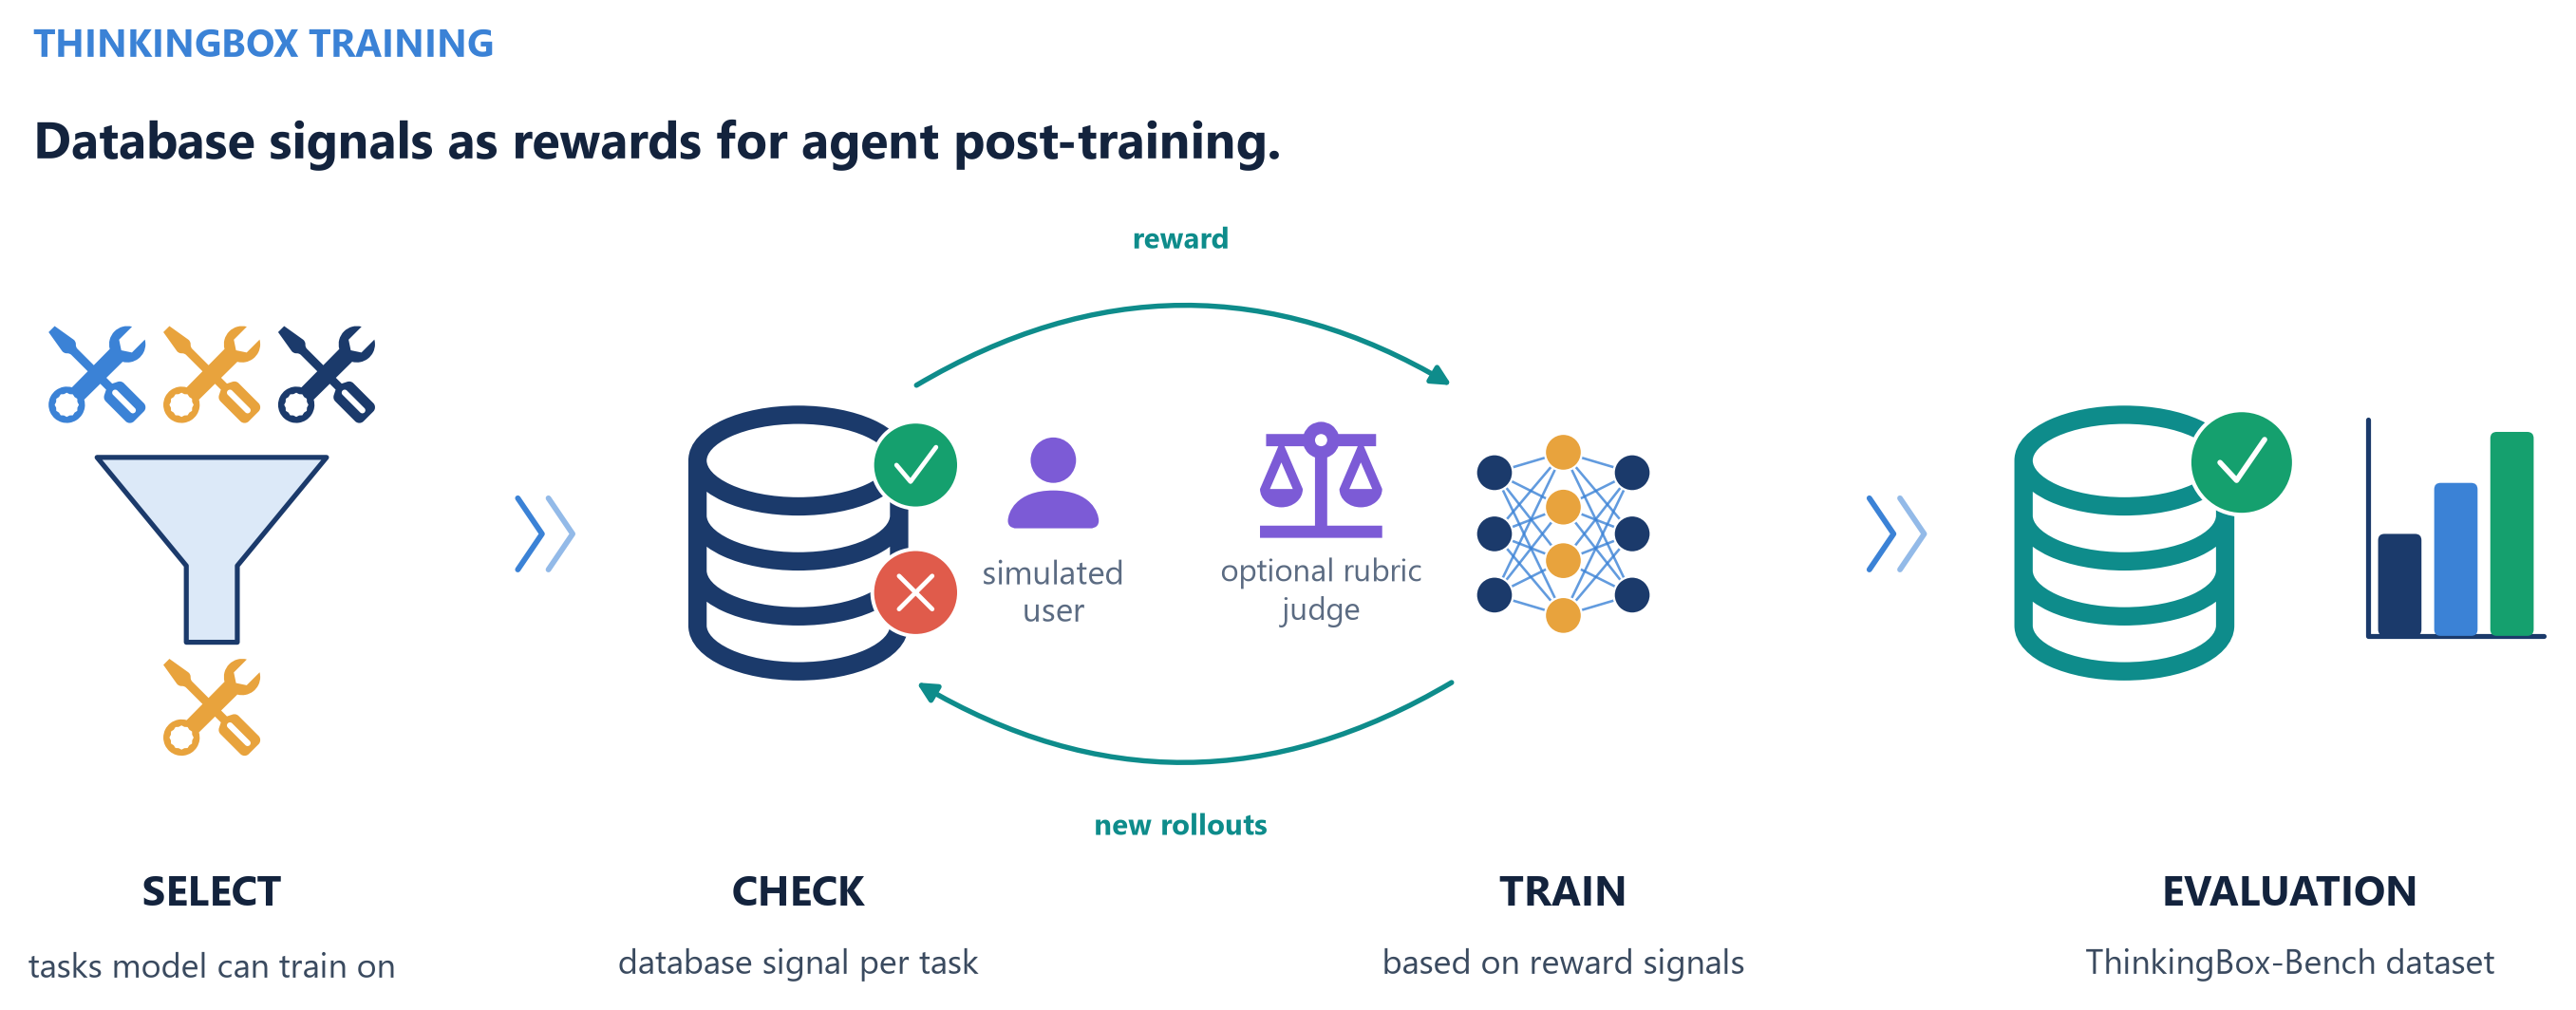
図 1. ThinkingBox は最終的なデータベース状態に対するプログラムによる検証を報酬へと変換し、ThinkingBox-Bench 外のタスクでエージェントを事後学習(post-training)させるために活用します。
本記事はマイクロソフトと Hugging Face による共同執筆です。共同執筆およびレビューに貢献してくださったマイクロソフトの Mirco Milletari 氏と Xiang Jiang 氏、Hugging Face の Sergio Paniego 氏、そして元インターンの Zhuochun Li 氏(ピッツバーグ大学)に深く感謝いたします。
ThinkingBox を構築した当初の目的は、タスクを完了したと主張しながらも実際には完了していないエージェントを特定することでした。
ベンチマークデータセット「ThinkingBox-Bench」に含まれる全 507 件のタスクでは、各タスクでエージェントに本物のバックエンドと一連のツールが割り当てられ、自由に操作させた上で、データベースに実際にどのような変更が加えられたかを検証します。第1弾の記事では、モデルがカスタマーチケットを解決済み(resolved)とマークしたものの、背後にある配送業者の例外ステータスはオープンのまま(open)だった事例を取り上げました。一見すると 9 回の正常なツール呼び出しが行われていたものの、最終的には誤ったデータベースレコードが 1 行書き込まれていたのです。
その後、私たちは自ら構築したシステムの可能性に気づきました。大半のタスクにおいて、最終的なデータベース状態に対してプログラムによる検証を実行すれば、そのまま 1 または 0 を返すことができます。これは単なるグレーダー(grader)にとどまらず、報酬関数(reward function)としても機能するのです。
そこで私たちは、ベンチマーク外の ThinkingBox 準拠タスクを用いてトレーニングセットを構築し、その実行結果を報酬として利用しました。ここでの課題は、エージェントのトレーニングにどのタスクを選ぶべきかという点でした。多くのタスクはモデルがすでに簡単に解決できるか、あるいは現在のモデルの能力では到底歯が立たないかのどちらかであり、どちらもモデルに効果的な学習をもたらしません。
難易度はポリシーに対して相対的(policy-relative)です。あるタスクが現在の…