
2026年10月21日公開
Qwen や Gemma などの汎用オープンソースモデルをファインチューニングして特定ドメインやタスクに特化させたモデルは、多岐にわたるドメインや汎用ユースケース向けに構築されたボキャブラリをそのまま引き継ぎます。
私たちの本番環境で稼働している作文採点システムでは、このボキャブラリのせいで、モデルが最も頻繁に出力するテキストが過剰な数のトークンへと細分化されていました。本記事では、近く発表予定の VocabX の論文から一部の成果を先行公開します。トークンの出現頻度ではなく「トークンごとのコスト」を軸にボキャブラリを特化・カスタマイズし、ベースモデルを変更することなく、実測推論コストを 77% 削減した手法をご紹介します。
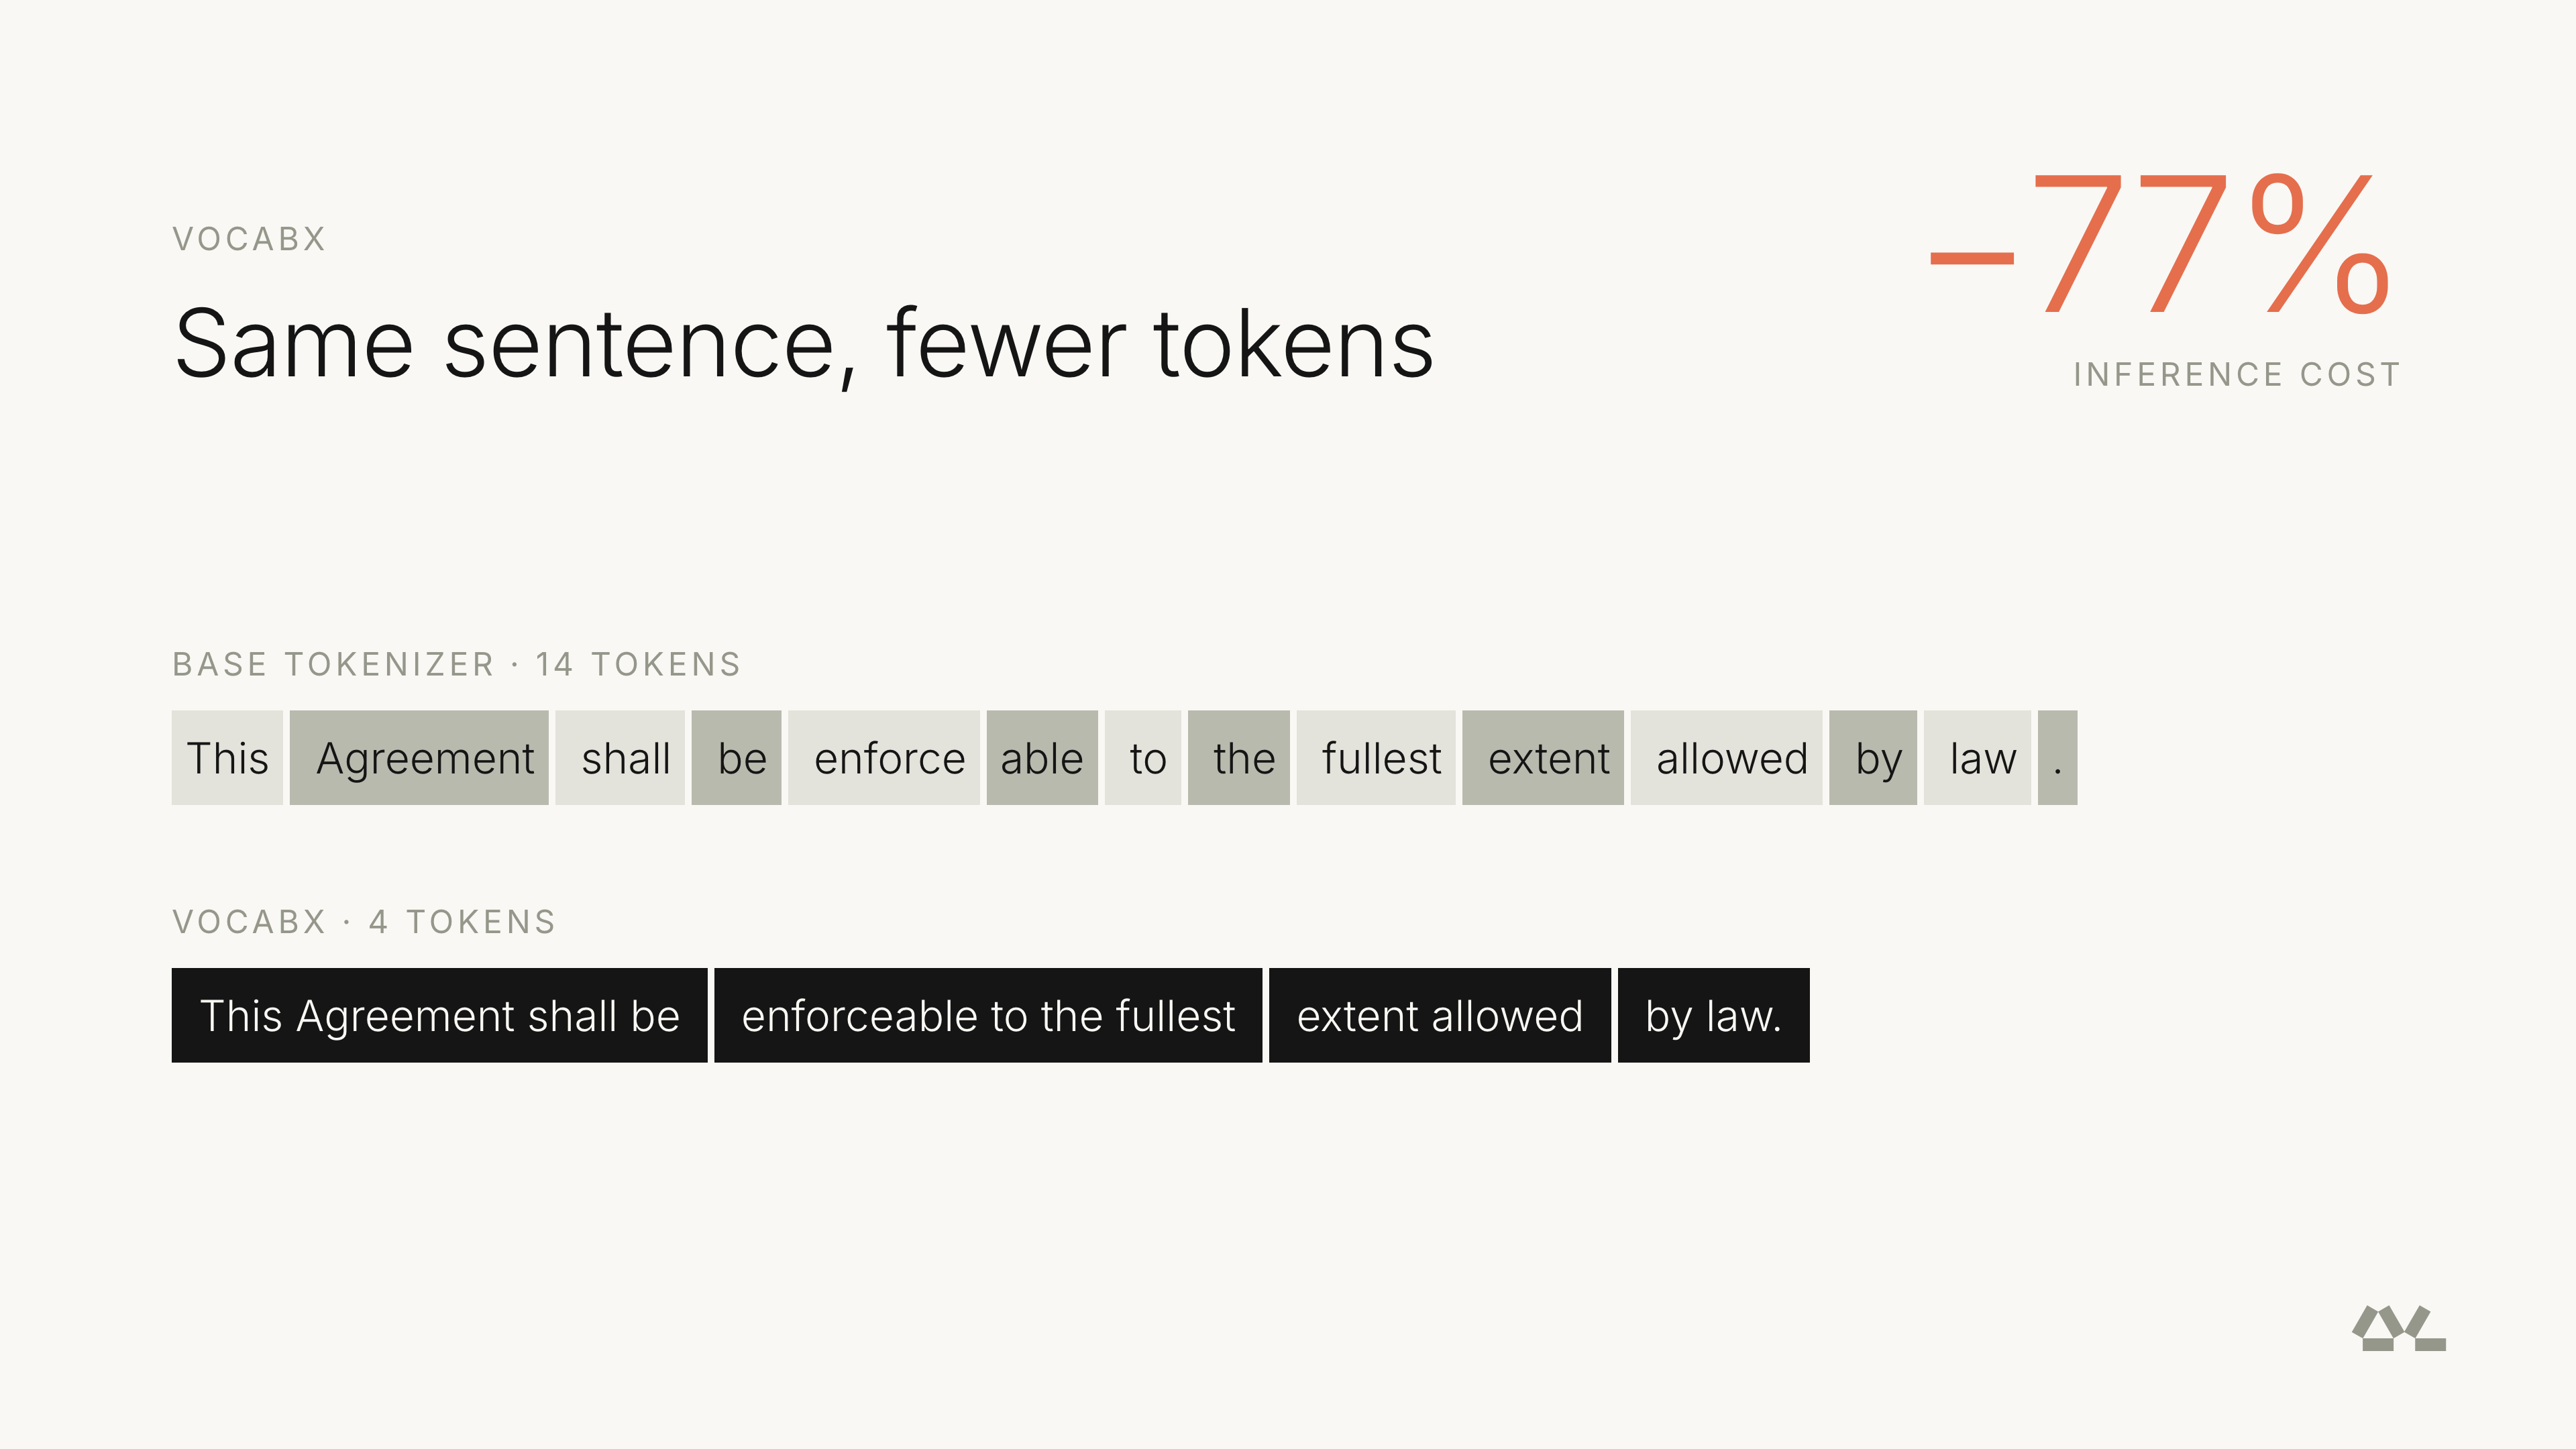
トークナイザー(tokenizer)は通常、ベースモデルの固定的な属性と見なされ、そのまま継承されて維持されることが大半です。しかし、特定ドメインに特化したモデルにおいては、トークナイザーこそがコストに最も大きな影響を与える調整レバーの1つとなり得ます。それにもかかわらず、学習ステップが始まるよりはるか前の段階ですでに決定づけられてしまっているのです。
私たちが本番環境で運用しているシステムの1つに、Qwen3-4B をベースに構築されたポルトガル語の作文自動採点システムがあります。このシステムは作文、プロンプト、参考資料を入力として受け取り、評価軸ごとの採点結果とフィードバックを含む JSON 形式の評価を出力します。
このモデルはそもそもサイズが小さく(パラメータ数 40 億 / 4B)、本タスク専用に学習されています。しかしトークナイザーは、多言語かつ膨大な種類のテキスト向けに構築された Qwen3-4B のオリジナルのものをそのまま引き継いでいました。この採点システムにおいては、対象は単一の言語(ポルトガル語)かつ単一のレスポンスフォーマットに過ぎません。その結果、二重のコスト増が発生していました。採点システムがリクエストごとに生成するテキストで不必要に多くのトークンを消費してしまうこと、そしてトークンを1つ生成するたびに、このタスクではほとんど使われない語彙を大量に含んだ 151,669 エントリものボキャブラリに対してスコア計算を行わなければならないことです。
私たちは、元のベースモデル、データ、学習レシピはそのまま維持しつつ、「VocabX」と呼ばれる手法を用いてこのボキャブラリを再構築しました。なお、本記事に掲載しているデータは現在査読中の論文版からの引用であり、正式発表までに変更される可能性があります。
すべての人のために作られたボキャブラリ
主要な言語モデルはすべてトークン単位で読み書きを行い、テキストをどのようにトークンへ変換するかはトークナイザーによって決まります。主流の汎用モデルのトークナイザーは、ソースコードから契約書、中国語に至るまで、多岐にわたるドメインや言語を網羅した大規模なテキストコーパスに基づいて学習されています。汎用モデルにとって、このアプローチは合理的です。
しかし、単一ドメインに特化したモデルにおいては、これが2つの無駄を生み出すことになります。