
ウサギの皮を被った正体は、なんと MiniMax だった!
国慶節の連休中、OpenRouter に突如出現し、匿名ながらランキングを席巻した謎のモデル Space Bunny(玉兎)。その覆面がついに剥がされた。
ウサギの着ぐるみを脱いだその正体は、なんと MiniMax だった!
正式にリリースされたモデル名は M3.1 Flash だ。
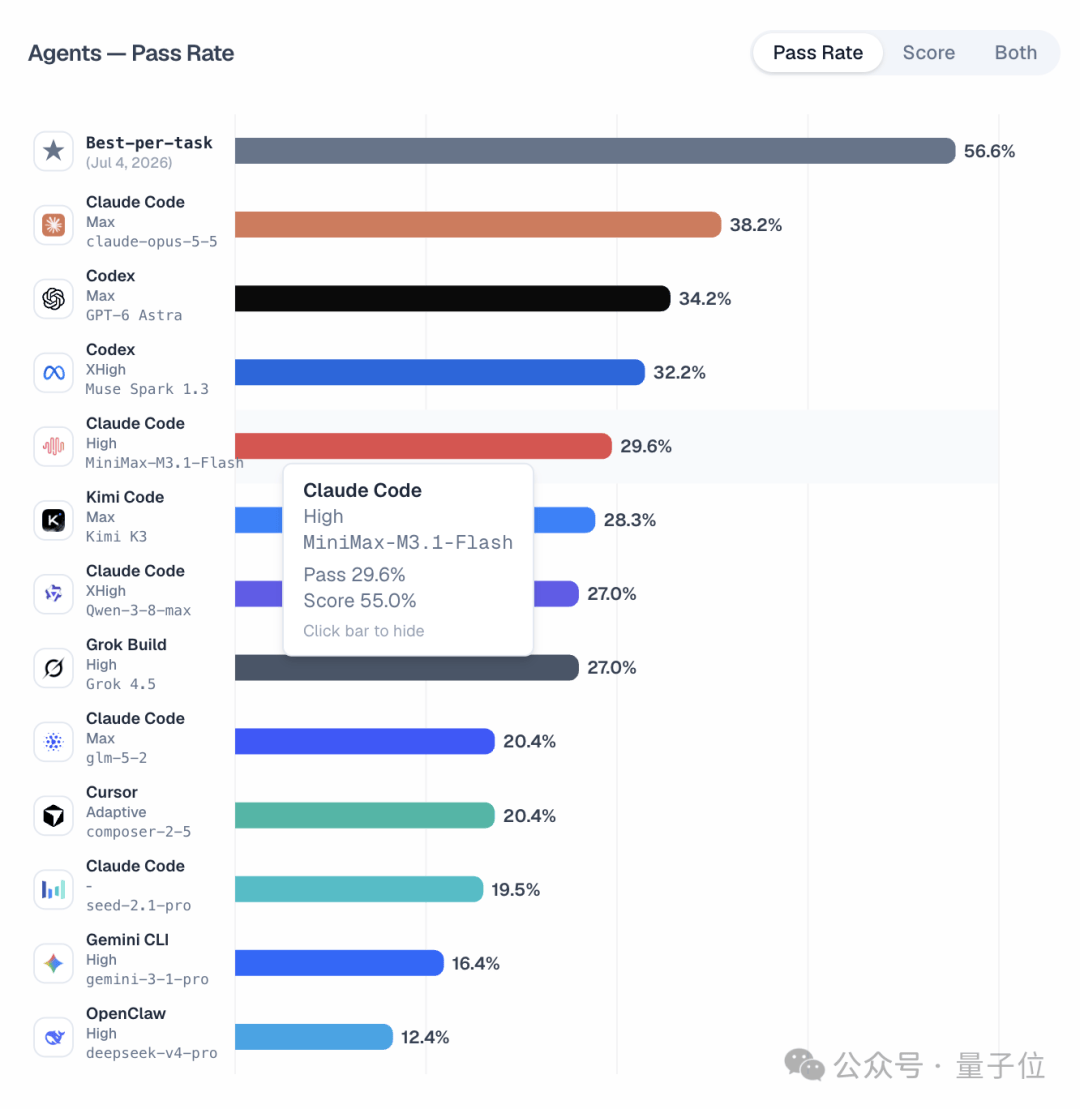
そしてこの正式版のベンチマークスコアは、Space Bunny 時代をさらに上回り、特にエージェント(Agent)能力において目覚ましい進化を遂げている。
Agents’ Last Exam(ALE)では 29.6% のスコアを叩き出し、中国産モデルとして首位を獲得した。
AA ランキングでも 43 点を記録。Flash クラスの軽量モデルとしては極めて際立った成績だ。
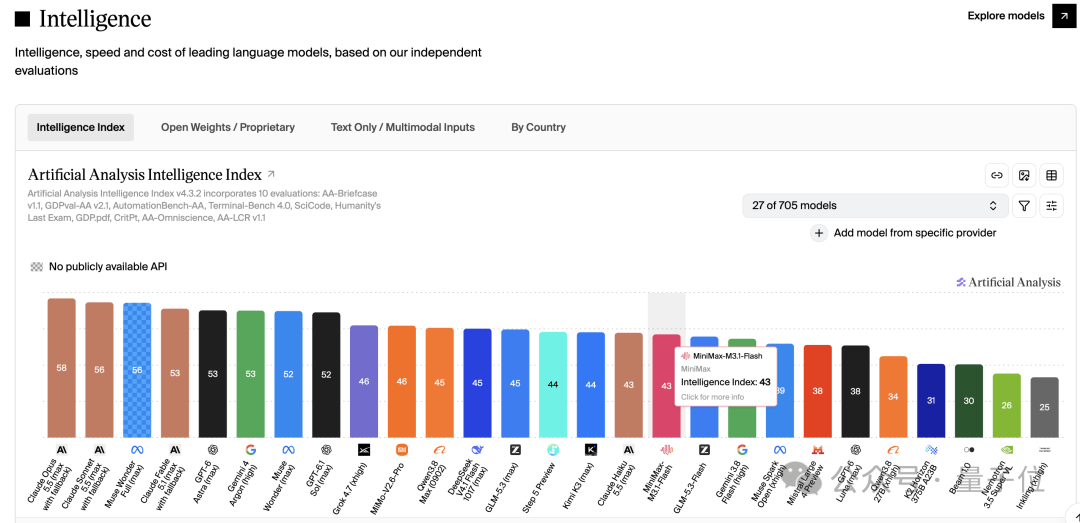
総合的なタスク実行能力が大幅に向上しており、まさに「超優秀な実務ワーカー」へと昇格したと言える。
それだけでなく、コーディング、サイバーセキュリティ、Computer Use といった領域でも、軒並み世界のトップ集団入りを果たした。
その上、「玉兎」時代から定評のあった超高速な推論性能は健在で、出力ピーク速度は 200+ TPS に達する。
さらに重要なのは——
さすがは Flash シリーズ、価格が極めてリーズナブルであることだ:
- 入力は 100 万トークンあたりわずか 1 元
- 出力は 100 万トークンあたりわずか 4 元
- キャッシュ読み取りは 100 万トークンあたりわずか 0.1 元
総合的な利用コストは、前世代の M3 と比較して一気に 30% にまで抑え込まれた。
この価格がどれほど破格かピンとこないなら、一言で言えばこうだ:
オフピーク時の V4.1 Flash とほぼ同等である。
あまりにも良心的で、まさに「暇なときは梁文谷、忙しいときは闫俊峰」(冗談はさておき)といったところだ。
△ 画像引用:@大厂显微镜
一方、シリコンバレーのプロプライエタリ(クローズドソース)陣営は、またしても新たなプレッシャーに晒されることになりそうだ。
DeepSeek に続き、シリコンバレーの大規模パラメータを誇るフラッグシップモデルたちは、中国産 Flash モデルによって再び新たな「コストパフォーマンスの絶対防衛ライン」へと追い詰められている。
テキストモデルによる見事な雪辱
正直なところ、これまで MiniMax に対する外部からの評価には疑問の声も少なくなかった。
マルチモーダルや動画生成技術こそ目覚ましいものの、純粋なテキスト LLM 領域ではしばらく沈黙が続いていたように見えたからだ。
だが今回の M3.1 Flash の登場は、間違いなく見事なリベンジマッチとなった。
具体的なベンチマーク成績を見てみよう:
コードエンジニアリングと実践的なバグ修正
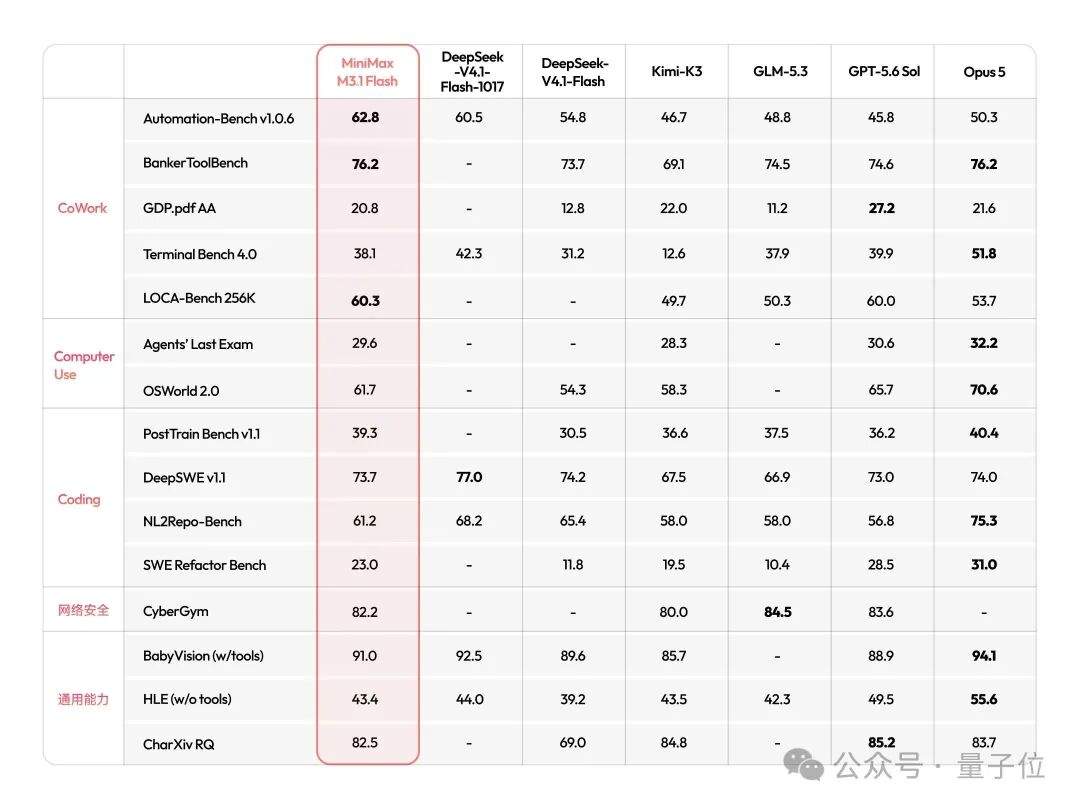
DeepSWE v1.1 の評価において、M3.1 Flash は 73.7% のハイスコアをマークした。
GPT-6.1 Sol、Claude Opus 5、Claude Fable 5 といった名だたるフラッグシップモデルが、この Flash モデルにスコアで逆転を許している。
これを上回っているのは、DeepSeek V4.1 Flash 1017 の 77 点のみだ。
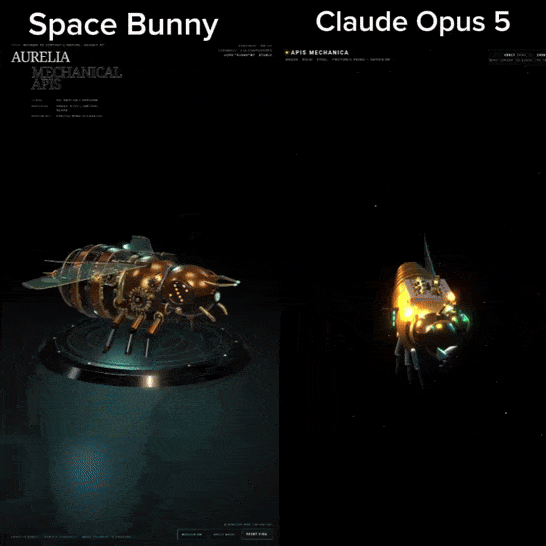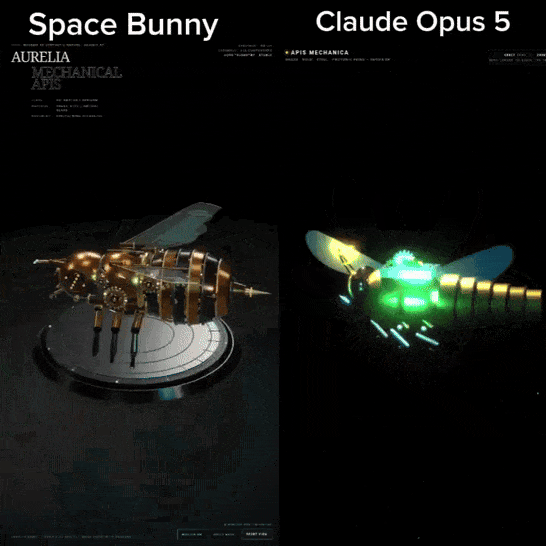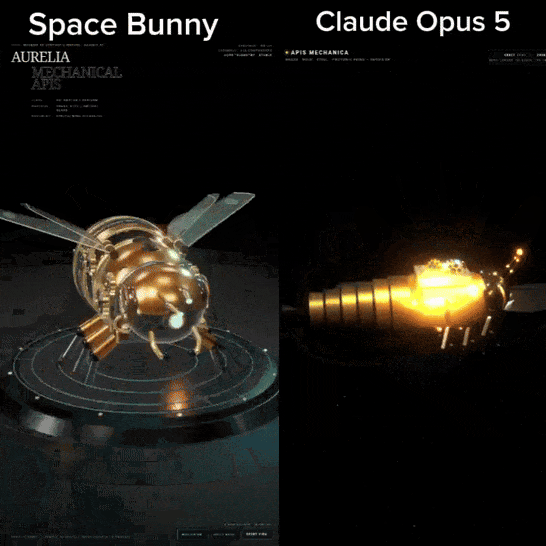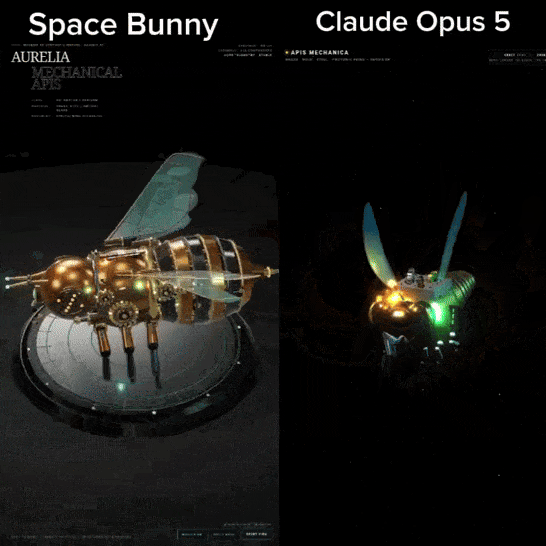
これは、かつて「玉兎」として匿名テストされていた頃のコミュニティの声とも合致する。Three.js などの 3D レンダリングや複雑なフロントエンドタスクにおいて、細部の制御が極めて正確だったのだ。
サイバーセキュリティの実践力
カリフォルニア大学バークレー校が主導する CyberGym ベンチマークでは、M3.1 Flash は 82.2 点を獲得。GLM-5.3(84.5 点)や GPT-5.6 Sol(83.6 点)に肉薄し、世界トップクラスの座を確固たるものにしている。
複雑な Agent とエンタープライズ向けマルチ SaaS ワークフロー
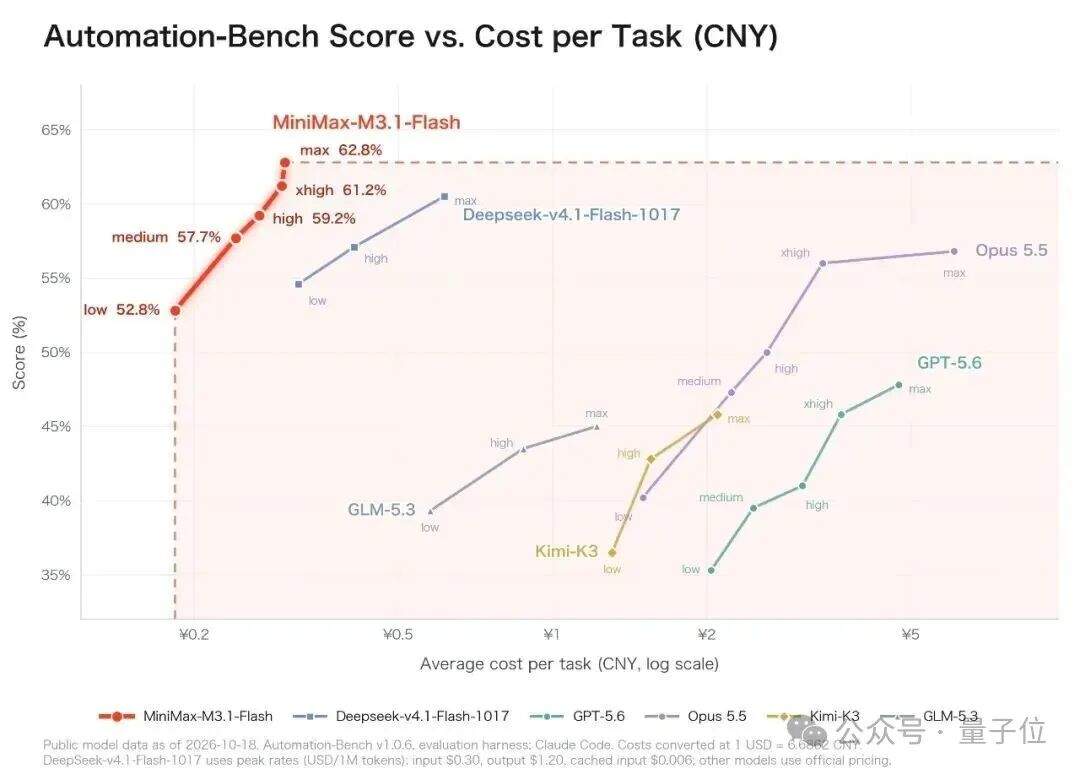
自動化プラットフォーム Zapier が公開した AutomationBench-AA のベンチマークでも、M3.1 Flash はトップクラスにランクインした。
1 タスクあたり 0.05 ドル未満という低コストでありながら、セールス、マーケティング、カスタマーサポート、財務、人事(HR)を横断する複雑なワークフローを自律的に連携・処理できる。
エラーの許容度が極めてシビアな金融特化ベンチマーク「BankerToolBench」では、M3.1 Flash はなんと 76.2 点を獲得し、業界最高峰とされる Claude Opus 5 と並んで世界同率 1 位に輝いた。
Computer Use(デスクトップの自律操作)
実際の PC 操作をシミュレートする OSWorld V2 では 61.7 点を記録。
さらに実ビジネスシーンの価値を測る ALE 評価においても、M3.1 Flash は極めて低いタスクコストでトップフラッグシップ並みのパフォーマンスを発揮した。
どちらの成績も中国産モデルの中で 1 位を獲得し、圧倒的なコストパフォーマンスを改めて証明した。
MiniMax のテキストモデルがいずれ主役の座に返り咲くことは予想されていたものの、その大役を担ったのが「Flash」の名を冠した軽量モデルだとは、誰も予想していなかっただろう。
超高速・低価格こそが正義
単なるベンチマークのスコアを離れて見ると、真に注目すべきは、このモデルが実際の産業実装シナリオにもたらすインパクトだ。
マルチエージェント協調や長大なワークフローを構築する際、開発者が最も直面しやすいペインポイントが 2 つある。果てしないレイテンシ(待ち時間) と、月末に届く冷や汗ものの API 請求書 だ。
実用的なエンタープライズ向け Agent は、バックエンドで数十回ものツール呼び出しを行い、複数のサブエージェント間で頻繁に通信を行うケースが多い。
トークン生成速度が遅ければ、ローディング待ちに耐えかねたユーザーが離脱し、呼び出しコストが高すぎれば、予算超過でサービス運用そのものがストップしかねない。
M3.1 Flash の真価はまさにここにある。
その基盤には、極めてアグレッシブな Sparse Attention(スパース・アテンション)アーキテクチャ が採用されている。
オンライン推論速度は約 3 倍に向上し、出力のピーク速度は 200+ TPS、中央値(P50)でも 170+ TPS を安定してキープする。
170 TPS とは、何を意味するのか?
MiniMax Code デスクトップ版や Claude Code、各種ローカルコーディングツールでリファクタリングタスクを投げれば、コードはほぼ一瞬で画面上に展開される。
これまで 4 つのサブエージェントを連携させたときに生じていたもたつきは、今や違和感をほとんど感じないシームレスな対話体験へと進化した。
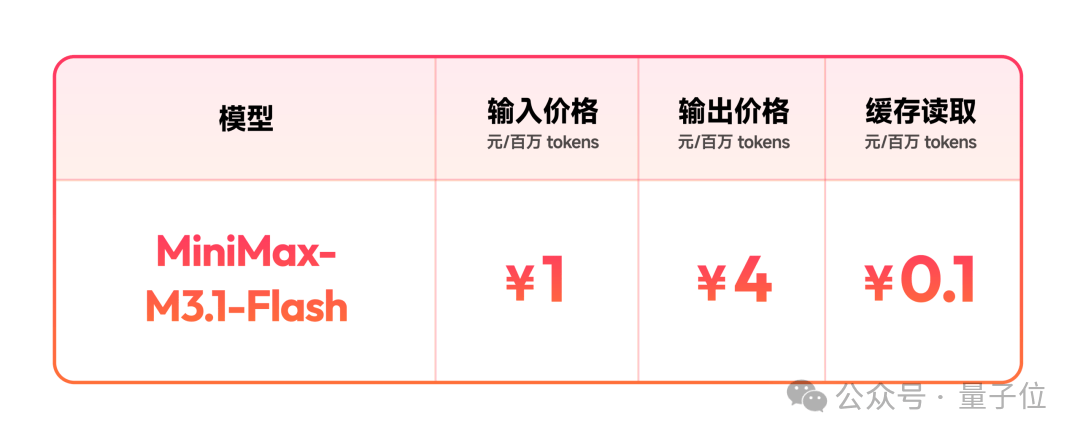
速度が向上した一方で、API の利用料金も大幅に引き下げられた:
- 入力料金:100 万トークンあたりわずか 1 元
- 出力料金:100 万トークンあたりわずか 4 元
- キャッシュ読み取り料金:100 万トークンあたりわずか 0.1 元
入力および出力コストは半減し、キャッシュ読み取り費用に至っては 75% もカットされた。
その結果、総合的な運用コストは前世代の M3 と比較して実に 70% 削減された。
開発者や企業にとって、大規模運用のハードルは劇的に引き下げられたのだ。
中国産ツインスターによる逆包囲網
これまで業界内では、「Flash モデルはフラッグシップ大規模モデルの低コストなダウングレード版にすぎない」という見方が一般的だった。
Flash を選ぶのは予算の都合か、あるいは軽量なタスクに限られ、クリティカルで複雑な本番シナリオでは、結局パラメータ数の大きい Pro クラスのフラッグシップに頼らざるを得ないと考えられていたのだ。
しかし今、その構図が崩れつつある。
DeepSeek V4.1 Flash 1017 が新たなコストパフォーマンスの基準を打ち立てた直後、MiniMax M3.1 Flash がそれに続き、2 つのモデルが立て続けに圧倒的なエネルギー効率と費用対効果を見せつけた。
小型モデルはもはや実験的な存在にとどまらず、数倍のパラメータと 10 倍の価格を持つフラッグシップモデルと真正面から渡り合える実力を備えている。
さらに興味深いのは、これら 2 つの中国産 Flash モデルが、見事なまでに補完し合う差別化路線を歩んでいる点だ:
- DeepSeek は純粋なコードエンジニアリング領域において、圧倒的なコストパフォーマンスを新たな次元へと引き上げた。
- MiniMax M3.1 Flash は、マルチ SaaS のエンタープライズワークフローや金融ツールチェーンの呼び出しなど、総合的な Agent 能力において明確な強みを発揮している。
一方はコードエンジニアリングに特化し、もう一方は複雑なビジネスプロセスを深耕する。
用途に応じて、柔軟なルーティング戦略をとることさえ可能だ:
負荷や時間帯に応じてモデルリソースを最適に割り振り、ピーク時は MiniMax、オフピーク時は DeepSeek を活用する ことで、トークンコストとシステム性能の最適解を実現できる。
このような活用パターンは、一般ユーザーにとっても API 利用がより高コスパな選択肢となる ことを後押ししている。
LLM の技術革新は目覚ましく速く、月額課金の一般向け(B2C)サービスであっても、モデルの急速な世代交代によって相対的なコストパフォーマンスが低下するリスクを常に孕んでいる。
さらに、B2C 向け製品には「5 時間の利用制限」「深夜のリセット」「負荷に応じた動的な性能低下(いわゆる“知能低下”)」といった体験上のペインポイントがつきものだ。
一方、API 利用へとシフトすれば、従量課金でチャージし、各社のモデルの性能に応じて柔軟に切り替えることができるため、むしろ圧倒的に自由度が高く快適な体験が得られる。
ここ最近、海外のメガテック企業が次々と新世代フラッグシップを発表し、市場には一時「LLM の競争は決着した、シリコンバレーがスケーリング則で総取りする」といった言説が溢れていた。
しかし、転換点は確かに訪れつつある。
2 つの中国産 Flash モデルが相次いで登場したことで、フラッグシップ級の能力が、超高速かつ手頃な価格で広く民主化されつつある。
頂点となる SOTA(最先端)を競い合うのも確かに激しい戦いだが、「コストパフォーマンス」と「エンジニアリングにおける実用性」が次々と克服された今、LLM の産業実装をめぐる真の戦いは、まさに火蓋を切ったばかりだ。
そして、エンジニアリングの実装と現場シナリオへの適応こそ、中国のテクノロジー企業が一貫して最も得意とする領域なのだ。