
2026年10月20日
スタートアップ
Terminal XのEval Agentは54の指標基準に基づいて出力を採点し、GPT‑6.1 Solのサポートにより、ファンドの投資マンデート(mandate)からの逸脱の検知率を25%向上させました。
企業規模:スタートアップ
地域:北米
業界:金融
製品:API
25%
次点モデルと比較して、エージェントの回答がファンドの投資マンデートを逸脱した際のGPT‑6.1 Solの検知率が25%向上
240万ドル
1社あたりの顧客がデューデリジェンスおよび投資ワークフローで実現した年間コスト削減額
+220ベーシスポイント
次点モデルと比較して、GPT‑6.1 Solを搭載したエージェントと人間のレビュアーとの一致率が220ベーシスポイント(bps)向上
30%
次点モデルと比較して、GPT‑6.1 Solのクエリあたりのコストを30%削減
投資ファンドの競争優位性は1件1件のディールによって蓄積されますが、各意思決定の背後にある判断力は、往々にしてごく一部のシニア投資家の頭の中にしか存在しません。彼らが退職してしまうと、ファンドはTerminal Xが言うところの「記憶負債(memory debt)」を背負うことになります。ドキュメントは残されていても、その背後にある推論ロジックが失われてしまうのです。
Terminal Xが開発したオペレーティングシステム「Capital Memory」は、この負債を解消するために設計されました。同社のフォワード・デプロイド・エンジニア(JPモルガンやブラックストーン出身の金融・投資のプロフェッショナル)がクライアントの投資チームに直接常駐し、ファンド固有のエージェントアーキテクチャ(agentic architecture)を設計。投資ロジックをコード化して顧客所有のエージェントへと定着させ、オンプレミスまたはプライベートクラウド環境にデプロイします。
これらのエージェントの推論には、GPT‑6.1 SolやGPT‑6 LunaなどのOpenAIモデルが活用されています。同時に、Terminal Xの「Eval Agent」がファンド独自の基準に基づいてエージェントの出力を評価・採点します。GPT‑6.1 Solを活用することで、Eval Agentがファンドの投資マンデートから逸脱した推奨を検知する精度は約25%向上し、同一のワークフローを実行する際のクエリあたりのコストは次点モデルと比べて約30%削減されました。
「GPT-6.1 Solの長大なコンテキスト推論能力とトークン効率性のおかげで、より深度のある評価パイプラインを構築できるようになりました。これにより、当社のEval Agentは投資判断を測定可能かつ監査可能なものにしています」
—— Hyun Hong氏(Terminal X 共同創業者兼CEO)
各ファンドのトップ投資家の推論ロジックを抽出し定着させる
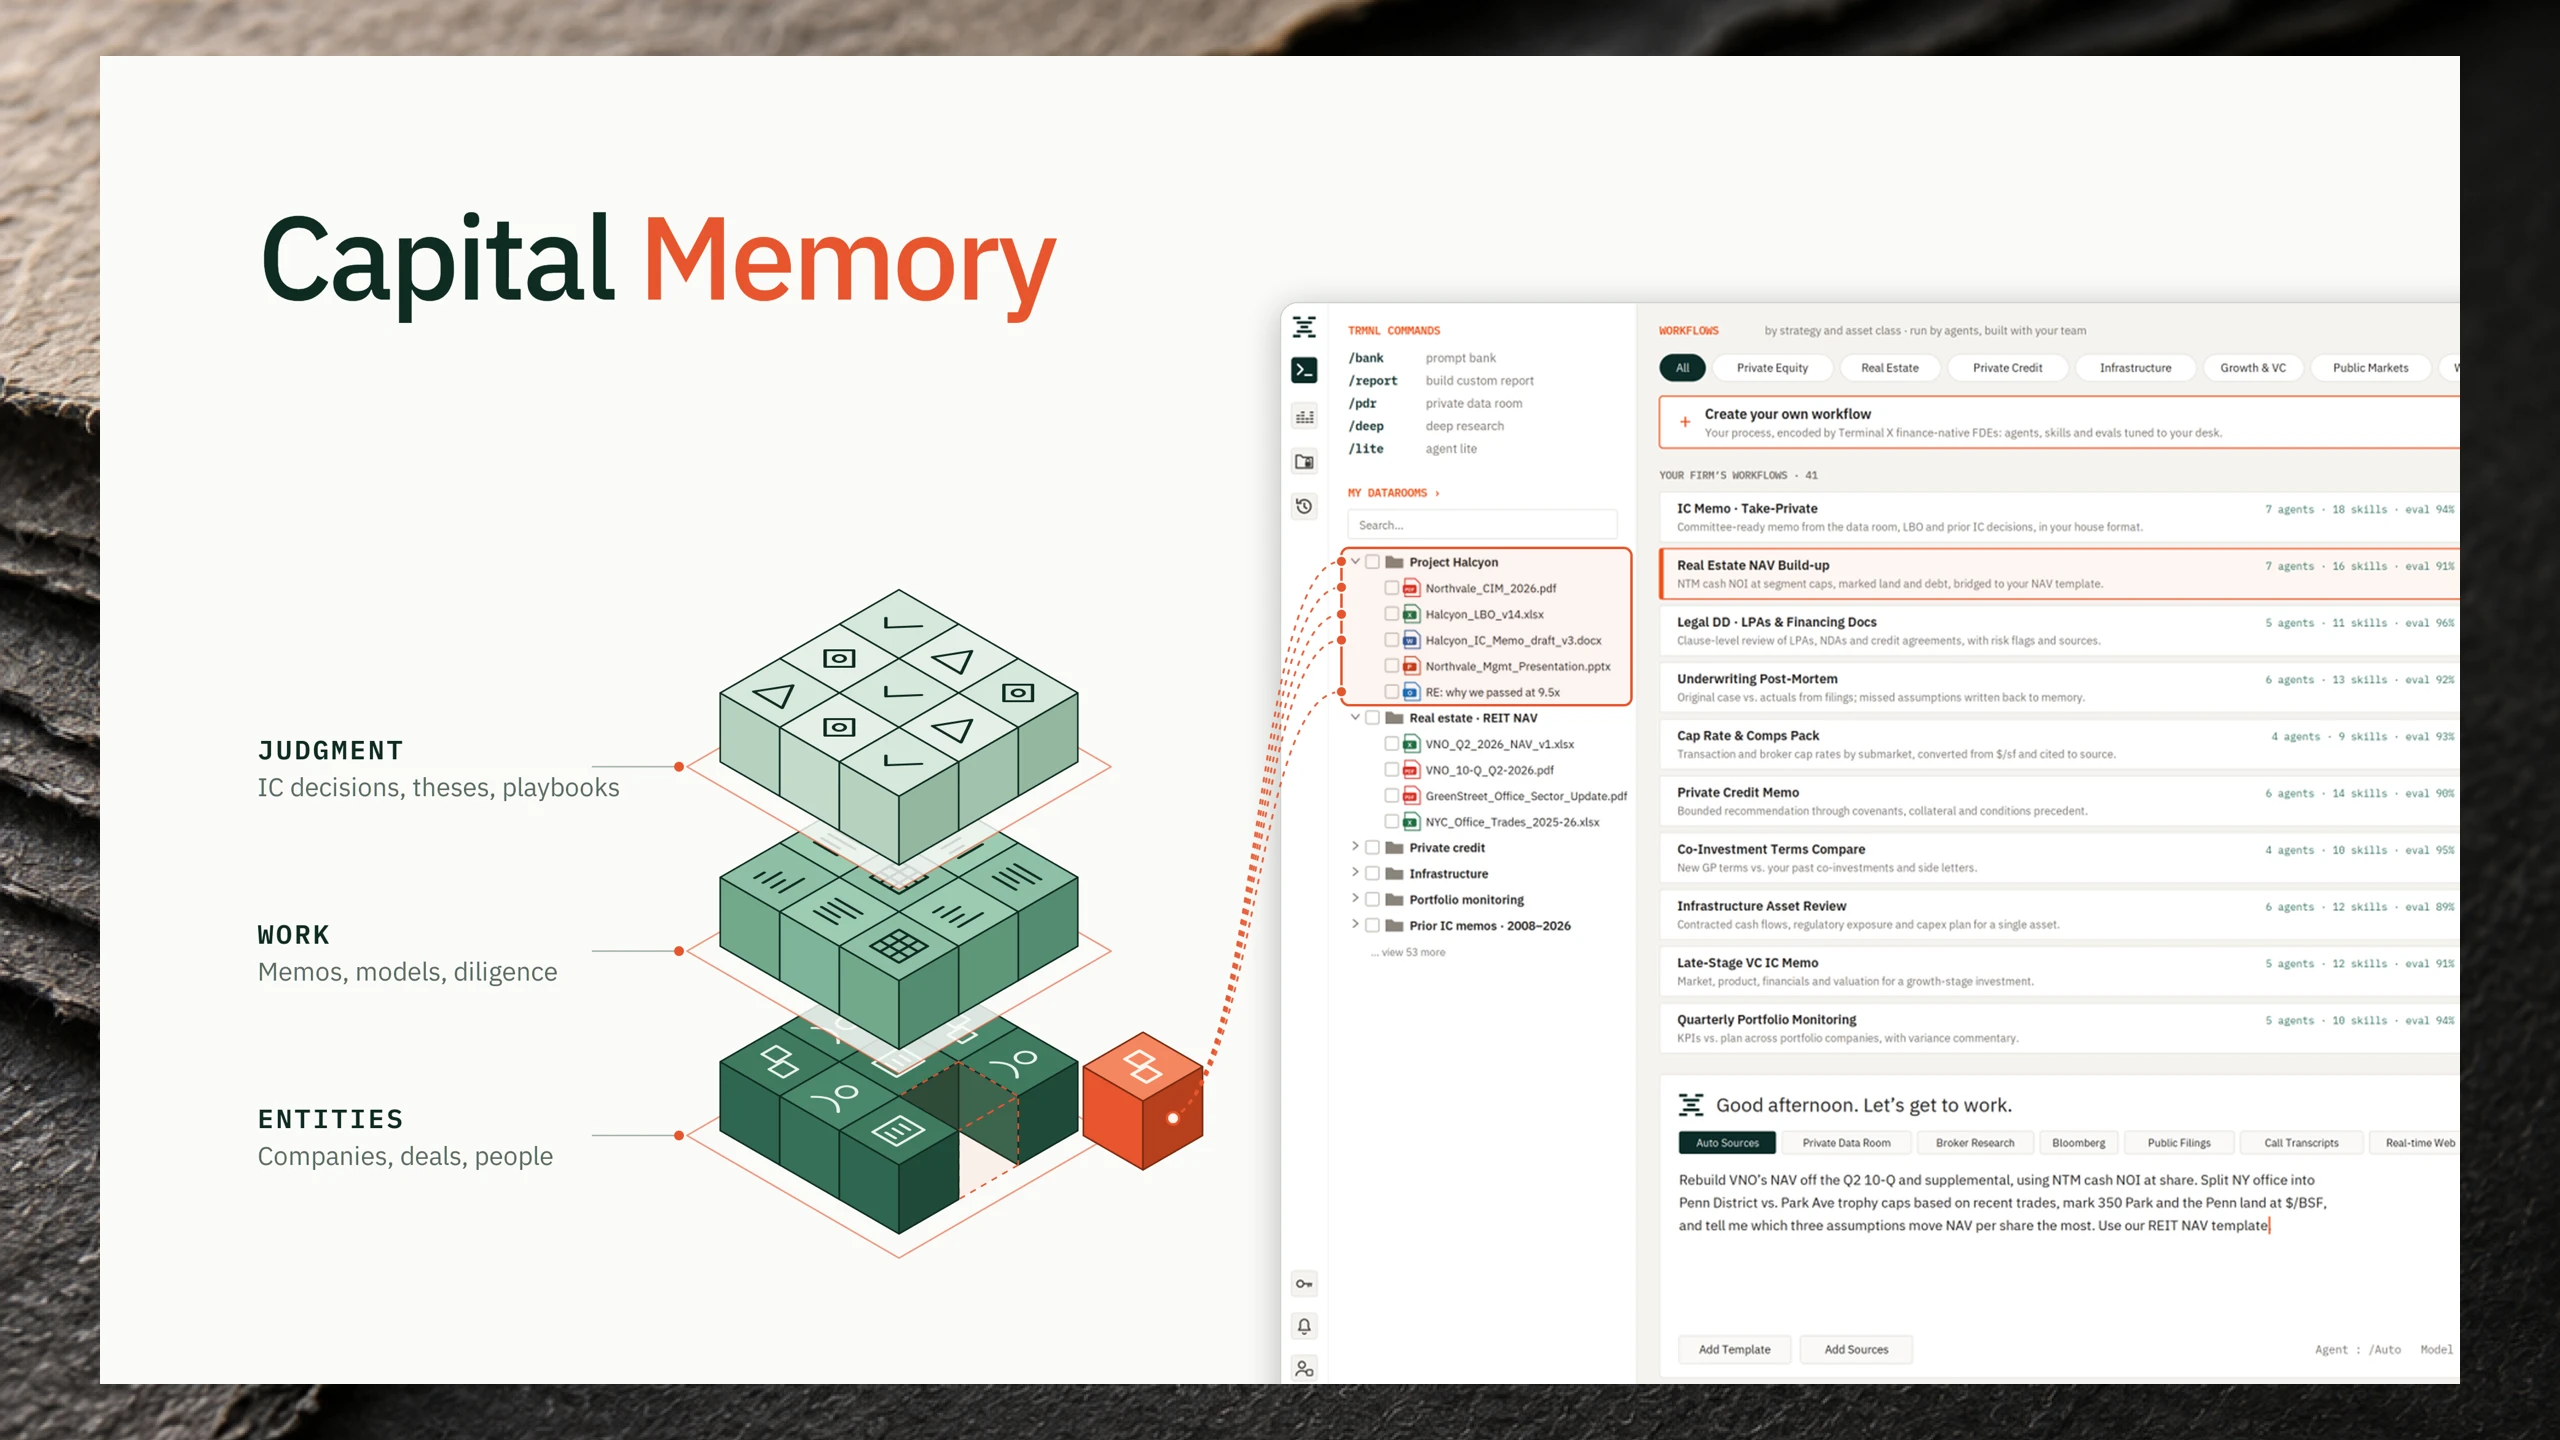
Terminal Xは顧客ごとに、そのファンドのトップ投資家のスタイルを再現する専用エージェントを構築します。エンジニアはクライアント先に数週間常駐し、社内で高く評価されている投資メモのリバースエンジニアリングを実施。これまで文書化されてこなかった暗黙のプロセス(例えば、クレジットチームがどのように借り手をスクリーニングするか、あるいは共同投資チームがメモ作成前にどのような情報ソースを参照するかなど)を抽出します。
その後、これらのプロセスはアセットクラスや戦略に合わせてカスタマイズされた数百ものエージェントに落とし込まれ、投資ステージごとにサブエージェントが配備されます。GPT‑6.1 Solは、高度な判断や巨大なコンテキストウィンドウを要するフェーズ(投資テーゼの骨子の抽出、主要な検討事項の特定、案件がファンドの投資マンデート要件に合致しているかの評価など)を担当します。一方、GPT‑6 Lunaは、推論の深さよりもトークンコストの効率性が重視される高スループットなタスクを担当します。
エージェントは、機密性の高い投資データの共有・管理専用の隔離環境である各社のプライベートデータルーム(private data room)内で稼働します。エージェントは英語、韓国語、日本語、中国語のドキュメントを処理でき、学習した内容を「ファンドの記憶(firm Memory)」として保存します。これは、過去の分析、投資委員会の決定、ワークフロー指針、ファンドの基本方針(house view)など、特定のチームがどのように意思決定を下してきたかを記録したバージョン管理付きのアーカイブです。
エンジニアはTerminal Xプラットフォーム上でこれらの「記憶」を再利用可能なワークフローへと変換します。本番環境では、すべてのクエリについて、実行されたステップ、参照された情報ソース、呼び出されたモデル、そして背後にある推論プロセスに至るまで、完全な監査証跡(オーディットトレイル)が保持されます。
Terminal Xのデータによると、このアプローチの導入によって顧客は大幅なコスト削減を実現しており、あるプライベートエクイティ企業では、デューデリジェンスおよび投資メモのワークフローを自動化することで年間240万ドルのコスト削減を達成したと報告されています。
Eval Agentによる出力の採点と継続的なシステム最適化
ファンド独自の基準に照らしてエージェントの回答を精査するため、Terminal Xは評価エージェント(Eval Agent)を構築しました。これはGPT‑6.1 Solおよびその他のOpenAIモデルでオーケストレーションされたワークフローであり、VP(バイスプレジデント)がアナリストの成果物をチェックするかのように、エージェントのあらゆる出力を綿密にレビューします。
Eval Agentは54の指標からなるルーブリック(評価基準)に基づいて各出力を検証します。検証項目には、「数値、類似企業データ(comps)、コンセンサス予想、引用内容が信頼できる情報源から取得されているか」「論理展開に破綻がないか」「投資推奨がファンドの基本方針(house view)と整合しているか」などが含まれます。
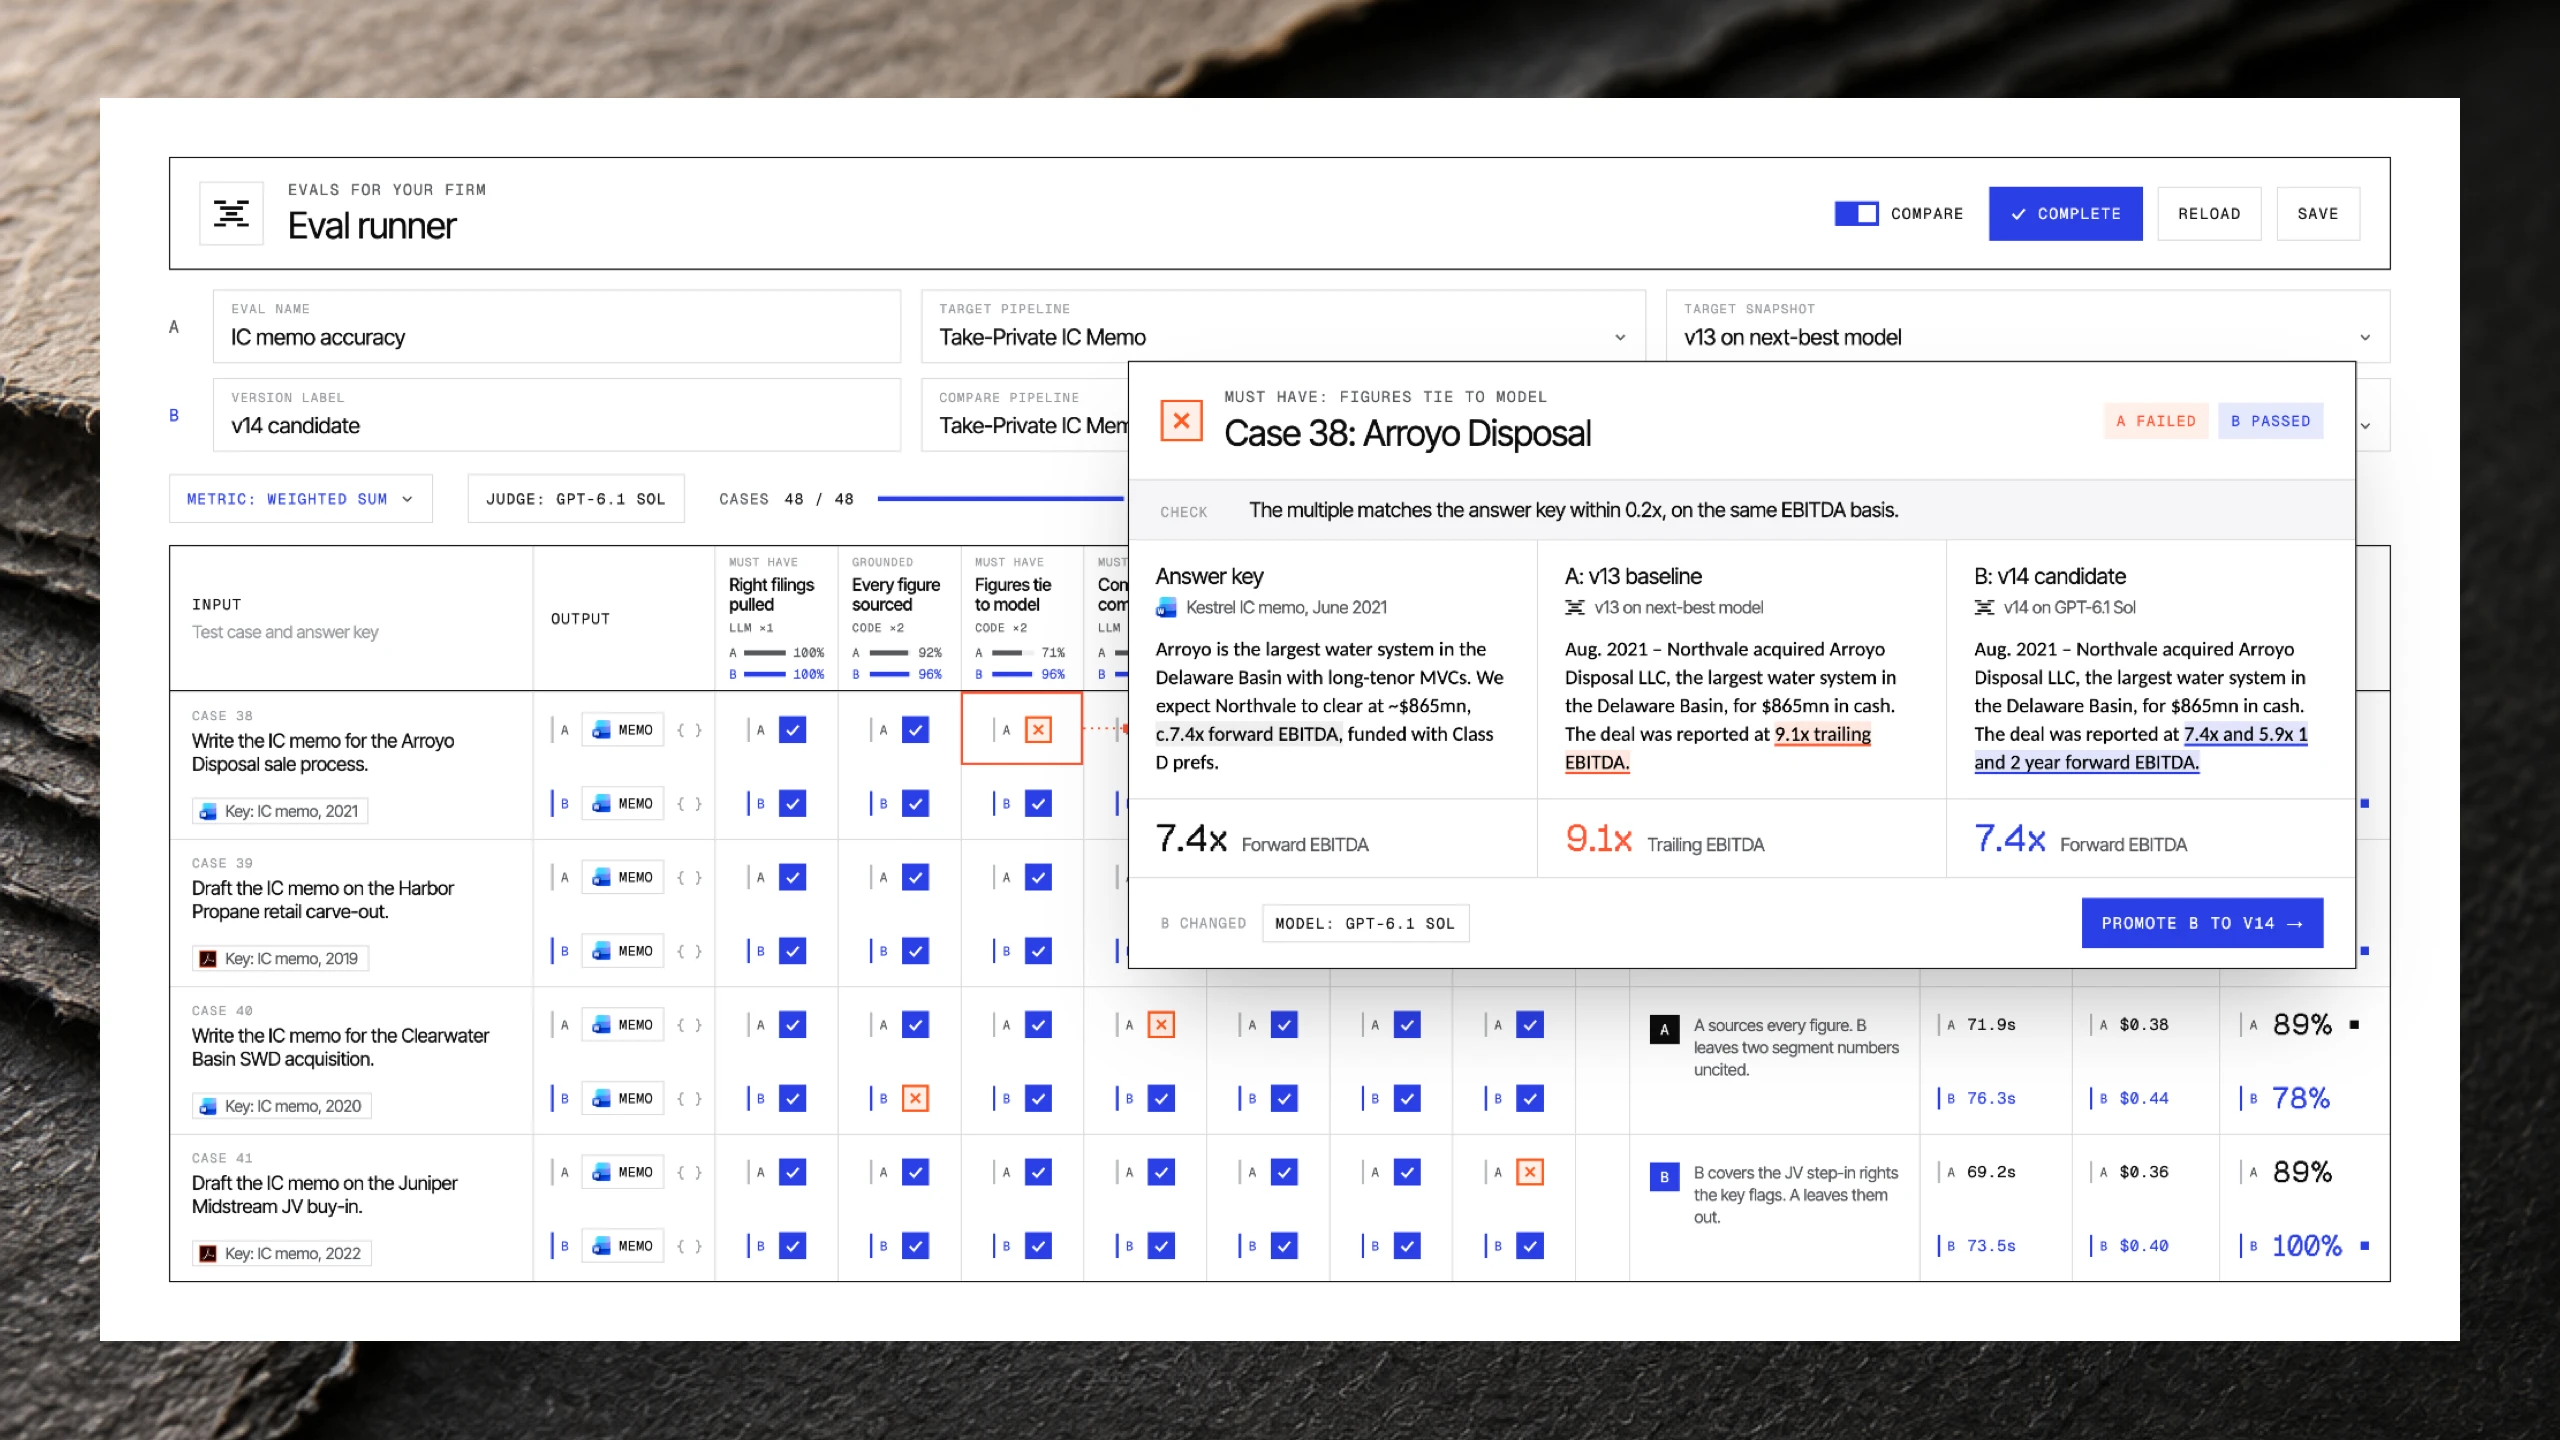
各チェック項目は「合格(pass)」または「不合格(fail)」と判定されます。不合格となった場合は必ず、その理由、より適切な代替情報ソース、または修正後のテキストが1行添えられ、新たな「記憶」として蓄積されます。たとえば、見落とされていたデータソース、不適切な類似企業、ファンドの基本方針から外れた論調などは、そのチームの新たなワークフロー指針や追加のテストケースとして定着していきます。
「すべての回答が評価され、アナリストが修正を加えるたびに、システムはそのファンドの仕事の進め方への理解を深めていきます」と、Terminal Xの共同創業者兼CTOであるKen Lee氏は述べています。「そのため、使い続けるほど、エージェントの思考プロセスは彼ら自身のチームにより近づいていくのです」
各種モデルをテストし、タスクに応じて最適化
Terminal Xは、自社の評価結果に基づいてモデルを選定しています。500件の採点評価において、GPT‑6.1 SolベースのEval Agentとシニアの人間のレビュアーとの一致率は88.6%に達し、次点モデルの86.4%と比較して220ベーシスポイント上回りました。
GPT‑6.1 Solが特に優れた成果を示したエラーの1つが「スタイル・ドリフト(style drift)」です。例えば、あるバイアウトファンドの投資マンデートが「純資産価値(NAV)を下回る非公開化ターゲットの発掘、アンダーライティングの評価、資金調達ストラクチャーの設計」であるとします。シナリオモデルが市場の転換点を予測した際、一部の案件提案ではディストレストデット投資やレスキューファイナンスへのシフトを提案し始めるケースがありました。GPT‑6.1 Solを搭載したEval Agentは、こうした投資戦略からの逸脱を検知する精度を約25%向上させました。