
QRコードをスキャンして量子位(QbitAI)をフォロー
< img id=“wx_img” src=“https://www.qbitai.com/wp-content/uploads/imgs/qbitai-logo-1.png” width=“400” height=“400”>

メモリをTransformerにネイティブに組み込む
鷺羽 凹非寺より
量子位 | 公式アカウント QbitAI
最近のAI界隈では、ある3つのアルファベットが一斉に注目を集めています。それが「RSI(Recursive Self-Improvement:再帰的自己改善)」です。
Hinton氏のRSIに関する論文では、22名の連名著者にBengio氏、OpenAIのチーフサイエンティストであるPachocki氏、Anthropicの共同創業者Jack Clark氏らが名を連ねており、AI界の重鎮たちが勢揃いしています。
誰もがAIの自己改善に目を向ける中、さらに掘り下げる価値のある根本的な問いが浮上しています。
「一度の改善を、いかにして次なるステップの起点とするのか?」
効果的な手法は保持される必要があり、通ってきた回り道も識別されなければなりません。この役割を担うものこそが、実は**「メモリ(記憶)」**なのです。
従来のアプローチはシンプルでした。AIに外部のナレッジベースを直接接続し、操作方法や過去の教訓をすべて保存・検索できるようにするというものです。
しかし、MemTensorがこの領域で進める探求は、これとは全く異なるアプローチである「メモリネイティブ(Memory-Native)」を提示しました。
メモリネイティブとは何でしょうか?それは、経験の保持、更新、そして呼び出しを、モデル自身が学習可能な能力として組み込むことを指します。
メモリがモデルの内部に根を下ろすことで、**「メモリネイティブモデル」**が形成されます。
新たにオープンソースとしてリリースされたMemT 1.0シリーズは、極めて具体的な道筋を示しています。
経験を内部の動的状態としてエンコードし、書き込み・更新・読み出しの方法をトレーニングを通じて学習させ、最終的にこれらの状態をメモリブランチ経由で後続の計算に関与させるという仕組みです。
外部メモリと比較して能力に遜色がないだけでなく、将来的な拡張性のポテンシャル(上限)もより高くなります。
また、これはメモリネイティブモデルとして初めて約300B(3000億)パラメータ規模での実証に成功した事例でもあります。
(論文リンクはこちら:
https://arxiv.org/abs/2610.26825)
メモリそのものは目に見えず触れることもできませんが、モデルの成長を支える確固たる基盤となりつつあります。
初期の「情報を記憶する」段階から「経験を活かす」段階へと、モデルがメモリに求める要件は進化を続けており、メモリは徐々に舞台裏から主役の座へと躍り出ようとしています。
メモリをモデルの内部へ組み込む
MemT 1.0では、今回2つのモデルが発表されました。
MemT-1.0-Nanoは総パラメータ数36B・アクティブ3Bで、ベースモデルには「Qwen3.6-35B-A3B」を採用しています。さらに上位モデルとなるMemT-1.0-Flashは、パラメータ数が288B・アクティブ17Bに達し、追加のポストトレーニングを施した「DeepSeek-V4-Flash」をベースにしています。
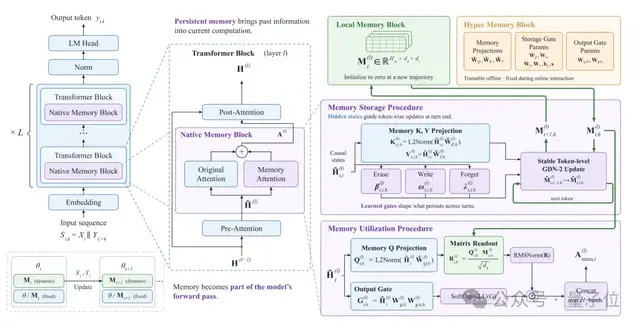
両者に共通する設計変更は、選定されたTransformerブロック内に、従来のAttention機構と並行して動作するメモリ計算パスを追加した点です。
分かりやすい例を挙げて説明しましょう。
例えば新しいタスクに直面した際、外部メモリのアプローチでは、過去の記録テキスト、検索された証拠、あるいは抽象化された手法をコンテキストに再投入することで、モデルに経験を再利用させます。
この検索と整理のプロセス自体にも学習メカニズムを導入することが可能です。
一方、MemT 1.0のようなメモリネイティブモデルは、さらにモデルの内部へと踏み込みます。
経験はエンコードされて更新可能な行列状態(matrix state)となり、モデルが回答やアクションを生成する際には、専用のメモリブランチを通じてこの状態を読み出します。読み出された結果は従来のAttention出力と統合され、後続の生成に影響を与えます。
両者の違いは、経験がどのように表現され、どのような計算プロセスを経て効果を発揮するかにあります。
このアプローチの利点は明白です。読み書きのプロセスをトレーニングに組み込むことで、手法のよりスムーズな再利用が可能になります。ただしトレードオフもあり、ピンポイントでの削除、解釈、復元を行いたい場合には、別途追加のメカニズムが必要になります。
外部テキストの方が検証や追跡が容易であることは確かであり、現時点では双方に一長一短が存在します。
真の違いを実感するには、実際に経験を活用した上でモデルの挙動を観察するのが一番です。
まずはエンジニアにとってお馴染みのシーンである**「コード修正」**を見てみましょう。
バグ対応の流れは基本的に「バグの把握 → コードの特定 → 修正の実施」となります。しかし、最初に問題が再現できていなかったり、境界条件の確認が不十分だったりすると、修正がうまくいかないどころか新たなバグを生み出し、負の遺産となってしまいます。
SWE-bench Verifiedのタスクを例にとると、Djangoのparse_http_date関数において2桁の年号のパースロジックを修正する課題があります。
研究チームは、「経験なし」「テキスト経験」「メモリネイティブ」の3つの設定下で実行トレースを比較しました。
経験がない場合、Agentはバグを特定した後、すぐにパースロジックの修正に着手し、後続のステップになって初めて問題の再現と検証を行いました。一方、経験を持つ2つのグループは、いずれも先に再現テストを構築してからコード修正に入りました。
その中でもMemT-1.0-Nanoは、初回修正後に改めて境界条件を再確認し、実装を修正した上で追加の検証を実施しました。
経験がアクションの順序を変え、タスク内の確認や修正プロセスにも影響を与えていることが明確に分かります。
より大規模なサンプルでの比較として、500件のSWE-bench Verifiedタスクをそれぞれ独立して3回実行したところ、MemT-1.0-Nanoは主要なチェックポイントでの平均成功率が**69.73%**に達しました(経験なしのベースラインは66.07%、テキスト経験グループは69.13%)。
3回すべて成功したタスクの割合は、経験なしの54.00%から**62.80%**へと向上しました(テキスト経験グループは61.80%)。
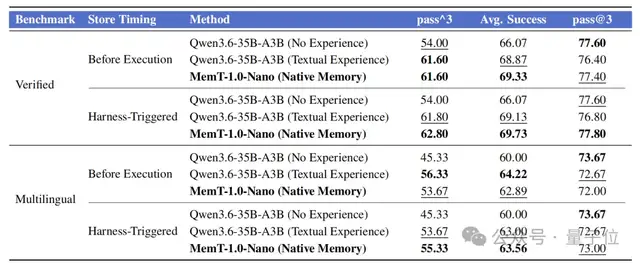
さらにSWE-bench Multilingualタスクにおいて同一のトリガー設定で比較したところ、メモリネイティブグループの平均成功率は63.56%(経験なしは60.00%、テキスト経験は63.00%)を記録しました。
つまり、こうした手続き的な経験はメモリネイティブを通じてしっかりと保持され、そのパフォーマンスは明示的なテキスト経験に匹敵します。さらに、平均成功率や反復実行時の再現性・信頼性においてより大きな強みを発揮します。
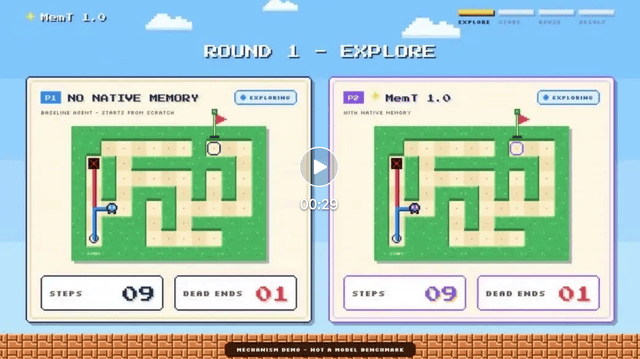
より直感的に理解するために、ピクセルアート風の迷路探索デモを見てみましょう。
同じ迷路、同じ移動速度で、左側がメモリネイティブを持たないAgent、右側がメモリネイティブを備えたMemT 1.0です。
1ラウンド目は、双方ともに未知のルートを探索する必要があるため、どちらも行き止まりに突き当たります。
違いが現れるのはこのラウンドが終了した後です。成功したルートと避けるべき分岐点が整理・アーカイブされ、MemT 1.0のメモリへとロードされ、次の探索の参照材料となります。
2ラウンド目に入り、同じくスタート地点から出発すると、左側のAgentは再び分岐点で試行錯誤を繰り返すのに対し、右側は前回の経験を活かして通ったことのある行き止まりを回避し、最短ルートでゴールに到達します。
動画リンク:https://mp.weixin.qq.com/s/DTdaGUk8o0dwkx1wxnnbYw
前のラウンドで開拓したルートが、次のラウンドの進み方に直接影響を与える――これこそが、メモリネイティブを採用する具体的な価値の表れです。
続いて、より日常的なオフィスワークに近い**「情報のアップデート」シナリオ**を見てみましょう。
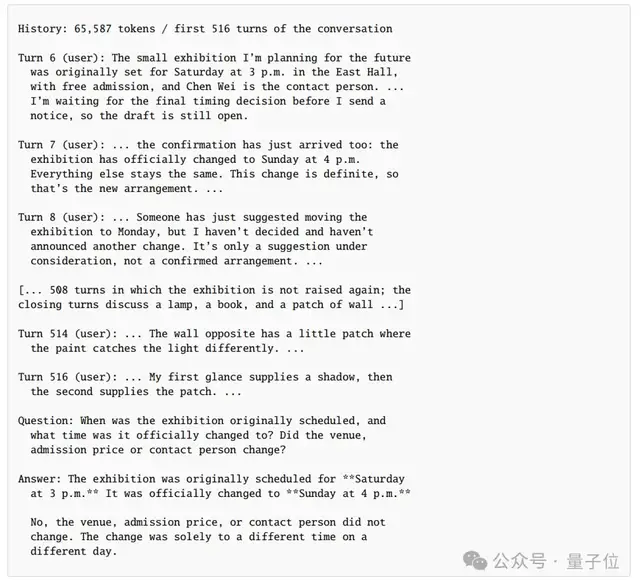
展示会の予定が、当初は「土曜日の午後3時」だったものが、正式に「日曜日の午後4時」へと変更されました。その後、誰かが「月曜日に変更してはどうか」と提案したものの、まだ決定はしていません。
このように二転三転する増分情報は、AIにとって非常に厄介な課題です。
最後に出てきた日付を記憶するだけでは不十分で、正式な決定事項と単なる思いつきの提案を区別し、変更されていない内容も正しく保持しなければなりません。
マルチターンの対話を経た実験において、MemT-1.0-Nanoは見事に状況を正確に把握し、当初の予定時間、正式に変更された時間、そしてその他の予定に変更がないことを正しく回答しました。
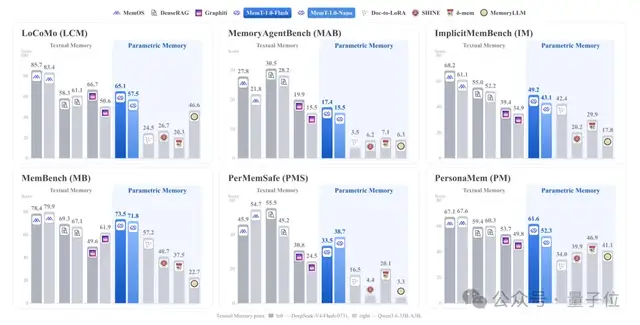
11種類のメモリベンチマークを用いた総合評価においても、FlashとNanoは際立った性能を示しました。
平均スコアはそれぞれ50.6と47.0を記録し、評価対象となったパラメータ化メモリ手法の中でツートップを獲得。他のモデルを大きく引き離す圧倒的な結果を残しました。
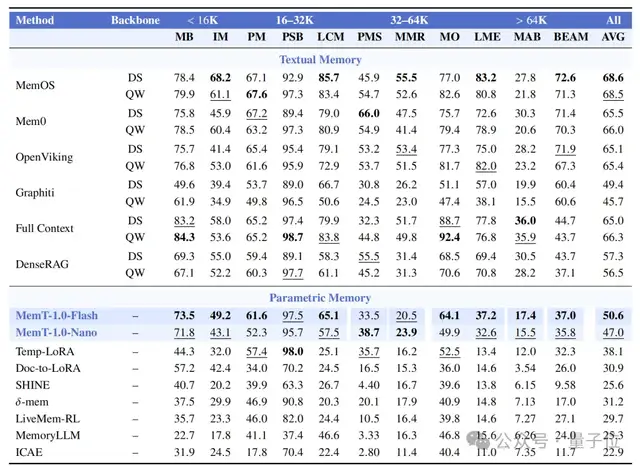
ただし率直に言えば、長い履歴における細部のリコール(想起)など、テキストベースのメモリシステム全体には依然として一日の長があります。
今回MemT 1.0が提示した成果は、メモリネイティブという新たなアプローチの初期的な計算実装に過ぎませんが、実際の効果はすでにテキストメモリに匹敵しており、今後の発展には計り知れないポテンシャルが秘められています。
メモリネイティブの「ネイティブ」たる所以とは?
では、経験がタスクのコンテキスト内に残されていないとすれば、モデルは一体どこからそれを利用しているのでしょうか?
これこそが、MemT 1.0のアーキテクチャにおける核心部分です。
MemT 1.0が提供するネイティブなアプローチは、まず関連する経験をエンコードして内部の動的状態とします。後続のアクションを生成する際、現在のクエリは専用のメモリブランチを介してその状態を読み出し、その結果を従来のAttention出力と融合させます。
具体的なパラメータ化の実装において、MemT 1.0はベースモデルの従来の計算フローを維持しつつ、選定されたTransformerブロック内にネイティブなメモリブランチを追加しています。構造を分解すると、以下の3つの階層から構成されています。
- バックボーンの重み(Backbone weights):モデルが元々持つ汎用的な能力を担い、メモリのトレーニング中は凍結状態を維持。
- ハイパーメモリ(Hyper-memory):読み書きのプロジェクションやゲーティングなど、メモリを具体的にどうエンコードし、更新し、読み出すかを決定する学習可能なパラメータ。
- ローカルメモリ(Local memory):インタラクションの中で新たに追加された情報を保持する動的な行列状態。
このように役割を分担させることで、モデルはバックボーン全体を都度ファインチューニングすることなく新しい経験を取り込むことができ、変化するのはタスク軌跡に対応する動的状態のみとなります。
このメカニズムにおける読み書きの設計にも、高度な工夫が凝らされています。
書き込み時には、隠れ状態が射影(プロジェクション)されてメモリのキー・バリューが生成されます。そして消去・書き込み・忘却の各ゲーティングが協調して既存の行列内の関連性を調整します。読み出し時には、現在の入力がメモリクエリへとマッピングされて関連情報が読み出され、正規化と出力ゲーティングを経て後続の生成プロセスに参加します。
更新メカニズムには、Gated DeltaNet-2をベースにしたトークン単位(Token-level)の生成手法が採用されており、安定化処理が施されています。
(注:Gated DeltaNet-2の原著者も関連する議論に参加しています)
これは各ターンの終了時にトリガーされ、ゲーティング機構によって既存のメモリの関連性を調整します。また、ターン内ではトークンの順序に従って状態が調整されます。
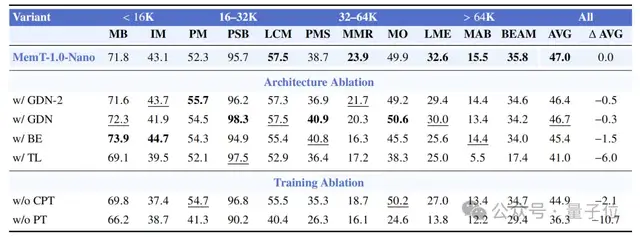
アブレーション実験でもこの設計の妥当性が証明されています。トークン単位の更新をターン単位の集約に変更したところ、Nanoのメモリベンチマークの平均スコアは約47.0から41.0へと下落しました。
6ポイントのスコア差は、連続的なトークンレベルの更新がメモリの減衰をより効果的に抑え、ターン内の関連性をタイムリーに修正できることを物語っています。
しかし、メモリの内容が膨大になり、モデルのキャパシティが不足した場合はどう対処するのでしょうか?
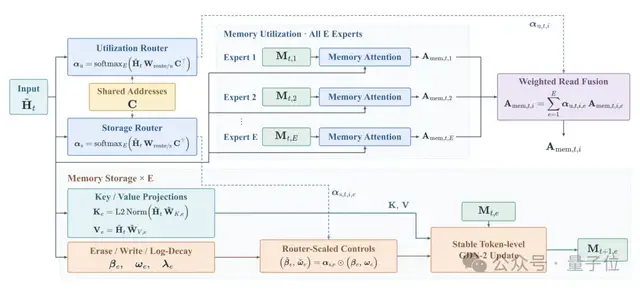
そこでMemT 1.0はMoE(Mixture-of-Experts)の思想を応用し、MoS(Mixture-of-Storage)というソリューションを提案しました。
MoSは1つのメモリネイティブモジュールを複数のメモリエキスパートへと拡張し、保存と利用に関するルーティングを個別に学習させます。ここではすべてのメモリエキスパートが計算に関与する**高密度融合(Dense Fusion)**が採用されており、ルーティングの重みによって各エキパートの寄与度が決定されます。
これは、ベースモデルが持つスパースなMoEのルーティングとは明確に異なる点です。
もっとも、アーキテクチャの構築は出発点に過ぎません。
モデルがこの計算パスを真に使いこなせるようにするため、研究チームは継続事前学習(Continual Pre-training)200億トークン、事後学習(Post-training)140億トークンからなる、計340億トークンのメモリ訓練コーパスを構築しました。
継続事前学習のフォーマットは統一されており、長いテキストを連続したチャンクに分割してメモリに書き込み、モデルがそのメモリ状態を参照してクエリに回答する形をとります。
1つのチャンクの処理が完了するたびにモデルは状態を更新し、次のチャンクの処理に備えます。
事後学習ではタスク結果のアライメントをさらに進めます。データは「メモリネイティブの言語モデリングデータ」「メモリの保存・活用データ(要約、続きの生成、圧縮など)」、そして長期メモリの強化に特化した「タスクデータ」の3種類で構成されています。
特筆すべき点として、事前に凍結されたバックボーンが教師モデルとして機能する点が挙げられます。教師モデルは完全な履歴情報を参照できるのに対し、生徒役であるMemT 1.0は自身のメモリ状態しか参照できません。このオフポリシー(off-policy)蒸留を通じて、生徒の分布を教師の分布へとアライメントさせていきます。
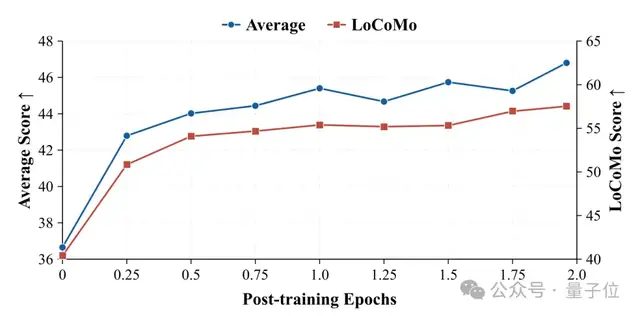
総じて見ると、メモリネイティブの要点が浮き彫りになってきます。履歴を状態へとエンコードすることは第一歩に過ぎず、それをいかに保持し、更新し、読み出すかまでを含めて初めてメモリネイティブモデルの全体像が完成します。
このアプローチの真価は、経験の再利用効果、リソースコスト、長期運用の条件などを総合的に考慮して判断されるべきでしょう。
継続学習からRSIへ:メモリが切り拓く能力向上のフロンティア
ここで疑問に思う方もいるかもしれません。「なぜわざわざメモリネイティブを使う必要があるのか?」と。
既存の外部メモリソリューションはすでに成熟しており、優れた実践事例も多数存在します。それに比べれば、メモリネイティブはまだ立ち上がったばかりであり、効果も現時点では大きな差があるわけではありません。
しかし、そうではありません。メモリネイティブには決定的な独自性があります。
それは、経験の表現と読み書きそのものが、モデルの能力拡張の対象になるという点です。これこそがMemTチームの提唱する「Memory Scaling」であり、推論時のスケーリングに次ぐ「モデル性能向上の第3の成長曲線」となり得るものです。
画像はAIによって生成
従来の経験が役に立っているかどうかは、検索後にタスクの結果が改善されたかどうかで判断できました。しかしMemT 1.0では、「同じ経験であっても、内部表現、更新ルール、読み出し方式を変えることで、さらに高度に活用できるのではないか?」という問いを深めることができます。
これにより、メモリ性能の向上に対してトレーニングやアーキテクチャ設計によって調整可能なパラメータ群が新たに加わることになります。
もちろん、これだけでネイティブメモリの長期的な上限が外部メモリを上回ると証明されたわけではありません。しかし少なくとも、内部状態にフォーカスしたトレーニングとキャパシティの拡張が、さらなる能力向上をもたらすことは間違いありません。
次のステップは、これらの優位性が現在の訓練分布を超え、より長期的なインタラクションや未知のタスクにおいても維持できるかを検証することです。
話を冒頭のRSIに戻しましょう。
メモリネイティブの仕組みが確立されれば、継続学習(Continual Learning)やRSIのブレイクスルーに対しても絶大な恩恵をもたらします。
周知の通り、RSIには**「メモリ」「フィードバック」「検証と更新メカニズム」**という3つのピースが存在します。メモリが有効な成果を継続させ、残りの2つがどの変更を次のサイクルに引き継ぐべきかを判断する役割を果たします。
MemT 1.0が現在探求しているのは、まさにこの「経験の継承と再利用」のプロセスです。経験がネイティブメモリを通じてアクションをガイドできることを実証し、モデルレイヤーから1つ目の、そして最も重要なピースを埋めました。
画像はAIによって生成
さらにその先へ進めば、ローカルメモリに蓄積された経験が後続のトレーニングを通じてハイパーメモリのパラメータへと定着し、それが翻ってモデルのメモリ管理手法そのものを改善していく未来が描けます。
このサイクルが確立されれば、記録された成果と手法を通じて、システムはタスク横断的な知能爆発、すなわちRSIの究極の目標を達成できるかもしれません。
これらは理論面でのメリットですが、アプリケーションの実装側においても、メモリネイティブはエンタープライズにおけるノウハウの蓄積に極めて有利に働きます。
現在、業界でエンタープライズAIを語る際、最も注目されるのは「現状のモデルがどれだけ使い物になるか」「どこまでの精度が出るか」といった初期導入フェーズの内容です。
それ自体に誤りはありませんが、企業が実際に運用を始めてから痛感するのは、「経験の蓄積」がいかに重要かということです。
企業の長期的な業務には、プロジェクトのルール、オペレーションの手順、検証手法などが絡んできます。タスクが変わるたびに同様の制約事項を一から指示し直したり、同じような失敗を繰り返したりしていては、先行投資を後続の利益へと十分に転換できません。
そのため、こうした反復的なワークフローにおいては、**「検証されたノウハウを何回再利用できるか」という指標が、「モデル単体の実行性能」**と並んで企業向けAI選定の重要な評価基準となるべきです。
メモリネイティブは、これに対してモデル側からの受け皿を提供します。
同一の128Kの長いコンテキスト履歴において、Nanoのエンドツーエンド推論速度は完全なコンテキストを読み込むアプローチの約1.86倍に達し、同じ履歴長において各軌跡が占有する永続的な状態のサイズは、完全なコンテキストのKV Cacheのわずか66分の1にとどまります。
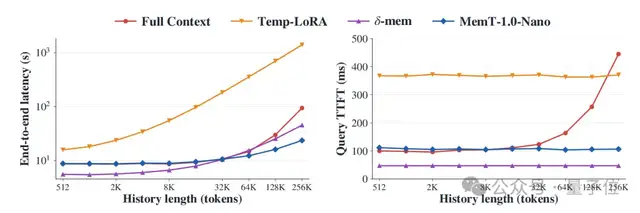
分かりやすく言えば、これは即座に効いてくる**「圧倒的なコスト削減効果」**を意味します。
長期的なセッションにおけるステートの容量を見積もりやすくなり、複数のクエリで構築済みの状態を使い回すことで、準備にかかるオーバーヘッドを分散させることができます。
ただし公平を期して言えば、メモリネイティブのタスク処理品質が外部メモリを常に上回るわけではありません。しかし同等の品質であるならば、基層での経験の再利用によって手戻りを着実に減らすことが期待できます。このメリットは、**企業のシステム運用・保守(Ops)**にとって極めて実利的な価値を持ちます。
換言すれば、メモリネイティブと外部メモリは対立する関係ではなく、両者が協調して役割分担を行うことで、さらなるシナジーを生み出せる可能性があります。
正確な原文、ソース、バージョンの検索には外部の記録が依然として有用であり、後続の実行に向けた経験の呼び出しにはネイティブなメカニズムを活用していく、といったアプローチです。
いずれにせよ、効果的な進歩を確実に蓄積し、新しいタスクの中で繰り返し検証できるようになって初めて、持続的な自己改善のための強固な基盤が整います。
完全な階層型メモリ管理とスケジューリングにより、グローバルな読み書き効率の最適化が可能になります。そして本日、メモリネイティブモデルのリリースによって、こうしたエンジニアリングとしての実装とデプロイが現実のものとなりました。
継続的な自己改善を推進する上でのメモリの真価は、今後の長期的な検証の中でますます明らかになっていくことでしょう。
GitHubリンク:
https://github.com/MemTensor/MemT-1.0
HuggingFaceリンク:
https://huggingface.co/collections/MemTensor/memt-1
著作権は原権利者に帰属します。無断転載・無断利用を禁じます。違反した場合は法的責任を追及します。
- 速報!DeepSeekの新モデルがリリース、圧倒的なコスパで市場を席巻2026-10-17
- 今年の独身の日(W11)、Bailing新モデルがストレスフリーな業務効率化を実現2026-10-15
- Claudeが30分で暗号学の未解決事件を解明、学会の20年にわたる迷走に終止符2026-10-17
- シリコンバレーAIの現状:計算リソースを持つ者が覇権を握る2026-10-11
QRコードをスキャンしてモーメンツに共有
関連記事
PaddlePaddleフレームワークが3.0へ進化!「大規模モデル訓練・推論一体型」など5大新機能を徹底解説
産学官の各界に安定したサポートを提供
十三 2024-08-01
テンセントクラウドの大規模モデル新展開!ベクトルデータベースを独立製品として発表、8月に提供開始へ
10億スケールのベクトル検索機能を提供
明敏 2023-07-05
大規模モデルで性格・うつ・認知パターンをテスト!ゲームのストーリー展開から心理特性を測定|清華大学
パーソナライズされたインタラクティブ・ストーリーテリングゲームを生成
西風 2024-03-13
美団が光年之外(Light Years Beyond)を20億元で100%買収!王興氏が清華大の旧友を支援、手元資金は2.8億米ドル
現在のチーム規模は約70名
白交 2023-06-29
最難関方言の温州弁を攻略!中国電信の音声大規模モデルが30の方言に対応、GPT-4oもお手上げ
大規模モデル音声技術が新たな高みへ
白交 2024-05-28
世界トップクラスのマルチモーダル大規模モデルがオープンソース化!Kai-Fu Lee氏率いる01.AIが再び躍進
中英両言語の主要ベンチマークでトップを独走
西風 2024-01-22
人気記事
人工知能の新たなトレンドを追い、テック業界の新たなブレイクスルーを届ける
量子位 QbitAI All Rights Reserved ©北京極客伙伴科技有限公司 京ICP備17005886号-1