
是石科技、分散スケジューリングフレームワーク「TokenFleet」を発表
GPUクラスタにおいて、リクエストのキュー待ちとリソースの遊休は往々にして同時に発生します。
「2026 CCF 全国高性能計算学術大会」において、是石科技(METASTONE)は新製品**「TokenFleet 分散スケジューリングフレームワーク」**を発表しました。リクエストルーティング、拠点間(DC間)キャパシティ協調、混合ワークロード制御に最適化の焦点を当て、既存のコンピュートリソースによる「有効な産出量」の向上を目指しています。
大規模言語モデル(LLM)の推論サービスを「国産Token最適化工場」に例えるなら、GPUは生産設備、推論インスタンスは作業ブース、業務リクエストは生産指示書(オーダー)といえます。TokenFleetが担うのは、これらオーダーと生産能力を効率的かつ高精度にマッチングさせる役割です。
同じ設備群であっても、受け取るタスクの種類や割り当て戦略が異なれば、最終的な待機時間やSLA要件を満たす産出量は大きく乖離します。大規模なコンピューティングサービスにおいて、こうした生産スケジューリングの最適化は避けて通れない重要課題です。
TokenFleet:クラスタの「有効産出量」にフォーカス
モデルの本番稼働後、クラスタは多種多様なビジネスシナリオへの同時対応を迫られます。
複数のモデルでクラスタのリソースを共有し、テナントごとにサービス品質保証(SLA)も異なります。短文のチャット対話にはミリ秒単位の低遅延応答が求められ、長文ドキュメントの解析は計算能力とVRAMリソースを大量に消費し、オフラインのバッチ処理には明確な完了期限が定められています。さらにサービスノードが複数のデータセンターに分散している場合、各地のリソースキャパシティをいかに効率よく協調させるかという課題も加わります。
大まかなトラフィック振り分けでは、特定インスタンスにリクエストが集中して長蛇の列ができる一方、別のノードではリソースが遊休状態になるといった偏りが容易に生じます。ロングコンテキストのリクエストとバッチタスクがリソースを奪い合えば、リアルタイムな対話の応答速度が低下します。さらに、リクエストのタイムアウト、途中キャンセル、重複計算が発生すると、貴重なGPUリソースが無駄に浪費され、価値あるデリバリーにつながりません。
モデル品質、サービス要件、リソース予算を一定に維持することを前提に、TokenFleetは**「有効なToken産出量を高め、単位有効産出あたりの総合コストを削減すること」**に注力しています。
本フレームワークは、連携して機能する3つのコア技術で構成されています。
- TokenPilot:同一モデルプール内での最適な推論インスタンスの選定を担当
- FleetMind:拠点間(DC間)のキャパシティにおけるマクロ視点での協調に特化
- SLOMax:混合ワークロードのアドミッション制御、キュー管理、キャパシティ配分を牽引
リクエストをどう振り分けるか、タスクをいつキューに投入するか、各拠点のキャパシティをどう連携させるか。これらすべての制御は、**「正常に完了し、かつSLA要件を満たす有効なToken産出量」**という単一のコア指標へと帰着します。
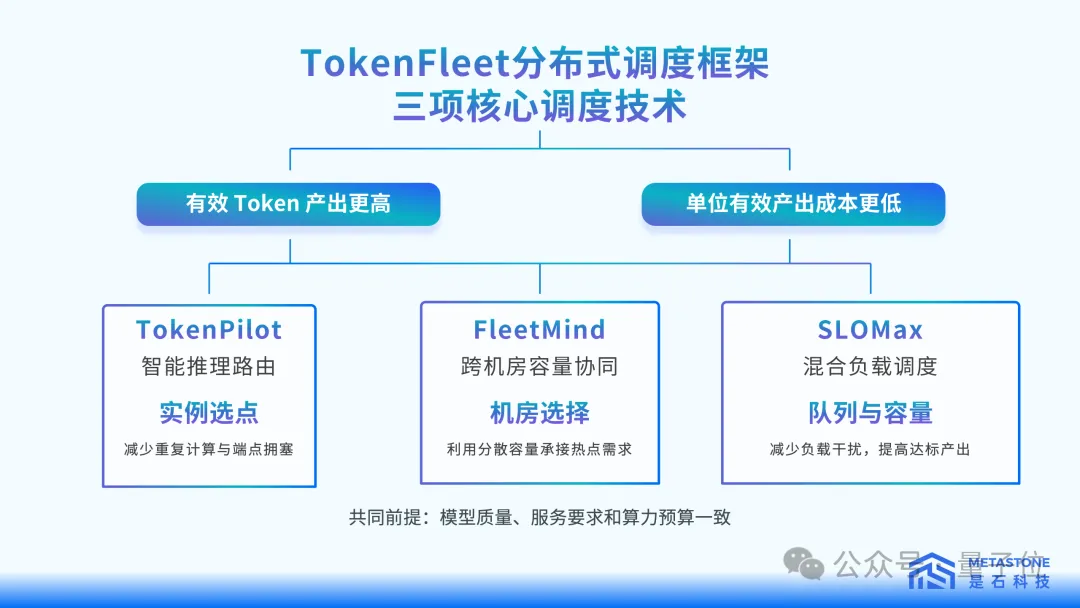
△図1 TokenFleet の3つのコアスケジューリング技術の概要
TokenPilot:キャッシュの恩恵とキュー待ちコストを両天秤に
リクエストルーティングにおけるインスタンス選定プロセスにおいて、対象のリクエストはどのインスタンスへ送信すべきでしょうか。
短いQAと長文ドキュメントは、統計上はどちらも「1リクエスト」としてカウントされますが、消費される計算量やVRAMの負荷には桁違いの差があります。単にリクエスト数のみを基準とした単純なロードバランシングでは、各インスタンスの実稼働負荷を均等化することは困難です。
さらにKVキャッシュの仕組みが、トレードオフの判断を一段と複雑にします。同一の長いプレフィックスを持つリクエストを、該当のKVキャッシュをすでに保持しているインスタンスへルーティングできれば、過去の計算結果を再利用でき、Prefillフェーズ(入力コンテキストの処理)における重複計算を大幅に削減できます。
しかし、キャッシュヒット率が高いインスタンスには、並行リクエストが集中してキュー待ちが生じるリスクが高まります。リクエストが特定ノードに過度に偏ってしまうと、計算処理の短縮分が長いキュー待機時間によって相殺されてしまいかねません。
TokenPilotはインスタンス選定時、キャッシュ再利用の恩恵とキュー待ちによるコストの双方を天秤にかけて評価します。入力コンテキスト長、出力バジェット、再利用可能なプレフィックスから必要な計算量を推定し、キューの深さ、処理中のトークン数、KVキャッシュによるVRAMの圧迫度、予測レイテンシを多角的に評価して候補インスタンスのスコアリングと選別を行います。(※出力バジェットはルーティングの制約条件としてのみ機能し、実際の最終出力長とは必ずしも一致しません。)
スケジューラーはこの評価に基づき、各インスタンスの予想処理コストを定量的に比較し、キャッシュ再利用によって削減できる計算コストが追加のキュー待ち時間を相殺するに値するかどうかを高精度に判断します。
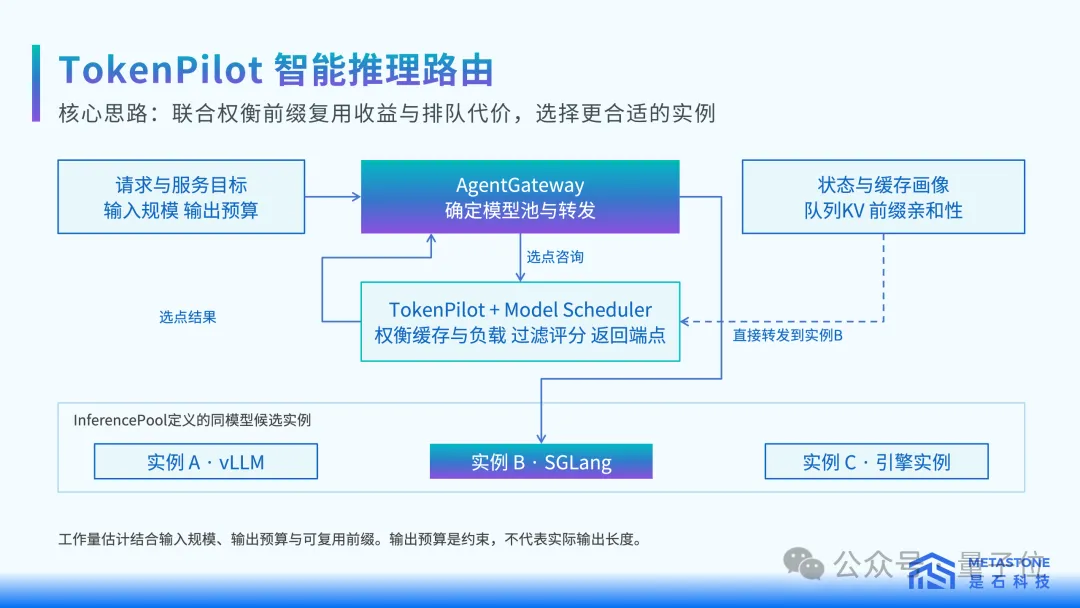
△図2 TokenPilot インテリジェント推論ルーティングフレームワーク
是石科技が公開したGLM-5.3のチューニングデータによると、テスト対象のハードウェアクラスタおよび特定の負荷条件下において、予測レイテンシに基づくルーティング戦略を導入した結果、P95のファーストトークンレイテンシ(TTFT)が32.4%削減、P50のファーストトークンレイテンシが71.3%削減されました。
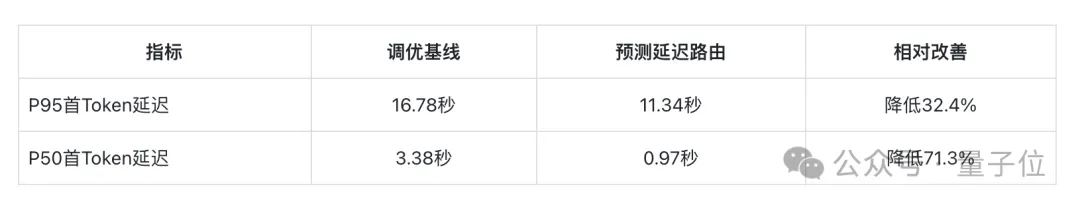
△表1 TokenPilot ファーストトークンレイテンシのチューニング結果。データソース:是石科技 大会講演資料。改善率は(ベースライン値-最適化値)÷ ベースライン値 で算出。レイテンシの低下が直ちにコスト低下を意味するわけではありません。
このうち、P50は中央値におけるスケジューリング応答水準を示し、P95はテールリクエスト(最悪ケース付近)の待機パフォーマンスを反映しています。このデータ群はベンチマーク環境における応答性の向上を示しており、全体のコスト対効果についてはシステムスループットや実際のリソース占有状況を加味して総合的に評価する必要があります。
FleetMind:拠点間で「真に利用可能なキャパシティ」を算出
スケジューリングの視野が単一クラスタから複数拠点(マルチDC)へと広がるにつれ、意思決定レイヤーには全社規模のリソース状況を把握する視点が求められるようになります。
あるノードに空きGPUが存在するからといって、そのノードが直ちにリクエストを受け入れられるとは限りません。対象モデルがすでにデプロイされているか、重みのバージョンが一致しているか、サービスエンドポイントがReady状態にあるか、そして拠点間のネットワーク転送遅延はどの程度かといった要素が、最終的なサービス品質に決定的な影響を与えます。
FleetMindの中核は、「実効的に利用可能なモデル推論キャパシティ」の正確な評価にあります。TokenFleetアーキテクチャにおいて、FleetMindは各データセンターのモデルデプロイ状況、リアルタイムの余剰リソース、ネットワーク通信経路の情報を一元的に集約します。まずマクロレベルでリクエストを処理すべき拠点を決定し、その拠点のローカルスケジューリングエンジンに引き渡して具体的な推論インスタンスを選定させます。
トラフィックの集中する拠点でキューの滞留が発生した場合、システムはリモート拠点の同バージョンモデルにReady状態のエンドポイントと余剰リソースが存在するかを動的に評価し、コンプライアンス要件を満たす新規リクエストを地域を跨いでルーティングすべきかを判断します。
リクエストのオフロード可否は、第一にデータセキュリティ規程やアクセス権限の地域制限に拘束されます。その上でオフロードする価値があるかどうかは、オリジン取得レイテンシ、キュー待機時間、計算負荷、キャッシュの恩恵、拠点間ネットワークの転送コストを総合的に勘案して判断されます。
拠点間協調は、複数の時間軸をカバーしています。短期的な視点では新規リクエストのルーティングを柔軟に微調整し、中長期的な視点ではモデルレプリカの配置やノードの事前ウォームアップを統括的に指示します。さらにキャパシティの事前確保、負荷上限の検知、自動フェイルバック機構を組み合わせることで、リソースのミスマッチを最小限に抑えます。
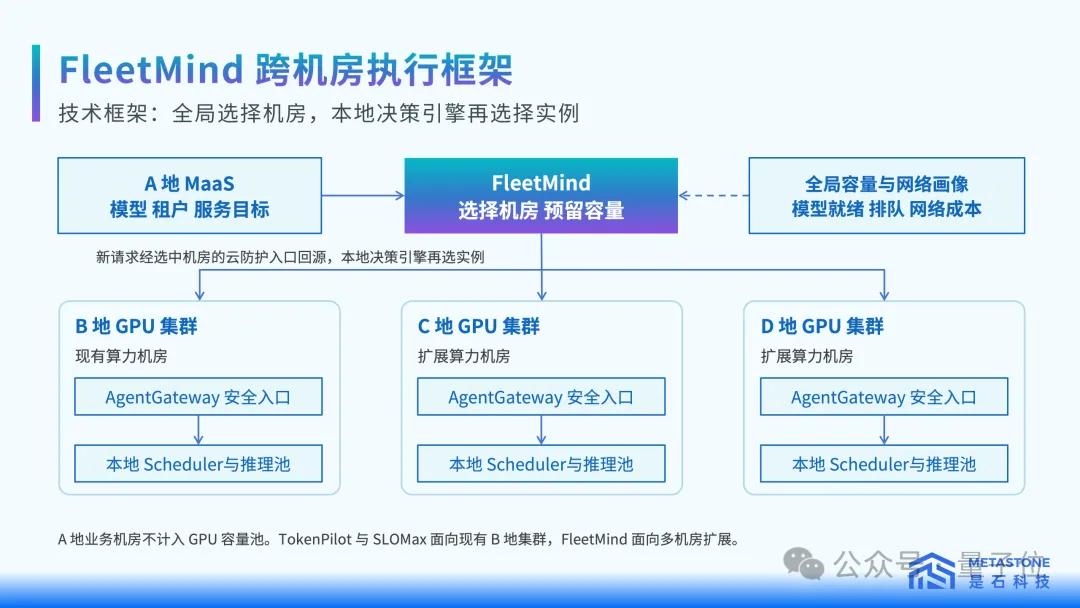
△図3 FleetMind 拠点間実行フレームワーク。注:拠点Aはビジネスの入口でありGPU容量プールには算入しない。拠点Bは既存クラスタ、拠点C・Dは拡張データセンター。
TokenPilotとSLOMaxが既存クラスタの緻密な管理にフォーカスしているのに対し、FleetMindは新規に増設されたデータセンターの水平方向への弾力的な拡張を支えます。拠点間スケジューリングの主眼は、業務上のコンプライアンスを満たした上で分散した遊休リソースを活性化して突発的なピーク需要に対応し、サイロ化や過剰なリソース確保による無駄を排除することにあります。
SLOMax:サービスレベルに応じた混合ワークロードの精密制御
同一クラスタに流入するリクエストであっても、求められるSLA要件は大きく異なります。
リアルタイムチャットは極めて短いファーストトークンレイテンシとスムーズな生成速度を追求します。長文コンテキスト処理は強力なPrefill能力と十分なKVキャッシュ用VRAMを必要とします。オフラインバッチ処理では完了期限と全体のスループットが最重要視されます。これら異種のリクエストを同一キューに混在させると、深刻なリソースの奪い合いが発生しやすくなります。
極端に長いPrefill処理時間、KVキャッシュによるVRAMの肥大化、並行バッチタスクの負荷は、いずれもインタラクティブなリクエストのリソースを圧迫します。結果としてリクエストのタイムアウト、ユーザーによる途中キャンセル、再試行が発生し、計算リソースの一部が無駄に消費されて有効な成果物へと結びつかなくなります。
SLOMaxは入力規模、出力バジェット、業務種別、テナントのサービスレベル目標(SLO)を総合的に分析して実際のワークロード特性を識別し、差異化されたアドミッション制御、キューの分離、動的なキャパシティバランシングを実施します。インタラクティブ性の高いリクエストへのキャパシティを最優先で確保しつつ、長短リクエストの混在実行によるパフォーマンスの乱高下を効果的に遮断します。
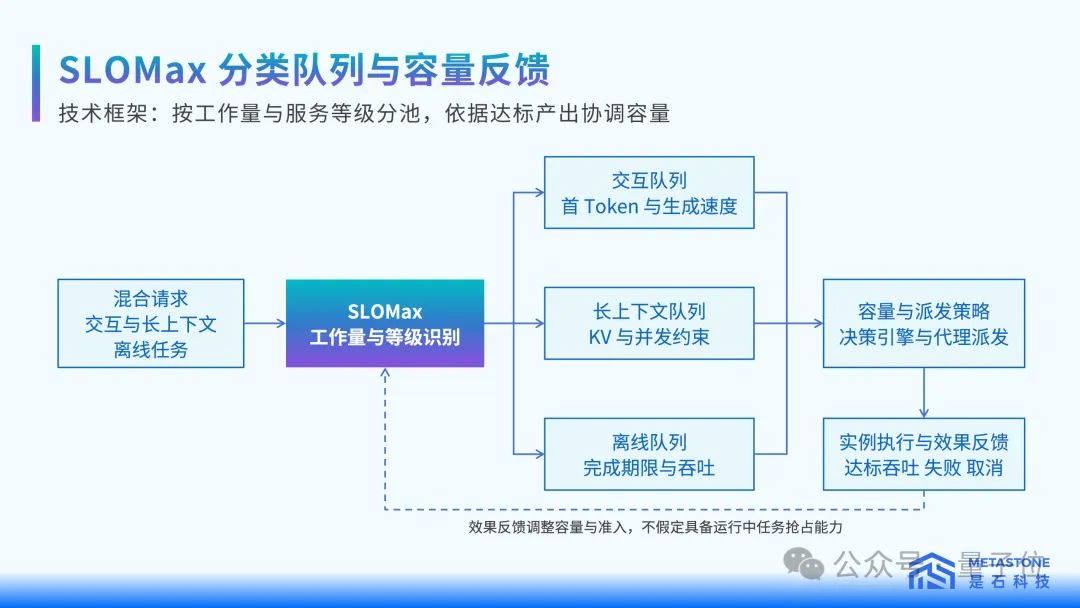
△図4 SLOMax 分類キューとキャパシティフィードバックのフレームワーク。注:効果フィードバックはキャパシティ割り当てとアドミッション基準の動的調整に用いられ、実行中タスクの強制的なプリエンプション(横取り)機能は想定していません。
スケジューリング全体の成果を測定する際、TokenFleetは「要件を満たした産出量」を主要な最適化指標に据えています。
**Goodput(要件充足スループット)**は、「テスト期間全体において、正常に完了し、かつ所定のサービスレベル要件を満たしたリクエストによって生成された有効Tokenの総量をテスト時間で割った値」と定義されます。業務タスクのタイプごとに独立した達成基準を設け、個別に統計を取る必要があります。
システムは達成スループット、失敗率、キャンセル率、重複計算コストなどの指標をスケジューリング中枢へリアルタイムにフィードバックし、アドミッション基準やリソース配分比率を動的に更新します。クラスタの効率を測る上では、単にGPU稼働率やピーク時の総スループットを見るだけでなく、最終的にSLAを達成した成果として結実した規模にこそ目を向けるべきです。
是石科技が公開したGLM-5.3の試算モデルによると、トラフィック制御協調スケジューリング戦略の導入後、クラスタ全体の総出力スループットは微増(約1.5%増)にとどまったものの、Goodput(要件充足スループット)は約29.4%向上し、要件達成率は約67%から約86%へと改善しました。
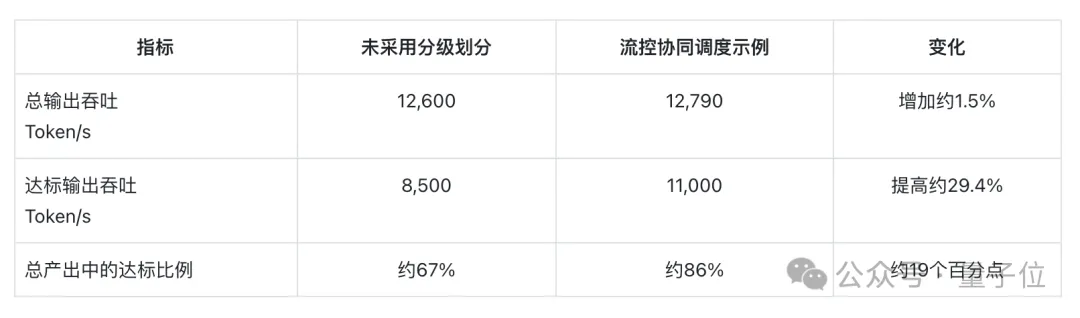
△表2 SLOMax 有効Tokenスループットの改善効果試算例。データソース:是石科技 大会講演資料。本表は試算例です。達成率は原文の四捨五入値をそのまま引用しており、約19ポイントの変動となります。
上記のデータは試算例であり、スケジューリングアーキテクチャが産出品質を向上させる可能性を示しています。実際のビジネス価値については、実稼働環境固有のワークロードやサービス指標と照らし合わせて検証する必要があります。
全体の出力規模が同等であっても、タイムアウトによる破棄や無駄な再試行を大幅に削減できれば、それだけ多くのリソースを要件を満たすTokenの生成へと振り分けることができます。SLOMaxは指標のクローズドループフィードバックにより、その後の全体リソース配分を継続的に最適化していきます。
「国産Token最適化工場」の効率はスケジューリングが決める
TokenFleetは、LLM推論の性能最適化を分散クラスタレベルへと進化させました。単一インスタンスの性能を複数リクエストへどう効率的に割り振るか、地域を跨ぐデータセンターの算力をどうシームレスに結合させるか。これらを実現するには、インテリジェントなスケジューリングフレームワークによって基盤ハードウェアインフラと上位のビジネスSLAを緊密に統合する必要があります。
是石科技(METASTONE)は、中立な第三者のフルスタックコンピュートリソースオペレーターとして特定モデルのエコシステムに縛られず、企業顧客に対してハードウェア選定、ネットワーク設計、タスクスケジューリング、性能最適化、クラスタ運用保守に至るワンストップのフルスタックデリバリーソリューションの提供に注力しています。
国家スーパーコンピューティングセンターにルーツを持つ確かな技術蓄積に支えられ、同社が運用するコンピューティングクラスタの稼働SLAは99.95%以上を維持しています。現在、是石科技は20,000 PFLOPSを超える異種コンピュートリソースを統括管理し、10か所以上のスーパーインテリジェントコンピューティングセンター(うち2か所は国家級スーパーコンピューティングセンター)を運用保守しています。コアチームは高性能計算分野の最高栄誉とされる「ゴードン・ベル賞(Gordon Bell Prize)」を3度受賞しており、超大規模な異種コンピューティングクラスタのフルスタック構築において豊富な実績を有しています。
「国産Token最適化工場」という技術構想のもと、是石科技は自社開発・自社運用の技術ループを通じて基盤システムソフトウェアを継続的にブラッシュアップし、汎用かつ高頻度なモデル推論の限界費用を引き下げ、国産ハードウェアが持つ本来のポテンシャルを最大限に引き出すことを目指しています。
以前リリースされた推論エンジン「Meta-Infer」が単一推論インスタンスの計算効率の最大化に重点を置いていたのに対し、今回発表されたTokenFleetは**「クラスタ分散スケジューリング」**に焦点を当てています。高精度なリクエストルーティング、柔軟な拠点間キャパシティ協調、きめ細かな混合ワークロード制御を通じて、大規模生産のための技術基盤を構築します。
より多くのビジネスがLLMの恩恵を「手頃なコストで、十全に享受できる」ようにするためには、先進的なハードウェアによる生の計算能力だけでなく、巨大なクラスタの生産能力を効率的に束ね上げる基盤システムソフトウェアが不可欠です。TokenFleetの試みは、コスト削減と効率向上という課題への解を、リクエスト一つひとつの適切な割り当てと、あらゆるコンピュートリソースの極限までの解放を通じて具現化しようとしています。