
10月17日、哲源科技(Zheyuan Technology)は計算医学プラットフォーム「WHIRLPO」を正式に発表しました。
2026年のAI分野では、極めて興味深い地殻変動が起きています。業界の視線がいまだ大規模言語モデルのパラメータ規模や自律型エージェント(Agent)、汎用人工知能(AGI)に注がれる中、マーク・ザッカーバーグ氏はさらに困難な領域——「生命システム」へと巨額の資金を投じ始めました。
今年4月、ザッカーバーグ氏と妻のプリシラ・チャン氏が設立したチャン・ザッカーバーグ・イニシアティブ(CZ Biohub)は、「バーチャル・バイオロジー計画」を始動させました。生物学的現象を予測するAIモデルの学習を目的に、データ整備と実験環境の構築へ5億ドルを投じる計画です。そして10月、このプロジェクトはさらに拡大しました。米国エネルギー省(DOE)と米国国立衛生研究所(NIH)がBiohubとタッグを組み、生命予測モデルのデータ基盤を共同構築することを決定。Meta、Google DeepMind、Isomorphic Labsといった世界最高峰のチームが一堂に集結しました。プロジェクト全体のコミット額は総額18億ドルに達し、そのうち米国エネルギー省が今後5年間で5億ドル超を拠出、NIHは長年蓄積してきた膨大な生物医学データを全面的に開放します。
プロジェクトの目標は至ってシンプルです。生命の振る舞いを精密に予測できるAI体系を構築することであり、Biohubはこれを「バーチャル・バイオロジー」と呼んでいます。分かりやすく言えば、分子、遺伝子、細胞から完全な生体システムに至るまでの高精度な「デジタルツイン」を創り上げることです。研究者は将来、LLMに質問を投げかけるようにコンピュータ上で生命に対する仮説や介入のシミュレーションを行い、まずデジタル空間で検証を完了させた上で、実環境の実験室へと進むことができるようになります。
この布石は、単にザッカーバーグ氏がバイオ医薬品の将来性を高く買っているからだけではありません。さらに深層を見れば、生命科学こそがAI競争の「第2の主戦場」となりつつあるからです。汎用大規模言語モデルの領域はすでに熾烈な「軍拡競争」へと突入し、計算資源、人材、資本の参入障壁は高止まりしています。一方で、生命システムの解明とモデリングは、いまだフロンティアの広がるブルーオーシャンです。AIに真の意味で「生命」を理解させることができた者が、チャットボットを遥かに凌駕する技術的参入障壁を築き上げることになります。
分子設計は得意でも、依然として険しい創薬の道
AIとバイオ医薬品の融合には長い歴史があり、人工知能が最も早くから産業化を期待されてきた領域の一つでもあります。しかし10年以上の進化を経てもなお、業界の前には根本的な疑問が立ちはだかり続けています。「私たちは本当に、新薬の誕生へと近づいているのだろうか?」
近年、AI創薬における目覚ましいブレイクスルーの多くは分子レベルに集中していました。タンパク質の立体構造予測、候補化合物のスクリーニング、分子のデノボ(ゼロからの)生成、薬物動態・安全性の予測、標的タンパク質と薬物の相互作用解析などです。AIは数千〜数万もの候補分子を一度に生成し、探索可能なケミカルスペースを劇的に拡大させました。研究開発効率の大幅な向上は疑いようもありません。
しかし、評価の基準を「アルゴリズムのスコア」から「一握りの新薬が実際に承認・上市されること」へと移すと、現実は極めて過酷です。今年8月、『Nature Reviews Drug Discovery』誌は10年以上にわたるAI創薬の歩みを総括するレビューを発表しました。無数のAIアルゴリズムが誕生したにもかかわらず、真に実質的な臨床価値を生み出した成果は依然として極めて限定的です。多くのAI創薬スタートアップのプロジェクトが前臨床や第I相・第II相臨床試験の段階で長期間停滞しており、第III相へと駒を進められた事例は数えるほどしかありません。
低分子化合物の生成において、AIは確かに標的タンパク質との結合親和性が高い分子をスクリーニングすることに長けています。しかし、これはあくまで「リガンド設計」に過ぎず、包括的な「創薬設計」とは到底呼べません。標的に結合する分子を見つけることと、人体内で安全性と有効性を両立させる医薬品を作り上げることの間には、次元の異なる難題が存在します。
これこそが、業界全体が今まさに省みなければならない核心です。これまで私たちは、極めて複雑な生命プロセスを過度に単純化しがちでした。AIは「どの分子がこの標的に結合できるか」を答えることには極めて長けていますが、創薬が真に対峙すべきなのは、より深層にある一連のシステム的課題です。
- なぜその標的が疾患を引き起こすのか?
- 標的に介入した際、生体システム内でどのような複雑なドミノ倒し(カスケード反応)が引き起こされるのか?
- なぜ同じ薬剤でありながら、患者によって劇的に異なる治療効果が現れるのか?
- なぜ細胞培養や動物モデルで劇的な効果を示した薬が、ヒトの臨床試験に入った途端にことごとく失敗するのか?
薬物分子が単独で機能することは決してありません。それは、遺伝子、タンパク質、細胞、組織、臓器、免疫系、代謝ネットワークが複雑に絡み合い、外部環境からも絶え間ない影響を受け続ける、極めて動的で巨大なシステムの中へと入っていくのです。新薬開発の成否を分ける鍵は、まさにこのシステムの中に深く根ざしています。ここから一つの根本的な命題が浮かび上がります。「AIが分子しか読めず、生命システム全体を理解できないままで、新薬開発をどれほど先まで推し進めることができるのか?」
単点分子モデルから「生命ワールドモデル」へ
これこそが、2026年にAIライフサイエンスにおいてパラダイムシフトが巻き起こっている核心的な理由です。モデリングのスケールはもはや単一のタンパク質、分子、細胞にとどまらず、システム階層へと引き上げられ、生命予測モデルの構築へとシフトしています。目指すのは単なる空間構造の予測ではなく、生命状態を動的に捉え、介入を受けたシステムの推移を予測し、外的ストレスに対する細胞の応答をシミュレーションすることです——これこそが、業界が定義する**「生命ワールドモデル(Life World Model)」**です。
大規模言語モデルが人類の言語の文法や論理を学習し、物理ワールドモデルが物体の運動や時空間の法則を学習するのだとすれば、生命ワールドモデルが対峙するルールやメカニズムはそれらを遥かに凌駕する複雑さを持ちます。遺伝子変異がタンパク質の発現を変え、タンパク質ネットワークがシグナル伝達経路を制御し、シグナル伝達が細胞の状態を再構築します。さらに細胞間の相互作用が組織の微小環境を形成し、それが階層的に臓器機能、ひいては人体全体へと波及していきます。生命そのものは決して静止した構造物ではなく、成長、老化、代償、変異を繰り返す動的な進化の渦中にあり、外部からの介入に対して絶えずフィードバックを返し続けます。
したがって、生命ワールドモデルは決して静的な「生命の百科事典」ではありません。その真の使命は、生命の稼働メカニズムの根底を解明し、ある変数が変化したときに複雑なシステム全体がどのように変化していくかを精密に予測・演繹することにあります。
このモデルが実用化されれば、創薬研究におけるAIの位置付けは根本から塗り替えられます。
- 従来モデル:既知の標的に対して、候補分子を高速・ハイスループットでスクリーニングする。
- 新モデル:特定の疾患に対し、まず発症メカニズムと根源を突き止め、その上で介入標的の評価、ベネフィットを享受できる患者層の選定、介入が生体全体に引き起こし得る連鎖反応を事前に予測する。
同じ「AI創薬」という看板を掲げていても、両者が解決しようとしている根底の課題は、もはやまったく別次元のものなのです。
中国国内の同時並行の動き:国家計画に盛り込まれた「計算医学」
この根底からの技術転換は、海外だけで起きているわけではありません。中国国内のAIライフサイエンス領域においても、「単一アルゴリズムの突破」から「システム的な疾患モデリング」への飛躍が同時に進んでいます。
今年9月、工業情報化部や国家発展改革委員会など10部門が共同で策定した『医薬品産業発展「第15次5カ年計画」』において、「計算医学(コンピューテーショナル・メディシン)」が人工知能、量子コンピューティング、スーパーコンピューティングと並び、今後5年間の医薬品産業における重点技術分野として初めて明記されました。AIとスパコンが強力な汎用計算基盤を提供するのに対し、計算医学の核心的価値は、それらの計算リソースを極めて複雑な生命システムへと接続し、現実の臨床疾患の難題を解決することにあります。
中国の哲源科技(Zheyuan Technology)は、まさにこの技術的アプローチを実践するパイオニアです。同社のチームは、単にパラメータ数の大きなバイオ特化型基盤モデルを追い求めるのではなく、疾患そのものにフォーカスしています。ゲノミクス、細胞動態、病因メカニズム、患者表現型、薬物介入などの多次元データを網羅的に統合し、多層的な計算モデルを構築。継続的な推論、学習、検証を可能にする「生命ワールドモデル体系」の構築を目指しています。
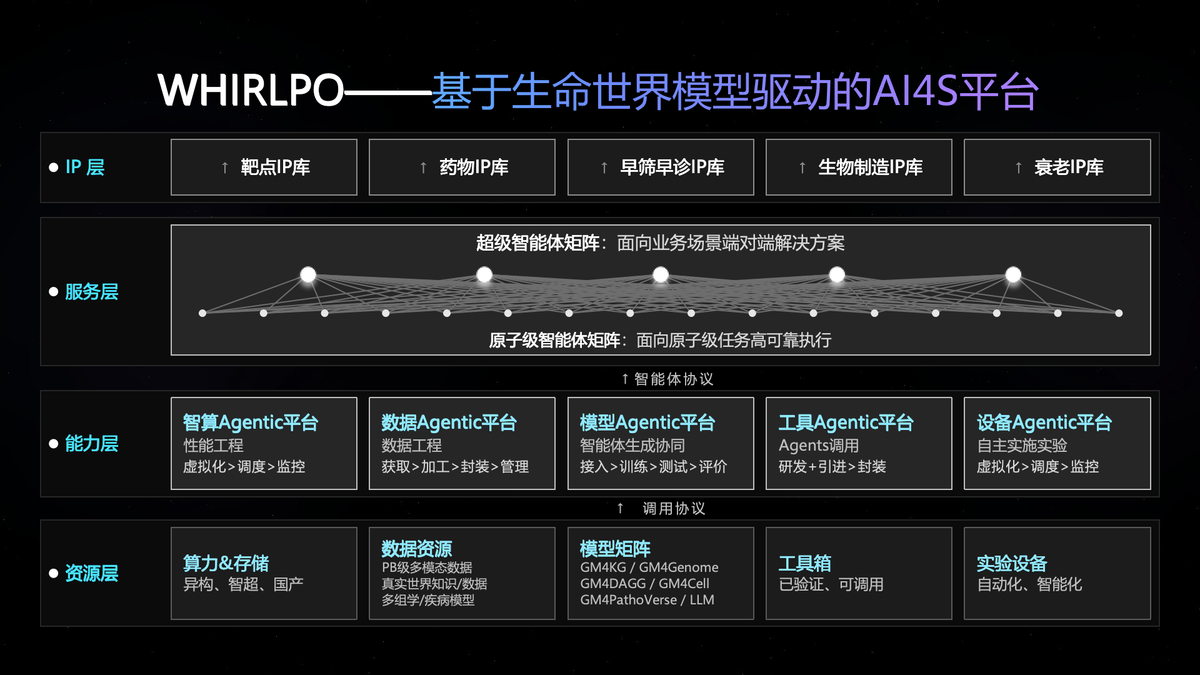
10月17日、哲源科技は計算医学プラットフォーム「WHIRLPO」を正式にリリースしました。このプラットフォームは単一の特化型バイオモデルではなく、さらに基盤となるエンジニアリングの難題を解決するために設計されています。もし生命ワールドモデルが次世代ライフサイエンスの礎となるのであれば、業界にはこうした複合モデルの持続的な学習と高効率な運用を支える、強固なインフラストラクチャが不可欠だからです。
生命ワールドモデル構築の難度は、LLMの学習を遥かに凌駕する
生命ワールドモデルを構築するエンジニアリング上の難度は、外部から過小評価されがちです。
- マルチモーダルかつ異種(ヘテロジニアス)データの難題:LLMはインターネット上の膨大なテキストデータを糧に成長しますが、生命科学の領域には標準化・統合された公開データセットが決定的に不足しています。ゲノミクス、シングルセル解析、空間オミクス、病理組織切片、医用画像、臨床コホートデータは極めて分散しており、データフォーマット、品質基準、観測スケールも大きく乖離しています。高付加価値なデータの多くは、ウェットラボによる特注の実験からしか得られません。Biohubが投じる18億ドルの資金のうち、かなりの割合が単なるモデル推論や計算リソースの消費ではなく、高品質な生物学的データの標準化された生成プロセスに充てられているのもこのためです。
- マルチスケール・クロスレイヤーのモデリングの難題:生命科学の領域には、万物を包括するような単一の「統一モデル」は存在しません。DNAの変異、細胞の状態遷移、組織微小環境の変遷、そして人体における疾患の進行を解析するには、それぞれのスケールに特化した専門モデルを有機的に協調させる必要があります。将来完成する生命ワールドモデルは、おそらく単体の巨大なニューラルネットワークではなく、マルチスケールモデル、構造化された知識ベース、専門的なツールチェーンが高度に融合した複合協調システムとなるはずです。
- ヘテロジニアスな科学技術計算におけるエンジニアリングの壁:モデルの事前学習、マルチオミクス統合解析、疾患推移のシミュレーション、デジタル患者のモデリングなど、タスクごとに要求される計算特性は大きく異なります。CPUやGPUをはじめとする多様なヘテロジニアス計算リソースを低レイヤーで柔軟にスケジューリングし最適化する必要があり、従来の一般的なLLM開発ではほとんど直面しないハイパフォーマンス・サイエンティフィック・コンピューティング(HPC)のエンジニアリング課題が山積しています。
- バーチャル計算とウェットラボのクローズドループの難題:LLMであれば、誤った出力が出てもアルゴリズムの改良や再学習で対応できます。しかし、生命モデルが導き出した標的仮説やメカニズムの判定は、必ず実験室(ウェットラボ)に持ち込んで生物学的な実証を行わなければならず、その実験結果をモデルのパラメータへとフィードバックして修正し、最終的には厳格な臨床試験を通過しなければなりません。モデルの推論ロジックは、コンピュータの中だけの「仮想的な自己無撞着」で完結することは許されないのです。
WHIRLPOプラットフォームは、まさにこれらのボトルネックの解消に焦点を当てています。ヘテロジニアスなコンピューティングクラスタ、マルチオミクス生命データセンター、専門モデルマトリクス、先端研究ツール、自律型AIエージェント、そして実験クローズドループの連携パイプラインを統合。モデル学習、科学計算からウェットラボでの実証検証に至る全プロセスをカバーするインフラストラクチャを構築しました。要するに哲源科技は、単にモデルを作っているのではなく、生命ワールドモデルのための「工業化生産プラットフォーム」を築き上げているのです。
AIライフサイエンスは「インフラ競争」の新ステージへ
2026年、世界の生命科学・計算科学領域は強烈な共振を見せています。
- 米国では、Biohubがエネルギー省、NIH、Meta、DeepMindらと手を組み、バイオAIに必要なデータ、計算資源、実験インフラの構築を加速させています。
- 中国では、「計算医学」が国家の「第15次5カ年医薬品産業計画」に正式に盛り込まれ、国内チームが生命ワールドモデルの基盤エンジニアリングプラットフォームの構築を急ピッチで進めています。
これら二つの動きは一見独立しているように見えますが、実質的には同一の業界コンセンサスを指し示しています。**「AIライフサイエンスは、単一アルゴリズムのベンチマークを競い合う段階を終え、包括的な基盤インフラの競争時代へと全面的に突入した」**ということです。
かつて業界が競い合っていたのは、「誰のタンパク質構造予測がより高精度か」「誰の分子生成アルゴリズムが優れているか」「孤立した開発プロセスの効率をいかに向上させられるか」でした。しかし、次のステージにおける真の競争障壁は、以下のように変貌を遂げています。
- 大規模かつ高次元な高品質の生命科学データを獲得できるか
- 遺伝子、細胞、組織、臓器を跨ぐマルチスケールのシステムモデリングを実現できるか
- 異種モデル群と多様な計算資源を高度にスケジューリングし、協調動作させられるか
- 計算シミュレーションとウェットラボ実験のシームレスなクローズドループ検証を確立できるか
- そして最終的に、AIを「断片的な生命データの処理」から「動的な生命システムの深層理解」へと真に飛躍させられるか
AI創薬が歩んできたこの10年余りを振り返ると、その探求の方向性は決して間違っていませんでした。ただ、これまでは生命メカニズムの中で計算複雑度が比較的制御しやすい部分を優先的に攻略してきたに過ぎません。分子構造が創薬の重要な基盤であることは間違いありませんが、医薬品が最終的に治療対象とするのは「孤立した分子」ではなく「生体としての人間」です。1つの有望な活性分子が、生体内で確実な臨床効果を生み出すまでの間には、極めて精密かつ複雑で動的な生体システムが横たわっています。
生命ワールドモデルは、言語モデルや物理ワールドモデルに続く、人工知能の次なる戦略的要衝となる可能性を秘めています。この新たな進化のフェーズにおいて、業界最大のチャンスは、ベンチマークスコアをわずかに更新し続けるチームにはもはやないのかもしれません。真に希少価値を持つコアアセットとは、AIが現実の生命世界へと真に足を踏み入れ、それを理解することを支え切る「統合された包括的インフラストラクチャ」なのです。