
UBTECHの「Thinker-WM」、主要なエンボディド・ワールドモデルベンチマーク3種すべてで首位を獲得
01 主要3大ベンチマークで完全制覇、Thinker-WMが3冠を達成
先日、UBTECHの「Thinker-WM」が、広く認められているエンボディド・ワールドモデル(Embodied World Model)の主要3大ベンチマーク評価すべてにおいて1位を獲得し、業界最高記録を更新しました。
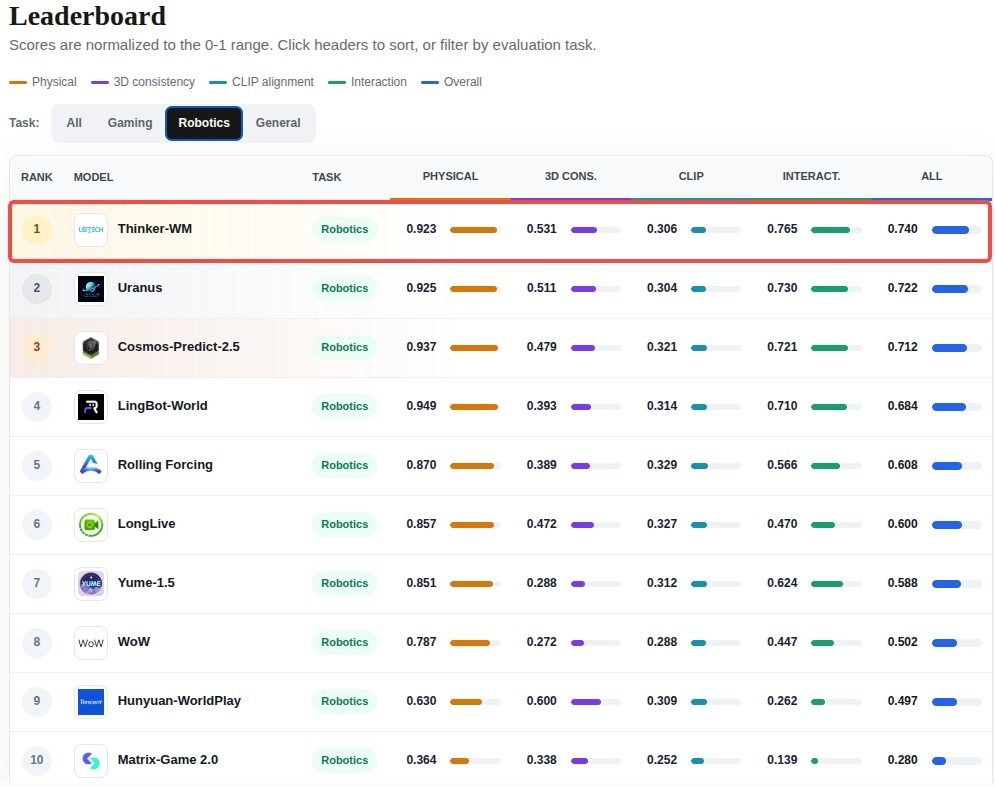
WorldOlympiad:
Thinker-WMは総合スコア0.740を獲得し、首位に立ちました。このベンチマークは、膨大な実機ロボットのインタラクションデータに基づいて構築されており、10種類以上の異なるロボット機体や多様なカメラ構成をカバーし、モデルのクロスモーダル・クロスビュー(異なる形態や視点間)の汎化能力を重点的に評価します。詳細な評価において、本モデルは3D一貫性(3D Consistency)で0.531、インタラクション忠実度(Interaction Fidelity)で0.765を記録。これら2つの単独指標はいずれも全参加モデルの中でトップとなり、3次元幾何構造とロボットのインタラクションプロセスに対する高精度なモデリング能力が実証されました。
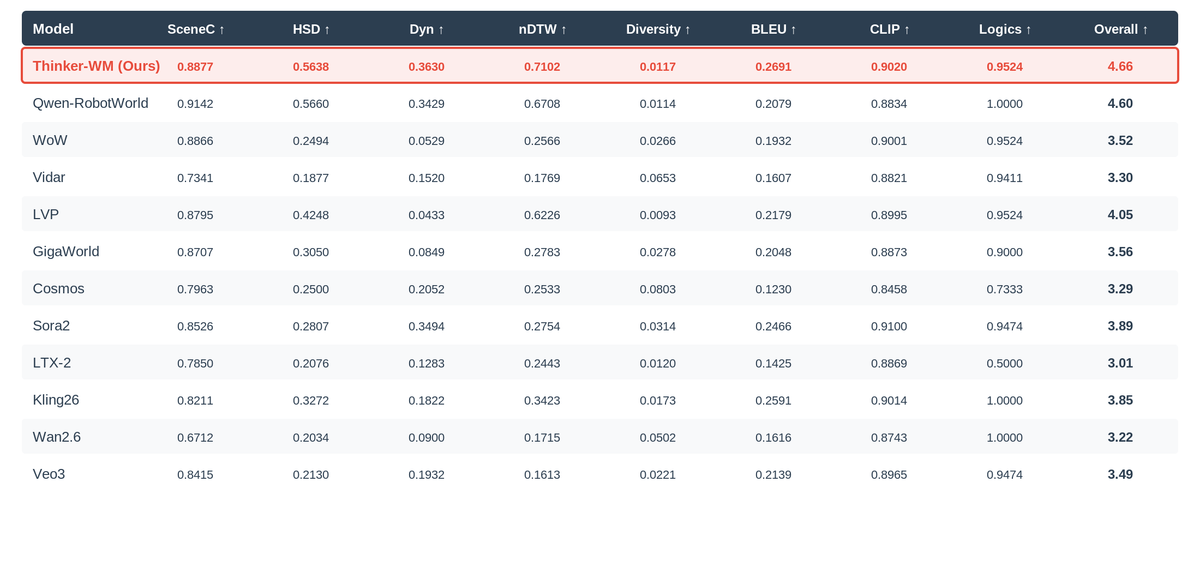
EWMBench:
Thinker-WMは総合スコア4.66を獲得し、Qwen-RobotWorldやSora2などの主要モデルを上回りました。EWMBenchは、シーンの一貫性、ロボットのエンドエフェクタの動作の正確性、そして指示のセマンティックアライメントという3つの能力次元を包括的に評価します。表現層におけるマルチモーダル統合モデリングの恩恵により、Thinker-WMはロボットの軌跡における時空間マッチング度を測定するnDTW(正規化動的時間伸縮法)や、運動速度および加速度の妥当性を評価するDyn(動力学的一貫性)など、ロボット運動の主要なコア指標において一貫してリードを保ちました。
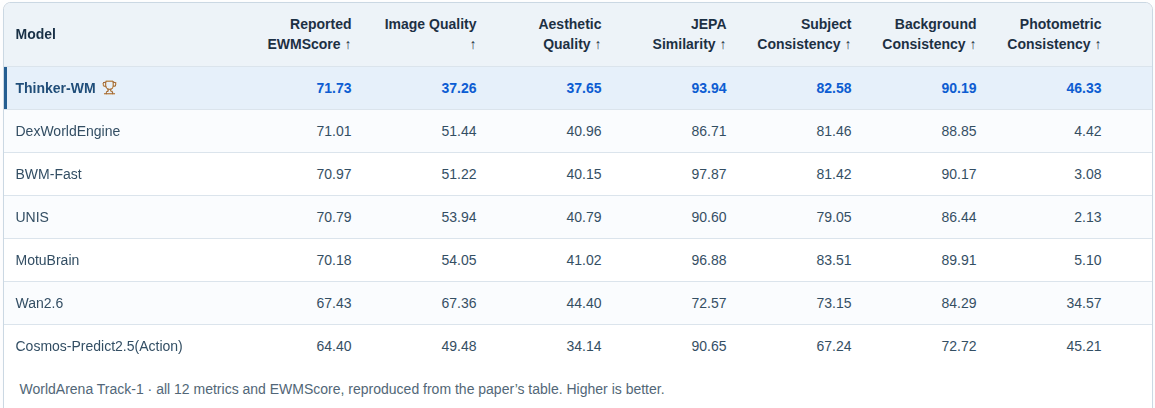
WorldArena1.0 Track-1:
シミュレーション環境ベンチマークのWorldArena Track-1において、Thinker-WMは視覚的画質、コンテンツの一貫性、物理的な妥当性、3D幾何精度、指示追従など、12の主要評価項目すべてで全体的なリードを獲得。シミュレーション環境下における視覚的生成品質と物理インタラクションの信頼性を両立させました。Thinker-WMは、表現層で統合されたUnified Dynamic Transformer(UDT)をコアとし、RGB画像、メトリック深度、ロボットのアクションを単一の共有動的表現の中で結合・進化させることで、動画とアクションの同時生成、世界の予測、ポリシー推論、動画からアクションへの変換、逆動力学など、多岐にわたる機能の統合を実現。エンボディドAI(具身知能)に向けた次世代の基盤的ワールドモデルの土台を提供しています。
02 Thinker-WMの技術的ブレークスルー:表現層における視覚・幾何・アクションのマルチモーダル統合
ロボットを実世界で稼働させタスクを遂行させる際、最も難しいのは目の前の物体を認識することではなく、環境が次にどのように変化するかを正確に予測することです。これこそがワールドモデルの核心的な価値でもあります。従来のワールドモデルは、動画生成が画面を担当し、ポリシーネットワークがアクションを担当し、幾何予測が空間情報を担当するといった「モジュール連結型」の手法が一般的でした。各モジュールが独立して計算を行い、インターフェースを介して出力をつなぎ合わせていたのです。
しかし、このアーキテクチャには構造的な欠陥があります。アクションは環境を変化させ、環境はアクションを制約し、幾何構造はその双方に同時に影響を与えます。実世界で緊密に結合している信号を人為的に異なるモジュールへと切り離してしまうと、本質的な因果関係が損なわれてしまいます。
例えば、「コップが机から押し落とされる」という物理イベントは、言語では1つの文として記述され、アクションでは一連の関節制御コマンドとなり、動画では画面を横切る物体の運動として現れ、深度情報では連続的に変化する距離場となります。これら4つの表現は同じ1つのイベントを指し示しているにすぎず、4つの異なる対象を意味しているのではありません。したがって、モデルにいずれかのモダリティを生成させることは、本質的に同一のプロセスを推論していることになります。
しかし、モダリティ間の情報重複は完全ではありません。アクションには外観やコンテキストが含まれません。まったく同じ関節コマンドであっても、何もない机の上と散らかった机の上とでは意味が大きく異なります。言語には時空間の微細な詳細が含まれません。「コップが机から押し落とされる」という表現は、押し出す力の向き、強さ、速度を規定しておらず、手の具体的な軌跡やコップが転がる回転数、着地点も特定しません。動画には明示的な幾何構造や測定値が含まれず、ピクセルの並びからはコップの正確なサイズも絶対距離も分かりません。そして深度情報には外観、意味(セマンティクス)、意図が含まれていません。表面の遮蔽関係や接触幾何を示すことはできても、その物体がコップなのかテーブルクロスなのかを識別することはできず、押し倒すという動作の意図を説明することもできません。
こうした課題に対し、UBTECHのThinkerチームは新たなアプローチを提示しました。それは、インターフェース層での単純な結合にとどまらず、表現層(Representation Level)においてマルチモーダルを深く統合することです。UBTECH独自開発の統合マルチモーダル・ワールドモデルであるThinker-WM(Thinker World Model)は、RGB動画、深度情報、ロボットのアクションを同一の中間表現空間へと統合エンコードし、共有パラメータに依存して共同進化させます。外観、幾何、アクションはもはや分断された3つのパイプラインではなく、同一の物理世界における進化プロセスの3つの発現形態となります。Thinker-WMの根本的な設計思想は、「異なるモダリティはいずれも同一の物理プロセスの異なる局面にすぎない」という点にあります。モデルは、モダリティの境界面で機械的に条件を継ぎ接ぎするのではなく、共有表現空間の中でアライメントを完結させ、推論を行います。
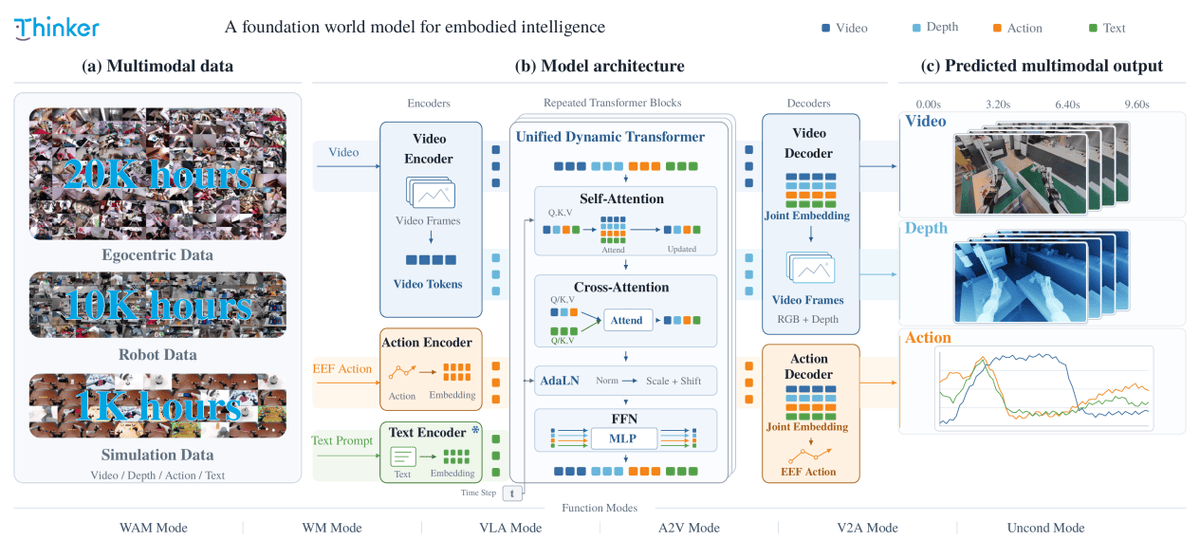
Thinker-WM:視覚・幾何・アクションの統合モデリングフレームワーク
具体的には、RGB画像、深度情報、ロボットのアクションがそれぞれ専用のエンコーダを介して統合潜在空間へとマッピングされ、続いて共有のUnified Dynamics Transformer(UDT)に入力されて時系列モデリングが共同で行われます。最終的にそれぞれのデコーダによって動画、深度マップ、ロボットの実行可能アクションへと復元・出力されます。これは、マルチモーダルのインタラクションがTransformerの内部で完結することを意味し、視覚トークン、幾何トークン、アクショントークンが同一のアテンション機構を通じて直接情報をやり取りするため、入出力層での浅い接合を回避できます。
また、幾何情報はもはや単なる補助的な教師信号として存在するだけではありません。Thinker-WMは深度をネイティブな生成モダリティとして扱い、動画と一貫した潜在トポロジーおよび時空間構造を共有します。深度による教師が共有表現を直接形成するため、物理空間の構造は外付けの追加モジュールではなく、ワールドモデルの「母語」となり、ロボットが物理空間をより正確に理解できるようサポートします。この統合モデリングの価値は実際のタスク実行でも実証されています。RoboTwinの単一タスクアブレーション実験では、深度モダリティを導入したことで、深度なしのベースラインと比較してタスク操作の成功率が15パーセントポイント向上しました。これは、空間幾何情報がシーンの理解に寄与するだけでなく、アクション生成とタスク実行の品質を大幅に向上させることを示しています。
03 統合表現を基盤に、単一モデルで6つの能力を解放
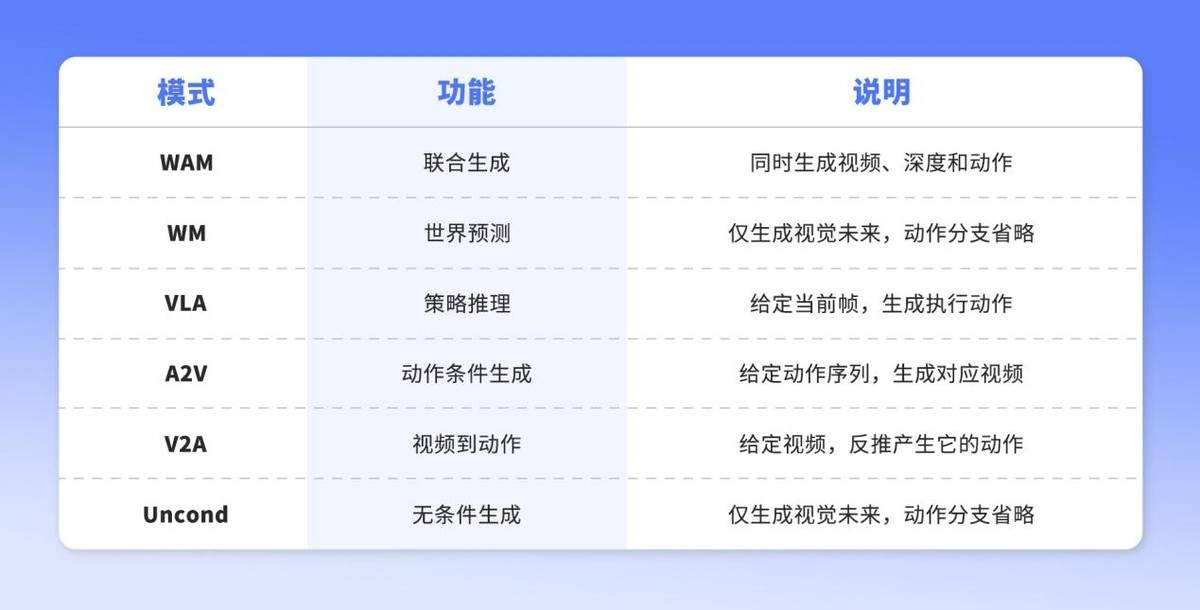
マルチモーダル統合表現と共有パラメータの設計により、Thinker-WMは条件モダリティと生成モダリティを柔軟に切り替えることで、6つの能力モードをネイティブにサポートします。
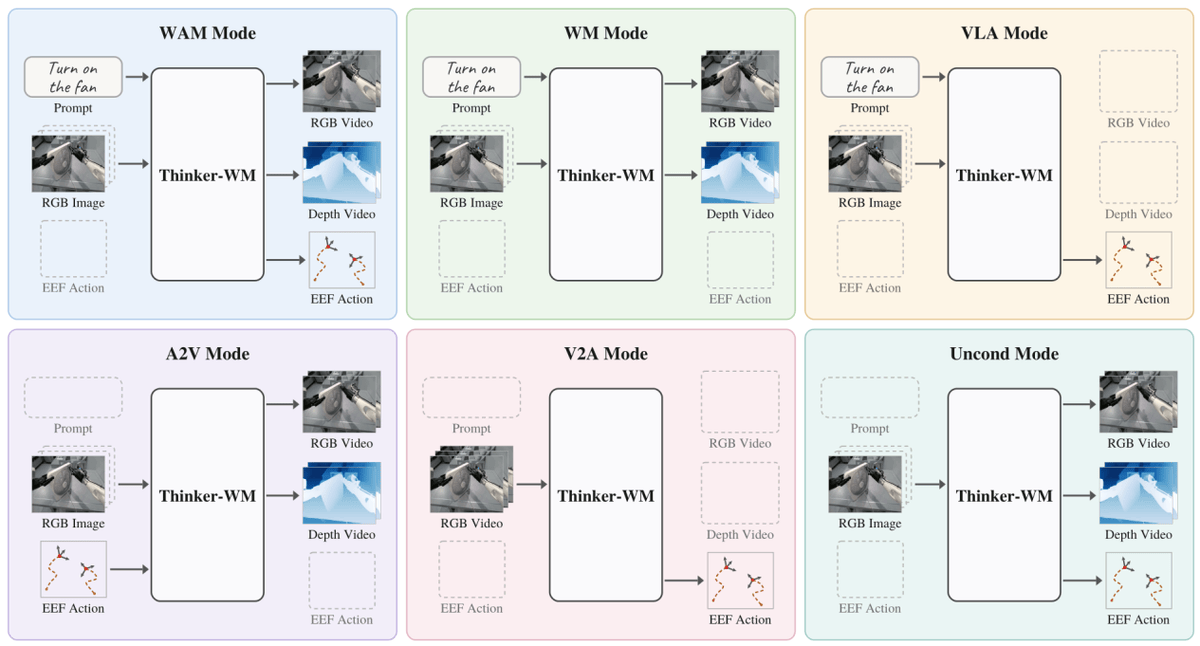
同一のモデルウェイトでありながら、未来の映像を先回りして予測・イメージすることも、ロボットの実行軌跡を逆算して推論することも、さらには動画からアクションコマンドを逆抽出することも可能です。これこそが、統合表現がもたらす最大の技術的恩恵です。
04 3万時間のヘテロジニアスデータが支える、汎用ワールドモデルの基盤
統合表現能力の背景には、UBTECHの大規模かつ多様なトレーニングデータによる強固なサポートがあります。Thinker-WMの学習コーパスは、エンボディドAI分野において極めて大規模なデータ量を誇ります:
- 約2万時間の一人称視点の人間の動画:家庭、小売店舗、工場など多様なシーンを網羅。ロボットのテレオペレーション(遠隔操作)では低コストでの収集が困難な、多種多様なタスク、物体、環境のギャップを埋めており、約1,000時間のアライメント済み深度データも併せて整備。
- 約1万時間の実機ロボットデータ:複数の異なる形態のロボット機体から収集され、視覚観測と実行可能アクションのペアによる教師信号を提供。このうち約3,000時間には高精度なアライメント済み深度アノテーションが付与。
- 約1千時間の高忠実度シミュレーションデータ:高精度な幾何情報と物理インタラクションの教師信号を提供。
ロボットごとにアクション空間、座標系、制御プロトコルは大きく異なります。Thinker-WMの統合思想はモデルアーキテクチャにとどまらず、データエンジニアリング全体にも徹底されています。本モデルでは、すべてのロボットのアクション出力をエンドエフェクタの姿勢(Pose)として統一して表現し、トークン内に各機体の専用識別子を埋め込んでいます。これにより、異なる形態のロボットが同一の生成空間を共有しながらも、それぞれの機体に適した高精度な制御能力を保持することが可能になります。
05 データインフラ:膨大なヘテロジニアスデータを統合モデルの学習へと効率的に供給
膨大なヘテロジニアス(異種)データをモデルの能力へと高効率に変換するには、堅牢で効率的なデータインフラが不可欠です。異なるロボット、人間の動画、シミュレーションデータの間で生じるフォーマット、モダリティ、アノテーション次元の違いに対処するため、UBTECHのThinkerチームはデータプラットフォーム「Data Factory」を独自開発しました。データ管理と学習サンプリングを疎結合化することで、マルチソースのヘテロジニアスデータを必要に応じて柔軟に組み合わせられるようにしています。
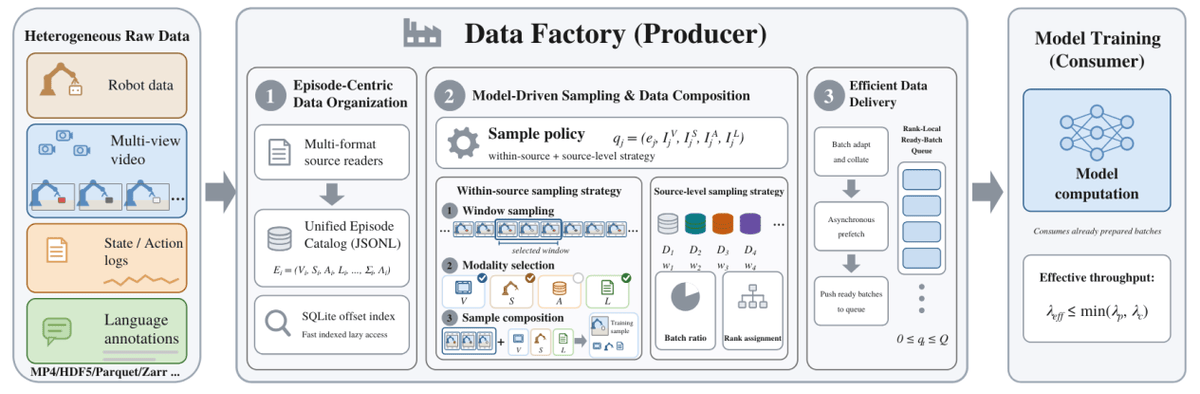
Data Factory:マルチソース・ヘテロジニアスデータから統合モデルの学習へ
Data Factoryは、以下の3つのコアメカニズムを軸にモデル学習を支えています:
- 統合的なデータ編成:動画、ステート、アクション、言語情報を標準化して統合し、異なる学習モードに応じて学習サンプルを動的に生成。
- 階層的な品質検証:異常なセグメントを自動フィルタリングし、深度と動画の時空間アライメントを厳格に検証することで、学習信号の信頼性を担保。
- 非同期プリフェッチとエンコード再利用:学習データを先行してスケジューリングおよびロードし、待機時間や重複計算のオーバーヘッドを大幅に削減。
このデータインフラにより、マルチソース・ヘテロジニアスデータの確実な組織化、柔軟なスケジューリング、高効率な供給が実現し、Thinker-WMにおける6つの能力モードの共同学習と持続的なイテレーションのための堅牢なエンジニアリング基盤が確立されました。
06 Motion Probe 実験設計:クロスモーダル表現の真の結合を検証
表現層でのマルチモーダル統合は本アーキテクチャの最大の特長ですが、これには1つの重要な疑問も生じます。「モデルは共有潜在空間の中で視覚、幾何、アクションの間の因果的結合を真に学習しているのか? それとも単に複数の入力を並行処理し、形式的に共存させているだけなのか?」
この疑問を検証するため、UBTECHのThinkerチームは軽量な「Motion Probe(モーションプローブ)」検証実験を設計しました。研究チームは、ウェイトを凍結したUDTの視覚表現層の直後にごく小さな運動予測ヘッドを接続し、この予測ヘッドのみをトレーニングして、純粋な視覚表現だけからエンドエフェクタの変位軌跡を正確に復元できるかをテストしました。
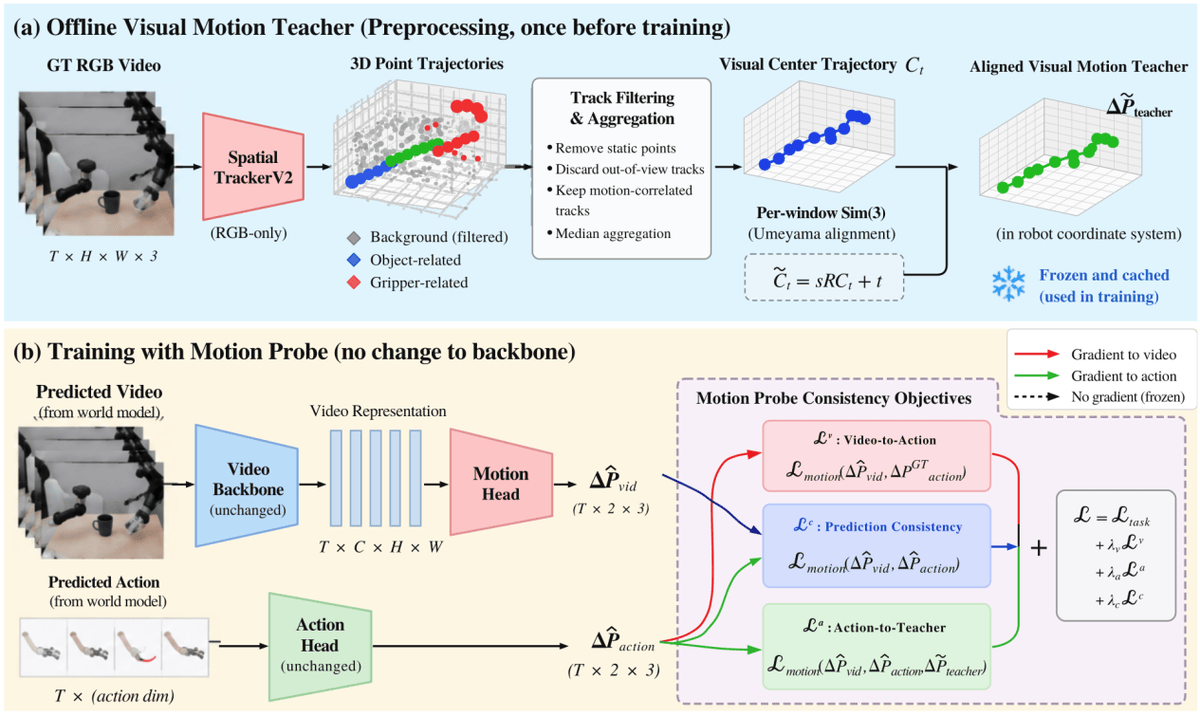
Motion Probe の概要
実験結果は仮説を裏付け、プローブの予測誤差は極めて低い数値を示しました。アクションの教師信号から切り離された状態であっても、視覚表現の中にはすでに高精度なアクションの運動情報が埋め込まれていたのです。この結果は、Thinker-WMの表現層におけるマルチモーダル統合が真に機能しており、視覚的知覚とアクション計画が互いに独立したパイプラインではなく、共有潜在表現の中で深層の因果結合を形成していることを明確に証明しています。
07 これが意味するもの
Thinker-WMによる今回の技術的ブレークスルーの価値は、ベンチマークランキングの首位獲得にとどまらず、エンボディド・ワールドモデルの進化における新たなパラダイムを確立した点にあります。
エンボディドAIにおけるワールドモデルは、「動画生成器+ポリシーヘッド」のような外付けのツギハギであってはならず、本質的に統合された時空間生成システムであるべきです。視覚的観測、空間幾何、アクション計画は、本質的に同一の物理イベントが異なるモダリティに投影されたものにすぎません。
ロボットが統合された表現空間の内部で、画面の変化、空間幾何、アクション軌跡を同時に推論できるようになれば、物理世界の因果論理に対する理解は質的飛躍を遂げます。これこそが、ロボットが「指示に従って機械的にタスクを実行する」段階から、「物理世界の動作原理を自律的に理解する」段階へと踏み出すための決定的な一歩となります。
現在、Thinker-WMはすでにUBTECHのロボットプラットフォーム上でのデプロイ・検証を完了しており、関連技術は次世代のエンボディドAIシステムを継続的に強化していく予定です。
Thinker-WMのテクニカルレポートや今後のアップデートバージョンは、UBTECHの公式エンボディドAI開発者コミュニティ「Thinker Cosmos」にて随時公開されます。また、ワールドモデルの二次開発機能の開放計画や、技術解説のライブ配信なども順次展開される予定です。
プロジェクトリンク
- 論文リンク: https://arxiv.org/abs/2610.18447
- プロジェクトページ: https://thinkercosmos.ubtrobot.com/thinker-wm
- GitHub: https://github.com/UBTECH-Robot/Thinker-WM
- Hugging Face: https://huggingface.co/UBTECH-Robotics/Thinker-WM