
今回新たにリリースされた Apertus 1.5 は、8B および 70B の Apertus 1.0 モデルをベースに拡張されており、画像・音声の理解機能、オプションの思考モード(thinking mode)、4倍に拡大されたコンテキストウィンドウ、強化された指示追従性、そして向上したツール利用機能が追加されています。アップデートされた 8B と 70B のモデル重みは、2026年7月24日に Apache 2.0 ライセンスの下で Hugging Face に公開されました。詳細についてはプロジェクトの技術レポートに記載されており、本記事でもその概要を紹介しています。 Apertus 1.5 は、第1世代モデルをベースとした継続事前学習(continued pre-training)によって構築されています。8B モデルには 4兆(4 trillion)トークン、70B モデルには 2兆トークンのテキストおよびマルチモーダル訓練データが追加され、総訓練データ量はそれぞれ 19T および 17T トークンに達しています。これまでのすべての Apertus リリースと同様に、これらのモデルは完全にオープンです。重みのオープン化、データのオープン化、理念(オープンな価値観)のオープン化、そして訓練の詳細の完全な公開が行われています。
主な強化点
- ネイティブマルチモーダル理解: Apertus 1.5 はテキストに加えて画像と音声の入力をサポートし、ドキュメント、図表、写真を会話内で扱えるようになりました。また、話し言葉(音声)の処理にも対応していますが、この機能は現時点では実験的段階にとどまります。
- 思考モード: 思考モードに切り替えることで、回答前に思考プロセスを経て推論を行い、推論系の問題における精度を向上させることができます。
- 長文コンテキスト: コンテキストウィンドウは 262,144 トークンへと拡張され、Apertus 1.0 と比較して4倍になりました。
- 指示追従性の向上: Apertus 1.0 に比べて指示追従性が向上し、より高精度で予測しやすい回答が得られます。
- ツール利用の改善: ツール連携が向上するよう訓練されており、外部ツールや API をより効果的に呼び出すことができます。
- 透明性のある価値基準: 「Apertus 憲章(Apertus Charter)」をより厳密に遵守し、モデルの価値基準と原則における透明性を確保しています。
訓練プロセス
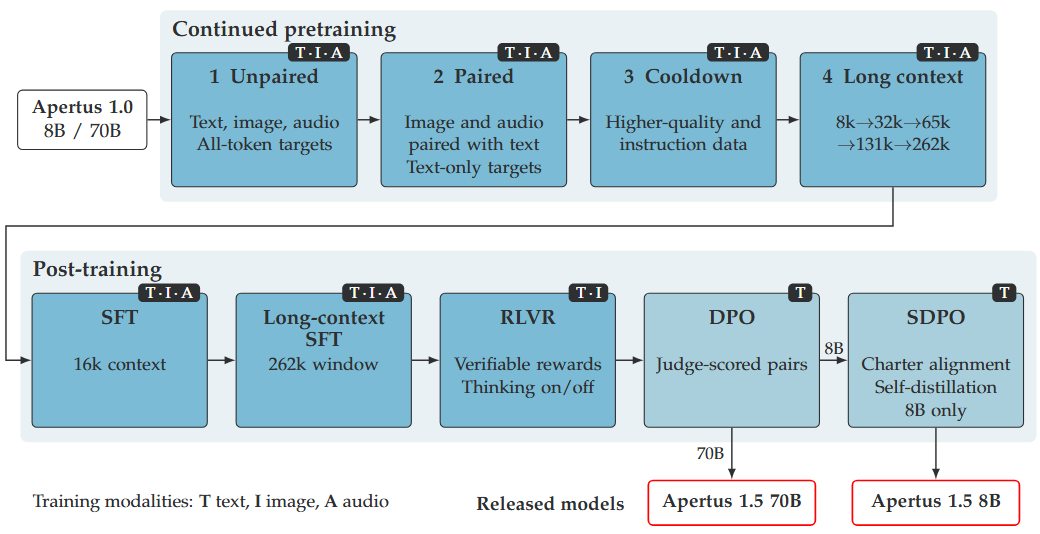 Apertus 1.5 の完全な訓練パイプライン
トークナイザーによるマルチモーダルの実現
v1.5 モデルでは、早期融合(early-fusion)アプローチによってマルチモーダル機能を導入しています。独立したビジョンエンコーダーを使用するのではなく、画像と音声がテキストトークンと同一のシーケンス内で離散トークンとして Apertus に入力されます。画像は Emu3.5 トークナイザーを用いてトークン化されます(512×512 の画像