
Black Forest Labs の FLUX.3 Image Klein がリリースされ、初日から Diffusers で利用可能になりました。単一のモデルでテキストからの画像生成(text-to-image)と複数参照画像を用いた画像からの画像生成(multi-reference image-to-image)の両方に対応し、さらに新機能として**レイアウト制御(layout control)**が追加されました。プロンプト内にバウンディングボックス(bounding box)を記述することで、画像内の各パーツの位置を指定したり、参照画像内のどの部分を移動させるかを指定したりできます。 これら2つのオープンソースのチェックポイント重みは、いずれも FLUX.3 Image Klein コレクション に収録されています:
| チェックポイント(Checkpoint) | 説明 | デフォルトパラメータ |
|---|---|---|
black-forest-labs/flux-3-image-klein | 高速推論向けのタイムステップ蒸留(Time step distilled) | 16 ステップ、CFG なし |
black-forest-labs/flux-3-image-klein-base | ベースモデル(Base model) | 50 ステップ、CFG 有効 |
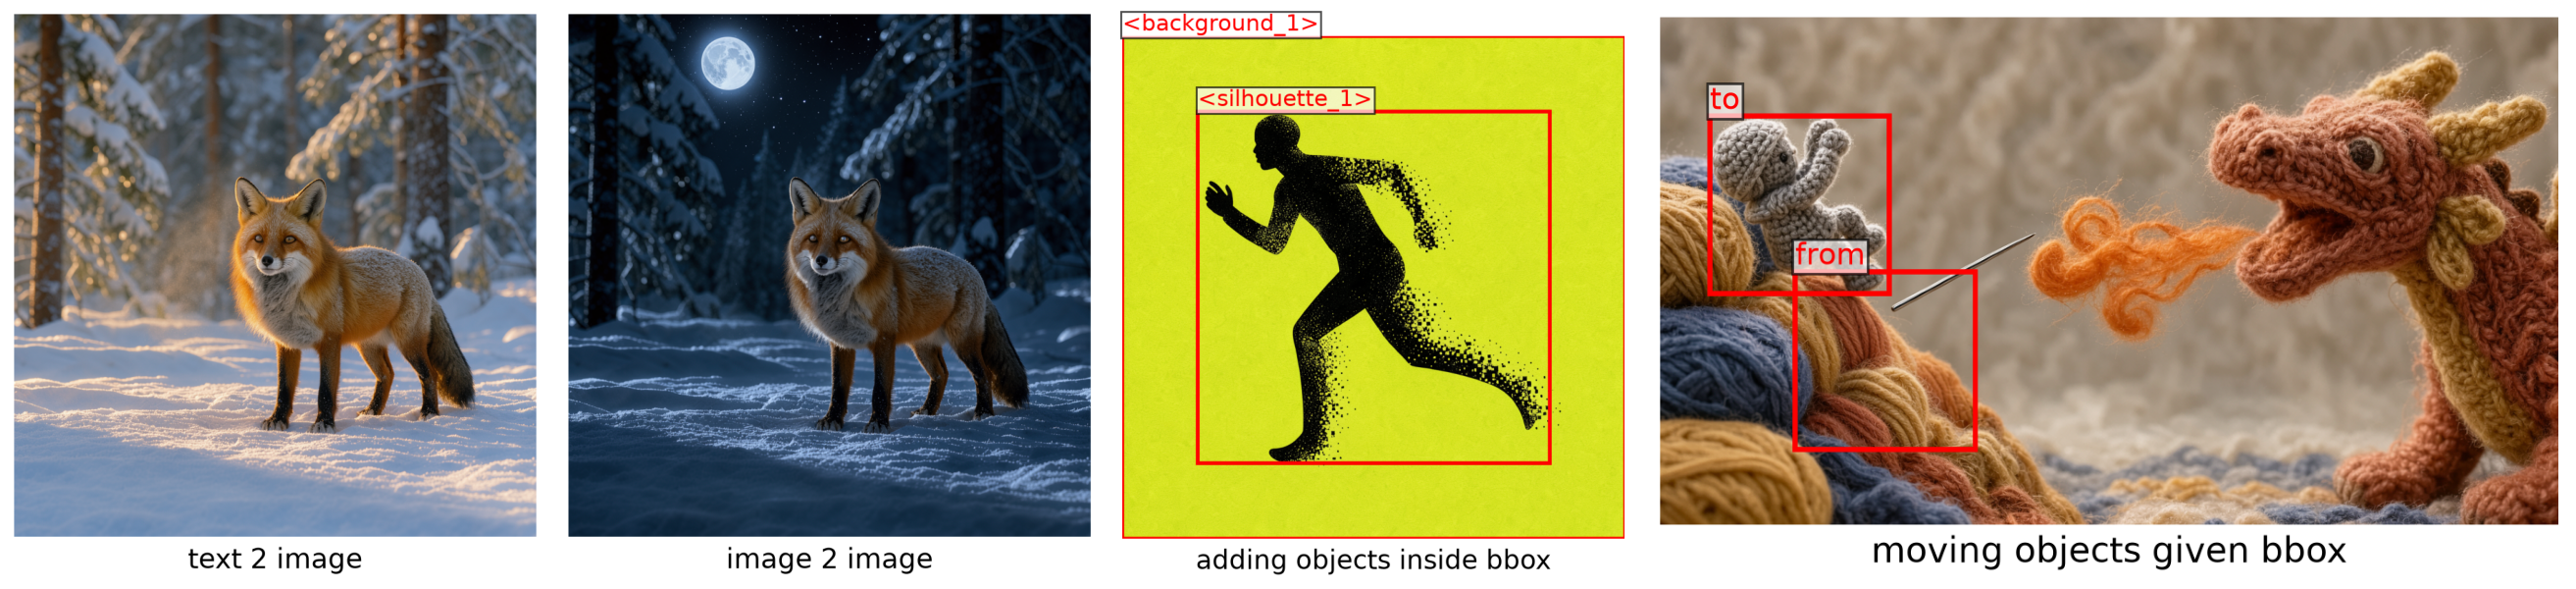
今すぐ Hugging Face Space で実際に画像を生成してみることができます。
要約(TL;DR)
- 単一モデルで Text-to-Image、複数参照画像による Image-to-Image、バウンディングボックスに基づくレイアウト制御を実現。
- 蒸留版チェックポイントは、1枚の H100 上で 1024 × 1024 解像度の画像をわずか約 2 秒 で生成可能。
from_single_file経由での NVFP4 および FP8 重みの読み込みに対応し、VRAM 容量が少ない GPU にも適しています。- Text-to-Image および画像編集に対応した LoRA トレーニングスクリプトを提供。
- モジュラー Diffusers(Modular Diffusers) パイプライン形式で提供されており、必要に応じてカスタムモジュールを自由に着脱・追加可能。