
2026年10月15日 · サイエンス
Pengfei Tian、Maxwell L. Bileschi、Zoi Tsangalidou、Sukhdeep Singh、Lucy J. Colwell
Google Antigravity による科学ワークフローを探索する
深刻化する薬剤耐性危機のなか、新たな抗生物質の開発は急務となっていますが、新規の治療法を見出すプロセスは往々にして時間がかかり、多大な人手を要します。今回、エージェント開発プラットフォーム「Google Antigravity」を活用することで、この研究開発プロセスを大幅に効率化できるようになりました。
Google Antigravity はエージェントベースの科学ワークベンチを提供し、生物学者が価値の高い標的候補を迅速に発見、構造評価、スクリーニングできるよう支援します。これにより、従来は複数のデータベースをまたいで行う必要があった断片的な検索を、単一のセッション内に統合できます。さらに研究者は、アミノ酸配列から直接その生物学的機能を予測できるモデル「ProtNLM」を活用し、UniProt データベース内のこれまで機能が特徴づけられていなかった数百万件ものタンパク質を素早くスキャンすることが可能になります。
本テクニカルウォークスルーでは、生物学者が Google Antigravity を使用して新規の抗菌ペプチド候補を発見した事例を紹介します。このペプチド候補は、呼吸器感染症を引き起こす病原体に対して活性を示すと予測されています。現在、発見されたリード分子はウェットラボでの実験検証が進められています。
新規抗菌ペプチドの探索
深刻化する薬剤耐性(AMR)は、現代において最も緊急性の高い世界的公衆衛生危機のひとつであり、2050年までに年間約1,000万人の命を奪う可能性があると予測されています。この危機に先手を打つには、新たな治療薬の発見が不可欠です。抗菌ペプチド(AMP)、特にバクテリオシン(bacteriocin)は、従来の抗生物質に代わる有望な選択肢として大きな期待が寄せられています。これらは自然の進化過程において、細胞外被から必須の細胞内装置に至る競合細菌の急所を標的とするメカニズムを獲得してきたため、病原体が耐性を獲得するのが極めて困難です。
ゲノムおよびメタゲノムシーケンシングの指数関数的な進展により、世界のデータベースには数十億件もの天然アミノ酸配列が蓄積されてきました。この天然データの宝庫からは、世界中で広く利用されているナイシン(Nisin)などのバクテリオシンや、近年のゲノムマイニングによって得られたダロバクチン(Darobactin)、ディノバクチン(Dynobactin)、ラリオシジン(Lariocidin)といった画期的な分子が生み出されています。
しかし、多くの分子はいまだタンパク質データベースの未アノテーションな「ダークマター」の中に埋もれたままです。これらは既知のタンパク質との相同性に乏しいため、その機能は今日に至るまで解明されていません。例えば、タンパク質配列および機能情報の主要なパブリックリソースである UniProt にも、ゲノムシーケンスプロジェクトから直接取り込まれたものの、機能が未知の配列が数百万件も含まれています。
このギャップを埋めるため、Google は ProtNLM(タンパク質自然言語モデル) を開発しました。これは、アミノ酸配列の根底にある進化の「文法」を直接読み解くよう特別に訓練された深層学習モデルです。これにより、生のタンパク質配列から直接その生物学的機能を予測し、これまで UniProt で未命名だった数百万件のエントリに対して高い信頼性で機能ラベルを付与できるようになりました。
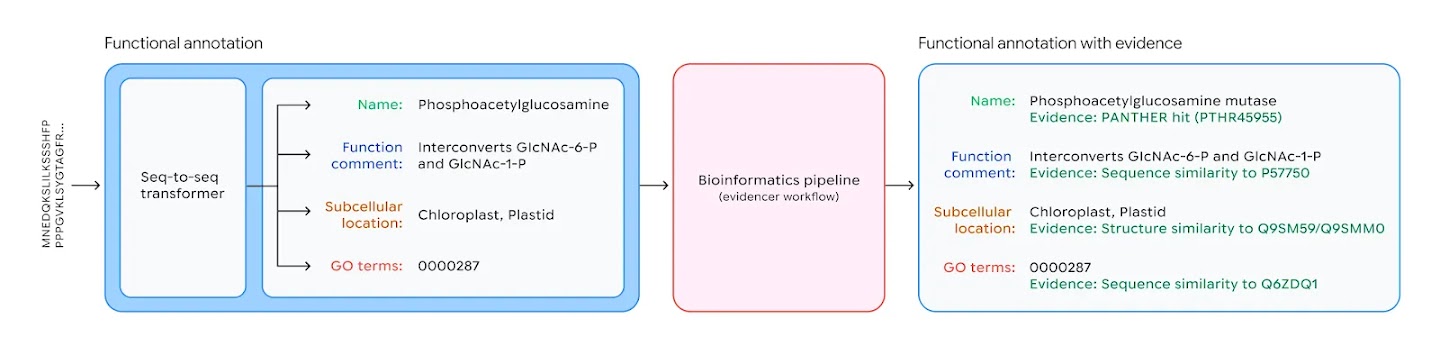
ProtNLM パイプラインの概要:生のタンパク質アミノ酸配列を、未レビューの UniProtKB/TrEMBL エントリに対する自然言語の生物学的アノテーションへと変換する。本システムのアノテーション範囲は、タンパク質名、機能の説明、細胞内局在、遺伝子オントロジー用語(GO 用語)、キーワードに及びます。
協調的インテリジェンス
科学的発見は、往々にして一度で完結するような単一ステップのプロセスではありません。実用的な候補タンパク質を見出すには、人間の直感を組み合わせ、反復的なサイクルを通じて新たな実験的証拠を取り込んでいく必要があります。Antigravity では、研究者と AI エージェントがまず明確な生物学的目標を設定します。それは、偽肺炎連鎖球菌(Streptococcus pseudopneumoniae)を対象に、新規抗菌ペプチド(AMP)を探索し、計算科学的に検証することです。インタラクティブなマルチターンセッションを通じて、研究者はどのような問いを投げかけ、どのような証拠を収集するかという科学的戦略を主導し、エージェントは複数のデータベースにまたがる処理のオーケストレーション、構造解析、文献の統合といった負荷の高いタスクを担います。
スライド 1 / 6
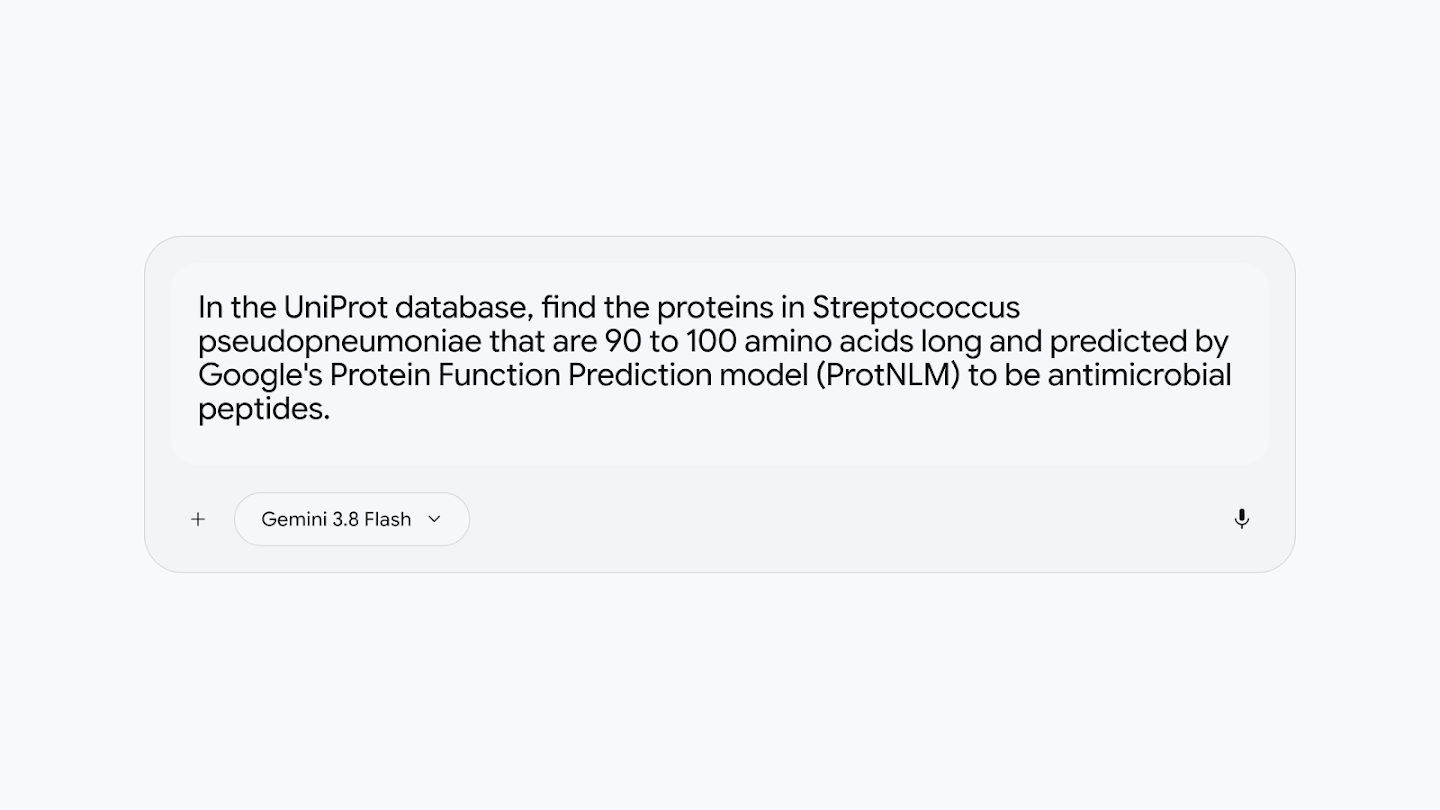
膨大な探索空間のナビゲーション:
エージェントがデータベースを検索し、数百万件のエントリを絞り込んで注目すべき少数の候補分子へと絞り込みます。ここでエージェントは、ラクトコッシン 972 ファミリー(Lactococcin 972 family)に属する 97 アミノ酸のバクテリオシン(UniProt ID:A0A0U0D591)を発見しました。
![図 43:インタラクティブなインターフェース表示