
一度の収集で、何度でも活用
エージェントに週報の作成や企画書の分析を任せることは、多くの人にとって日常的な習慣となっています。しかし、新しいタスクを開始するたびに、ユーザーは資料を探し出して背景情報を補足しなければならず、エージェントも検索、読解、整理といった幾重ものプロセスを経なければ本格的な作業に入れません。タスクが変われば、その一連のフローをまた最初からやり直す必要があります。
こうした既存資料の繰り返し処理は、時間と労力を浪費するだけでなく、無駄なトークン消費を増大させます。資料が複雑でプロセスが長くなるほど、情報の抜け漏れや理解の齟齬が生じやすくなり、タスク完了の精度に直結します。
この課題を解決するため、WorkSwarmは「パーソナルナレッジスペース」に初めてネイティブ対応しました。
「パーソナルナレッジスペース」は、ユーザーが設定したマルチソースのデータチャネルに基づいてコンテンツを自動収集し、ルールベース処理、ルールとLLMのハイブリッド処理、あるいはエージェントによる自律処理などのアプローチを通じて、散在する資料を**「目次付き・関連性あり・出典明記」**の構造化された個人向けナレッジへと整理します。そして最終的に、「プログレッシブ・ディスクロージャー(段階的開示)」方式により、エージェントが必要に応じて呼び出せるように提供します。
WorkSwarmは、散在する個人資料を長期的に再利用可能なパーソナルナレッジベースとして蓄積し、真の**「一度の収集で、何度でも活用」**を実現します。これにより、エージェントは背景情報をより正確に特定して活用できるようになり、タスク完了率が向上するだけでなく、準備時間とトークン消費量も大幅に削減されます。
openJiuwen パーソナルナレッジスペース:パーソナライズされたマルチソース知識を自動収集し、オフィス向けエージェントが必要に応じて活用
パーソナルナレッジスペースは、「ソース、収集、処理、利用」の4層アーキテクチャを中心に、ユーザーが日常的に蓄積してきた個人資料を、持続的に再利用可能なタスクの背景知識へと変換します。
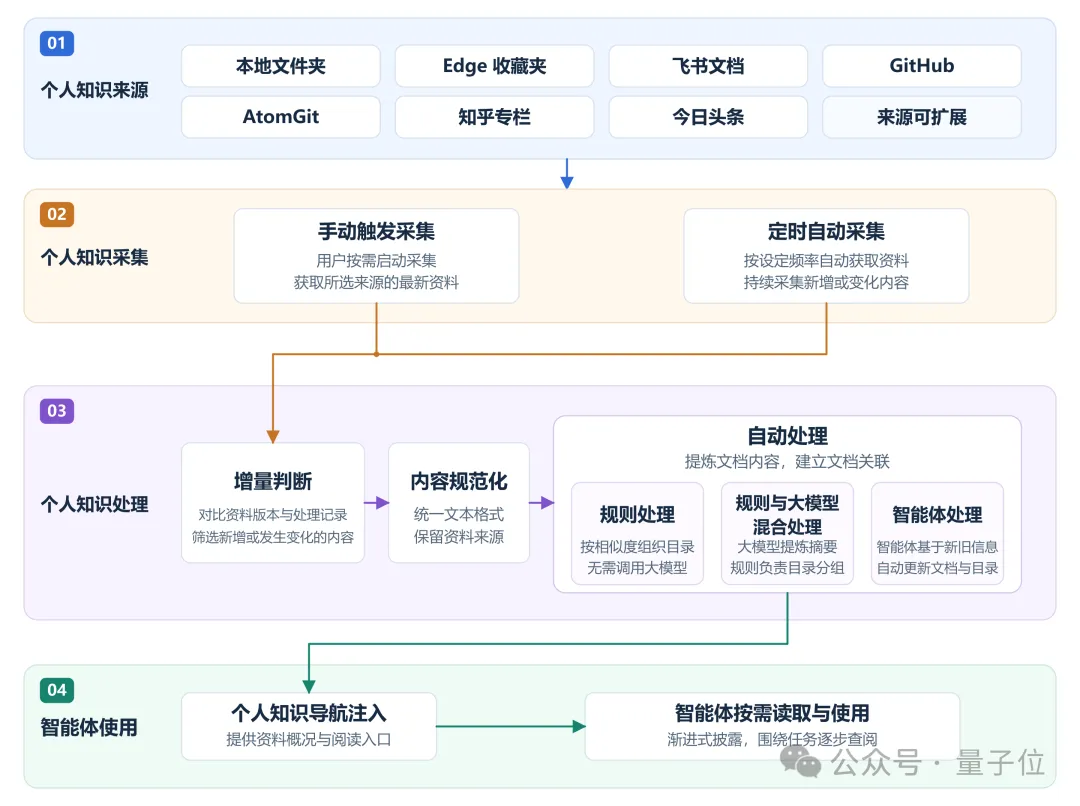 △ パーソナルナレッジスペースの4層プロセス:マルチソース資料の設定、手動および定期収集、3種類の処理方式、エージェントによるオンデマンド呼び出しをカバー
ユーザーがまず知識ソースと収集範囲を選択すると、システムはそれに応じてオンデマンドまたは定期的にコンテンツを取得します。収集された資料は、フォーマットの正規化と差分判定を経て、今回の同期で更新すべき内容と変更点を自動識別します。続いてシステムは、あらかじめ設定されたルール処理、ハイブリッド処理、またはエージェント処理メカニズムに従い、コンテンツをトピック目次と Markdown ページへと整理し、ドキュメント間の関連性とオリジナルの出典情報を完全に記録します。目次構造と引用元の検証をパスした最終成果物は、ユーザーがいつでも閲覧可能な状態になります。
ユーザーがタスク内で本機能を有効にすると、システムはエージェントに対してナレッジの概要と閲覧用のエントリポイントを提供します。エージェントは現在の目標に沿って関連ページを段階的に参照し、蓄積された知識をタスクを効率的に実行するための信頼性の高いコンテキストとして活用します。
パーソナルナレッジスペースの設定と収集:知識ソースを自由に選択、手動・定期の増分収集に対応
「設定」内の「ナレッジ」ページでパーソナルナレッジスペースを有効化すると、ユーザーはローカルフォルダ、Edgeのお気に入り、知乎(Zhihu)コラム、今日頭条(Toutiao)、Feishu(Lark)ドキュメント、GitHub、AtomGit などの多様なチャネルを自由に連携できます。各ソースは個別に設定可能で、どの個人資料をナレッジスペースに取り込むかをユーザーが完全に自律制御できます。
設定完了後、ユーザーは手動で収集をトリガーしてナレッジベースを主体的に更新できるほか、定期自動収集を設定して一定周期で継続的に更新を取得することも可能です。システムはデータソースの識別子、バージョン番号、収集進捗を組み合わせることで、新規追加または変更された資料を正確に識別し、既存の知識フレームワークの下で効率的な増分処理を実行します。
「ソース管理」ページでは、収集の進捗とリアルタイムステータスが一目で把握でき、同期頻度の調整や今回の収集結果の確認ができるだけでなく、実行中の収集タスクをワンクリックで中止することも可能です。
(操作例:「設定」の「ナレッジ」ページでパーソナルナレッジスペースを有効化した後、「ソース管理」に入ります。今日頭条を例にすると、作成者のホームページリンクを追加するだけで手動収集を開始し、同期ステータスをリアルタイムで監視できます。)
パーソナルナレッジ処理:3つの整理方式を提供し、分散した資料を再利用可能な知識へ
Webページ、ドキュメント、コードではフォーマットが異なり、同一テーマのコンテンツが別々のチャネルに散らばっていることも珍しくありません。パーソナルナレッジスペースは、まずデータ形式を統一した上で主要コンテンツを抽出し、トピックごとに目次と独立したページへと再構築します。これにより、エージェントが全体像を迅速に把握してから必要に応じて深掘り読解できるようになるだけでなく、元ドキュメントへのリンクや出典情報も完全に保持されます。
新たな資料が取り込まれるたびに、システムは既存のナレッジをベースに追記・アップデートを行い、同一のプレーンテキスト体系のなかで知識が継続的に進化・蓄積されるようにします。
ユーザーは資料の特徴や整理のニーズに応じて、「設定」の「ナレッジ」ページで以下の3つの処理プランを自由に選択できます:
- ルール処理:BM25単語重み付けとテキスト類似度アルゴリズムを活用してページを対応するトピックに分類し、目次およびページ間の参照関係を自動維持します。全工程で生成AIモデルの呼び出しは発生しません。
- ルール&LLMハイブリッド処理:まずLLMが新規資料のタイトル、要約、キーワードを抽出し、続いてルールベースシステムがトピックのクラスタリングと目次の構築を行います。最後にLLMが明確な目次タイトルと導入概要を生成し、効率性と可読性を両立させます。
- エージェント処理:エージェントが新規資料と既存ナレッジ体系との関連性を深く分析し、既存トピックへの更新または統合を優先的に行います。必要に応じて新規ドキュメントを作成し、目次インデックスとクロスリファレンス関係を全自動で同期・維持します。
後者2つの方式を採用する場合、ユーザーは資料整理専用のモデルを自由に設定できます。整理が完了すると、システムは目次構造と引用元を自動検証し、チェックを通過したコンテンツは直ちにユーザーの閲覧およびエージェントの呼び出しに利用できるようになります。
さらに、ユーザーはファイルツリー、ナレッジグラフ、または全文検索を利用してコンテンツを素早く検索し、本文を展開して読んだり、「ソース」の表記を頼りにいつでもオリジナルの出典へ遡ったりすることができます。
(検索例:収集完了後、すでに「jev」に関するコンテンツが含まれている場合、ユーザーが「ナレッジ」ページで「jev」を検索すると、右側に構造化された本文が表示されるほか、グラフを通じて関連ノードを直感的に探索できます。)
オンデマンド利用:段階的開示により、エージェントが既存の知識を持って作業を開始
資料が体系的なパーソナルナレッジとして蓄積された後、ユーザーはタスク入力欄の「+」メニューからエージェントをナレッジスペースに接続できます。ユーザーの指示を受け取ると、エージェントはまずスペース全体の概要とインデックスのエントリを取得して知識のスコープを把握し、続いてタスクの目標に沿って目次や参照リンクを辿りながら段階的に深く検索を行い、必要なコンテキストを柔軟に補完します。
この「プログレッシブ・ディスクロージャー(段階的開示)」メカニズムは、人間の従業員がプロジェクトを引き継ぐ際に、まず目次やプロジェクト概要に目を通してからピンポイントで詳細ドキュメントを参照するプロセスに似ており、毎回のタスクで蓄積された知識を無駄なく正確に呼び出すことを可能にします。
収集プロセスとタスク呼び出しはそれぞれ独立して制御されます。システムはバックグラウンドで静かに収集と更新を継続でき、エージェントはユーザーの許可がある場合にのみ知識を参照します。タスク呼び出しをオフにした場合でもデータ収集は正常に動作し、ユーザー自身もいつでも既存ドキュメントを自由に閲覧・検索できます。
ユーザーは常に知識へのアクセス権およびエージェントの利用権限について絶対的なコントロールを保持します。新たなタスクを始める際、ユーザーは目下の目標に集中するだけでよく、基盤に蓄積されたナレッジ体系がエージェントのコンテキストブレーンとして自然に機能します。
(呼び出し例:パーソナルナレッジスペースを有効化した後、「jev について紹介して」と入力して送信すると、WorkSwarm はナレッジベース内の関連ドキュメントを自動で参照し、コアメカニズムや実践事例などの多角的な視点を含んだ体系的な回答を直接出力します。)
効果の比較:タスク成功率の向上、所要時間とトークン消費の削減
パーソナルナレッジスペースを活用することで、エージェントはあらかじめ保有資料の範囲を把握した上で、重要なドキュメントをピンポイントで特定・参照できるため、タスク実行フェーズで手当たり次第に元の資料を繰り返し探し回る無駄を効果的に回避できます。
開発チームは2組のベンチマーク比較テストを実施し、本メカニズムがタスク完了度、実行所要時間、トークン使用量の最適化にもたらす効果を検証しました:
比較結果によると、パーソナルナレッジスペースを備えた WorkSwarm は、クライアントカルテ、プロジェクト資料、進捗計画を横断的に理解し、明確かつ詳細なプロジェクトの振り返りと今後のToDoを迅速に整理できました。一方、同スペースがない場合、エージェントは複数回の検索を経ても核心となる背景にたどり着くのが難しく、最終的には具体性に欠ける会議準備フレームワークを出力するに留まり、ユーザーに対して手動で情報を補足するよう求める結果となりました。
同様に、ナレッジスペースを有効にすることで、WorkSwarm はブラウザのブックマークや知乎コラムなどのチャネルで事前に蓄積されていたナレッジ資産を直接活用でき、タスクの推進スピードを大幅に向上させました。
さらに、openJiuwen チームはローカルの論文、ブラウザのブックマーク、Feishuドキュメント、GitHub、AtomGit、知乎、今日頭条という7種類の代表的なデータソースをカバーした、25の実践的シナリオからなる評価データセットを独自に構築しました。単一ソース検索、クロスソース統合、テーマ変更に伴う再利用、欠落事実の補完、無関係なノイズ混入など多岐にわたるシナリオを網羅し、定量的な評価基準をあらかじめ設定しています。実測データによると、パーソナルナレッジスペースを有効化した場合:
- タスク成功率が 32% 向上:エージェントが必要な情報へより素早くアクセスでき、チャネルをまたいだ断片的な資料を統合して完全な回答を生成できるため、資料の不足や見落としによるタスク失敗が大幅に減少しました。
- タスクの総所要時間が 76.2% 短縮:背景資料が事前の段階で前処理および構造化されて蓄積されているため、タスク実行時には完成されたドキュメントを直接呼び出すことができ、その場での検索・通読・再整理といった煩雑なフローが不要になりました。
- タスク実行フェーズの総トークン消費量が 84.1% 削減:蓄積された知識は再利用性が高く、エージェントが必要な断片をピンポイントで抽出するため、大量の元ドキュメントを繰り返し入力することによる無駄な消費を大幅に抑制できました。
エージェント処理モードにおける前処理段階では一定のトークンコストが発生するものの、コンテンツ抽出に特化したコストパフォーマンスの高い軽量モデルを採用することでそのコストは抑制できます。また、蓄積されたナレッジは後続の多様なタスクで繰り返し呼び出されるため、1回あたりの按分コストはゼロに近づいていきます。
おわりに
openJiuwen パーソナルナレッジスペースは、分散し孤立していた個人情報を体系化し、長期的に再利用可能な知的資産へと転換することを目指しています。ユーザー自身によるソース設定を前提に、システムが差分同期と構造化された再編成を自動で行うことで、日常的な閲覧を快適にし、エージェントのオンデマンドな呼び出しを容易にして、多岐にわたる複雑なタスクへ盤石なコンテキスト基盤を提供します。
今後は、ユーザーの実際の業務動線と連動し、ビジネス目標や知識の空白領域を自動で捉えて自発的にピンポイントの知識拡充を行う仕組みを模索していきます。これにより、蓄積プロセスを実際の生産性シナリオへさらにフィットさせ、オフィス向けエージェントが高度な協調作業のなかで使えば使うほど手に馴染む存在となることを目指します。
パーソナルナレッジスペースは、あなたが蓄積したすべての資料を、次なるエージェントとの協調進化の起点へと変えていきます。
パーソナルナレッジスペースは現在、WorkSwarm に全面的に実装されています。体験およびコードの入手先:
- WorkSwarm 公式サイト:https://openjiuwen.com/workswarm
- GitHub:https://github.com/openJiuwen-ai/jiuwenswarm
- AtomGit:https://atomgit.com/openJiuwen/