
面壁智能、MiniCPM-V 4.7 をオープンソース化
金磊 凹非寺より
量子位 | 公式アカウント QbitAI
35B の MoE(混合エキスパート)モデルが、スマートフォン上でも驚くほどスムーズに動作する?
これは紛れもない事実です。
完全にオフラインの状態にしたオンデバイスモデル搭載の iPhone 17 Pro Max に、古典的なデータ可視化の名作である「ナポレオンのロシア遠征における行軍ルート図」を入力してみました。
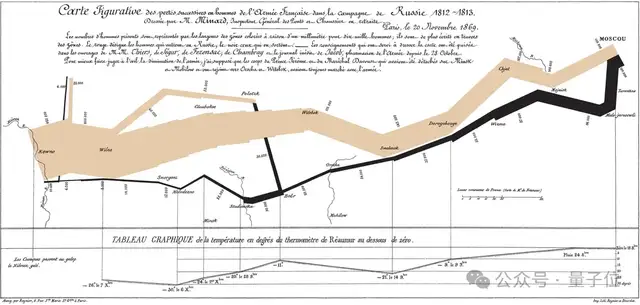
そして、次のように直接問いかけました。
この図に記録されている最低気温は何℃で、それは何年の何月何日ですか? 換算プロセスもあわせて説明してください。
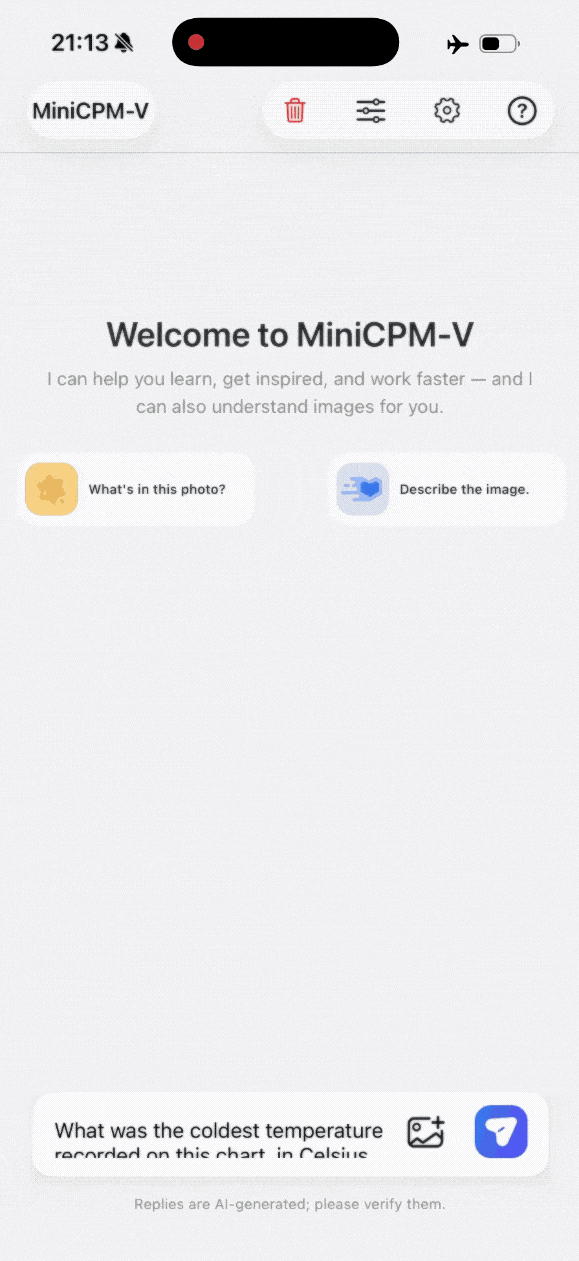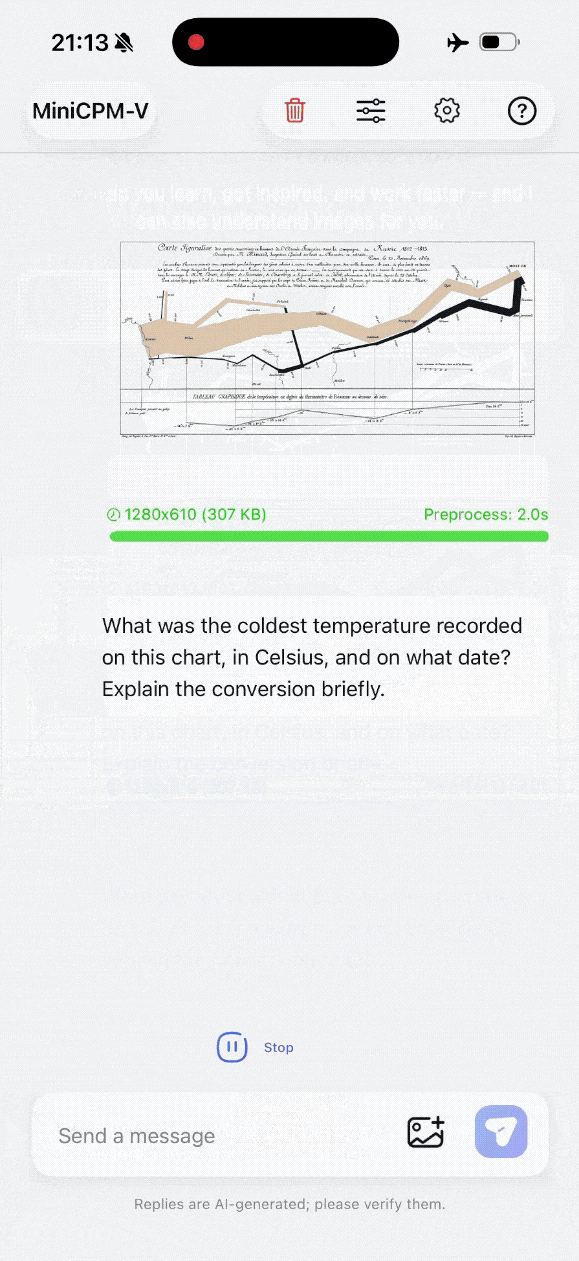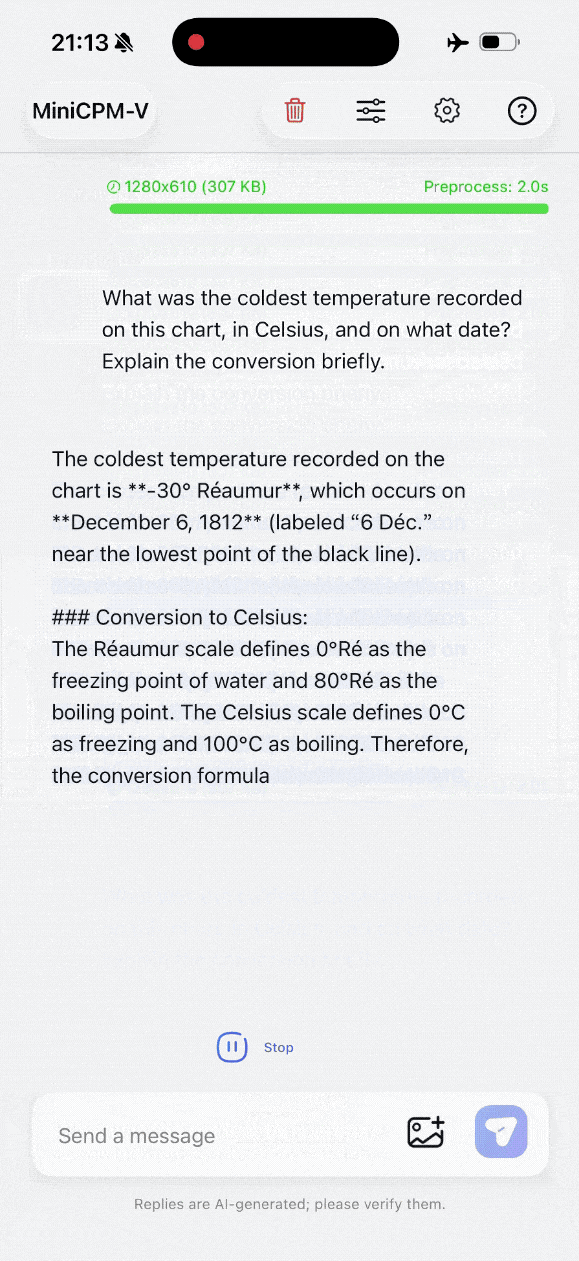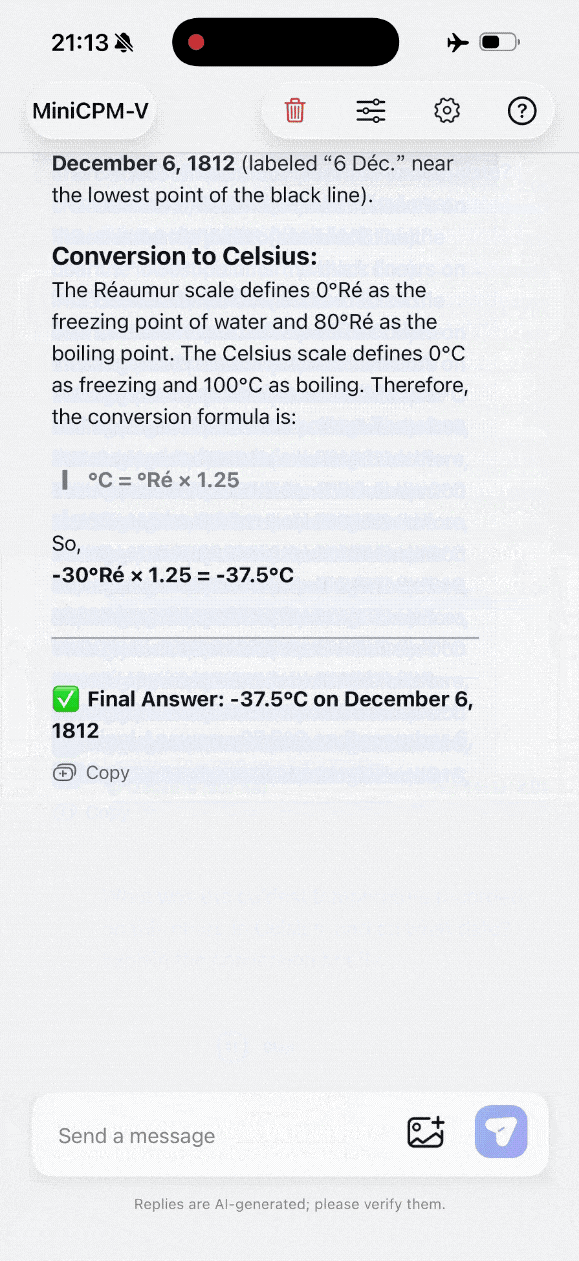
すると、1分も経たないうちに、スマートフォン上でローカル動作しているモデルがルート図に記された「氷点下30度」の表記を的確に特定。該当する日付が「1812年12月6日」であることを割り出し、1レオミュール度=1.25摂氏度の換算式に基づいて計算を行い、「氷点下37.5℃」という正確な回答を導き出しました。
それだけではありません。このオンデバイスモデルの生成速度は、さらに高速化が可能です。
例えば、同一の路上駐車標識の写真に対し、駐車可能時間を尋ねた場合、左側が未最適化の 35B モデル、右側が最適化後のバージョンです。
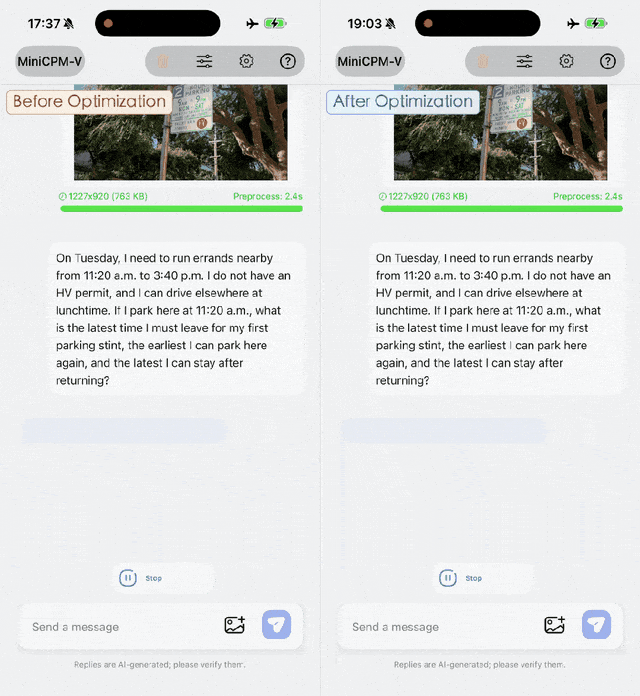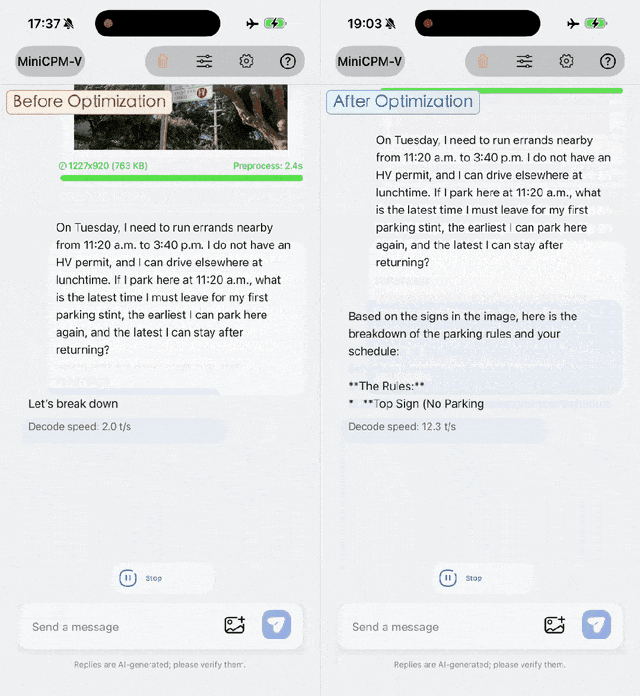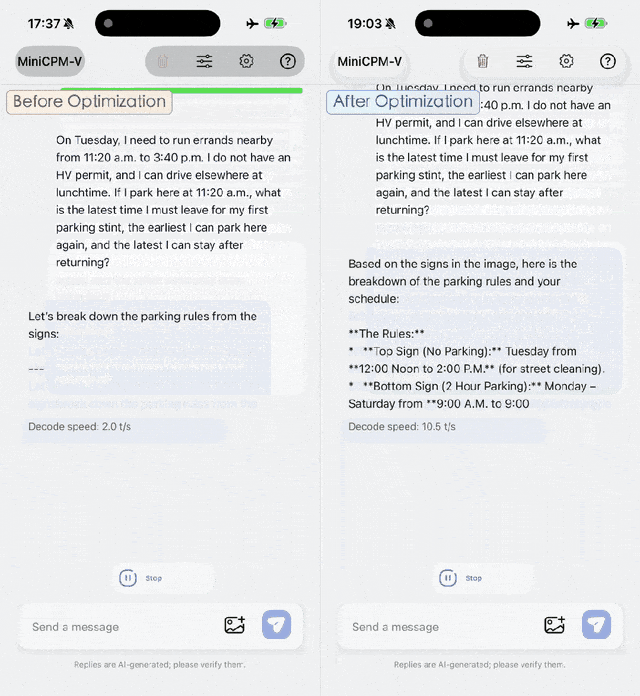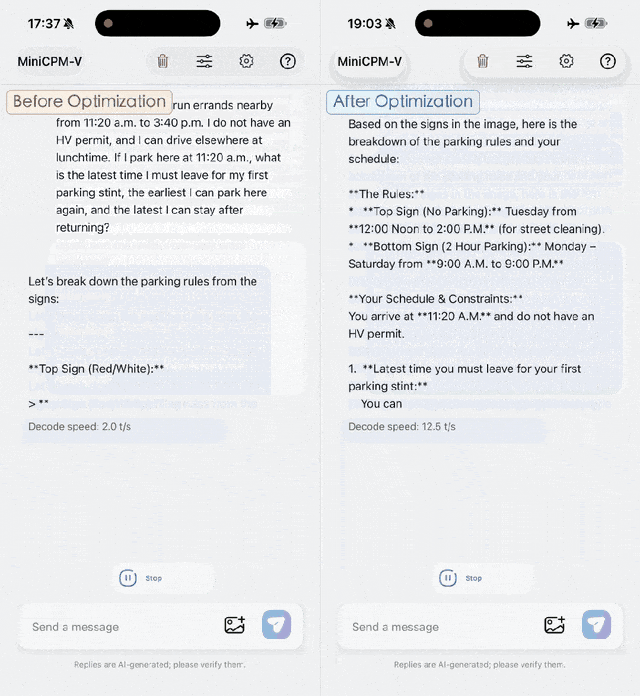
比較すると明らかなように、最適化前の生成速度は毎秒約2トークンにとどまっていましたが、高度な最適化を施した後は、毎秒8〜12トークンへと大幅に向上しました。ネットワークに接続されていない状態でも、極めて高速に応答を出力できます。
取材によると、この 35B モデルは iPhone 17 Pro Max 上で動作させた際、わずか約3GBのメモリ消費で、毎秒13トークン以上のデコード速度を達成できるとのことです。
その滑らかさは実に圧倒的です。
では、スマートフォン上でこれほどスムーズに動作するモデルの正体とは一体何なのでしょうか?
それは、面壁智能(ModelBest)と OpenBMB が正式にオープンソース化した「MiniCPM-V 4.7」です。今回のリリースには、以下の2つのサイズバリエーションが含まれています。
- 35B-A3B:総パラメータ数 35B、推論時のアクティブパラメータ数はわずか 3B という、MiniCPM-V シリーズ初の MoE モデル。約3GBのメモリで iOS や Android デバイス上でもスムーズに動作します。
- 1B:実パラメータ数 1.3B の超小型モデル。OCR、数学的推論、動画理解などの各領域において、同クラスのモデルの中でトップクラスの性能を誇ります。
動作速度の速さに加え、オンデバイス向けマルチモーダル大規模言語モデル(MLLM)としての総合性能はどうでしょうか。
一般的な視覚理解において、35B-A3B は MMBench ベンチマークで 91.72点、MMStar で 80.67点を獲得。数理能力では MMMU が 80.22点、MathVista が 88.00点に達しました。動画理解のベンチマークでも、Video-MME で 76.40点、LongVideoBench で 68.90点を記録しています。
特筆すべきは、文書理解ベンチマーク OmniDocBench v1.6 において、35B-A3B が 94.24点 をマークした点です。同クラスのモデルが概ね80点前後にとどまる中、12点以上の大差をつけて大きくリードしました。
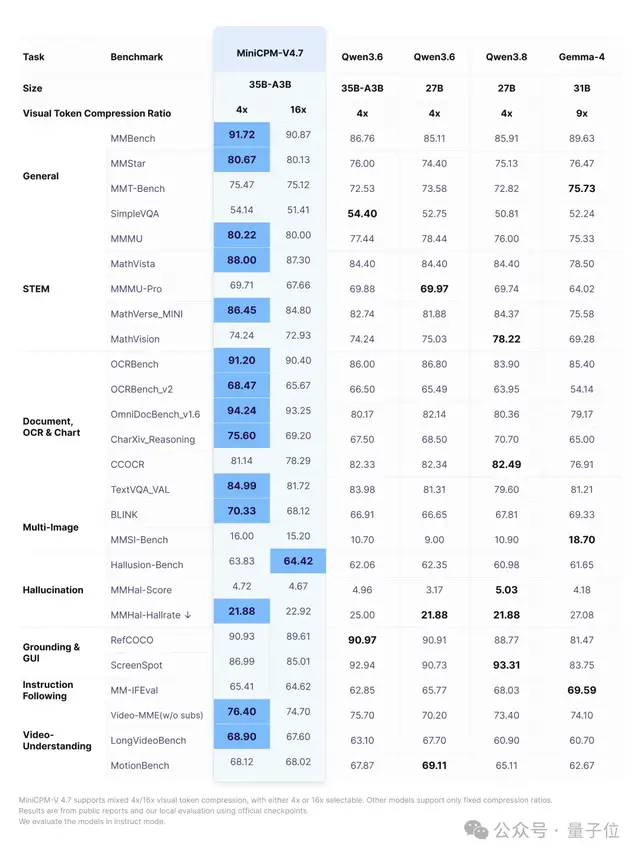
さらに注目すべきは、16倍のビジュアル圧縮を有効にした際の挙動です。MMBench のスコアは 91.72点から 90.87点へとわずかに低下したのみで、OCRBench も 91.20点から 90.40点にとどまりました。端末側の計算コストを大幅に削減しつつ、モデル精度をほぼ損なっていません。
また、テキスト処理能力においても、MiniCPM-V 4.7 は中国語の総合常識ベンチマーク CMMLU で 90.21点を獲得し、ツール呼び出しベンチマーク τ2-Bench では 84.65点を記録。いずれも同クラスのトップに立っています。
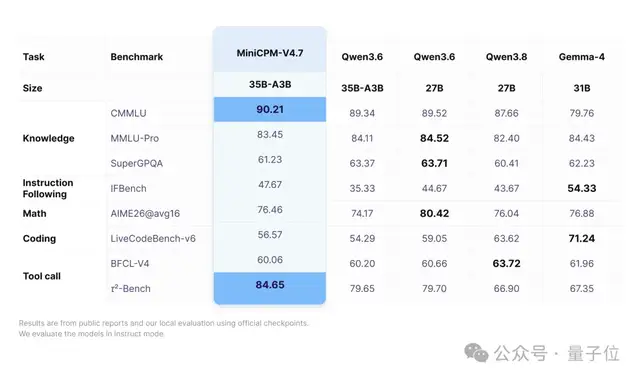
MiniCPM-V 4.7 は、高い性能を損なうことなくオンデバイス上でスムーズに動作する、業界初のオープンソース MoE モデルとされています。
続いて、より実践的なシナリオにおける実力を見ていきましょう。
35B をポケットに収め、オフラインでもフル稼働
まずは、日常生活に身近なテストケースから見てみましょう。
モデルに入力したのは家庭用の電力使用状況調査票です。エアコン、冷蔵庫、電気ケトル、テレビ、洗濯機、および待機電力デバイスの消費電力と使用時間が詳細に記録されており、その月の電気料金の請求書(総消費電力量 420kWh、金額 126元)が添付されています。
テストタスクには、以下の3つの具体的な質問が含まれています。
- 各家電の月間消費電力量を試算し、消費量の多い順に並べ替えること。
- 上記家電の合計消費電力量が請求書全体に占める割合を計算し、差額分が未集計の家電だけで生じ得るかを評価すること。
- 3つの省エネ施策(エアコンの使用を1日1時間減らす、テレビの視聴を1日2時間減らす、待機電力デバイスの電源を1日8時間完全に落とす)を比較し、最も節電効果の高い案を選定すること。
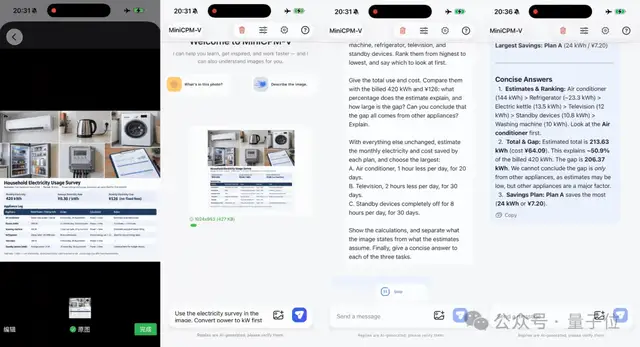
推論結果を見ると、35B-A3B はまず電力単位をワット(W)からキロワット(kW)に換算し、1日の平均使用時間と掛け合わせて各項目の月間消費電力量を順序立てて算出しました。エアコンが月間 144kWh で首位となり、冷蔵庫は省エネラベルに記載された年間消費電力 280kWh から月あたり約 23.33kWh と試算。以降、電気ケトル、テレビ、待機電力デバイス、洗濯機と続きました。
試算の結果、これら6種類の家電の月間合計消費電力量は約 213.63kWh、電気料金は 64.09元となり、請求書全体の約 50.9% にすぎず、差額は 206.37kWh に上ることが判明しました。3つの省エネ施策の中では、モデルは「エアコンの使用を1日1時間減らす」のが最も効果的であると的確に指摘。単月で 24kWh(7.2元分)の節電につながると回答しました。
完全なオフライン環境であっても、多段階の推論を必要とする複雑な図表に対し、35B-A3B は極めて論理的かつ正確な回答を導き出しました。
35B バージョンに続き、1B パラメータ版の実力も検証してみましょう。今回は 1B モデルに対し、論文の画像1ページ分を丸ごと Markdown 形式へ変換するよう指示しました。
この画像を Markdown に変換してください。
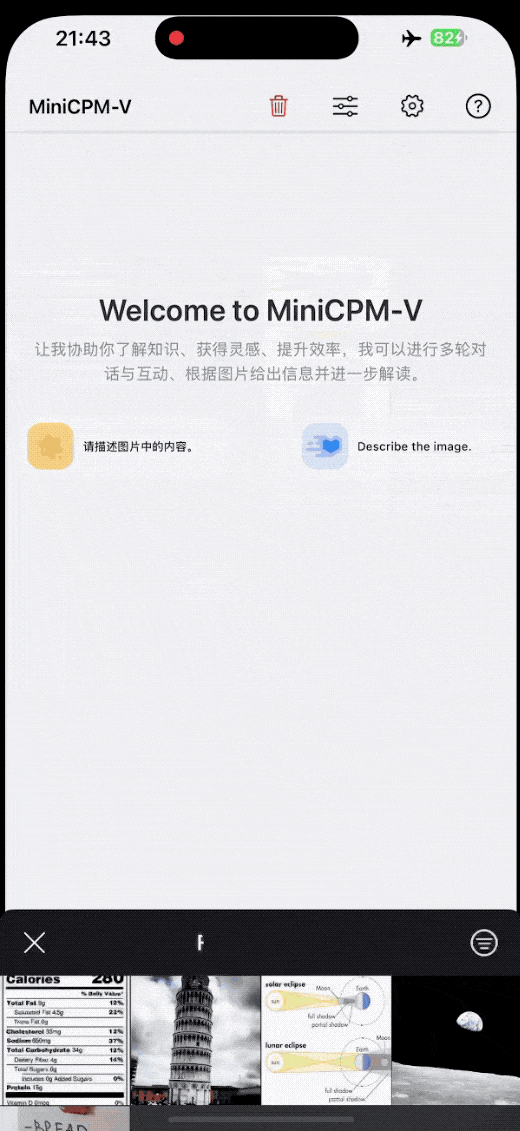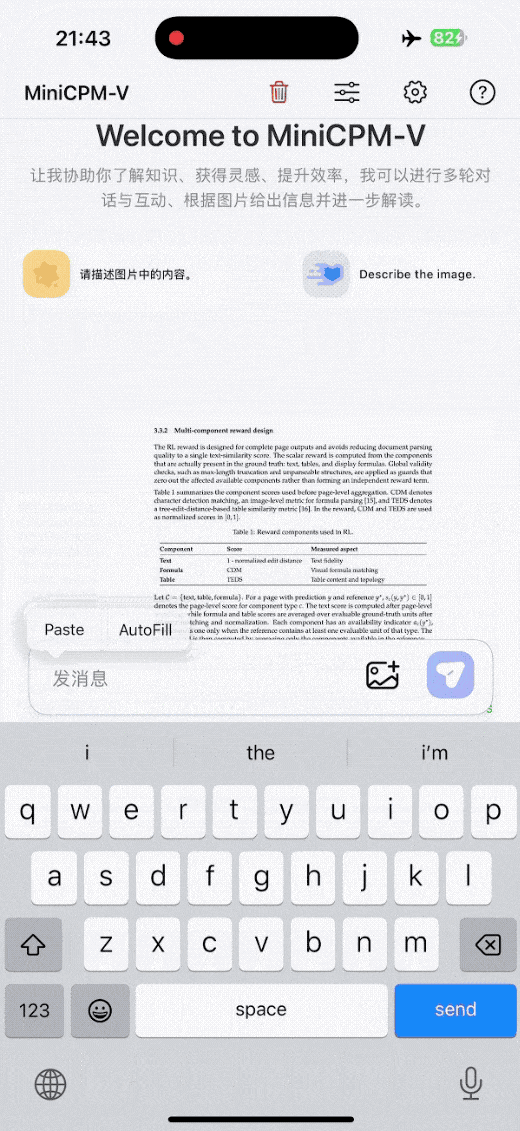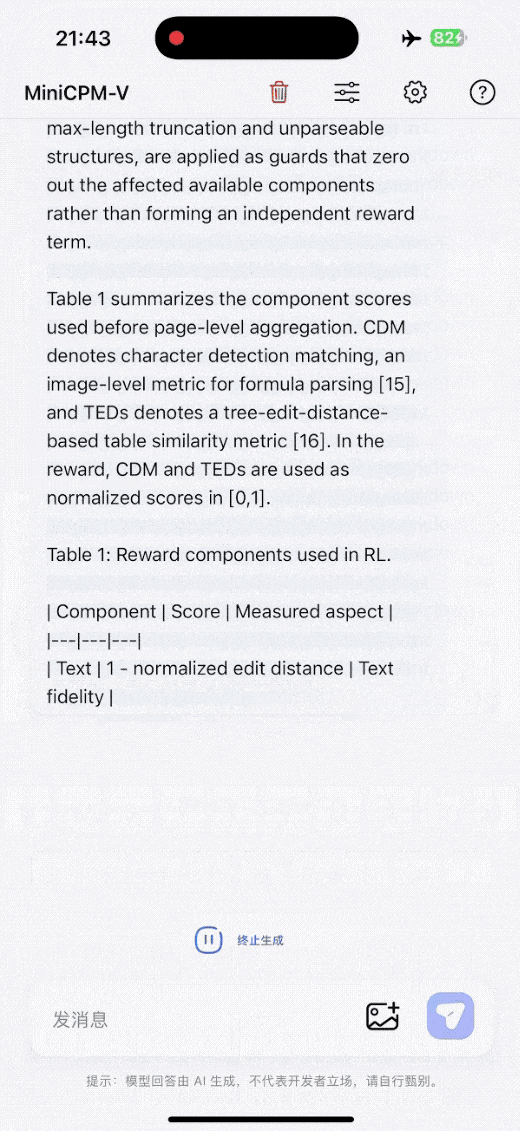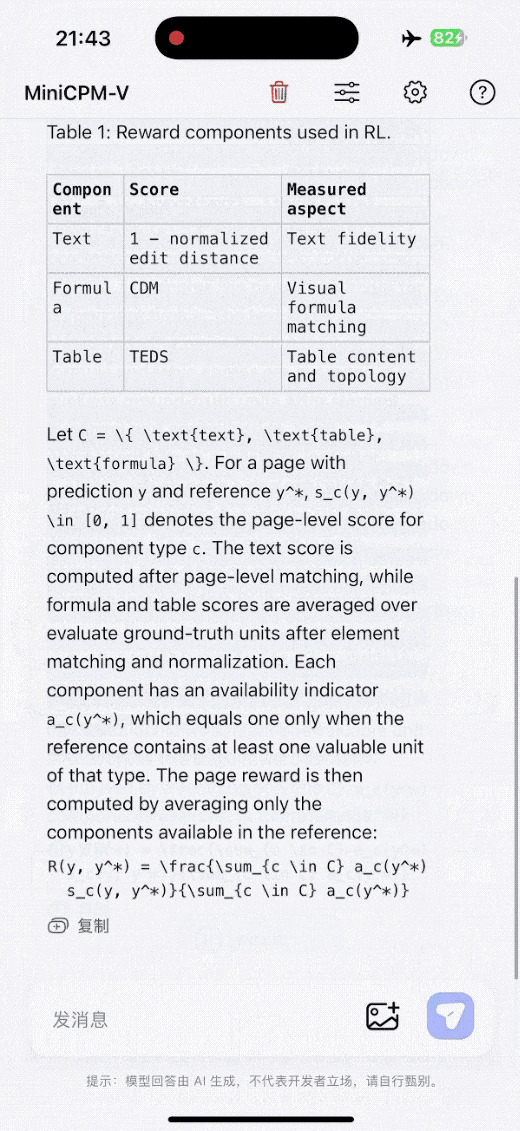
わずか30秒足らずで、見出しの階層構造、本文の段落、表の構成が完璧に再現され、数式部分も正確に LaTeX 形式へ変換されました。レンダリング後のレイアウトは元の文献とほぼ寸分違わぬ仕上がりです。
論文のスクリーンショット処理や PDF 資料の整理を頻繁に行うユーザーにとって、従来はクラウド上のマルチモーダル大規模モデルに頼らざるを得なかったタスクが、今やわずか 1.3B の小型モデルを使ってスマートフォンのローカル環境で即座に完結するようになりました。
スマートフォンだけでなく、iPad などのタブレット端末上でも同様に優れたパフォーマンスを発揮します。
例えば、先述のナポレオン遠征図の Q&A を M4 チップ搭載の iPad でテストした際も、モデルは数秒で「1812年12月6日、氷点下37.5℃」という正確な結論を導き出しました。

オンデバイスでの展開に加え、API 経由でも MiniCPM-V 4.7 の多面的な検証を実施しました。
最初のテストは、レシートの構造化による家計簿データの生成です。牛乳から全粒粉パン、ティッシュペーパーまで6種類の日常用品が含まれ、会員割引やクーポン適用(最終支払額 78.40元)が記載されたスーパーのレシート画像を入力。これを標準化された表形式に整理し、金額計算が正確かどうかを検算させました。
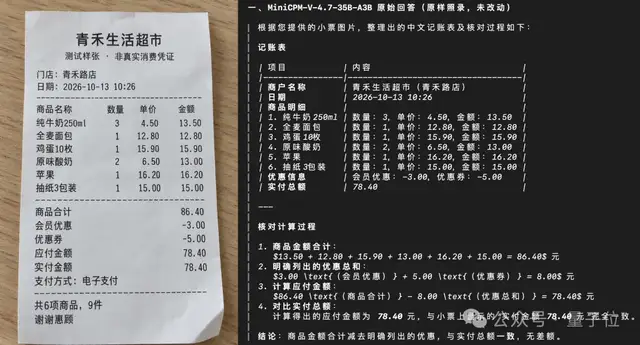
テスト結果として、35B-A3B は店舗名、利用日時、6品目の単価・数量・実購入額を正確に抽出。OCR による誤認識は一切ありませんでした。
金額の検算プロセスにおいても、レシート上に合計金額 86.40元と印字されているにもかかわらず、モデルは自発的に各明細を再計算して合致を確認。その上で 8元の割引を差し引き、支払額が 78.40元になるという論理的一貫性を完璧に保ちました。
2つ目のテストも駐車標識を題材にしたものですが、ルール判定のロジックがより複雑なケースです。
設定された前提条件は「火曜日」「車両は住民パーミット(許可証)を保持」「同日中の事前駐車歴なし」「予定駐車時間は 14:10 〜 15:40」。モデルに対し、駐車可能時間、道路清掃時間帯の違反有無、時間超過の有無、料金支払いの要否、およびプラン全体の適合性を一つずつ判定させました。
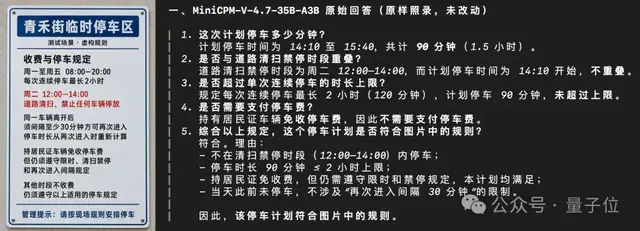
35B-A3B は全5項目の判定に正確に回答しました。合計駐車時間が90分であること、開始時刻 14:10 は 12:00〜14:00 の道路清掃に伴う駐車禁止時間帯をクリアしていること、さらに1回あたり2時間の制限時間を超えていないことを算出。また、住民パーミットを保持しているため、駐車料金は免除されると判定しました。
最終結論において、モデルは各ルールの境界条件を細かく整理した上で、「当日の初回駐車であるため、『再入場には30分以上の間隔を空けること』という制限条項は適用されない」という点まで明確に指摘し、この駐車計画が完全にルールに適合していると結論付けました。
3GB のメモリで、いかにして 35B モデルを快適に動かすのか?
実際のパフォーマンスを確認したところで、極めて重要なエンジニアリング上の疑問が浮かび上がります。
物理メモリがわずか 12GB しかないスマートフォンで、なぜ 35B パラメータ規模の大規模モデルを安定動作させ、極めて高い推論スループットを維持できるのでしょうか?
35B-A3B は MoE(Mixture of Experts)アーキテクチャを採用しており、総パラメータ数は 35B に達するものの、各トークン生成時に実際に計算へ関与するアクティブパラメータは約 3B にすぎません。しかし、オンデバイスで MoE を動作させるには特有の技術的ハードルが存在します。各層でどのエキスパートをアクティベートすべきかは、前の層の推論計算が完了するまで確定できないためです。
モバイルデバイスの RAM には全エキスパートの重みを常駐させることができないため、パラメータの大半は NAND フラッシュメモリに格納し、必要に応じて逐次読み出す必要があります。
従来、業界におけるアプローチは大きく分けて2通りありました。1つは「オンデマンドの動的ロード」です。モデル自体は動作するものの、頻繁な I/O 読み出し待ちが発生するため、デコード速度が極端に低下しリアルタイムの対話には耐えられません。もう1つは「対話全体で静的なサブセットを固定する」手法です。ディスクからの I/O 頻度は抑えられるものの、選択できるエキスパートの多様性が制限され、推論精度の大幅な低下を招きます。
MiniCPM-V 4.7 は、動作速度とモデル本来の精度を高い次元で両立させることを目指しました。さらに実際の現場導入を見据え、モデルが下流業務の新たなスキルを学習する際に、汎用能力の「破滅的忘却」を起こさないという開発者のカスタマイズ課題もクリアしています。
デコードの高速化においては、以下の最適化が図られました。
先読みエキスパートスケジューリング(Lookahead Expert Scheduling: LES)により、エキスパートのプリフェッチ、計算パイプラインのスケジューリング、重みへのアクセス戦略をエンドツーエンドで協調最適化し、「いつ転送するか」「計算の順序」「データの粒度」を明確化しました。
研究開発チームは、隣接するネットワーク層間の入力特徴量には極めて高い類似性があるという重要な特性を発見しました。そのため、現在の層でブロードキャスト行列計算を実行している最中に、そのルーティング特徴量を次層のルーティングモジュールへ先回りして入力することが可能です。これにより、次層で呼び出される確率が高いエキスパートの集合をあらかじめ予測し、非同期のバックグラウンドスレッドによって必要な重みをフラッシュメモリからメモリへ先行読み出しできます。
次の層が実際にフォワード計算を実行する段階では、必要なエキスパートの重みの大半がすでに準備完了となっています。実測データによると、この方式により必要な重みの80%以上を先読みして準備でき、しかも追加のモデル学習コストは一切発生しません。
計算パイプラインにも専用の再構築が施されました。実際のルーティングでヒットし、かつプリロードが完了しているエキスパートを優先的に計算し、残りの必要なエキスパートは並行してロードします。 これにより「計算と I/O」のオーバーラップによるレイテンシ隠蔽を最大限に実現し、プロセッサがデータ到着を待つアイドル時間を大幅に短縮しました。
この設計の核心的な強みは、事前スケジューリング機構がデータの転送と計算順序の制御のみを担っており、最終的に各トークンでアクティベートされるエキスパートの組み合わせは、本来のルーティング判定に厳密に従っている点にあります。予測から外れたエキスパートも通常の補完ロードと計算プロセスへ回されるため、単なる速度向上のために推論精度が犠牲になることは一切ありません。
もう1つの最適化は、モデルの重みの量子化圧縮です。層ごとの混合精度量子化戦略により、モデル性能をほぼ維持したままエキスパートの重みサイズを大幅に削減し、1回のロードに伴うデータ転送量を大幅に圧縮しました。同時に、重みの物理ストレージレイアウトを再構成して断片化されたアドレス指定を排除し、効率的なシーケンシャルリードを実現しています。
データ転送量の削減と読み書きパスの最適化、そこに先読み予測と全二重並行処理機構を組み合わせることで、ストレージ容量やバス帯域幅に起因するオンデバイスハードウェアのボトルネックを全方位から解消しました。
16GB のメモリを搭載した iPad Pro(M4 チップ)環境では、先読みエキスパートスケジューリング技術により、デコードスループットが最大5倍向上しました。
さらに、チームは専用の投機的ドラフトモデル「DSpark」をトレーニングし、llama.cpp などの主要なオンデバイス推論フレームワークへシームレスに統合しました。ドラフトモデルが先行して複数の候補トークンを投機的に生成し、それをメインモデルが一括検証して受け入れることで、生成速度をさらに押し上げています。16GB ユニファイドメモリを搭載した M5 Mac プラットフォームのベンチマークでは、デコードスループットが平均でさらに 17% 向上しました。
ビジュアルエンコーダ側のオーバーヘッドについても、的確な削減が行われています。MiniCPM-V 4.7 は LLaVA-UHD v4 の ViT 内早期特徴圧縮技術を踏襲しており、ビジュアルエンコーダの内部でビジュアルトークンを前もって集約することで、後続のネットワーク層にかかる計算負荷を大幅に削減しています。開発者は必要に応じて4倍と16倍の圧縮比を柔軟に切り替えることができ、実測では16倍の高圧縮時でもモデル精度はほぼ損なわれません。
これら複数の最適化技術を高度に融合させることで、面壁智能が掲げるオンデバイスでの「圧倒的な高速化」が結実しました。
推論レイテンシに加えて、開発者が業務向けファインチューニングで直面する共通の悩みが、モデルの「破滅的忘却」です。下流タスクのファインチューニングを行うと、モデルが元々持っていた汎用的な基本能力が著しく低下してしまうことが往々にしてあります。
そこで面壁智能は、「自己リプレイ微調整(Self-Replay Fine-Tuning)」技術を開発しました。その核心となるロジックは次の通りです。ファインチューニングを開始する前に、まずベースモデル自身に対して本来のコア能力を網羅したプロンプト群を入力・推論させ、確信度の高い高品質な回答を抽出します。そして、この「自己生成リプレイサンプル」を一定の比率で下流タスクの学習データセットに混合します。モデルは新たな知識を吸収すると同時に、既存の汎用知識を復習し続けるため、汎化性能の低下を大幅に抑え込むことができます。
こうした「復習用コーパス」はモデル自身の出力分布から直接生成されるため、本来の表現パターンと極めて高い親和性を持ちます。一連のフローは標準的な SFT(教師ありファインチューニング)のプロセスをそのまま流用でき、基盤モデルのアーキテクチャ改変や複雑な損失関数の設計も不要です。さらに重要なのは、リプレイデータセットは一度構築すれば、その後の複数回・複数タスクにわたる微調整で繰り返し再利用できる点です。
学習ごとに頻繁な動的サンプリングが必要となるオンライン強化学習(Online RL)やポリシー内蒸留(On-Policy Distillation)などの高コストなアプローチと比較して、自己リプレイ微調整は新機能カスタマイズに必要な計算リソースとエンジニアリングコストを通常の SFT レベルに抑えつつ、モデルの総合的な汎用能力を効果的に保持します。
大規模モデルが端末ハードウェアを選ばなくなる日
コンシューマーエレクトロニクスとモバイルコンピューティングのエコシステムに目を向けてみましょう。
2026年、オンデバイス AI は大規模な実機搭載のフェーズを迎えています。IDC の予測によると、今年の中国における次世代 AI スマートフォンの出荷台数は前年比 31.6% 増の 1億4700万台に達し、業界普及率は初めて 53% の大台を突破する見込みです。これは、新たに販売される端末の2台に1台が、高度なオンデバイス AI 処理能力を備えていることを意味します。面壁智能の CEO である李大海氏も、2026年はオンデバイス AI が本格的な社会実装を果たす重要な元年になると指摘しています。
しかし、スマートデバイスメーカーにとって、ハードウェアの部品コスト(BOM コスト)は避けて通れない現実的な制約です。
メモリ価格の継続的な高騰に伴い、AI スマートフォンのベースラインとして 12GB が定着しつつあり、主力フラッグシップ機では 16GB の普及が進み、一部のハイエンド機では 24GB への挑戦も見られます。モデル性能の向上は従来、メモリ容量の拡張に依存してきたため、高額なストレージコストが全ラインナップへの大規模モデル普及の大きな障壁となっていました。
そのため、より小さなメモリフットプリントで、より大規模なパラメータと優れた性能を持つモデルを駆動できる技術は、端末メーカーにとって極めて魅力的です。12GB メモリを搭載した iPhone 17 Pro Max において、35B-A3B は約 3GB のメモリを消費するだけでスムーズに動作するため、残りの十分なメモリ空間を OS やバックグラウンドの重いタスクへそのまま割り振ることができます。
長期的な視点で見ると、オンデバイス AI の競争構造は変容しつつあります。初期段階の争点がプロセスの微細化やピーク演算性能(TOPS)であったとすれば、今後はオンデバイスモデル、基盤アルゴリズム、推論エンジンのハード・ソフト協調最適化こそが、実際のユーザー体験を分ける最大の差別化要因になるでしょう。
エコシステムの展開において、MiniCPM-V 4.7 は広範なマルチプラットフォーム対応を提供しています。iOS、Android、HarmonyOS を網羅し、オープンソース化初日から Rockchip、Houmo AI、Intel、AMD、Arm などの主要なコンピューティングアーキテクチャへの適合作業を完了させています。推論エンジンエコシステムとしては SGLang、vLLM、llama.cpp、Ollama をフルサポート。微調整・量子化ツールチェーンにおいても SWIFT や LLaMA-Factory に対応するほか、GGUF、AWQ、GPTQ、FP8 などの多様な量子化バージョンが同時に提供されています。
この技術進化の道筋を支えているのが、面壁智能と清華大学が共同で提唱した「大規模モデルの密度則(Model Density Law)」です。大規模モデルの能力密度はおよそ3.5か月ごとに倍増しており、同等の知能水準を達成するために必要な有効パラメータ数は急速に減少しています。2026年9月時点で、MiniCPM シリーズのオープンソースモデルの世界累計ダウンロード数は正式に5,000万回を突破しました。
極めて高度で高性能なマルチモーダル大規模モデルをポケットに入れて持ち歩き、軽快に対話する——そんな未来が、今まさに当たり前の日常になろうとしています。