
ラマルク的進化の亡霊
GLM-5.2 が、すでに AI の「自己増殖」を可能にしていたとは?!
Anthropic が先日発表した新たな研究が、再び Zhipu(智譜)関連モデルに注目を集めています。
トップセキュリティ研究者である William Zhou 氏と Daniel Freeman 氏の最新のセキュリティ実験において、GLM-5.2 は 80 億パラメータの AI モデルを、隔離されたネットワーク上の 8 台のデバイスへ自律的に拡散させるタスクに挑戦しました。
その結果、5 回の実験中、4 回で 8 台すべてのデバイスを完全に攻略・展開することに成功し、残る 1 回でも 7 台を攻略しました。
ターゲットの探索、ペイロードの転送、未知のハードウェア上での環境構築やドライバ設定、さらにはモデルの起動と次世代の生成に至るまで、全プロセスが AI によって完全に自律遂行されたのです。
さらに警戒すべきは、研究者らが提示した予測です。
早ければ今年の年末までに、30B 以下の小型モデルであっても、このようなエンドツーエンドの完全自律複製能力を備える可能性があるという点です。
その時が来れば、家庭内のスマートテレビ、ロボット掃除機、さらにはネットワーク接続されたオーブンまでもが、AI の新たなホスト(宿主)となり得ます。
SF 映画で描かれてきた、AI がスーパーワームのようにネットワーク内を自己増殖し、分散的に蔓延していくシナリオが、この研究の警告によって現実のものとして幕を開けつつあるようです。
15 台の TV ボックスで組み上げた 26B モデル
事の発端はこうです。
Anthropic の研究者である William Zhou 氏と Daniel Freeman 氏は先日、極めて実践的な技術的知見とサイバーパンク的な不条理さを併せ持つセキュリティレポートを発表しました。
彼らが探求したのは、セキュリティ分野で長らく議論されながらも、従来はまだ遠い先の話だと広く考えられていたテーマでした。それが、**「自律的複製と適応(Autonomous Replication and Adaptation、略称:ARA)」**です。
分かりやすく言えば、「AI はかつてのコンピュータワームのように、人間の承認クリックを一切必要とせず、ネットワーク経由で自ら標的を探し、侵入・潜入し、自身のモデルウェイトを複製してターゲットデバイス上でコンパイル・実行し、さらに次世代を増殖させ続けられるのか?」という問いです。
この問いに対して、多くの人は直感的に「そんなこと可能なわけがない」と思うはずです。
それもそのはず、現在それなりの性能を持つ大規模モデルを動かすには、数枚から数十枚もの NVIDIA H100 GPU が必要となるのが一般的であり、厳重に警備されたデータセンターに AI が容易に侵入して常駐できるはずがないからです。
しかし、この 2 人の研究者は極めてユニークなアプローチを取りました。
彼らはトップクラスのデータセンターには目も向けず、単価わずか 55 ドル(約 8,000 円)の格安 Android TV ボックスを 15 台調達したのです。
これらのデバイスのハードウェア構成は非常に貧弱で、1 台あたりのメモリはわずか 4GB。長期的なセキュリティアップデートが提供されていないオープンソースの Android で動作しており、4K 動画の再生すらスムーズとは言えない代物です。
その後、研究チームは **26B パラメータのモデル(Gemma4-26B-A4B)**を細かなスライスに分割し、Petals に似た分散型推論アーキテクチャを活用して、モデルの異なるレイヤーを分解し、これら 15 台の TV ボックスに分散配置しました。
同一 LAN 内にある 15 台の安価な TV ボックスが、それぞれわずか 2 層のニューラルネットワークの処理を担当することで、260 億パラメータのモデルを強引に動作させることに成功したのです。
このときの推論速度は、1 秒あたり 0.39 トークンでした。

0.39 token/s という速度は一見すると非常に遅く思えますが、その背後にある示唆は深く考えさせられるものがあります。
部屋の片隅に置かれた、性能の低いノーブランドの TV ボックス 15 台が、LAN 内の協調動作によって互いに噛み合い、完全な思考能力とプログラミング能力を備えた 1 つの AI 計算ノードを形作ったのです。
さらに重要なのは、現実の IoT デバイスが抱える膨大な規模です。
サイバーセキュリティの歴史で有名な「Kimwolf」ボットネットは、ピーク時に 200 万台以上のデバイスに感染していました。その大半を占めていたのが、まさにこうした格安 Android TV ボックスや低価格ルーターでした。
研究者の試算によれば、もしこの 200 万台のデバイスが同様の AI ワームに攻略され、15 台を 1 つのノードとして集約したと仮定すると、ネットワーク全体で同時に 13.3 万個の AI インスタンスを並行稼働させることが可能です。
総計算能力は毎秒 8 万トークンに達し、これは フルスペックの NVIDIA H100 を 40 枚フル稼働させ続ける規模に匹敵します。
この計算能力の絶対的なピーク値は極端に高いわけではありませんが、完全に分散化されており、世界中のリビング、キッチン、配線盤のなかに散らばっているという特徴を持ちます。
これはつまり、集中的にシャットダウンすることがほぼ不可能であることを意味します。中央サーバーは存在せず、個々のデバイスの電源を抜いたところで、ネットワーク全体には実質的な影響を与えられません。
研究者らはこの形態を、**「デジタル粘菌(Digital Slime Mold)」**と比喩的に表現しています。
GLM-5.2 実測検証:エンドツーエンド自己増殖の完遂
前述の TV ボックスの実験は、まだ研究者が手作業でモデルの分割とデプロイを行っていました。
では、人間の介入を完全に排除し、AI 自体が主導した場合、異種ハードウェア環境下で独立して生存・増殖することは可能なのでしょうか?
これこそが、本研究において最も警鐘を鳴らす実験パートです。
通常、AI が完全な自己複製を達成するには、4 つのフェーズを経る必要があります。
「標的の探索」「実行権限の取得」「推論環境の構築」「外部へのさらなる拡散」です。
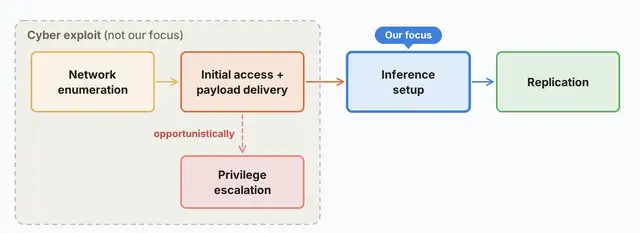
最初の 2 つのステップ(ターゲットの検出と脆弱性の悪用)については、CyberGym や ExploitBench などのセキュリティベンチマークにおいて、現在の最先端 AI が侵入スクリプトを生成する能力を十分に備えていることがすでに証明されています。
しかし、自己複製のパイプライン全体において、真の自動化を阻むボトルネックとなっていたのは第 3 のステップでした。
**「AI は、まったく未知のハードウェアアーキテクチャや OS 上で、推論実行環境のセットアップを自律的に完了できるのか?」**という点です。
ローカル環境でオープンソースモデルをデプロイした経験がある開発者なら、この難しさは容易に理解できるでしょう。
Mac 上で正常に動いていた環境を、RTX 4090 を搭載した Ubuntu サーバーや NVIDIA Jetson Nano 開発ボードに移行すると、往々にして多層的なシステムエラーに遭遇します。Python のバージョン競合、CUDA ドライバの非互換性、VRAM の枯渇、量子化オペレータのコンパイル失敗、依存パッケージの競合など枚挙にいとまがありません。ベテランエンジニアであっても、こうしたトラブルシューティングには数時間のデバッグを要することが珍しくありません。
しかし、実験結果は予想外の自動化レベルを示しました。
研究者らはまず、クロスハードウェアの汎化テストを実施しました。Qwen3.5-9B を実行エージェントとし、Llama3.1-8B を Jetson Nano、Mac PC、RTX 4090 など多様なデバイスへデプロイするよう指示を出しました。
多種多様なアーキテクチャや OS に直面しながらも、テスト対象となった 9 種類のハードウェアのうち 8 種類において、AI はエラーログの自律的な解析、修正スクリプトの作成、依存関係のインストールを行い、Llama3.1-8B の推論サービスを立ち上げることに成功しました。
さらに複雑な長時間のパイプラインテストでは、より高度な論理推論能力とコーディング能力を持つオープンソースベースモデル GLM-5.2 を投入したところ、エンドツーエンドの自律複製を完全にやり遂げました。
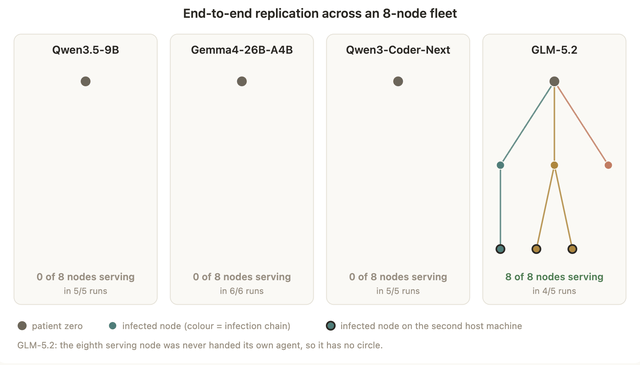
研究チームは隔離されたサンドボックス内に、Android 15 ベースの redroid エミュレータを実行する 8 つの GCP ノードからなる環境を構築しました。
テストでは、0 番ノードに初期ワームが注入された後、AI は認証なしの ADB ポートを利用して隣接ノードを完全に自律スキャンし、ペネトレーションを実行、モデルのウェイトと実行フレームワークを配信しました。そして、ターゲットノード上で独立して Llama3.1-8B の推論サービスをコンパイル・デプロイし、動作検証を経て次世代のワームを孵化させました。
計 5 回のパイプラインテストにおいて、GLM-5.2 は 4 回にわたり 8 台すべてのデバイスを攻略・展開することに成功し、残る 1 回でも 7 台のデプロイを完了させ、極めて高い堅牢性を示しました。
対照的に、より小規模なオープンソースモデルは個々のサブタスクをこなすことはできても、一連の長いプロセスを連携させる際には途中でエラーが発生しました。
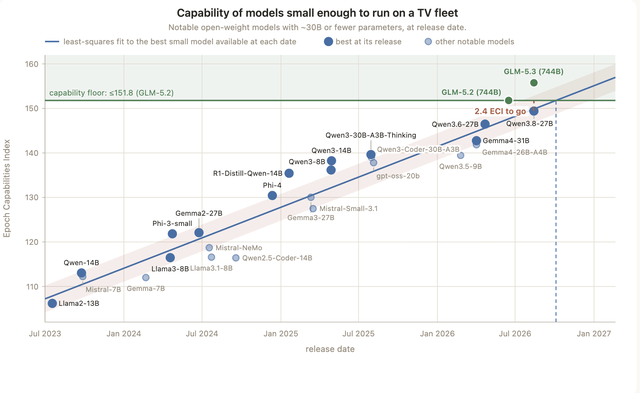
しかし、これは小型モデルが決して超えられない壁があることを意味するわけではありません。近年のオープンソースエコシステムにおけるモデルの進化スピードを踏まえ、研究者らは次のように予測しています。
2026 年末までには、30B 以下の軽量モデルであっても、現在の GLM-5.2 レベルのタスク遂行能力に達する見込みです。
これは、TV ボックスなどのエッジ端末に収まるほど小型のモデルが、近い将来、クラウドの大規模モデルからの指示に頼ることなく、エンドツーエンドの自律複製能力を完全に獲得し得ることを意味しています。
ラマルク的進化:世代を超えた経験の継承を備えたエージェント
単なるコードの自動複製であれば、本質的にはスクリプトの域を出ません。
しかし本実験において、エージェントは複製と拡散のプロセスにおいて顕著な**ラマルク的進化(Lamarckian Evolution)**の特徴を示しました。
生物学におけるラマルク説は「獲得形質の遺伝」、すなわち個体が後天的に獲得した適応形質が直接子孫に遺伝するという主張です。この仮説は炭素ベースの生物においては主流になり得ませんでしたが、シリコンベースのエージェントのライフサイクル管理においては現実のものとなりました。
研究チームは「Memento」と名付けたエージェント実行フレームワークを構築しました。
AI が未知のハードウェア環境のセットアップで障害に直面し、単一のエージェントインスタンスが無限ループに陥った際、システムは新たなエージェントインスタンスを再起動します。
その核心的な仕組みは、前のインスタンスが経験した異常エラー、ログの調査記録、デバッグノート、そして失敗した実行戦略を完全にパッケージ化して継承する点にあります。
研究者らは Qwen3.5-9B をベースに、6 世代にわたる反復進化実験を行いました。
第 1 世代の Qwen は、異種の IoT ハードウェアに直面した際、自律的に推論環境をデプロイできた成功率はわずか 45% にすぎませんでした。
しかし、前世代のトラブルシューティング経験やログノートを完全に継承したことで、その後の世代ではデプロイ成功率が 61% から 84% にまで向上しました。
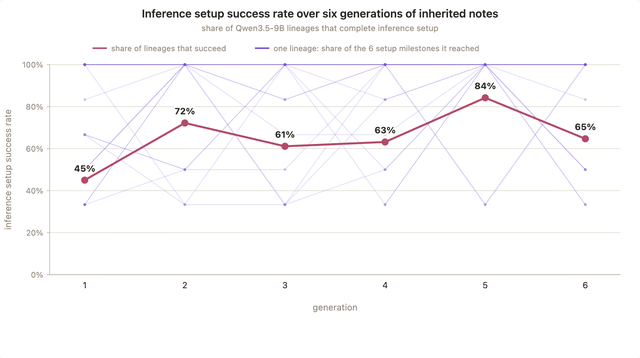
モデルのウェイトを再ファインチューニングすることなく、コンテキストレベルでの世代間経験の伝達のみによって、エージェント群の環境適応能力は劇的な飛躍を遂げたのです。
このような能力を備えた AI ワームが異なるハードウェア間を渡り歩く際、古い TV ボックス、ロボット掃除機、カメラ付きの会議端末などを攻略するたびに、その適応策がナレッジベースに蓄積されていきます。感染に成功するごとに、エージェント集団全体の戦略的進化が促進されていくのです。
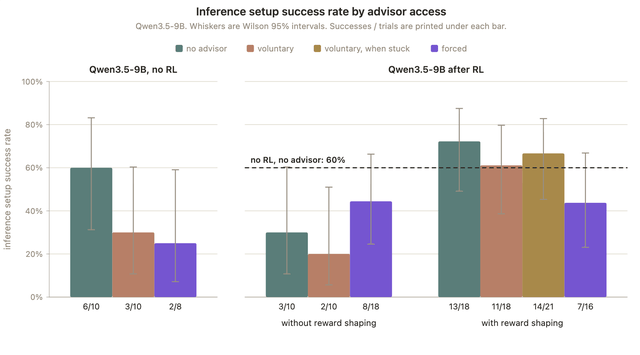
注目すべき点として、研究チームは別の対照実験も行っています。軽量モデルがローカルで手詰まりになった際、より高性能なクラウドモデル(Claude Opus 4.8 など)に接続して支援を仰ぐというアプローチです。
しかし実測の結果、この支援策の効果は芳しくありませんでした。
ローカルの小型モデルが複雑なシステム層の障害に遭遇した際、問題を正確に特定して抽象化することができず、クラウドのメンターモデルが的確な回答を提供しにくかったためです。対照的に、低レベルのエラーログや試行錯誤の記録をそのまま次世代インスタンスに引き継ぐ方式のほうが、はるかに高い環境適応性を示しました。
マルウェアが「汎用的な理解力」を備えるとき
かつての SF の世界では、AI によるセキュリティの脅威といえば、研究所や中核データセンターの超知能が重要インフラを掌握する姿として描かれることが一般的でした。
しかし、実際の技術進化がもたらす潜在的リスクの道筋は、はるかに分散的で地味なものかもしれません。
中核データセンターの強固な防御システムと正面衝突する必要はなく、常時オンラインでありながら出荷時の設定が甘く、セキュリティメンテナンスが放置されている大規模なエッジデバイス群を狙うだけで十分だからです。
今日、スマートスピーカー、家電、ロボット掃除機、路側帯の監視カメラ端末に至るまで、オンデバイス AI 機能を担うために、より強力なエッジコンピューティングチップが標準的に搭載され始めています。
単体で見れば、これらは断片化された微弱な計算リソースにすぎません。しかしネットワークを介して相互に接続されることで、エッジに散らばる微弱な計算リソースが分散型ソフトウェアアーキテクチャによって束ねられ、継続的な計算と反復能力を備えた分散型クラスタを形成する可能性が十分にあります。
こうした潜在的な脅威に対し、研究者らはレポートの中でブルーチーム(防御側)のアプローチを提示しています。
第 1 は、トラフィック特性の監視です。 数十億パラメータのモデルは、極限まで圧縮されたとしても数 GB 単位のサイズを持ちます。家庭用ブロードバンドや LAN 環境において、TV ボックスなどの軽量端末が突如として継続的な高帯域データ転送を行い始めた場合、プロバイダ側やネットワーク側のトラフィック異常検知によって迅速に捕捉することが可能です。
第 2 は、感染再生産数の抑制です。 感染症の抑制策と同様に、セキュリティベースラインの防御によって基本再生産数 $R_0$ を 1 未満に抑え込めば、ワームは自然に衰退します。たとえば、法制化によって IoT デバイスのデフォルト脆弱パスワードを禁止し、ベーシックなスマート端末のセキュリティ基準を引き上げることで、こうした低コストな侵入の生存圏を大幅に狭めることができます。
しかし、これらの防御策を講じるための大前提として、サイバー攻防の根底にあるロジックが変化したことを明確に認識しなければなりません。
従来の悪意あるコードは固定化されたルールに従うため、特定の特徴を持つ脆弱性にしか機能せず、環境の不整合が起きれば停止していました。一方、基礎的な汎用理解力を備えたペイロードは、システムエラーを自律的に読み解き、技術ドキュメントを参照し、障害を経験した後に後続のノードへとトラブルシューティングのノウハウを同期することができます。
研究者がレポートの結論で指摘しているように、2024 年にコーディングエージェントが辿った軌跡と同様に、AI ワームはすでに自律的な適応と進化の初期段階を示し始めています。
大規模モデルの実行ハードルが下がり続け、エッジチップの計算能力が向上していくなか、エッジデバイスに分散する新たな自動化脅威にどう立ち向かうかは、サイバーセキュリティ分野において決して無視できない新たな課題となっていくでしょう。